
私たちは、MSLが14か月で最前線の研究所へと成長した軌跡を一貫して追い続けてきましたが、本日、ついに決定打となる発表がありました。MetaがMuse Wonderを発表し、OpenAIのSol/Terra/LunaやAnthropicのOpus/Sonnet/Haikuと同様に、SparkとGlimmerとともに完全なラインナップが揃いました。興味深いことに、Museは具体的なパラメータ規模を公表していないものの、特定のベンチマークにおいてMuse Wonder FullはFableやAstraを実際に上回っています。また、施された事後学習(post-training)の度合いが異なるため、WonderがFableやAstraと同等クラスのモデルと言えるのかは、現時点では完全には明らかになっていません。
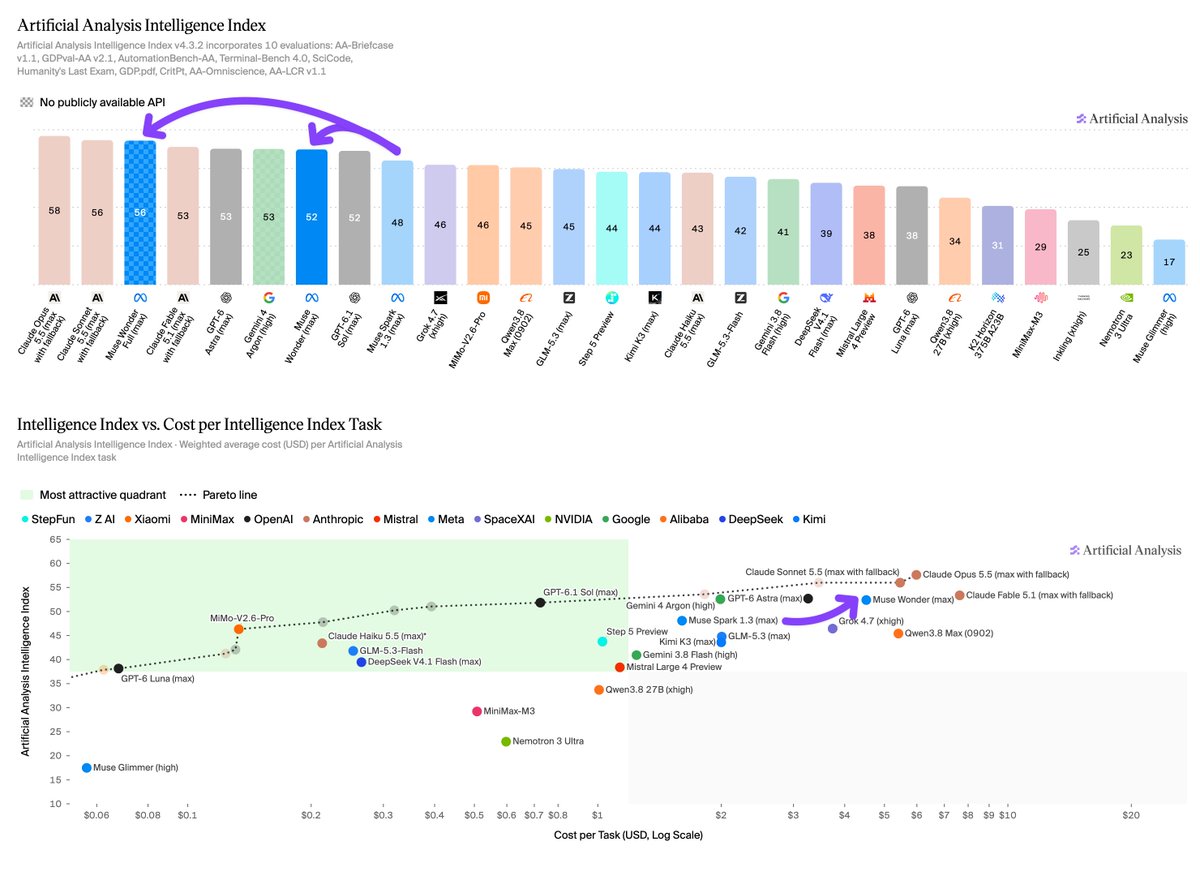
MetaがMuse WonderとMuse Wonder Fullを発表しました。最大推論構成時のArtificial Analysisインテリジェンス・インデックス v4.3のスコアはそれぞれ52と56を記録し、6週間前にリリースされたMuse Spark 1.3(最高48)と比較して、両モデルともに大幅な向上を達成しています。
Muse Wonderはすでにユーザー向けに提供開始されています……
 ——
以下に、今回の発表に関する完全な詳細分析をまとめました。
AI Twitter 振り返り
トップニュース:MetaがMuse WonderとMuse Wonder Fullを発表
ニュースの概要
Meta Superintelligence Labs(MSL)が、第2世代モデルファミリー「Muse Wonder」(コードネーム「スイカ」 🍉)を正式リリースしました。設立からわずか約14か月でありながら、第三者機関によるベンチマークでは最前線(フロンティア)レベルに迫る性能を示しています。
-
予告フェーズ: 正式発表の数時間前から、複数の関係者がスイカの絵文字を投稿して予告を行っていました:@rpnickson(「これは大きなスイカだ……」)、@alexandr_wang、@finkd(「Museに🍉を投稿しろと言われた」)、そして@EdwardSun0909。@kimmonismusは、@synthwaveddによるリーク価格情報をリポストしました。それによると、入力100万トークンあたり4ドル、出力100万トークンあたり20ドル、1M(100万)トークンのコンテキストウィンドウを備え、最も推論能力が高い最上位の「Wonder Full」はMuseCode Power/Maximum Usageサブスクリプションプラン限定で提供されるとのことです。
-
2種類のモデル: @finkdがこのモデルファミリーを発表しました。彼が説明したところによると、Muse SparkはMSL初の製品シリーズであり、Wonderは「私たちをフロンティアへと押し上げる、はるかに大規模で技術的にも高度なモデルクラス」とのことです。今回発表された2つのバージョンは、Muse Wonder(高速フロンティアモデル)とMuse Wonder Full(フルスペックモデル)です。
-
- WonderはMeta Model APIおよびMuse Codeからアクセス可能。
- FullはMuse Codeのサブスクリプションユーザー限定。
- WonderはMuseのパーソナルエージェント製品に搭載され、サブスクリプションユーザーが優先されます(@finkd)。
- Muse Codeのインストールコマンドは
curl dev.meta.ai/install.sh | bashです(@alexandr_wang)。
-
製品の位置づけ: Metaはこれらのモデルを「個人およびプロフェッショナル向けのエージェントワーク(agentic work)」におけるSOTA(最先端)としてアピールしています。@alexandr_wangは3つの主要な特徴を挙げています:
- アクティブメモリ(Active Memory): 数日、数週間、さらには数か月にわたる長期記憶を保持。
- アクティブフォーカス(Active Focus): ボトルネックや困難な課題を突破し、タスクを完遂(クローズドループ)。
- 特定ドメインの専門性(Domain expertise): 金融および法務分野でSOTAを達成し、「ヘルスケア分野でも強力なパフォーマンス」を発揮。
-
トレーニングの歩み: Wang氏によると、4月にMuse Sparkをリリースして以来、Metaは事前学習(pre-training)と強化学習(RL)のスケール拡大を継続してきました(投稿;研究ブログ)。@AIatMetaはこれを「基盤の再構築からフロンティアへの到達を14か月で成し遂げた」と表現しています。
-
安全性に関する表明: @AIatMetaによると、本シリーズのモデルは敵対的プロンプトに対する堅牢性を強化してトレーニングされており、プライバシー情報にも慎重に対応できるとのことです。なお、具体的なシステムカード(system card)についての言及はありませんでした。
-
ローンチ初日の利用枠バグ: WonderおよびWonder FullがMuse Codeの利用枠を異常な速度で消費する問題が発生していました(@alexandr_wang、続報のコメント)。この問題はその日のうちに修正され、全ユーザーのクォータがリセットされました(修正のアナウンス;@mjdouglas)。Wang氏は「現在も解決に向けて取り組んでいる課題がいくつか残っている」と述べています(投稿)。
-
メディアインタビュー: ザッカーバーグ(Zuckerberg)氏とWang氏がStripeのポッドキャスト番組「Cheeky Pint」に出演しました(@collision)。テーマには「1000億ドルの大勝負」「エージェントコマース(Agentic commerce)」、OpenRouter、「なぜAIは勝者総取りにならないのか」、そしてMSLの組織構造などが含まれています。
第三者ベンチマーク(客観データ)
Artificial Analysis(@ArtificialAnlys)——最も詳細なサードパーティ分析を提供:
-
インテリジェンス・インデックス v4.3(Intelligence Index v4.3): Wonder Full(最大推論構成)は56、Wonder(最大推論構成)は52を記録し、Muse Spark 1.3(最高48)から向上しました。Spark 1.3とWonderのリリースの間隔はわずか6週間です。現在、Opus 5.5が58でトップを走っています(@TheRundownAI)。
-
Wonder Fullは全10項目のインデックス評価でスコアを向上させました。 中でもエージェント関連タスクの伸びが最も顕著です:
- Terminal-Bench 4.0:33% → 57%
- GDPval-AA v2