
LFM2.5-24B-A2B は、総パラメータ数240億(24B)でありながら、アクティブパラメータはわずか20億(2B)の推論モデル(Reasoning Model)です。エッジデバイス上で高速かつプライベートなエージェント(Agent)を実現するために設計されました。回答を出力する前に思考を行い、ツール呼び出しに対応し、主要なエージェントハーネス(Agent harnesses)においてマルチステップのタスクを実行できます。1トークンあたり2Bのパラメータのみがアクティブ化されるため、推論トークンあたりの計算コストが極めて低く、ユーザーは手元のハードウェア環境でエージェントを常時実行し続けることが可能です。
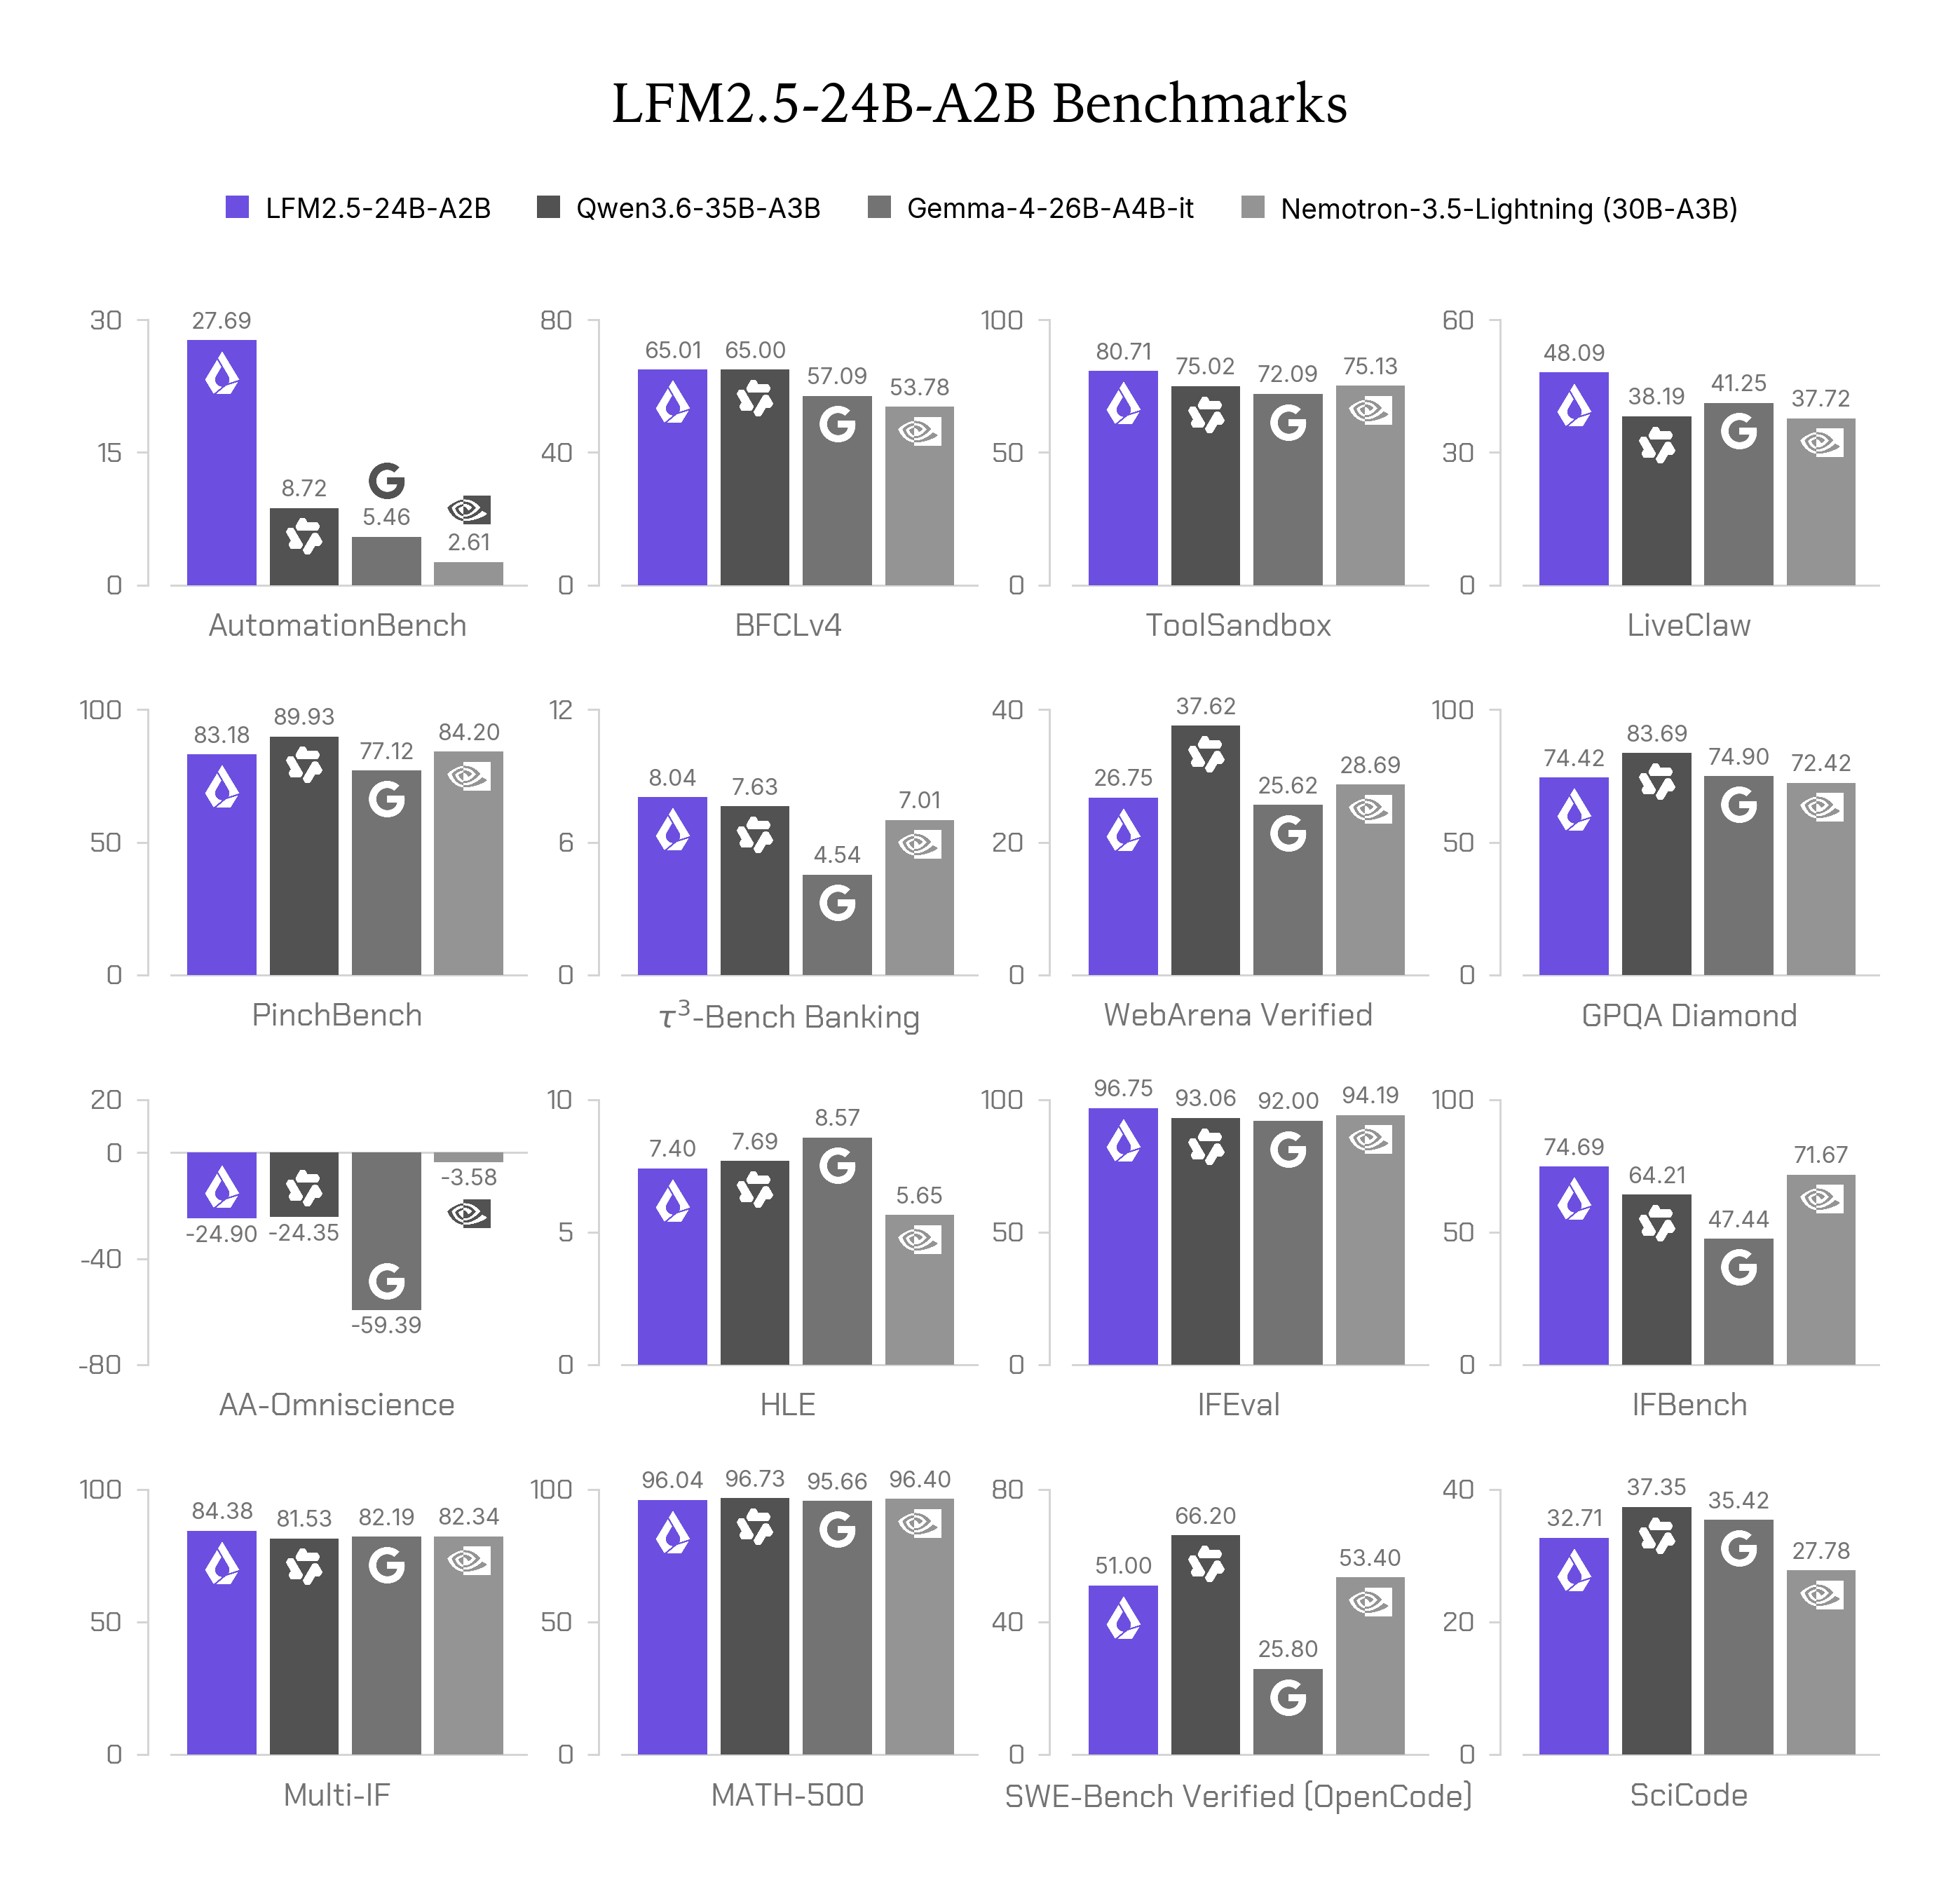
- クラス最高峰のエージェント性能: エージェントおよびツール呼び出しのタスクにおいて、総パラメータ数およびアクティブパラメータ数が約50%多い Qwen3.6-35B-A3B に匹敵し、LiveClaw ベンチマークでは同モデルの 38.19 を上回る 48.09 を記録しました。
- MoEクラスの推論速度: 常に回答前に思考プロセスを挟みます。1トークンあたり2Bのパラメータのみをアクティブ化するため、推論トークンごとのコストを極めて低く抑えられます。
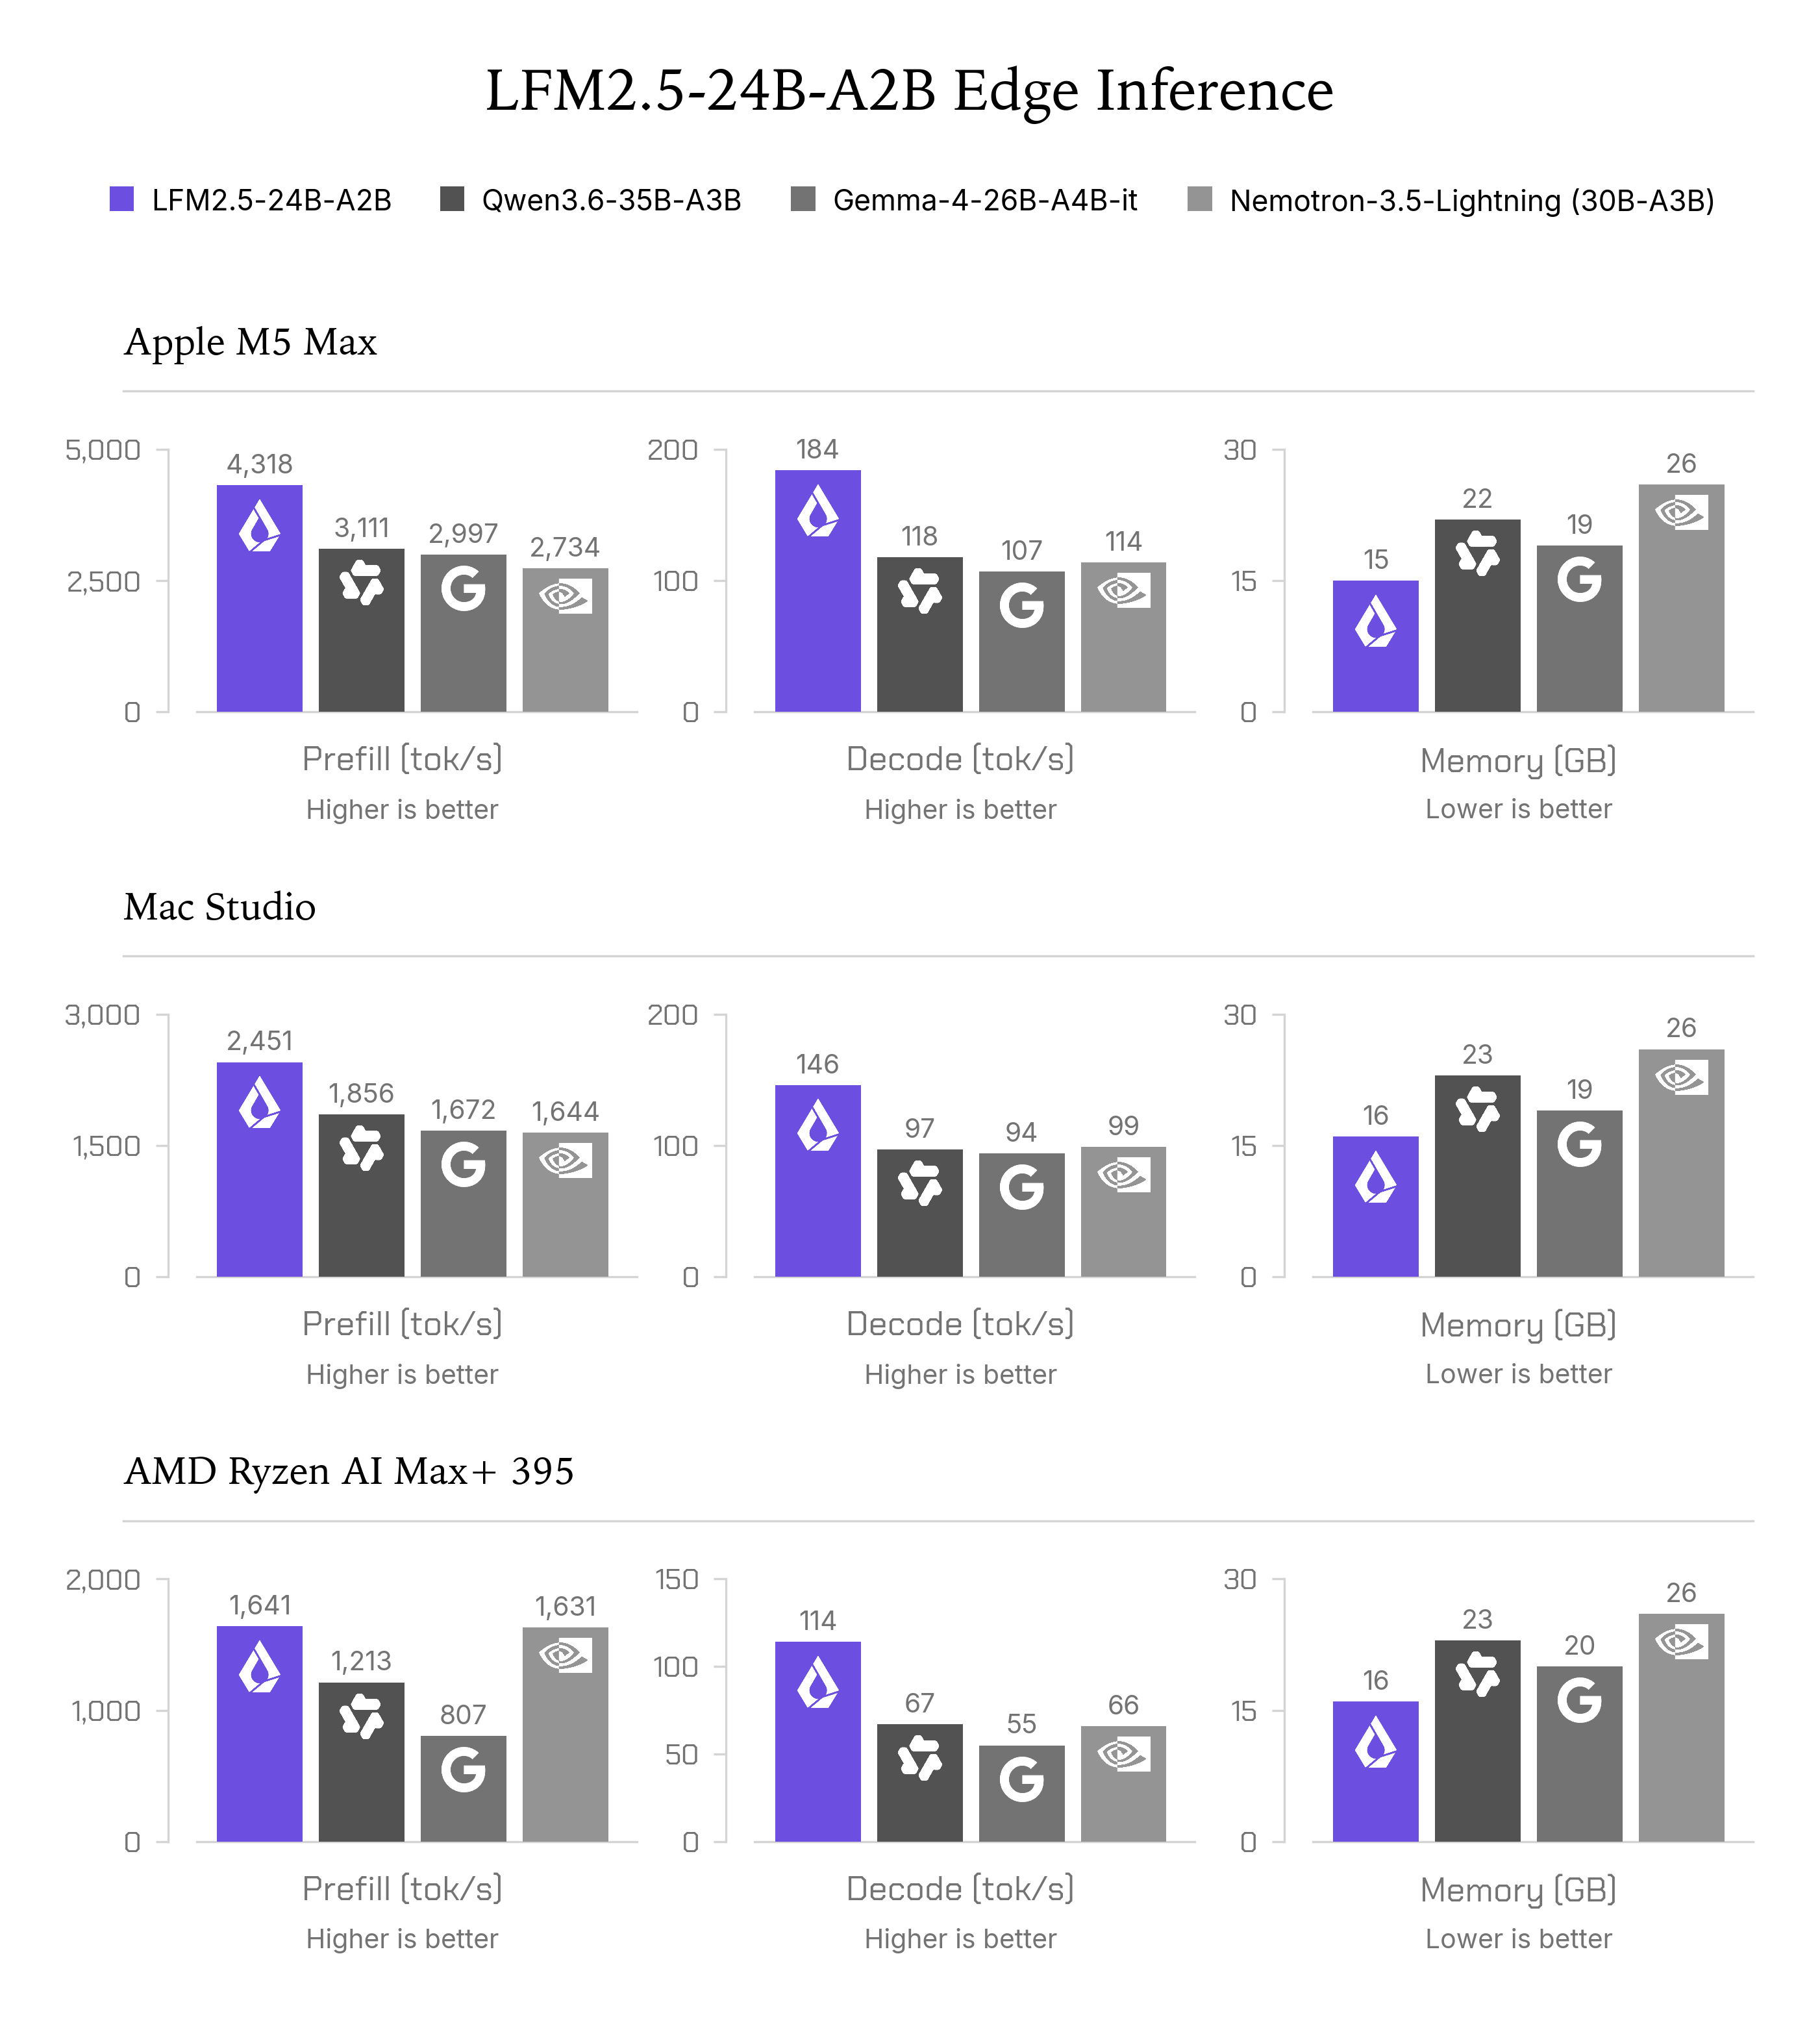
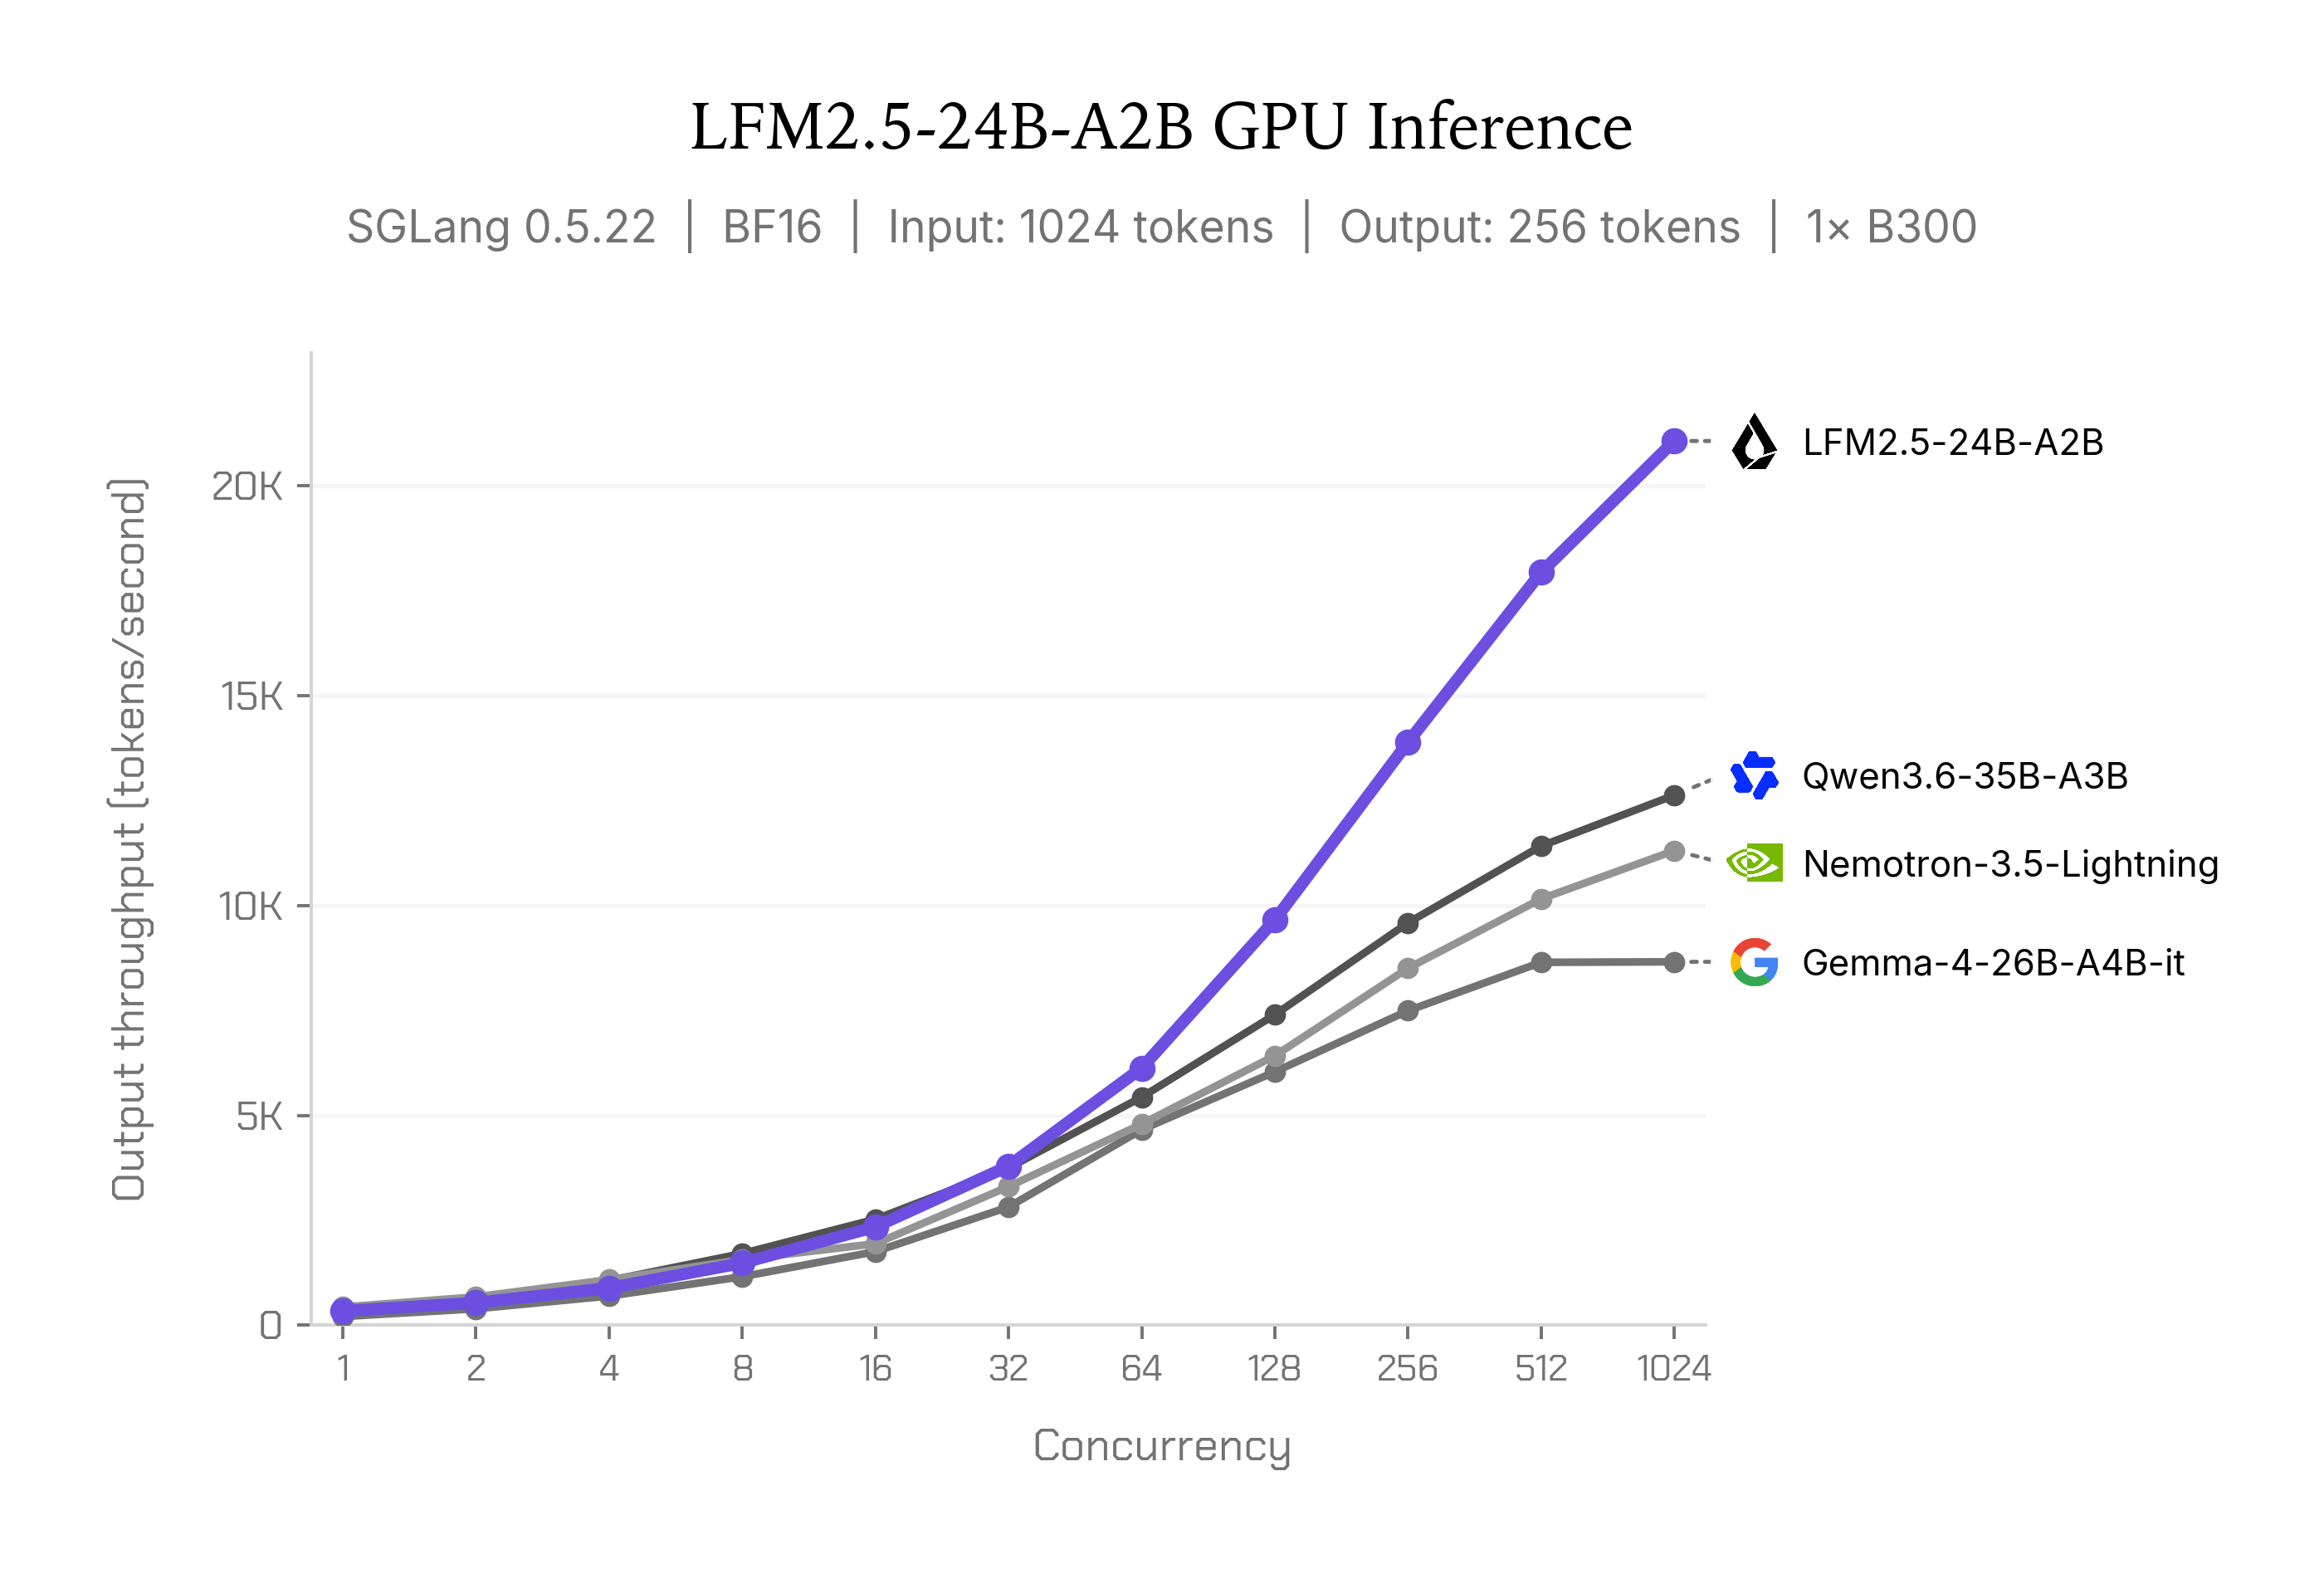
- 高効率な推論: Apple M5 Max では 184 tok/s、NVIDIA B300 GPU 1基で最大2万1000(21K)出力 tok/s を達成します。
わずか2Bのアクティブパラメータで動く推論エージェントの構築手法
LFM2.5-24B-A2B は LFM2-24B-A2B をベースに構築されており、そのモデルアーキテクチャを踏襲しています。40層のネットワークで構成され、各MoEモジュールは64のエキスパートを備え、Top-4ルーティングを採用。さらに、ゲート付きショート畳み込み(gated short convolutions)とグループクエリアテンション(GQA)を組み合わせたハイブリッドアーキテクチャとなっています。コンテキストウィンドウは 32K から 131K トークンへと拡張され、インプレーストークナイザー拡張(in-place tokenizer expansion)によって語彙サイズが 65K から 128K トークンへと倍増したことで、非ラテン文字系テキストのトークン化効率が向上しました。前世代とは異なり、本モデルは純粋な推論特化型モデル(reasoning-only model)であり、最終的な回答を出力する前に明示的な思考の連鎖(Chain of Thought)を生成します。
事前学習の規模は、約 17T トークンから約 33T トークンへと拡大されました。続く中間学習(Mid-training)では、32K コンテキストにおいて推論、数学、コード、指示追従、多言語テキストを重点とした 2T トークンを投入し、131K コンテキストにおいて長文コンテキストデータを中心とした 300B トークンを追加しました。ツール呼び出しやマルチターンのインタラクション軌跡は、両フェーズを通じて組み込まれています。事後学習(Post-training)では、以下の5段階を経てベースモデルをエージェントへと洗練させています。
- 教師あり微調整(SFT)
- 教師モデルの特化(Teacher specialization)
- 非エージェント向けマルチドメイン同一ポリシー蒸留(MOPD, non-agentic): 非エージェントタスクにおいてエキスパート教師モデルからの蒸留を実施。
- エージェント向け MOPD(MOPD, agentic): エージェントタスクに焦点を当てた第2段階の蒸留。
- エージェント強化学習(Agentic RL): OpenClaw、Hermes Agent、Pi、OpenCode などのエージェントハーネス内でモデルを学習。
ベンチマーク結果
ツール呼び出しやエージェントワークフロー、一般知識、指示追従、数学、コードを網羅する16のベンチマークにおいて、LFM2.5-24B-A2B を Qwen3.6-35B-A3B、Gemma-4-26B-A4B-it、Nemotron-3.5-Lightning と比較評価しました。比較対象の中で最もパラメータ数が少ないにもかかわらず、総パラメータ数およびアクティブパラメータ数が約50%多い MoE モデルと十分に渡り合える実力を発揮しています。
| ベンチマーク | LFM2.5-24B-A2B | Qwen3.6-35B-A3B | Gemma-4-26B-A4B-it | Nemotron-3.5-Lightning (30B-A3B) |
|---|---|---|---|---|
| AutomationBench | 27.69 | 8.72 | 5.46 | 2.61 |
| BFCLv4 | 65.01 | 65.00 | 57.09 | 53.78 |
| ToolSandbox | 80.71 | 75.02 | 72.09 | 75.13 |
| LiveClaw | 48.09 | 38.19 | 41.25 | 37.72 |
| PinchBench | 83.18 | 89.93 | 77.12 | 84.20 |
| τ³-Bench Banking | 8.04 | 7.63 | 4.54 | 7.01 |
| WebArena Verified | 26.75 | 37.62 | 25.62 | 28.69 |
| GPQA Diamond | 74.42 | 83.69 | 74.90 | 72.42 |
| AA-Omniscience | -24.90 | -24.35 | -59.39 | -3.58 |
| HLE | 7.40 | 7.69 | 8.57 | 5.65 |
| IFEval | 96.75 | 93.06 | 92.00 | 94.19 |
| IFBench | 74.69 | 64.21 | 47.44 | 71.67 |
| Multi-IF | 84.38 | 81.53 | 82.19 | 82.34 |
| MATH-500 | 96.04 | 96.73 | 95.66 | 96.40 |
| SWE-Bench Verified (OpenCode) | 51.00 | 66.20 | 25.80 | 53.40 |
| SciCode | 32.71 | 37.35 | 35.42 | 27.78 |
*すべてのモデルは vLLM を使用して評価され、各ベンチマークで推奨されている生成パラメータを採用しています。
実用面における本モデルの最大の強みは、ツール呼び出しと指示追従性能にあります。8つのツール呼び出しおよびエージェント関連ベンチマークのうち、LFM2.5-24B-A2B は5項目(AutomationBench、BFCLv4、ToolSandbox、LiveClaw、τ³-Bench Banking)で首位または同率首位を獲得しました。特に AutomationBench では、次点のモデルに3倍以上の大差をつけています。さらに、3つの指示追従ベンチマークすべてで第1位を記録しました。より大規模なモデルは、知識集約型タスク(GPQA Diamond、HLE、AA-Omniscience など)やコーディングタスク(SWE-Bench Verified (OpenCode)、SciCode など)において依然としてわずかなアドバンテージを保っているため、高度な知識を必要とするタスクでは、LFM2.5-24B-A2B と検索拡張生成(RAG)やウェブ検索を組み合わせて使用することをお勧めします。
これらの評価結果により、LFM2.5-24B-A2B は、ローカル環境で安定して動作し、推論機能とツール呼び出し機能を兼ね備えたエージェントを構築するための強力な基盤であることが示されています。
CPU および GPU における推論速度
LFM2.5-24B-A2B はリリース初日から、llama.cpp、MLX、vLLM、SGLang、ONNX を含む包括的な推論エコシステムをサポートしています。
エッジ/オンデバイス推論: 比較対象となった MoE モデルの中で LFM2.5-24B-A2B は最速を誇り、M5 Max では 184 tokens/s、Ryzen AI Max+ 395 では 114 tokens/s のデコード速度を記録しました。次点のモデルと比較して最大1.7倍高速でありながら、メモリフットプリントは最小に抑えられています。
GPU 推論: LFM2.5-24B-A2B は同規模のモデルクラスにおいて最速であり、高並発環境下の B300 1基で 21K tokens/s を超えるスループットを達成します。
LFM2.5-24B-A2B の使い方
推論力とツール呼び出し能力を併せ持ち、ローカル環境で安定して動作するエージェントを構築したい場合、LFM2.5-24B-A2B は最適な選択肢です。
最新バージョンの transformers(transformers>=5.0.0 に対応)をインストールします。
pip install -U transformers続いて、モデルを読み込んで実行します。
from transformers import AutoModelForCausalLM, AutoTokenizer, TextStreamer
model_id = "LiquidAI/LFM2.5-24B-A2B"model = AutoModelForCausalLM.from_pretrained(    model_id,    device_map="auto",    dtype="bfloat16",)tokenizer = AutoTokenizer.from_pretrained(model_id)streamer = TextStreamer(tokenizer, skip_prompt=True, skip_special_tokens=True)
prompt = "What is C. elegans?"
input_ids = tokenizer.apply_chat_template(    [{"role": "user", "content": prompt}],    add_generation_prompt=True,    return_tensors="pt",    tokenize=True,)["input_ids"].to(model.device)
output = model.generate(    input_ids,    do_sample=True,    temperature=0.1,    top_k=50,    repetition_penalty=1.05,    max_new_tokens=512,    streamer=streamer,)
お使いのエージェントフレームワークでの利用
OpenAI 互換の任意のローカルバックエンドで LFM2.5-24B-A2B を起動し、お使いのエージェントフレームワークからそのエンドポイントを指定するだけです。例えば、Hermes Agent を使用する場合:
hermes config set model.provider customhermes config set model.base_url http://localhost:8080/v1hermes config set model.default LFM2.5-24B-A2Bhermes config set model.context_length 131072hermes config set model.api_mode chat_completionshermes config set agent.tool_use_enforcement trueポート番号は使用する推論バックエンドによって異なります(llama.cpp および MLX は 8080、vLLM は 8000、SGLang は 30000、LM Studio は 1234)。OpenClaw や Pi の設定手順についてはモデルカードを、環境構築の詳細な手順については公式ガイドをご参照ください。詳しくは私たちの[リリースブログ](https: