
スコア21対0の圧勝、AIはもはや大規模言語モデルを呼び出す必要すらない
ゲームをプレイしながら、自らをアップグレードする?
Huaweiの最新研究により、AIが「プレイしながら強くなる」術を身につけました。
Huaweiノアの箱舟研究所(Noah’s Ark Lab)とユニバーシティ・カレッジ・ロンドン(UCL)などの共同研究チームが発表したAIエージェントシステムMemento 3が、ARC-AGI-3公開データセットに含まれる全25タイトル・計183ステージを完全クリアしました。
これは決して、総当たり的な試行錯誤で力任せに突破したわけではありません。
人間のプレイヤーが同じステージをクリアするのに平均17,135回のアクションを要したのに対し、Memento 3はわずか7,518回しか要しませんでした。操作ステップ数は人間より約56%少なく、RHAE(相対的人間行動効率)指標で100点満点を獲得しました。
さらに注目すべきは、このシステムがClaude Opus 5をベースモデルとしながらも、プロセス全体を通じてモデルの重み更新を行わず、ゲームタスク向けのファインチューニングも一切施していない点です。
AI自身による試行プレイ、実行ルールの導出、環境をシミュレートするコードの作成、そしてミス発生時の自己反省と修正のみによって、満点での完全クリアを達成したのです。
対照的に、ARC Prize公式の標準テストフレームワークにおけるClaude Opus 5の平均RHAEスコアは約40.7点にとどまります。ベースモデルが完全に同一であるにもかかわらず、このエージェントシステムアーキテクチャを採用するだけで、スコアが59.3点も大幅に向上しました。
それだけではありません。この手法はパズルゲームにとどまらず、研究チームがAtariのクラシックアーケードゲーム「Pong」に適用したところ、AIが自律的に制御戦略を編み出した後は、大規模言語モデル(LLM)へ推論リクエストを一度も送ることなく、3ゲーム連続で21対0の完封勝利を収めました。
LLMのリアルタイム推論から切り離されても、なぜゲームが安定して動作し続けるのでしょうか?
その核心となるメカニズムこそ、本研究のテーマである**世界モデルに基づく再帰的自己改善(Model-Based Recursive Self-Improvement)**にあります。
HuaweiのAIが25タイトルを完全クリア、操作回数は人間より56%減少
テストに用いられた25タイトルは、ARC Prizeが策定したベンチマーク「ARC-AGI-3」のものです。従来のARCテストと比較して、このバージョンには根本的な変化が見られます。
静的な「入力・出力」の解答パターンにとどまらず、AIを未知のインタラクティブなゲーム環境に直接投入する形式へと移行したのです。
ゲームのルールはAI自らが探る必要があり、クリア条件も自力で見つけ出さねばならず、各アクションのフィードバック効果もすべて試行錯誤を通じて把握しなければなりません。
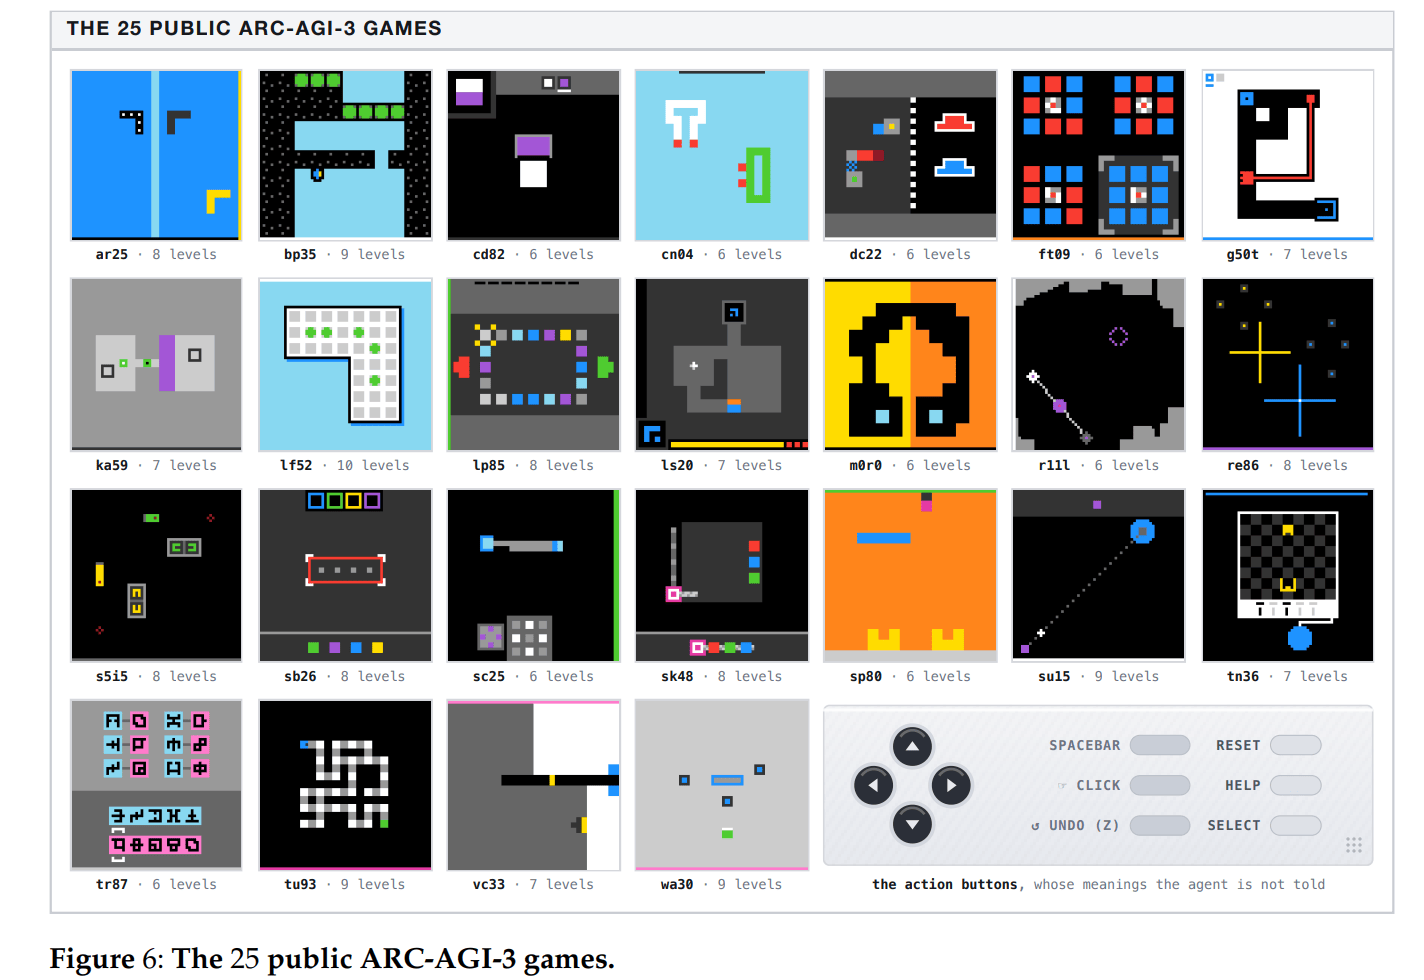
公開された25タイトルには計183のステージが含まれており、画面の多くはシンプルなピクセル、グリッド、色彩、幾何学図形で構成され、レトロなミニゲームのようなスタイルをしています。
しかし、その素朴なビジュアルの裏には、極めて高い推論難易度が潜んでいます。AIにとってアクションの制御自体は難しくありませんが、最も厄介なのは環境の動作原理が完全に未知である点です。特殊なブロックを踏むとどのような連鎖反応が起きるのか? 扉が開かないのは色が違うからなのか、それとも幾何学的な形状が一致していないからなのか? さらに過酷なことに、先のステージではまったく新しいメカニズムが導入され、それまでに構築したルールが根本から覆されることすらあります。
人間プレイヤーにとっても、これらのゲームは極めて挑戦的です。
ARC Prizeのテストデータによると、アメーバを操作して移動・変色させるパズルゲーム「r11l」ではテスト参加者10人全員がクリアできたものの、記号の解読メカニズムが問われるパズルゲーム「tr87」では、挑戦者12人のうちクリアできたのはわずか6人でした。
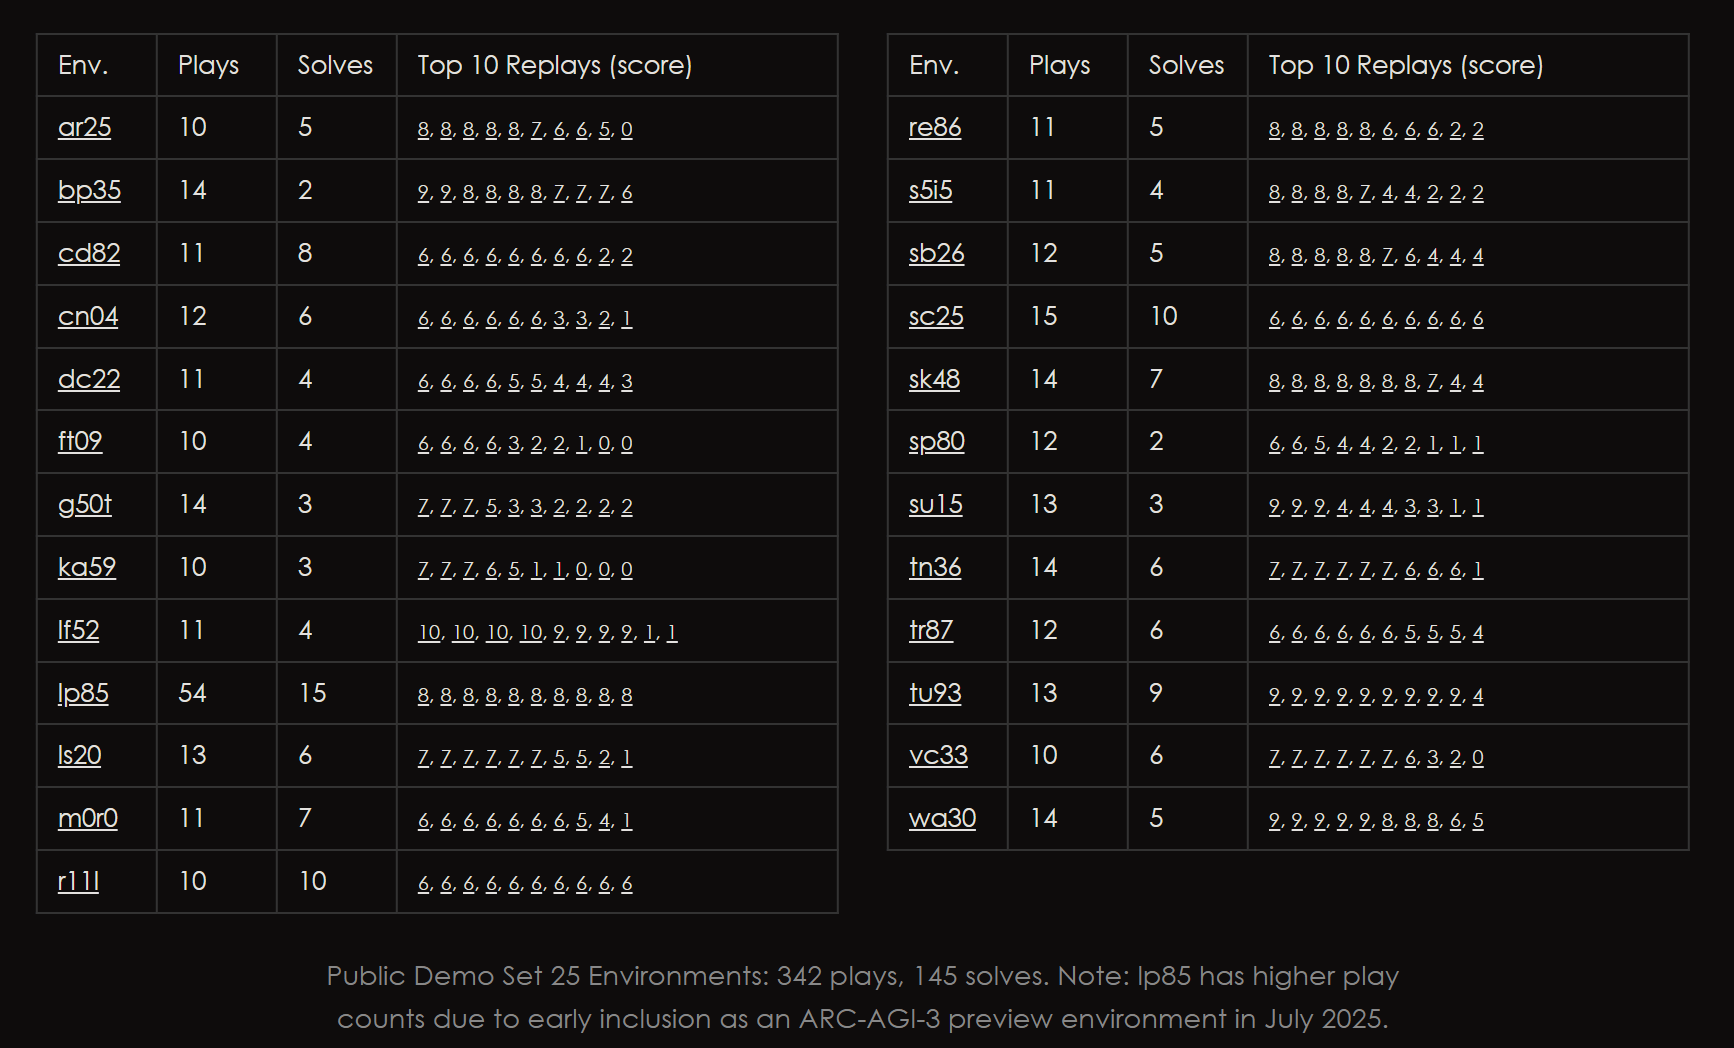
これまでにも、各研究チームがこの領域で激しい競争を繰り広げてきました。
- プリンストン大学が発表したContinual Harnessは3タイトルのみのクリアで、スコアは20.5点。
- NVIDIAの研究者が開発に参加したDreamTeamは6タイトルをクリアし、スコアは38.1点。
- 独立系研究者のDavid Courtis氏が開発したOPINE-WorldとNVIDIAチームのNOOAは、それぞれ78.4点と85.1点を獲得。
- 個人開発者のSergey Rodionov氏が手掛けたbaseline1は特に優れた性能を見せ、全25タイトルをクリアして99点を獲得し、満点まであと一歩のところまで迫りました。
そしてHuaweiの共同研究チームによるMemento 3が、その残された1点の差を埋めたのです。
Memento 3は100点満点で全25タイトル・183ステージを完全クリアしただけでなく、総操作ステップ数を7,518回にまで圧縮し、baseline1の8,347回と比べて829回削減。クリア率と行動効率の両面で他を凌駕しました。
一体どのようにして実現したのでしょうか?
モデルの微調は不要:コードを媒介とした自己反復メカニズムの構築
論文によると、Memento 3のコアパラダイムは**Code as Model(モデルとしてのコード)**と呼ばれています。
その設計思想は、エージェントが探索の過程で2つの重要な資産を自律的に構築することにあります。それは、リアルタイムに更新されるルールのメモと、ゲームの物理法則をシミュレート可能な実行可能コードです。
- Rulebook(ルールブック):AIが導き出した環境の法則(操作のフィードバック、クリア判定条件、未解明の境界条件など)を記録したMarkdown形式のドキュメント。
- Executable World Model(実行可能な世界モデル):AIが体系化したルールを、独立して実行可能なPythonコードへと直接落とし込んだもの。メモリ上に軽量なゲームシミュレータを自律構築することに相当します。
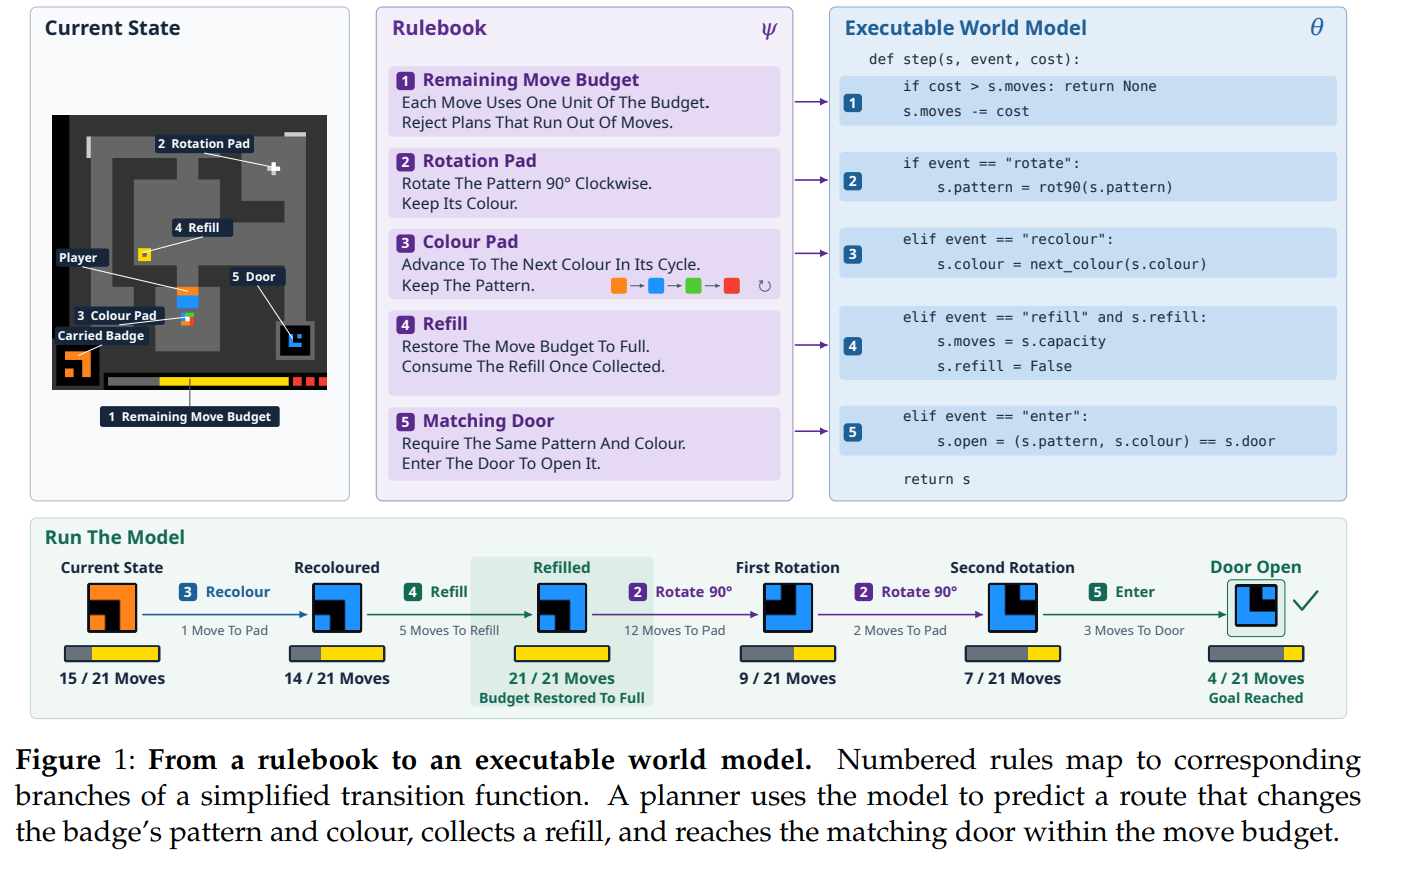
この2つのツールを足がかりに、AIは実際に行動を起こす前に、まずコードシミュレータ内でマルチパスのシミュレーションと枝刈りを行い、最適なアクションシーケンスを選択できます。
しかし、最初に導き出したゲームのルールに誤りがあった場合はどう対処するのでしょうか?
Memento 3は自己省察と反証メカニズムを備えており、実際の観測結果とシミュレーションの予測が衝突した瞬間、能動的にルールを再構築します。
論文では典型的な事例が紹介されています。あるパズルゲームで特殊なブロックに遭遇した際、AIは当初「キャラクターがブロックに乗ると、進入した方向に応じてパターンが鏡像反転する」と推測しました。しかし実際に移動してみると、進入方向とは無関係にパターンが時計回りに90度回転することが判明しました。AIは直ちにルールブックを修正し、基盤となるPythonシミュレーションコードを同期して書き換えました。
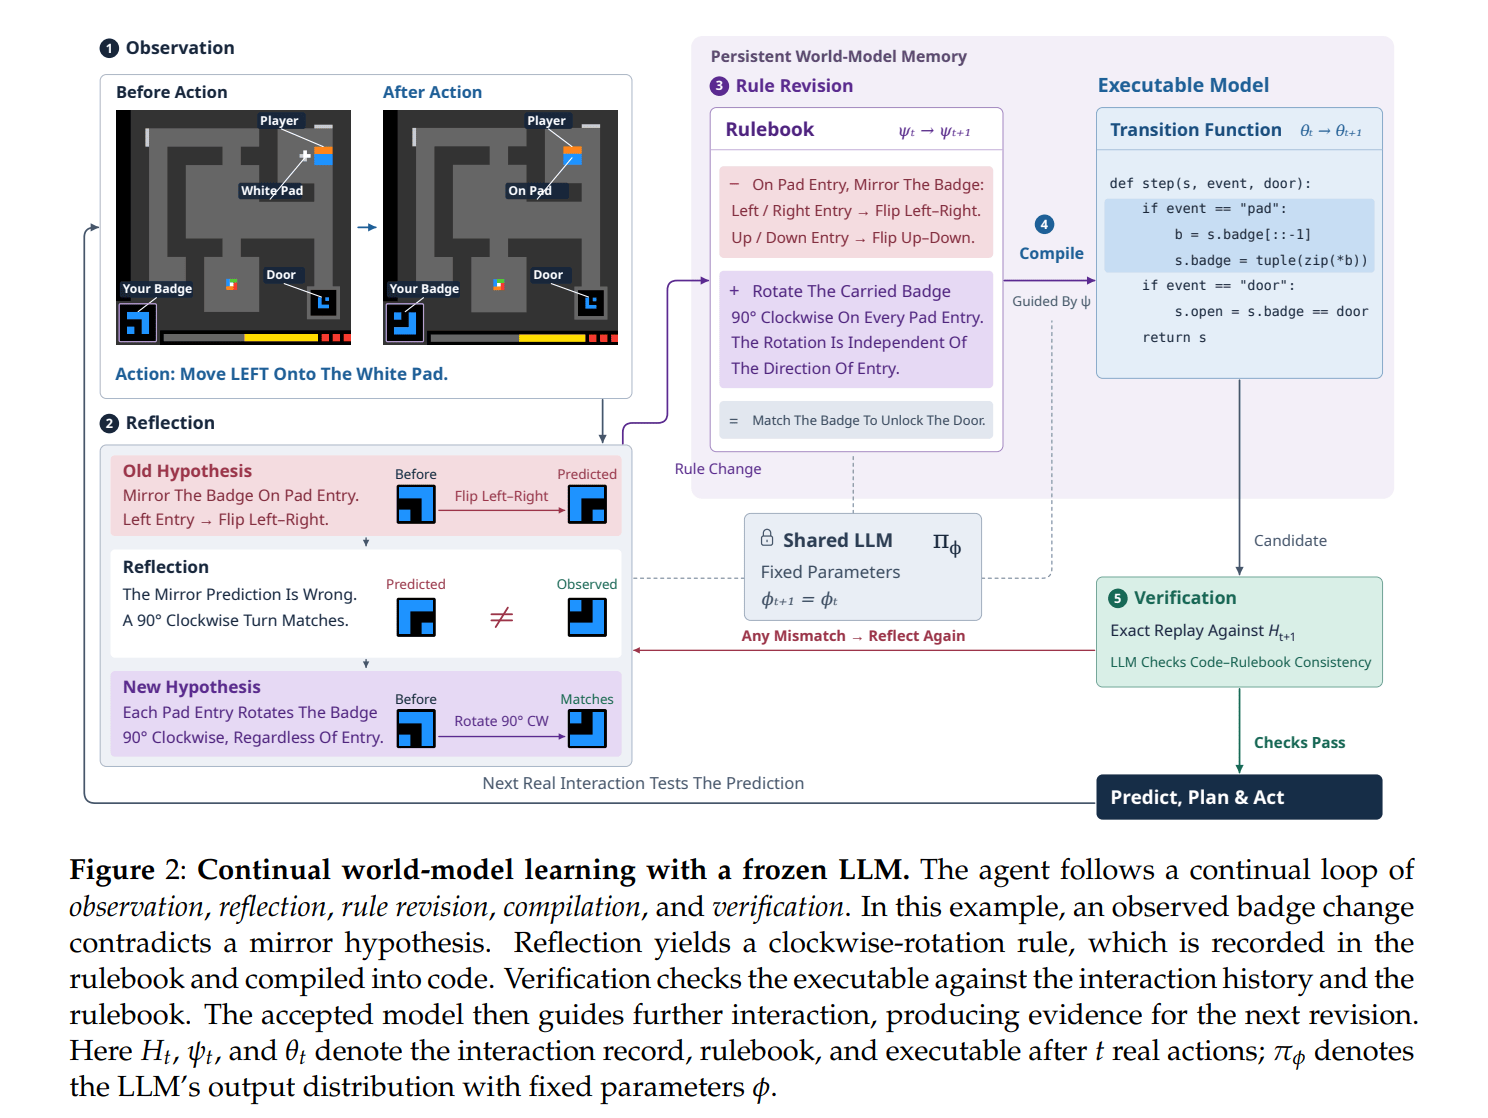
ルール更新後、システムは検証プロセスを実行します。過去の一連のアクションをリプレイし、64×64の画面状態を1ピクセルずつ比較して、コードが実際の結果を正確に再現できているかを検証します。依然として乖離がある場合は、シミュレータと実環境が厳密に一致するまでコードロジックの微調整を継続します。
さらに、過去のステージで蓄積された事前知識は、後続のステージへシームレスに転移されます。
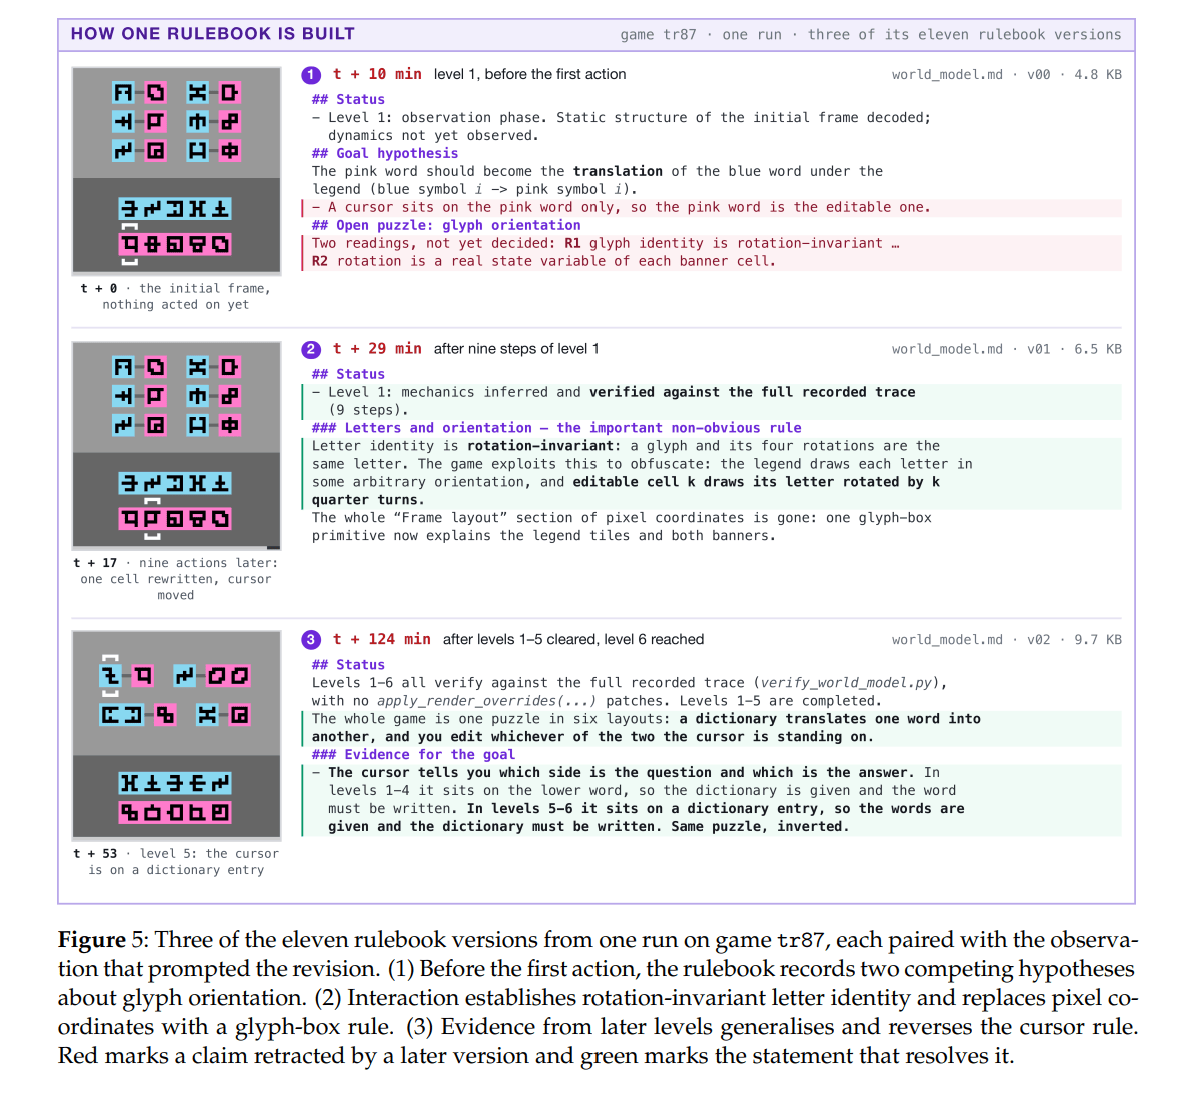
記号パズルゲーム「tr87」を例にとると、AIは当初、記号の向きに意味があるかどうかを確信できませんでしたが、やがて向きが異なっていても同じ文字に対応し得ることを突き止めました。新しいステージが登場すると、カーソル位置の判定ロジックも適時修正しました。ゲーム全体のプレイを通じて、同一のルールブックが計11回のバージョン反復を経ています。
状態の追跡可能性を担保するため、研究チームはGitバージョン管理も導入しました。ルールやコードが変更されるたびにコミット履歴が生成され、その後の推論でロジックのドリフトやエラーが発生した場合、過去のバージョンへロールバックして別のブランチから探索をやり直すことができます。
これによって、本研究が指し示す「再帰的自己改善(Recursive Self-Improvement, RSI)」の閉ループが形成されます。モデル自体のパラメータを凍結したままでも、エージェントは経験の蓄積、ルールの反復、コードの進化を継続することで、戦略パフォーマンスの自律的な飛躍を実現できるのです。
アブレーション実験によっても、ルールブックの有用性がさらに裏付けられました。3つのゲームを用いた対照実験において、ルールブックを保持した場合のAIのクリア総操作回数は617回でした。一方、ルールブックを取り除いてコード世界モデルのみを残した場合、操作回数は677回に増加しました。ルールブックの存在により操作ステップ数は約9%削減され、エージェントの対話ターン数は約18%削減されました。
研究チームはさらにデュアルモデルアーキテクチャも検証しました。AIに2組の世界モデルを並行して維持させ、インタラクション軌跡を共有しつつ、それぞれ異なるルールの仮説と反事実的推論を担わせるというアプローチです。実験の結果、ゲーム「wa30」において、単一モデルではクリアに899回の操作が必要だったのに対し、デュアルモデルアーキテクチャでは597回にまで抑えられ、操作効率がさらに約34%向上しました(現時点でこのデュアルモデルによる性能向上は主にwa30で検証されたものであり、他の環境への汎化性についてはさらなる検証が必要です)。
これらの結果は、基底モデルの再トレーニングやファインチューニングを行わなくても、外部の世界モデルを修正し続けることで、AIが自律的な能力の進化を達成できることを示しています。
21対0の完封:戦略固定後はLLMのリアルタイム推論から脱却
動的かつ連続的な環境における本手法の汎化能力を検証するため、研究チームはMemento 3をAtariのクラシックアーケードゲーム「Pong」に投入しました。
離散的なグリッド状のパズルゲームとは異なり、Pongはボールの連続的な運動、跳ね返り、衝突予測を伴うため、物理法則を推論すると同時にパドルの移動に対するリアルタイムな軌道決定能力が求められます。
テストプロセスは、システムの適応能力の高さを示しました。
当初、AIはボールのバウンドに関する物理法則の事前知識を持たず、手探りの中でルールを帰納するしかありませんでした。当初はパドルが4つの反射エリアに分かれており、当たる位置によって射出角度が決まるという仮説を立てましたが、プレイ中に水平方向への跳ね返りに遭遇しました。
観測の矛盾を検知したAIは、衝突点のパラメータを再計算して反発力学の数式を再構築し、その後の誤差に対しても微調整を繰り返すことで、最終的に実際の挙動に極めて近い物理モデルをフィッティングさせました。
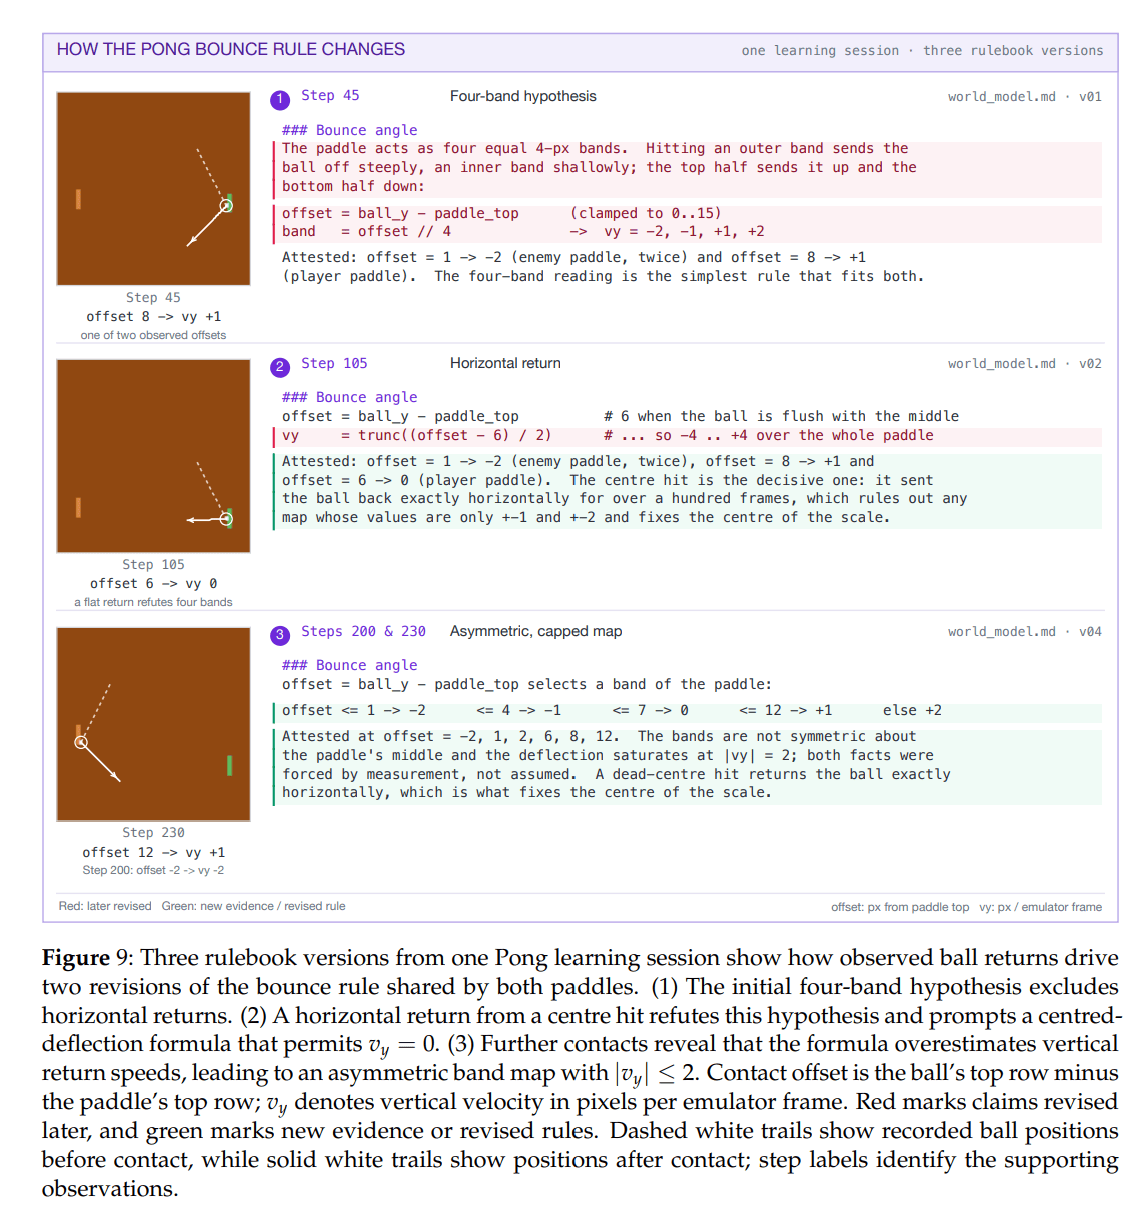
制御戦略が収束して固定化された後、研究チームは生成されたプログラムをLLMから切り離して単独で実行させました。Claude Opus 5のAPI呼び出しを行わず、ルールの更新も停止した状態です。
このオフライン状態において、AIは3つの異なる初期設定のすべてで、21対0というスコアで対戦相手を完封しました。
この段階になると、LLMはもはやフレームごとのアクション決定に関与する必要がありません。LLMの役割は、初期段階でルールを探索して戦略を合成し、ロジックが完成した後はそれを確定的な実行コードへとコンパイルすることへとシフトしたのです。
比較実験によると、世界モデルを導入せず、入力画像に基づいてLLMが毎フレームごとにアクションを生成する手法にのみ依存した場合、最終スコアは-19にとどまり、ランダム操作時のスコアである-20.7に近い結果となりました。
LLMに毎ステップ高コストなフォワードプロパゲーションを実行させるよりも、まずLLMを活用して法則を抽出し、その後の実行を軽量なプログラムに委ねる方が、はるかに高い効率を示すことが明らかになりました。
データによると、Memento 3が有効な制御戦略へと収束するのに要したゲーム画面は約9,500フレームにすぎませんでした。これに対し、一部の従来の強化学習ベンチマークでは通常、数十万から数億フレームものサンプリングデータを必要とします。
もちろん、このアプローチにもコスト面の課題は存在します。Memento 3は探索フェーズにおいて推論強度の高いモードのClaude Opus 5を呼び出しており、コード生成、静的解析、検証プロセスで相当なトークン量と計算リソースを消費しました。また、現在の実験環境は主にルールが明確に閉じたゲームサンドボックスに焦点を当てており、オープンでランダム性の高い現実世界の複雑なタスクにおける有効性については、今後さらなる検証が必要です。
しかし、本研究は具象化AI(Embodied AI)や汎用エージェントの構築に向けて、極めて重要な示唆を与えています。
再帰的自己改善(RSI)は、必ずしもモデル深層の重みを頻繁に更新することに依存する必要はない。検証可能・実行可能・ロールバック可能な外部世界モデルを構築することで、パラメータが固定された汎用LLMであっても、未知の領域において自己反復と能力の飛躍を十分に達成できる。