GLMの「爆速モデル」降臨か?
Zhipuが「GLM-5.3-Highspeed」と呼ばれる新モデルを静かにリリースし、現在Zcodeに統合されています。
ネット上のユーザー @leo114119 氏の投稿によると、このモデルは現在Zcode 3.15.1でテスト利用可能となっており、サブスクリプションユーザー向けに段階的にロールアウト(グレースケール配信)されているとのことです。
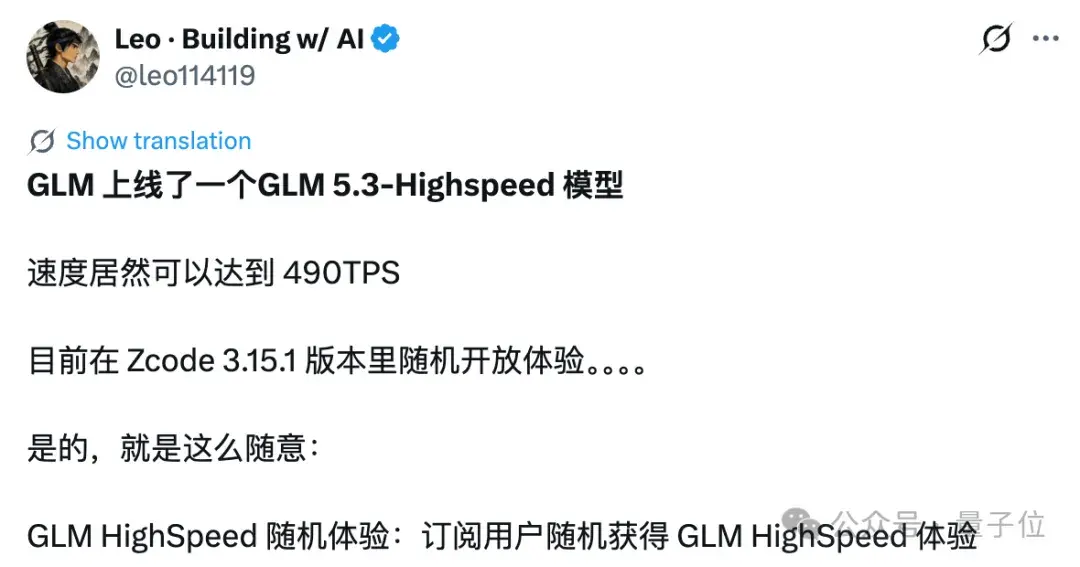
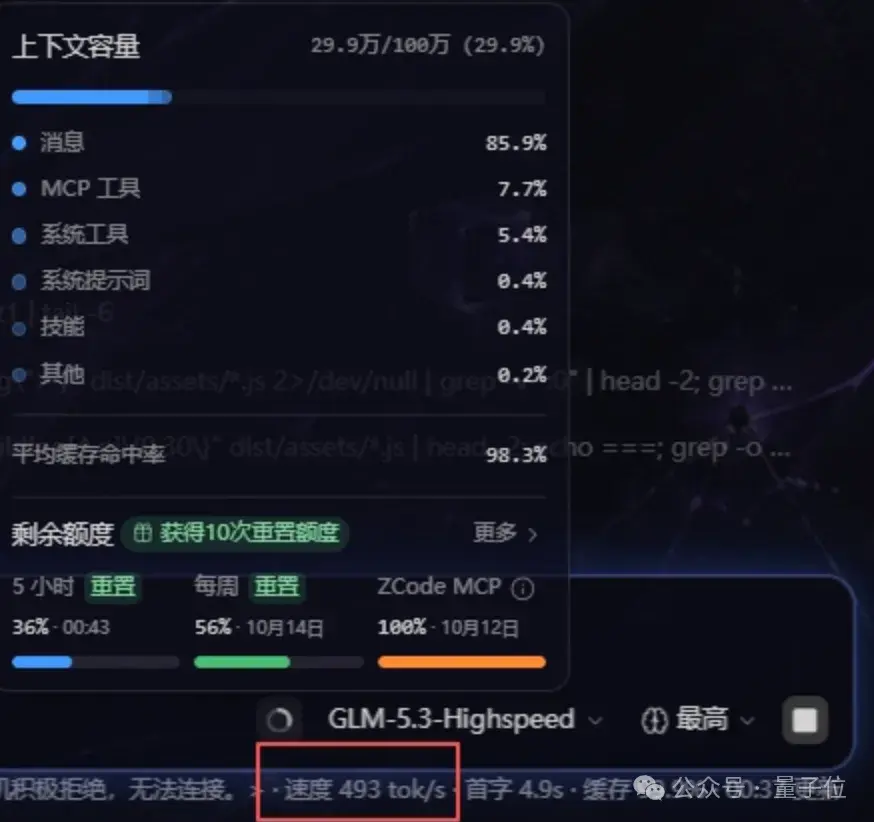
公開された実測データによると、このモデルの生成速度は驚異的な 490 tokens/s に達しています。
筆者も早速Zcodeにアクセスし、手動でこのモデルを追加・切り替えを試みてみました。
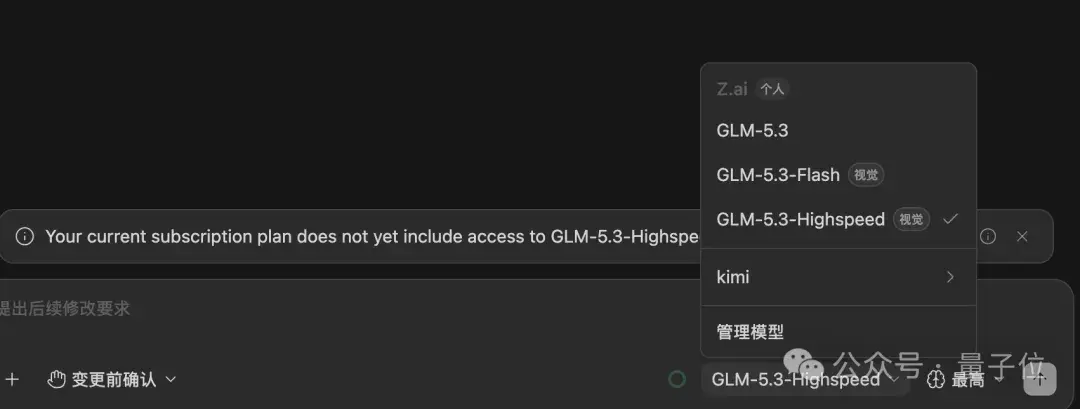
しかし、Liteプランにはまだ権限が付与されていないためか、あるいはテスト配信の対象から外れていたためか、現時点では呼び出すことができませんでした。
GLM-5.3 高速版の実力は?
高速版と銘打っている以上、最も注目されるのはその生成パフォーマンスです。
ユーザーが公開した実測値 490 TPS(TPS:1秒あたりの生成トークン数)は圧巻で、500 TPSの大台に迫る勢いです。この速度を維持できれば、1万トークンの出力もわずか約20秒で完了します。
比較として、Zhipuが先月発表したばかりの GLM-5.3-FlashX の最高速度は約 200 tokens/s であり、Artificial Analysis による計測では、Z.ai API 上の GLM-5.3-Flash の出力速度は約 60 tokens/s でした。
このスピード向上幅は、まさに次世代の「爆速モデル」と呼ぶにふさわしいものです。
実のところ、GLM-5.3-Highspeed の登場には以前から兆候がありました。Pi のモデルカタログに、すでにこのモデルが登録されていたのです。
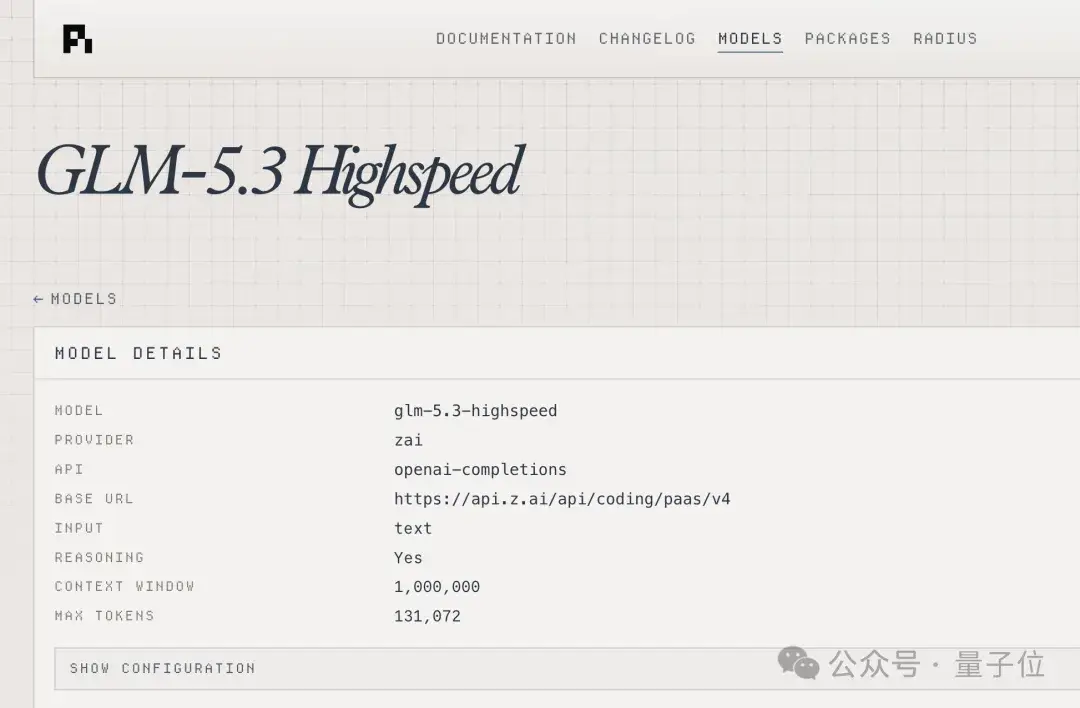
カタログの情報によると、GLM-5.3-Highspeed のコンテキストウィンドウは100万トークン、最大出力トークン数は 131,072(約128k)で、思考の深さ(Thinking intensity)は low、high、max の3段階が用意されています。これらのスペックは、GLM-5.3 通常版と同一です。
また、Redditなどのコミュニティでもこのモデルについて多くの議論が交わされており、OpenCode 上に登場した謎の匿名モデル「Omen Alpha」と関係があるのではないかと推測されています。
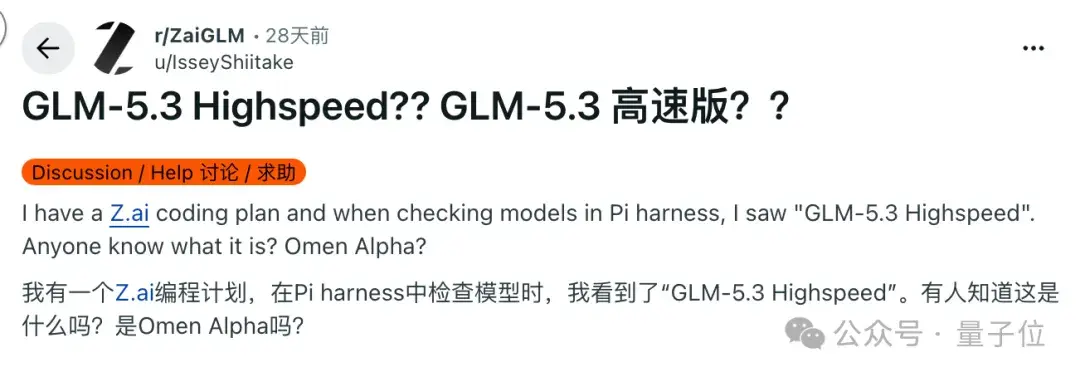
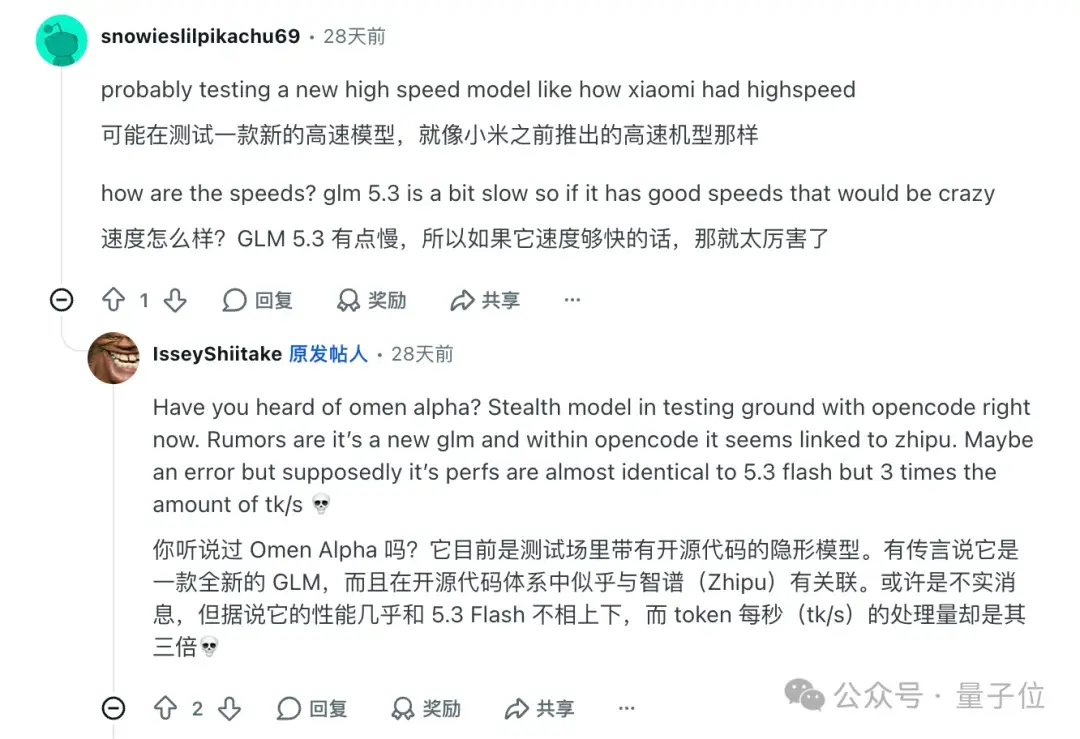
9月にOpenCodeへ登場した Omen Alpha は、その挙動や特徴から、コミュニティ内ではすでにGLMシリーズの派生ではないかと目されていました。
さらに、定番の「自転車をこぐペリカン」のプロンプトを使ってテストを行ったユーザーもいます。
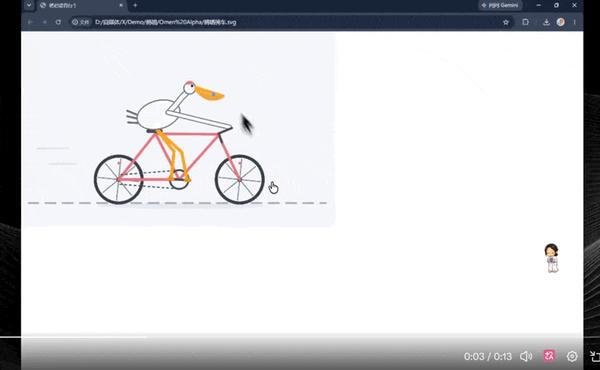
実測フィードバックを要約すると、「推論速度が極めて速く、思考も深く、生成クオリティが安定している」と高評価を得ています。
Omen Alpha の正体については依然として諸説あり、GLM-5.3-Highspeed だとする声のほか、GLM-5.3-Omni や GLM-5.4-Flash ではないかと推測する声もあります。
なお、Zhipu は以前にも高速モデルを展開した実績があります。今年5月にリリースされた GLM-5.1-highspeed は出力速度 400 tokens/s を記録し、当時のグローバルな大手モデルプロバイダーにおけるAPI最高速度を塗り替えました。
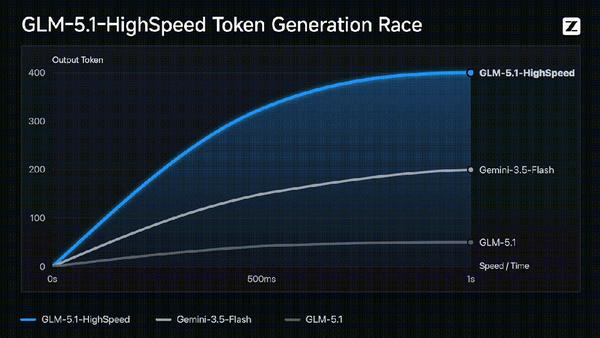
今回の GLM-5.3-Highspeed が安定して 490 TPS を発揮できるのであれば、高スループットや長大なコンテキストを扱うタスクにおいて、生産性の大幅な向上が期待できます。
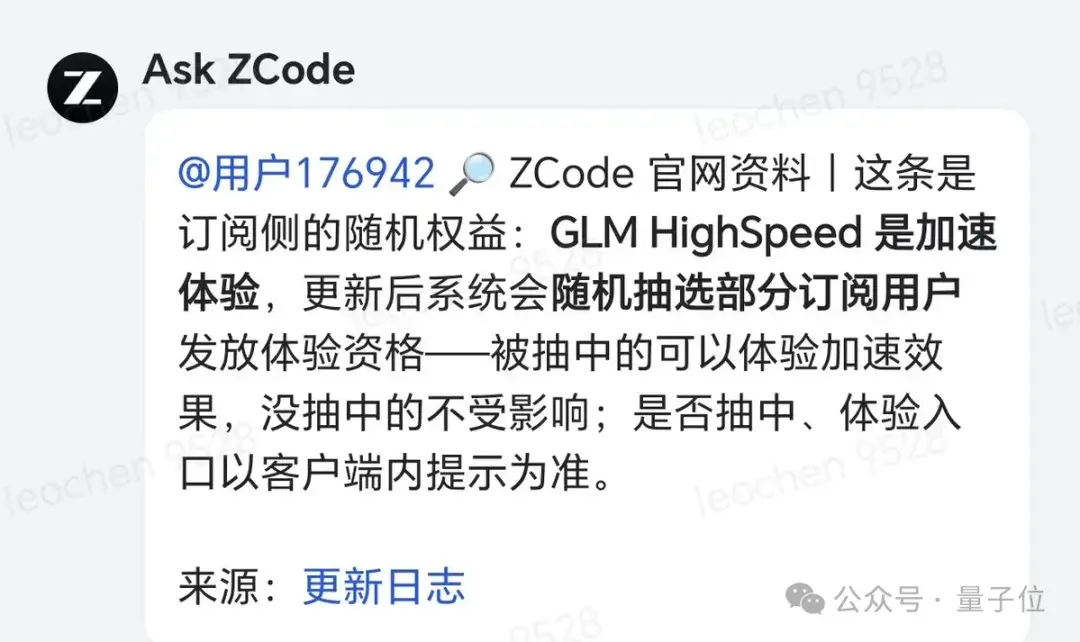
現在、このモデルはZcode内で段階的なテスト配信が続いています。すでにアクセス権限を得たユーザーは、ぜひその実際のパフォーマンスを試してみてはいかがでしょうか。