
論文初稿を作成するマルチエージェントワークフロー
昨今、学術論文の数は追いきれないほど膨大になっていますが、論文を自動生成する AI ツールも次々と登場し続けています。
最近、GitHub に新たな AI 論文生成ツール「Open Academic Paper Gen」が公開されました。
「また論文生成 AI か」とスルーする前に、少し待ってください。
参考文献付きの初稿を自動生成できるだけでなく、Open Academic Paper Gen には非常に強力な特長があります。
それは、文献の全文を入手できる場合、全文(ここが重要です)の奥深くまで根拠を探索し、論文内で引用されている主張を一つひとつ検証してくれる点です。
正直なところ、この機能は極めて実用的です。
論文の執筆は通常、ある研究テーマから出発し、主張を整理して論拠を探し、文献を読み込みながら自身の見解を動的に調整していくプロセスをたどります。
AI の支援を受ければ、論点の展開や論拠となる文献の検索は非常に効率的になります。しかし最大の課題は、「主張も文献自体も実在するものの、AI が抽出した『主張』を論文全体の文脈に戻して確認すると、著者が意図していた内容とまったく食い違っている」というケースが頻発することにあります。
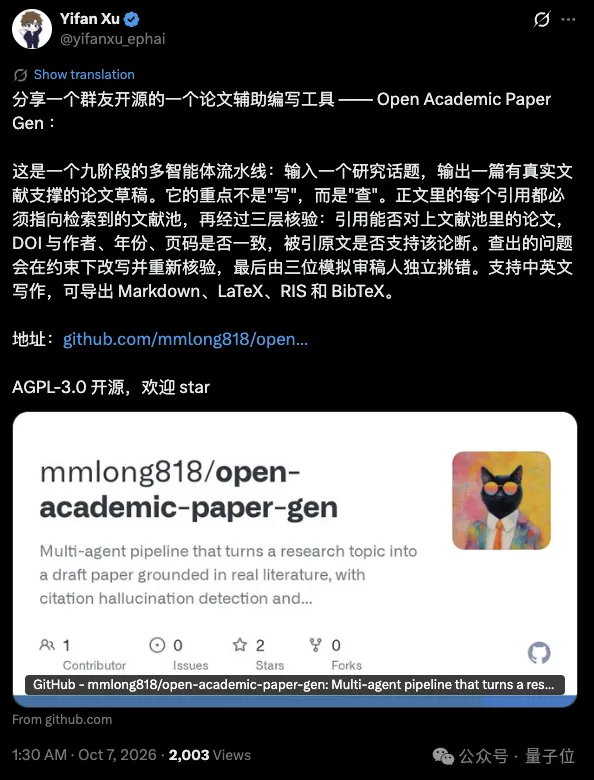
この課題を解決するため、Open Academic Paper Gen は文献の全文を取得した後、関連する段落を特定し、その文献が該当の主張を本当に裏付けているかどうかを判定します。
ページ番号の情報がある場合は注記に該当の PDF ページ番号も記載されるため、研究者が後から元の箇所を確認するのも容易です。
つまり、「その論文が実在するかどうか」だけでなく、「原著者が本当にそう述べているかどうか」までしっかりと検証してくれるのです。
論文初稿を作成するマルチエージェントワークフロー
全体として、Open Academic Paper Gen は論文の初稿作成に向けたマルチエージェントワークフローであり、テーマ選定からエクスポートまでの全工程を以下の 9 つのフェーズに分解しています。
研究範囲の決定、文献検索、クレンジング・スクリーニング、トレンド分析、切り口の探索、アウトライン作成、本文執筆、引用検証、そして最終成果物のエクスポート。
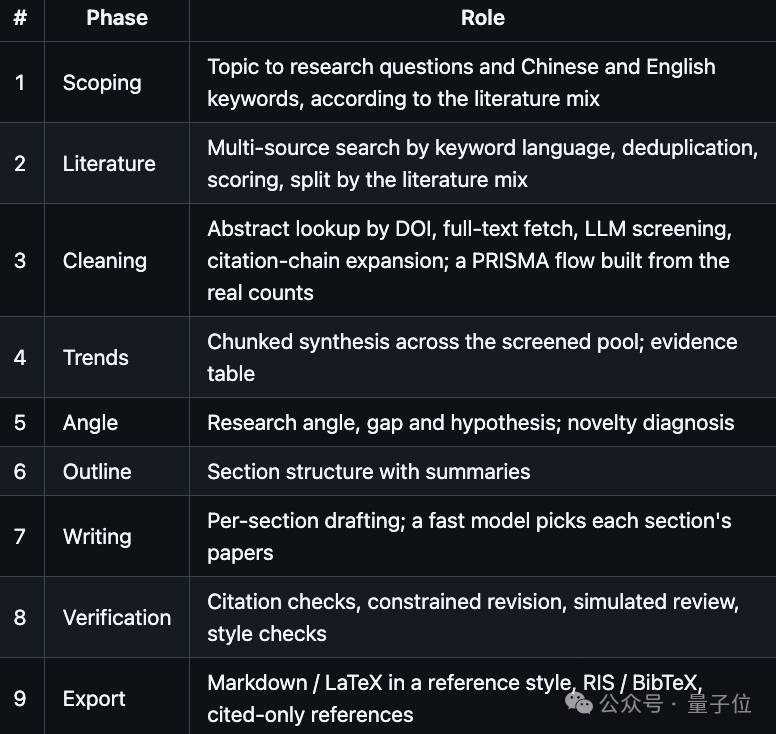
他の AI 論文執筆ツールと同様に、ユーザーが研究テーマ(例えば「物理世界における RSI」など)を入力すると、システムがそれを具体的なリサーチクエスチョンに分解し、英語・中国語のキーワードを生成して OpenAlex、Crossref、Semantic Scholar、arXiv などのデータベースから論文を検索します。
取得した文献は重複排除とスコアリングが行われ、モデルによって関連性がスクリーニングされます。関連度の高い論文が見つかると、システムはその参考文献や被引用文献をたどって検索をさらに拡張します。「まず 1 本を捉え、そこから芋づる式に関連文献を補強する」というアプローチは、Connected Papers の仕組みとよく似ています。
続いて、収集された文献はエビデンステーブルとして整理され、各論文のリサーチクエスチョン、研究手法、実験データ、主な結論、そして限界点が網羅的にまとめられます。
これらの材料をもとに、システムは対象分野の現在の研究トレンドを分析し、潜在的な研究視点、学術的ギャップ、先端的な仮説を提示します。
ここでさらに注目すべきステップが、新規性診断です。
Open Academic Paper Gen は、課題設定、手法、データ、視点などの多角的な観点から切り口を評価し、文献プールの中で最も類似している既存研究を指摘するとともに、査読者から寄せられそうな批判や疑問を予測します。 (これは、自身が ResNet を考案したつもりになっていたときに、他人がすでに似たような研究をしていないかを AI が先回りして確認してくれるようなものです)。
具体的には、これらの診断は今回検索された文献プールに基づいて行われます。したがって、文献プール内に見当たらないからといって、学界全体で誰も取り組んでいないことが完全に保証されるわけではない点には留意が必要です。
研究の切り口が定まると、システムはアウトラインを作成し、セクションごとに初稿を執筆していきます。初稿が完成した後は、引用検証と模擬査読のプロセスに入り、最終的に Markdown や LaTeX 形式でエクスポートできます。参考文献は RIS や BibTeX などの主要フォーマットに対応しています。
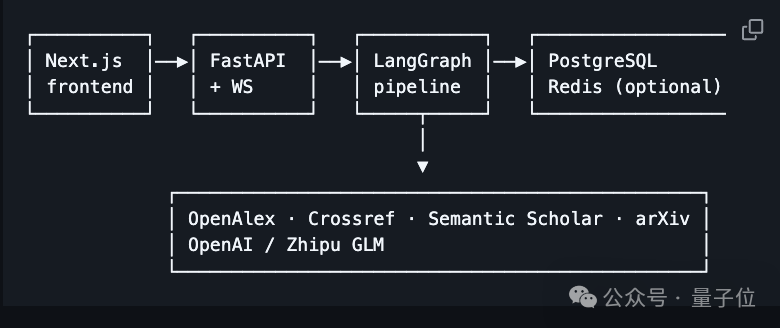
動作モードとしては、デフォルトでは各重要フェーズで一時停止し、ユーザーが確認・編集・承認を行ってから次のフェーズに進む仕様になっています。AI の自動研究能力を試したい場合は、全自動モードに切り替えて最初から最後まで自律的に実行させることも可能です。
なお、実際に試してみたい開発者はモデルの設定要件に注意してください。現時点で本プロジェクトは OpenAI と Zhipu GLM をサポートしていますが、主張の検証、引用のない言明のチェック、模擬査読といったコア機能の実行には依然として OpenAI API Key の設定が必要です。
文単位の引用はどのように検証されるのか?
客観的に見れば、文献の自動検索、初稿の執筆、そして AI によるレビューという流れ自体は、すでに多くの論文執筆プロジェクトで標準的なパイプラインとなっています。LLM のハルシネーション(幻覚)を可能な限り抑えるため、引用チェックや人間による確認ステップを組み込んでいるプロジェクトも一部存在します。
しかし Open Academic Paper Gen は、このフローにおける引用の検証・修正の粒度をさらに細かく突き詰めています。初稿に参考文献を割り当てることと、それらの文献が本文の論述を厳密に裏付けていることを証明することは、まったく次元の異なる作業だからです。
具体的には、検証プロセスは以下の 3 重チェックに分かれています。
第 1 のチェック:引用が文献プール内に存在するかどうかの確認
執筆プロセスにおいて、本文中のすべての引用マーカーは、すでに収集済みの具体的な論文と対応していなければなりません。モデルが存在しない引用マーカーをその場で捏造した場合は明確にマークされ、迅速な特定と修正が可能です。
第 2 のチェック:文献のメタデータの照合
DOI を持つ論文については、まず Crossref のレコードと照合され、見つからない場合は doi.org で追加検証が行われます。タイトル、著者、発行年などの情報に食い違いがある場合は、警告がトリガーされます。
第 3 のチェック:原文が本文の論述を実際に裏付けているかの確認
この段階で、検証作業は表面的な「文献情報」から、本質である「文献の中身」へと踏み込みます。全文が取得できた場合、システムは引用された主張と一致度の高い具体的な段落を検索し、論文冒頭の背景情報と合わせてモデルに入力して、原文が本文の記述を裏付けているかを分析・判定します。全文が取得できない場合は、アブストラクトや抜粋テキストに基づいて判定されます。ページ番号のデータが存在する場合は警告情報に対応する PDF ページ番号も付記されるため、研究者が後から確認する際にも便利です。
もちろん、モデルが十分な根拠を見つけられなかったとしても、その主張が誤りであると証明されたわけではありません。
Open Academic Paper Gen の処理ロジックでは、根拠が不足している場合は「判定不能」としてマークされます。また、テキスト情報が少なすぎて照合すら行えない文献は「未検証」としてマークされ、安易にパスさせるような処理は徹底して排除されています。
全体として見ると、単なる「ワンクリック論文生成」に比べ、文献の整理、エビデンスの特定、引用のセルフチェックを深く連動させた Open Academic Paper Gen の設計思想は非常に柔軟で理にかなっています。特に、AI が生成したコンテンツに対して「一見もっともらしいが信用しきれない」と感じがちな場面において、原文の根拠を素早く特定して引き出せる仕組みは、ファクトチェックを行う研究者にとって強力な足がかりとなるはずです。
ちなみに、本プロジェクトは個人開発者の 猫叔 氏によって開発されたものです。Open Academic Paper Gen のほかにも、同氏はこれまでに AI 脚本作成や AI 研究など、複数のオープンソースプロジェクトを公開しています。
参考リンク: