
マルチモーダルモデルのためのビジョンネイティブ Harness が登場!
先日、何愷明(Kaiming He)氏らの研究チームは、最新論文『VISTA: A Visual Harness for Reasoning in an Interactive World』において、ビジョンネイティブな Harness(ハーネス)を発表しました——
その名は VISTA です。
VISTA を用いることで、既存のマルチモーダルモデルは追加の再学習を行うことなく、環境を直接観察して元の画面を保存し、推論時にいつでも過去の画面を振り返り、拡大して詳細を確認できるようになります。
環境をテキストやコードへ抽象化する従来のアプローチとは異なり、VISTA はオリジナルの視覚情報を完全に保持します。モデルは直面している問題に応じて、過去に観察した画面を再びコンテキストに呼び戻し、現在の判断や推論に役立てることが可能です。
この手法により、視覚的な経験はモデルがいつでも呼び出し、繰り返し検証できるコンテキスト情報へと変換されます。これによりマルチモーダルモデルは、視覚記憶を中心に構築されたネイティブな「足場(Harness)」を手に入れることになりました。
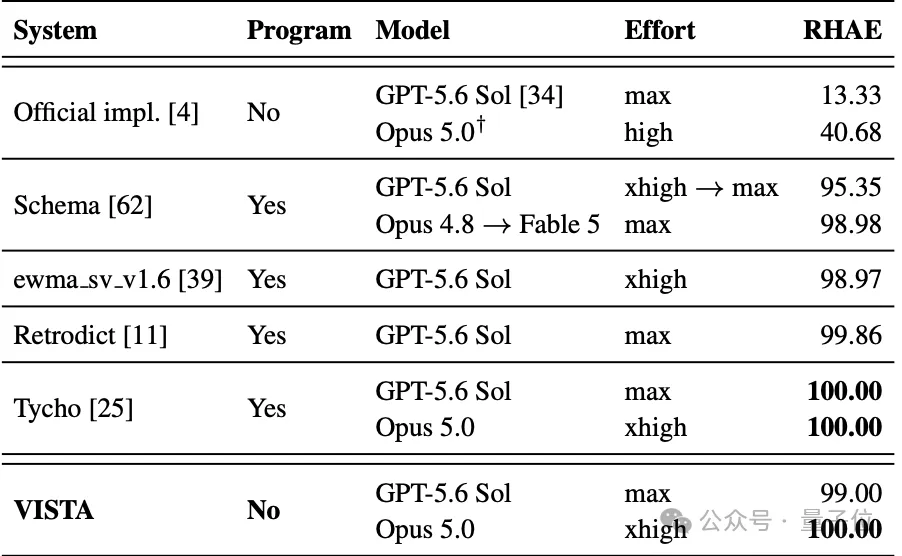
ベンチマーク評価において、VISTA と組み合わせた Claude Opus 5.0 は、ARC-AGI-3 の公開されている全 25 種類のゲームをすべてクリアしました。人間のアクション効率に対する相対スコアは満点の 100 を記録し、消費したゲームアクション数は初見の人間のベースラインよりも 57.4% 少ない結果となりました。
モデルを GPT-5.6 Sol に置き換えた場合でも同様に全ゲームをクリアし、99 という高いスコアを達成しています。
それだけでなく、研究チームはブラウザゲーム、迷路、一筆書き・結線パズルなどにおいても本手法の有効性を実証しており、今後は現実世界により近いエンボディド(身体性)タスクを研究の視野に入れています。
このソリューションは、具体的にどのように実現されているのでしょうか?
ビジョンネイティブな足場(Harness)
ResNet、Mask R-CNN から MAE に至るまで、視覚認識と表現学習は何愷明氏の研究における一貫したコアテーマでした。
今回、VISTA が目を向けたのは新たな命題です。「継続的なインタラクションの中で、モデルにいかにして視覚的経験を蓄積・保存させ、効率的に活用させるか?」
その答えが Harness です。
昨年 11 月、Anthropic は長時間のコーディングタスクを例に挙げ、Harness が複数のコンテキストウィンドウをまたいでタスクを推進するのをいかに支援するかを紹介しました。
具体的には、Harness はタスクリストを通じて ToDo を管理し、進捗ファイルやコード履歴によって完了した作業を保存します。
これにより、モデルが新しいコンテキストウィンドウに移行したとしても、これらの状態記録を読み取ることで過去の進捗と今後の計画を明確に把握できます。
複雑なタスクはステップごとに分割実行・逐次検証され、コンテキストウィンドウの切り替え時にもシームレスに引き継がれます。

テキストやコードをベースにタスク状態を保持するこの Harness メカニズムは、これまでの AI エージェント能力の飛躍的進化を後押しした最大の要因といえます。
しかし現実のシナリオでは、テキストによる記憶だけでは明らかに不十分です。
実際の視覚環境に置かれた場合、モデルは物体の座標や向きを記憶するだけでなく、アクションの前後に生じる環境の細かな動的変化を正確に理解しなければなりません。
さらに重要なのは、モデルが最初に画面を観察した時点では、どのディテールが後続のステップで決定的な役割を果たすかを事前に予測できないことが多いという点です。
これほど豊かな視覚情報を、事前にテキストのメモだけで漏れなく記録しておくことは極めて難しく、後から参照する際に完全な情報として役立つ保証もありません。
ARC-AGI-3 ベンチマークでは、画面を数値で構成されたテキストグリッドに変換し、環境ルールをシミュレートして行動プランを導き出すプログラムをモデルに書かせる、という手法が従来一般的でした。
注:ARC-AGI-3 はインタラクティブな視覚的推論ベンチマークであり、ゲームのルールや目標は事前に与えられません。エージェントは自律的な観察と試行錯誤を通じて攻略法を模索する必要があります。
しかしこの手法には限界があります。環境が複雑になるにつれて、物体の外観的特徴や空間トポロジー、動的な変化をテキストやコードへ劣化なく変換することは極めて困難になります。また、インタラクションのターン数が増えるにつれ、初期の視覚フレームはコンテキストウィンドウから押し出されるか、過度に圧縮されたテキストサマリーに置き換わってしまいます。
そこで VISTA は、次の本質的な課題の解決に焦点を当てました。
ベースモデルを再学習させることなく、推論の必要に応じて過去の視覚情報をエージェントが再度取得・検証できるようにするにはどうすればよいか?
VISTA のアプローチは、アクション実行中のアニメーション遷移フレームを含め、環境から返されるすべてのフレーム画面をコンテキストの外にそのまま保存し、モデルが必要としたタイミングでピンポイントに呼び戻すというものです。
ARC-AGI-3 の評価において、本システムは複数フレームにまたがる時系列の比較だけでなく、ブロック上の方向マークといった細かな情報を確認するための局所的な切り出し・拡大にも対応しています。
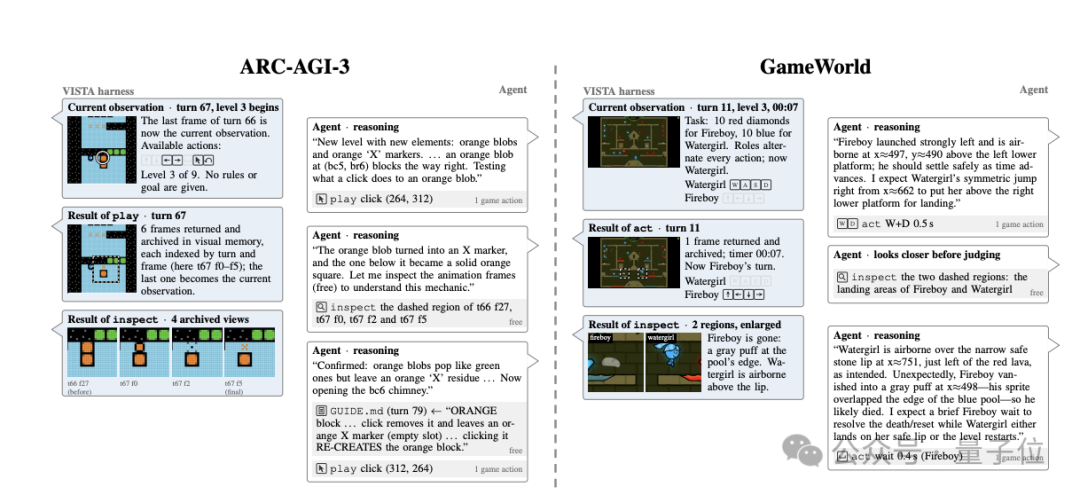
このアーキテクチャでは、テキストメモがモデルの現段階の認識をまとめる役割を担い、元の画像画面は繰り返し確認できる客観的な証拠として機能します。
研究チームはこのメカニズムを、インタラクション履歴に対する「明示的アテンション(Explicit Attention)」と定義しています。モデルは現在の推論ニーズに基づき、どの視覚データをコンテキストに呼び戻すかを自律的に判断できます。
これを実現するために、基盤システムは元の画像ストリームを完全に保持し、俊敏な検索・検査ツールチェーンを提供する必要があります。
具体的な実装
モデルに視覚的経験の永続化と振り返りの能力を与えるため、VISTA は 3 つのコアコンポーネントを構築しました。
「視覚的観察」「可逆な視覚記憶」「能動的な視覚検査」です。これら 3 つが連携し、画面の入力提示、履歴の保存、オンデマンドの呼び出しをそれぞれ担当します。
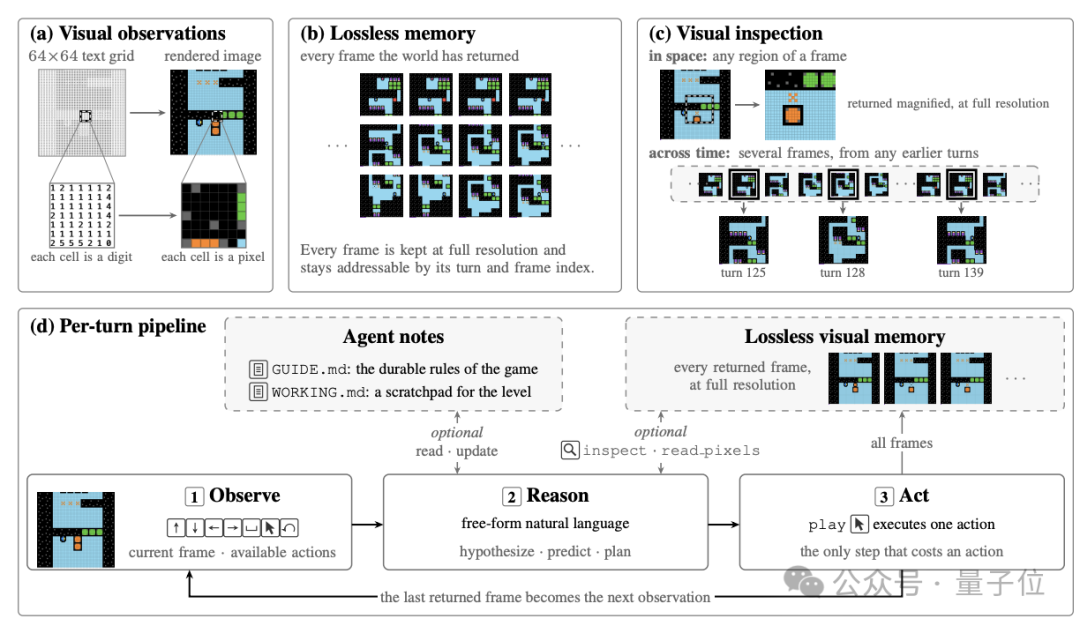
1. 視覚的観察:モデルへの高精度な環境画面の提供を担当。
ARC-AGI-3 の実験では、公式から提供される 64×64 の画面を 512×512 の PNG 画像に拡大し、色、形状、空間トポロジー関係を完全に保持することで、モデルが物理的な特徴を直接知覚できるようにしています。
2. 可逆な視覚記憶:モデルが見た画面の構造化ストレージを担当。
アクションを実行するたびに、VISTA は環境から返されるすべての画像(アクション中のアニメーション中間フレームを含む)を劣化なく保存し、ターン番号とフレーム番号に基づいてインデックスを作成します。
モデルは早い段階で「どの特徴を記録すべきか」を性急に判断する必要はなく、すべての視覚的経験を基盤アセットとして蓄積しておき、必要に応じていつでも取り出せます。
3. 能動的な視覚検査:モデルによる過去フレームのオンデマンドな振り返りと深掘りをサポート。
inspect ツールを使用することで、モデルは指定したターンの過去画像を呼び出せるだけでなく、ピクセル単位の詳細を調べるために局所的な切り出し・拡大を行うこともできます。
ある操作によって引き起こされた具体的な状態変化を把握したい場合、モデルは複数のターンをまたいで複数フレームを取得し、差分比較を行うことも可能です。
このメカニズムは、マルチモーダルモデルにいつでも検索可能な「ビジュアルアーカイブ」を持たせるようなものです。モデルは現在の視界にとどまらず、自律的に過去の軌跡を遡り、後続の意思決定に確かな証拠をもたらすことができます。
具体的な運用フローにおいて、これら 3 つのコンポーネントは厳密な時系列に従って連携します。
各ターンの開始時、モデルはまず現在の画面と実行可能なアクション空間を解析し、事前の知識と照らし合わせてシステムの状態を分析した上で、次のアクションの仮説を立てます。
現在の知覚の信頼度が不十分な場合、モデルはツールチェーンを起動して過去のフレームを呼び出したり、局所的な視野を拡大したり、さらには不連続なピクセル値を読み取って仮説を検証します。
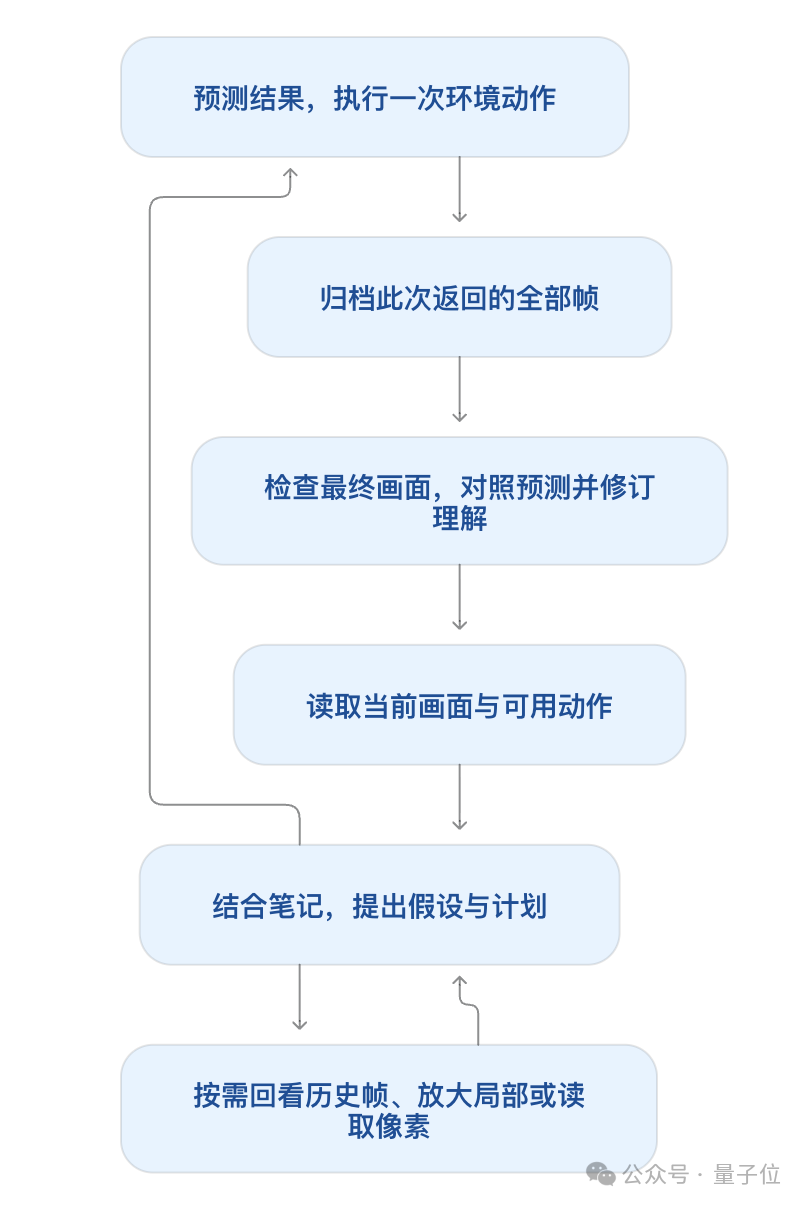
証拠を固めた後も、モデルは闇雲に操作するのではなく、まずはアクションによるフィードバックの予測を行います。
実行が完了すると、実際のフィードバックと予測を照らし合わせて検証し、根底にあるルールに対する認知モデルを動的に修正します。
このループを通じて、エージェントは継続的なインタラクションの中で環境の探索と知識のアップデートを同時に進めていきます。
長期的なタスクにおけるコンテキストの一貫性を担保するため、VISTA は 2 つの構造化テキストメモを併用しています。
GUIDE.md:ステージ間で再利用可能な一般的なルールや戦略パターンを蓄積。WORKING.md:現在のタスクの具体的な状態、リアルタイムの進捗、今後の実行計画を記録。
コンテキストウィンドウが上限に近づくと、モデルはまず中間ハンドオーバーサマリーを生成し、その後スムーズに新しいウィンドウへと移行して動作を継続します。既存のテキスト記録、アクションログ、基盤となるビジュアルアセットはすべて完全に引き継がれます。
特筆すべきは、VISTA が視覚履歴の完全な記録を実現しながらも、コンテキストを力任せに埋め尽くすようなアプローチは取っていない点です。
フル機能版の構成では、1 回のターン実行後、フレームワークはデフォルトで最後のフレームのみをアクティブなコンテキストに注入します。アニメーションの遷移フレームはすべて外部ストレージに保持され、指示があった場合にのみオンデマンドで呼び出されます。
この疎結合な設計により、大量の画像フレームによる貴重なコンテキスト容量の圧迫を防ぎつつ、視覚情報の完全性を維持しています。
さらに重要なのは、VISTA がモデルの新たな重み付け学習を一切導入していないという点です。
シーンの理解、推論・意思決定、パスプランニングは完全に既存のマルチモーダル基盤モデルに依存しており、Harness はツールのスケジューリング、経験の管理、証拠の提示に特化しています。
VISTA はモデル構造を根本から作り直すのではなく、マルチモーダルエージェントが視覚的経験を獲得・蓄積・活用するための方法論をエンジニアリングアーキテクチャの観点から刷新したといえます。
実験による検証
ARC-AGI-3 に加え、研究チームは GameWorld、AI GameStore、BabyVision の 3 つのベンチマークでも VISTA の包括的な評価を実施しました。これらは Web ゲーム、迷路ナビゲーション、トポロジーパズルなど多彩なタスクを網羅しています。
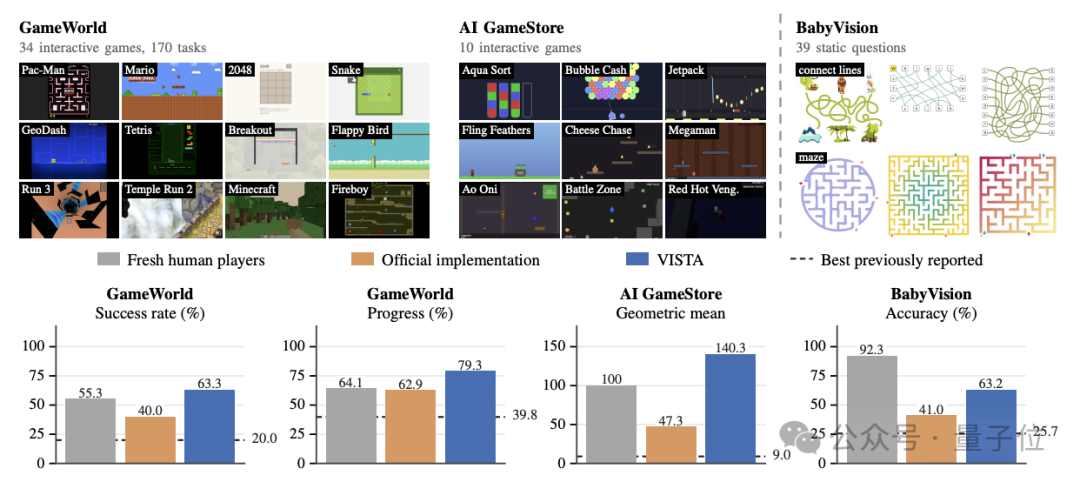
すべて GPT-5.6 Sol をベースモデルとして統一し、公式のベースラインと比較した結果は以下の通りです。
- GameWorld の 170 タスクにおいて、クリア成功率を 40.0% から 63.3% へと大幅に引き上げました。
- AI GameStore の 10 種類のゲームにおいて、総合ベンチマークスコアが 47.3 から 140.3 へと跳ね上がりました(人間の測定値中央値を 100 として正規化)。
- BabyVision から選定された 39 問の静的迷路およびトポロジーパズルにおいて、正解率が 41.0% から 63.2% へと向上しました。純粋な静的タスクであっても、局所的な拡大やピクセルの比較によって推論ロジックの誤りを大幅に是正できることが示されました。
過去の画像を可逆的に蓄積し、必要に応じて検索できるようにすることで、既存の大規模モデルの奥深い視覚的ポテンシャルを劇的に引き出せることがデータによって実証されています。
同一の VISTA パラダイムは、わずかなチューニングのみでまったく異なるゲームロジックやパズル推論タスクへシームレスに適応でき、優れた汎用性を示しています。
研究チームは、今後の展開として物理次元のエンボディド AI タスクに注力すると述べています。変化の激しい非静的な環境下において、モデルがいかに時系列の視覚記憶を効率的に保存・検証・最適化し、より正確な物理的意思決定を下せるかを探求していく予定です。
著者紹介
論文の共同筆頭著者は Qiushi Han 氏、胡珂雅(Keya Hu)氏、Linlu Qiu 氏の 3 名で、責任著者および共同著者には Cathy Wu 氏と何愷明(Kaiming He)氏が名を連ねています。
Qiushi Han(Josh Han)氏は、MIT オペレーションズ・リサーチ・センターの博士課程に在籍中で、Cathy Wu 氏に師事しています。
胡珂雅(Keya Hu)氏は、MIT 電気工学・コンピュータサイエンス学科(EECS)の博士課程に在籍しており、何愷明氏と Jacob Andreas 氏の共同指導を受けています。
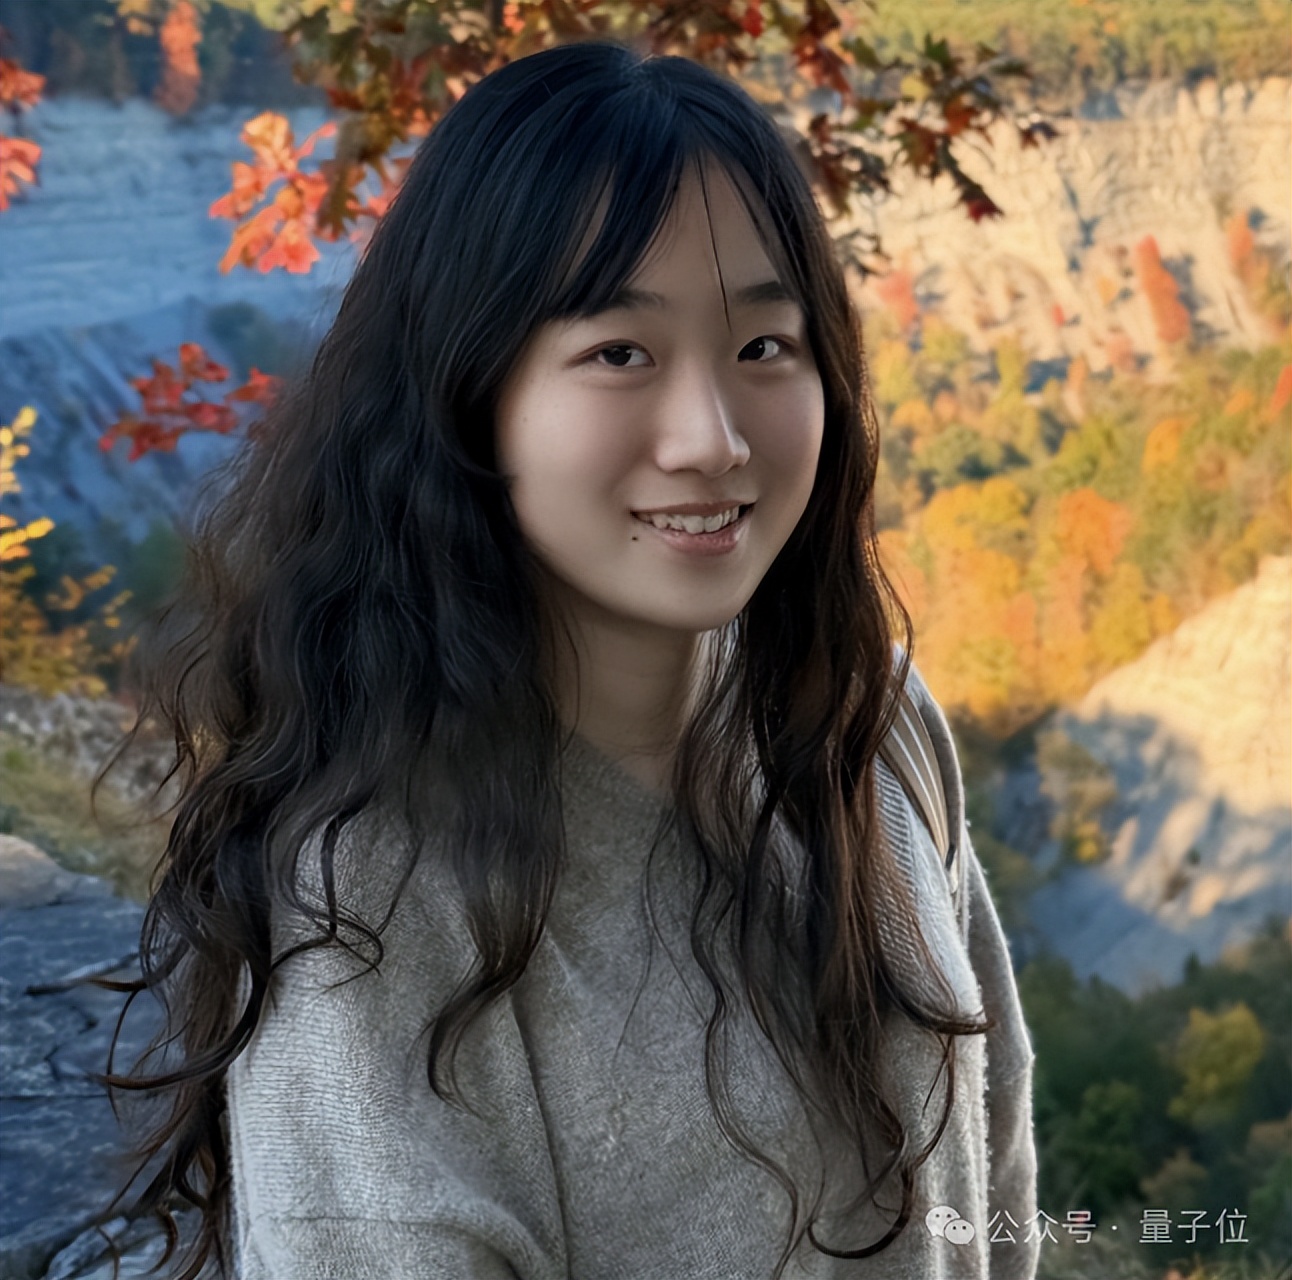
胡珂雅氏は上海交通大学 ACM クラスを卒業後、視覚と言語の融合領域に焦点を当て、高いサンプル効率と強力な汎用性を兼ね備えた汎用エージェントの開発に取り組んでいます。
Linlu Qiu 氏は、MIT EECS およびコンピュータ科学・人工知能研究所(CSAIL)の博士課程に在籍しており、指導教員は Yoon Kim 氏と Jacob Andreas 氏です。
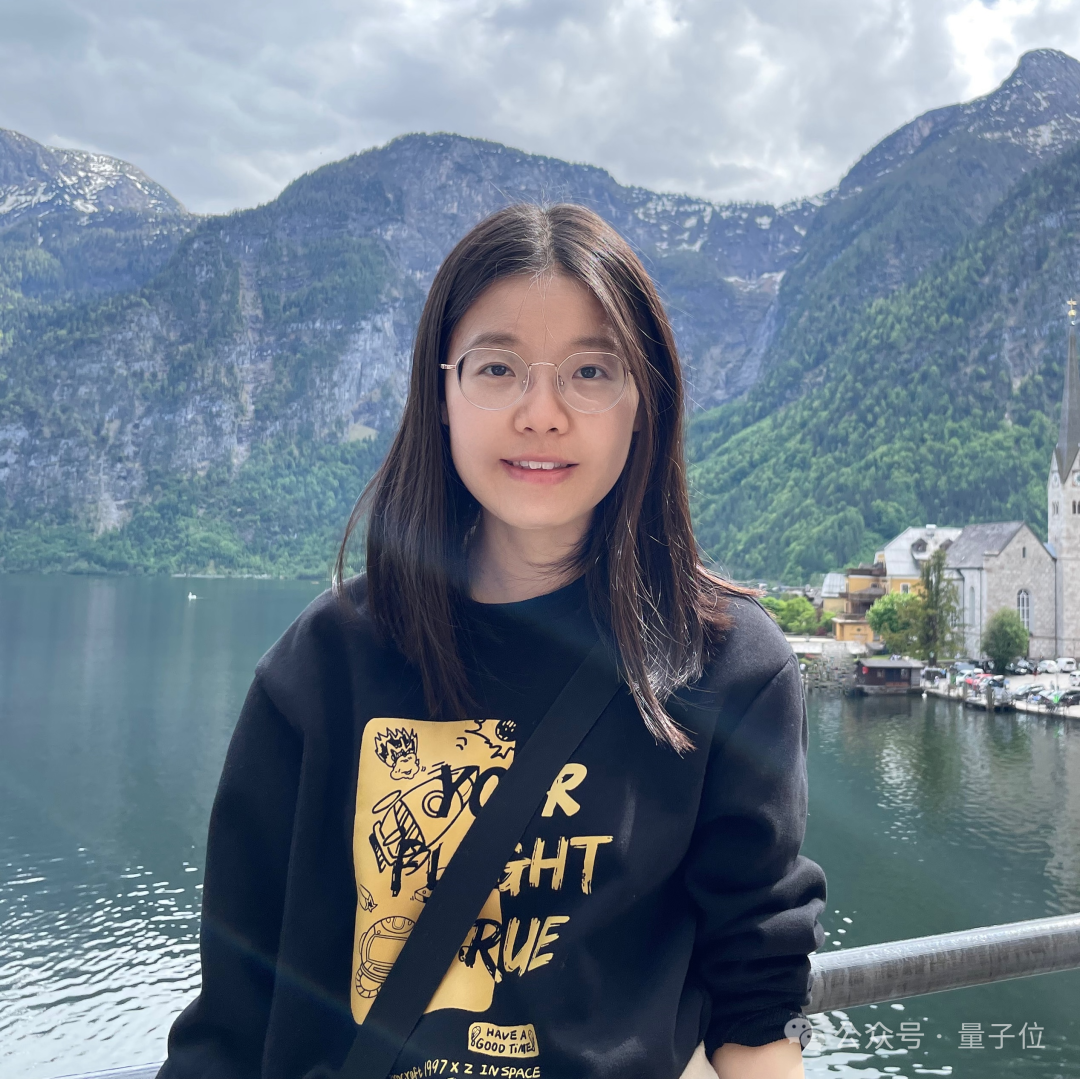
同氏の研究は自然言語処理と機械学習に焦点を当てており、これまで Google Research や Meta FAIR で研究に従事した経歴を持ちます。
Cathy Wu 氏は、MIT 土木・環境工学科およびデータ・システム・社会研究所(IDSS)のアソシエイトプロフェッサー(准教授)を務めており、機械学習と強化学習を用いた複雑な交通システムの最適化などの課題に長年取り組んでいます。
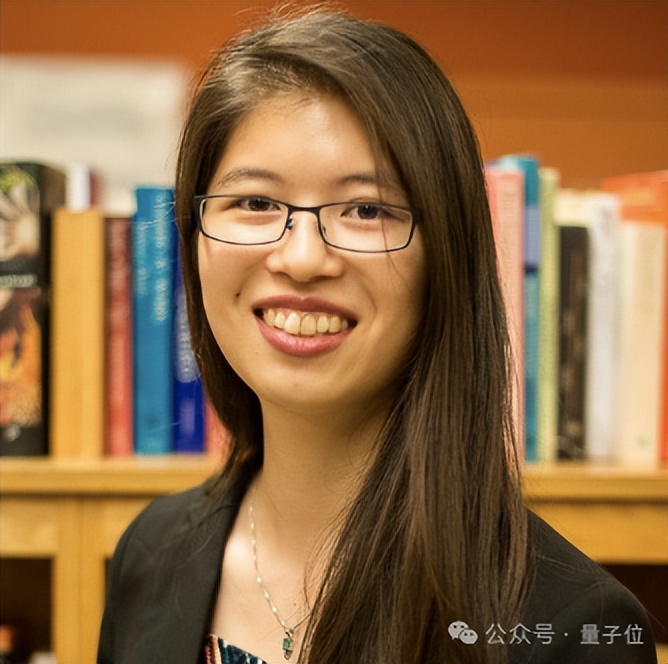
同氏は MIT で学士号および工学修士号を取得し、カリフォルニア大学バークレー校で博士号を取得しました。
何愷明(Kaiming He)氏は、MIT EECS の終身アソシエイトプロフェッサー(テニュア准教授)であり、ResNet、Mask R-CNN、MAE など、コンピュータビジョンにおける金字塔的研究の筆頭著者です。
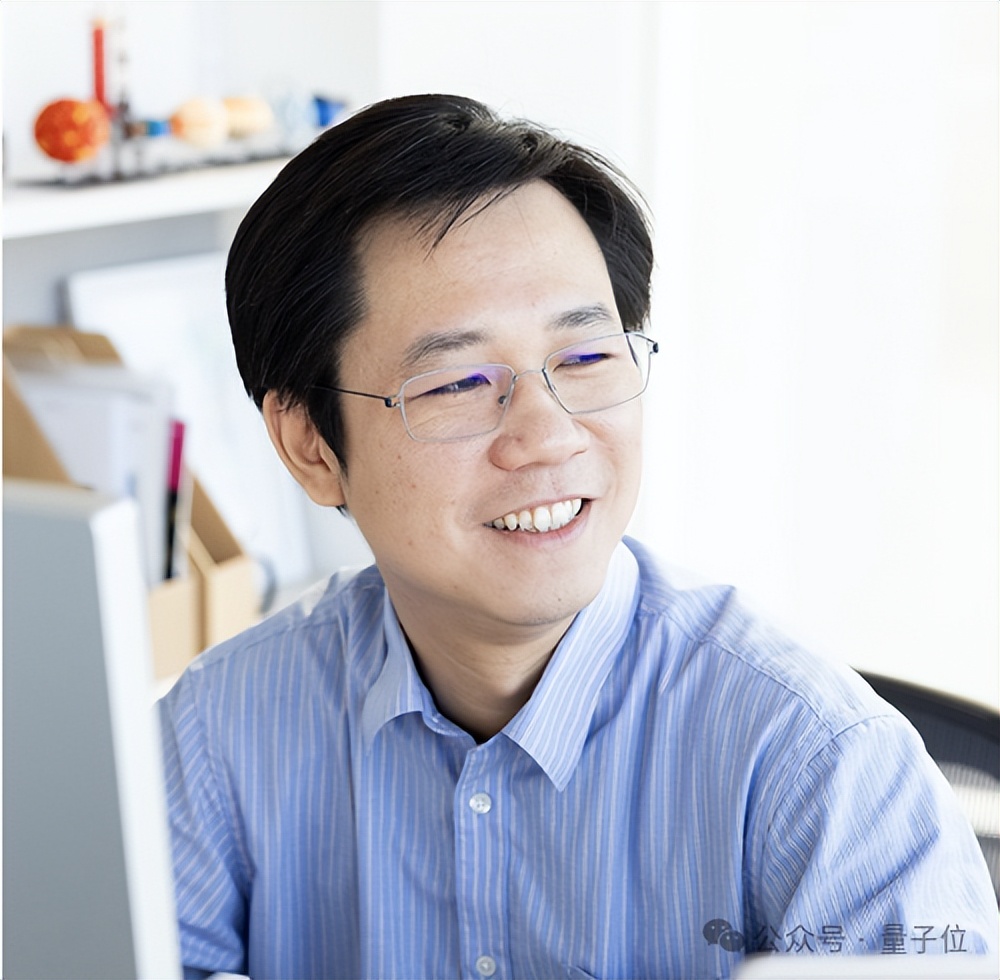
何愷明氏は清華大学を卒業後、香港中文大学で博士号を取得。長年にわたりマイクロソフトリサーチアジア(MSRA)および Meta FAIR に在籍し、2024 年に MIT の教員に着任しました。