
クラスタースケジューラーの構築:完全な占有率を維持しつつ、影響力の高い研究を優先する
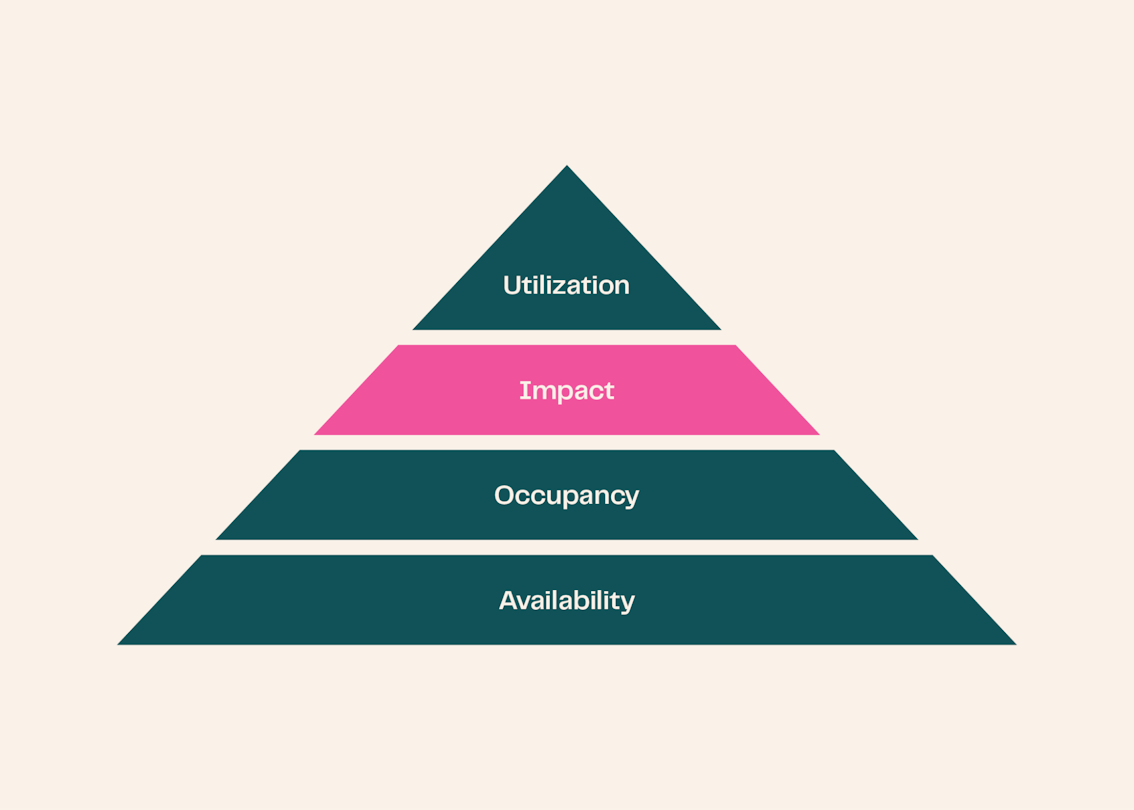
Ai2 の AI インフラチームでは、研究所全体に GPU コンピュート能力を提供し、特に大規模な分散学習ワークロードのサポートに注力しています。私たちはこの責務を、4つの指標からなるピラミッド構造として捉えています。
ピラミッドの土台となるのは可用性(availability)、すなわちハードウェアが健全な状態を保ち、いつでもタスクを実行できる頻度です。その上が**占有率(occupancy)で、特定のワークロードに割り当てられている利用可能時間の割合を指します。さらにその上層が影響力(impact)であり、最も価値の高いワークロードにリソースがどれだけ配分されているかを示します。そしてピラミッドの頂点に位置するのが利用率(utilization)**で、ワークロードのライフサイクル全体を通じて実際に消費された GPU 演算性能の割合です。
本稿では、スケジューリング判断における「影響力」をいかに高めるかについて探ります。最近、私たちは従来の優先度ベースのスケジューラーを廃止し、GPU 時間の予算制、階層型フェアシェア割り当て(hierarchical fair-share allocation)、およびタイムスライシング契約(time-slicing contract)を組み込んだ新たなシステムへと移行しました。これにより、各研究プロジェクトにどれだけの GPU 時間を割り当てるべきかという議論は、都度対応する運用上の雑務から、透明性の高い行政的な予算配分プロセスへと刷新されました。
リソースのオーバーコミット(Overcommitting)
Ai2 では、88基から1024基規模のクラスターに分散された数千基の NVIDIA H100、B200、B300 GPU を管理しています。これらのクラスターは AI モデルの大規模分散学習向けに特化して構築されており、約150名の専属研究者を支援しています。研究領域は、LLM や VLM のフルサイクル学習、ロボティクス向けの強化学習(RL)シミュレーション、科学向けエージェント(scientific agentic)用途の事後学習(post-training)など、多岐にわたる AI 分野をカバーしています。
多くの研究機関と同様に、GPU 時間への需要は供給をはるかに上回っています。投入されるワークロードから見ると、クラスター内で未処理となっているリクエストに必要な GPU 数は、常時、実際に利用可能な GPU 数の2〜3倍に達しています。言い換えれば、クラスター内の利用可能な GPU 1時間ごとに、2〜3件の異なる研究ワークロードが競合している状態です。
以前は、優先度ベースのスケジューラーを採用し、ワークロードごとにプリエンプション(横取り)をオプトアウトできる仕組みにしていました。各チームには、プリエンプションから保護されたワークロードで同時に使用できる GPU 数に上限が設けられていました。一方、プリエンプション可能なワークロードは、空いている GPU 上でその上限を超えて実行することができました。このポリシーは、予想通り不健全な現象を引き起こしました。たとえば、GPU の「場所取り(squatting)」が発生し、ユーザーは必要なときに即座にアクセスできるよう、何もしないアイドル状態のタスク(no-op workloads)を居座らせるようになりました。これは、研究者がリアルタイムで問題を切り分けるためのデバッグ用ワークロードを、十分に低いレイテンシで起動できないと感じていたために生じたものでした。さらに「優先度のインフレーション(priority inflation)」も確認され、最終的にはスケジュールされたタスクの100%が「HIGH(高)」優先度を使用する事態に陥りました。その結果、優先度の低いワークロードは GPU 時間を得る機会を完全に奪われてしまいました。加えて、プリエンプションの可否が任意であったため、オンコール担当のエンジニアのチケット対応時間の多くが、メンテナンス上の問題が判明しているノード上で稼働する「プリエンプション不可」ワークロードをいかに整然とシャットダウンさせるかという調整・交渉に費やされることになりました。
コモンズの悲劇(Tragedy of the commons)
これらの問題が発生した当初、私たちは根本原因をすぐには特定できませんでした。最も重要な作業に GPU 時間を確実に割り当てるための初期の取り組みは、優先度設定のより厳格な管理に偏っており、最終的には優先度ベースのスケジューラーを迂回して、重要プロジェクトに GPU を排他的に占有させる運用へと行き着いてしまいました。当初は気づいていませんでしたが、私たちはまさに「コモンズの悲劇(tragedy of the commons)」を目の当たりにする格好の実験場を作り出してしまっていたのです。希少な共有リソースを取り合う中で、個人が自身の利益を最大化しようと行動した結果、全体としては最適ではない結果を招き、基盤となるリソースの乱用につながってしまいました。
このような現象に直面したのは、私たちが最初ではありません。リソース割り当ては、アルゴリズム開発、経済学、システム管理が融合した非常に興味深い研究分野です。その根本的な課題は、ユーザーの方が組織よりも自身のタスクの価値をよく理解している一方で、その価値を過小申告したり、全体のパフォーマンスを損なってでもリソースを独占し続けたりするインセンティブが働く点にあります。例えば、2011年にドミナント・リソース・フェアネス(Dominant Resource Fairness)を提唱した論文の中で、Ghodsi らはあるエピソードを紹介しています。ある検索エンジン企業が、高い利用率を保証できる場合にのみタスク用の専用マシンを提供したところ、すぐに「ユーザーが利用率を人為的に引き上げるために、コードに無駄な無限ループを乱雑に追加するようになった」ことが発覚しました。ハードウェアは絶えず進化していますが、リソース割り当てを難しくしている本質的な問題は昔も今も変わりません。
スケジュールではなく予算管理(Budgets not schedules)
コモンズの悲劇を解決する古典的な手法は、共有リソースの私有化です。所有者には、自身のアセットの価値を最大化するインセンティブが働きます。私たちがチームに GPU クラスター全体の専有権を割り当てていた際も、実質的にはこのモデルの変形を実践していましたが、その粒度が粗すぎました。研究開発には波(周期的な浮き沈み)があるため、結果として GPU がアイドル状態になることが頻発しました。チームごとに実験や学習の準備が整うタイミングは異なるため、専有権を割り当てる方式では、ある期間には実行するタスクが何もない一方で、別のチームが演算リソースをただ待たされるという事態がどうしても生じてしまいます。
当時の私たちは、動的に変化する研究ニーズを静的なタイムスケジュールに無理やり詰め込もうとして、実質的にナップサック問題(knapsack problem)を手作業で解いているような状態でした。私たちは、アセットの所有権メカニズムがもたらす望ましいインセンティブを活かしつつ、GPU の完全な占有率(full occupancy)も維持したいと考えました。
そこで、所有権モデルを刷新することにしました。チームに GPU ハードウェアそのものを直接割り当てるのではなく、一定割合の「GPU 時間」を配分するように改めたのです。将来の需要を予測するには先端科学の実験結果をあらかじめ知る必要がありますが、それは不可能です。一方で、各研究タスク間の優先順位付けは戦略的な判断事項であり、前もって議論して決定する方がはるかに容易です。スケジューリングの迷路を手探りで解くのをやめ、経営陣が投資家のように考えられるようにしました。つまり、ワークロードが実際に発生する前に、経営陣が潜在的な影響力を評価し、各研究タスクにどれだけの GPU 時間を「投資」するかを決定するのです。スケジューラーは、新しく到着したワークロードの優先順位を決める際に、この情報を活用できるようになります。
この考えに基づき、私たちは管理者が管轄するプロジェクトや研究者に GPU 時間を比例配分できる階層型システム(hierarchical system)を設計しました。下図に示すように、これにより研究戦略が保証された GPU 時間の割り当て枠へと直接落とし込まれます。他でどれだけ多くのプロジェクトがキューに並んでいようとも、プロジェクト A1 はクラスター全体の計算能力の 35% を使用する権利を持っていることが明確に担保されます。
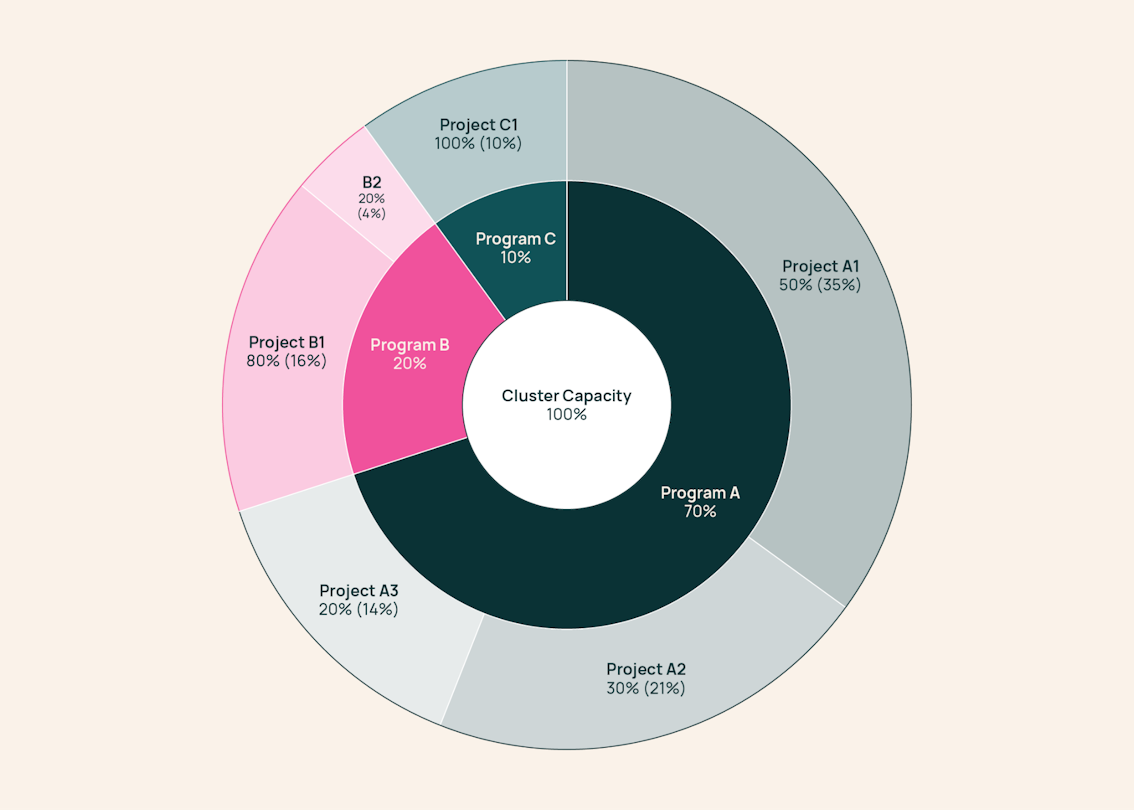
カッコ内の数値は、末端(リーフ)プロジェクトに割り当てられたクラスター総容量の割合を示しています。
このシステムでは、GPU 時間に対するあらゆるリクエストは予算から拠出される必要があり、そうでなければプリエンプション保護の対象外となります。旧システムでは、「HIGH(高)」優先度を指定するのにコストがかからず、さらにプリエンプション不可であったため、あるチームが