
0.2秒。
これは、ロボットが電子レンジのドアを閉める際、人間の手が突然割り込んできたときに緊急停止するまでにかかる時間です。
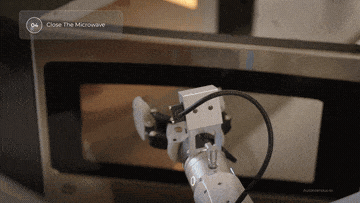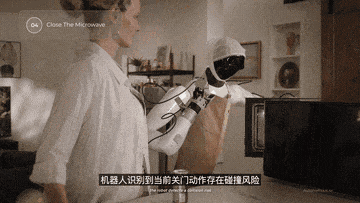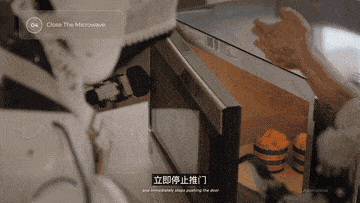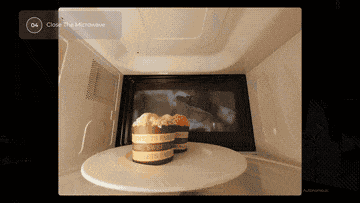
さらに興味深いディテールもあります。
ケーキの皿にアルミ缶が混ざった状態で電子レンジへ運ばれる際、ロボットアームはまず缶をつまみ出して脇に置きます。そして、皿の上が安全であることを確認したうえで、電子レンジへと入れます。
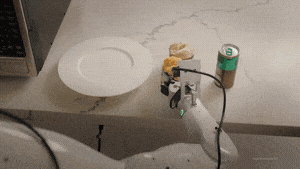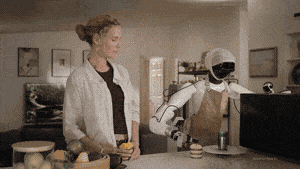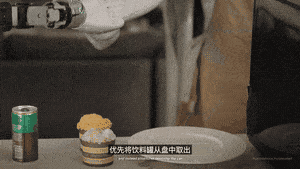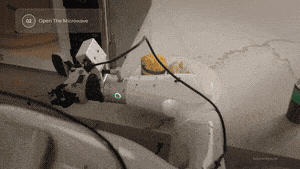
これらの一連のデモ映像を見ると、確かに目を見張るものがあります。
具現化AI(Embodied AI)分野を長く追っている読者なら、身に染みて感じているかもしれません。現在、多くのロボットのデモは一見華やかに見えますが、その大半は「パターンの丸暗記」にすぎません。環境の照明が少し変化したり、物の位置がわずかに動いたり、あるいは人間の指示に少しでも曖昧な意図が含まれていたりすると、ロボットはたちまち停止するか、操作ミスに陥ってしまいます。
しかし今回のテストでは、強力なLED懐中電灯でロボットのビジョンセンサーを直接照射しても、ロボットは安定して作業を継続できました。
これらの映像は、事前に記録された動作軌道の再生でもなければ、確率統計による偶然の産物でもありません。次々と発生する想定外の外乱に対し、システムは物理世界の「因果法則の理解」に基づいて、一連の対応動作をリアルタイムに推論しているのです。
このロボットを駆動しているシステムのコードネームは CRIS-0。
その開発チームは、カリフォルニア大学サンディエゴ校(UCSD)助教授であり、カーネギーメロン大学(CMU)因果学派の研究者でもある黄碧薇(Biwei Huang)氏が創業した因果AIスタートアップ——Aether AI です。
以前、同社が選択した因果推論AIのロードマップについて報じられたことがありました。当時は、因果AIは依然として数式や思考実験の段階にとどまっていると考える人が少なくありませんでしたが、今回、Aether AIは実用的なデモを正式に披露しました。
機械的な「手探り」からの脱却:ロボットが因果関係を理解する
具現化ロボットの実社会への適用において、最も困難な課題は標準的な作業手順ではなく、至る所で発生する予期せぬ外乱です。
従来のロボットは、突発的な外乱に遭遇すると、機械的に古い座標を繰り返して衝突を起こすか、プロセス全体がエラーでフリーズしてしまいます。一方、エンドツーエンドのブラックボックスモデルは、数十ステップにも及ぶ長時間のタスクにおいて誤差が蓄積しやすく、「一歩狂えば、すべてが破綻する」事態に陥りがちです。
CRIS-0が提示したブレイクスルーは「因果」です。ロボットを「何が見えているか」から、「なぜそれが起きたのか、何を変えれば最終結果に影響するのかを理解する」状態へと進化させました。
まず、一連のテストデータを見てみましょう。
外部からの突発的な干渉に対処する「Coffee Preparation(コーヒーの準備)」テストでは、ロボットがコーヒーマシンを掴もうとする際に、人間による位置の移動や急激な照明変化が発生します。CRIS-0は平均2秒以内に因果変数の変化を認識してリアルタイムで再計画を完了し、10回のランダムな外乱に対して9回の有効なリカバリを実現しました。
さらに重要なのは、闇雲にプロセス全体を最初からやり直すわけではないという点です。
コーヒーマシンが押しやられた後、システムは「ハンドルの相対的な位置姿勢」というコアな因果変数を追跡し続けます。変数の状態のズレを検知すると、接近と把持の動作フェーズに限定して修正を行い、原点に戻って再初期化する必要はありません。
耐干渉性は基本機能にすぎず、長時間の自律タスクにおいて、因果駆動のアプローチはその真価をさらに発揮します。
「リビングでの探し物と片付け」のような数十ステップに及ぶ連続タスクにおいて、システムは長期的な目標を検証可能なアトミックな因果フェーズに分解し、各フェーズを進めるごとに事前条件と事後条件のチェックを厳格に実行します。
さらに、CRIS-0は優れた常識推論能力と物理的知覚能力も示しています。
- 文脈理解とプライバシー意識:デスクを片付ける際、散らばった一般的な本はローテーブルにまとめ、個人のプライバシーに関わる請求書は個別に引き出しへ収納します。
- 能動的なインタラクション知覚:見た目が似ている2本の飲料缶を前にした際、まず軽く持ち上げて揺らすことで缶の重さと内部の液体の状態を感知し、空き缶であることを確認してからゴミ箱に捨てます。飲みかけの缶であることを感知した場合は、安定した状態で元の位置に戻します。
曖昧な要求に対しても、因果メカニズムはプロンプトの汎化性を大幅に向上させ、より深いパーソナライズされた理解をもたらします。
「Personal Pick and Place」テストでは、「朝のランニングの後に飲むのに適した飲み物を持ってきて」といった、暗黙的な推論を含む20の曖昧な指示に対して、システムは18回の正確なピッキング&プレースを達成しました。
表面的なキーワードマッチングの運任せにするのではなく、時間帯やユーザーの状態、環境のコンテキストを組み合わせ、「運動後はエネルギー補給が必要であり、過度な糖分は避けるべき」という隠れた因果変数を抽出し、対応する操作プランを自動生成して実行したのです。
CRIS-0の解剖:ブラックボックスを因果エンジンへ改造する
この技術アーキテクチャを読み解くには、まず1つの根本的な問いに答える必要があります。「なぜ従来のロボットはいつも『ぎこちない』のか?」
物理世界と純粋なデジタルの世界には本質的な違いがあります。コンピュータ内でコードを書いたり対話したりする場合、入力ミスはいつでも取り消せます。しかし現実の物理世界では、摩擦、重力、剛体の衝突、光や影の変化といった制御不能な要素が常に発生しています。
従来のVLA(Vision-Language-Action)などのエンドツーエンドモデルは、表現学習のスピードは速いものの、長期的なプロセスタスクにおいて致命的な「誤差の累積」という欠陥を抱えています。ステップ1で生じたわずかなズレがステップ2で拡大し、ステップ10に至る頃には動作全体が完全に破綻してしまうことがあります。さらに深刻なのは、単一のブラックボックスモデルは外部からの干渉を受けた際に原因を特定(帰因)できず、通常は元の計画を機械的に実行し続けるか、システムがクラッシュするしかない点です。
もう1つの一般的なアプローチであるAgent(エージェント)方式は、ステップの分解能力を備えているものの、その基盤となる思考ロジックの大半は純粋なテキストやマルチモーダル大規模言語モデルの確率的推論にとどまっています。環境が変化すると、システムはまず視覚映像をテキストに翻訳し、LLMが「次に何をすべきか」を段階的に推論するのを待つ必要があります。モデルの推論が終わる頃には、現実のロボットアームはすでに衝突を起こしてしまっているかもしれません。
これらの課題に対し、Aether AIは因果ネイティブ(Causal-Native)なAgentアーキテクチャを提案しました。これは主に以下の3つの側面から構成されています。
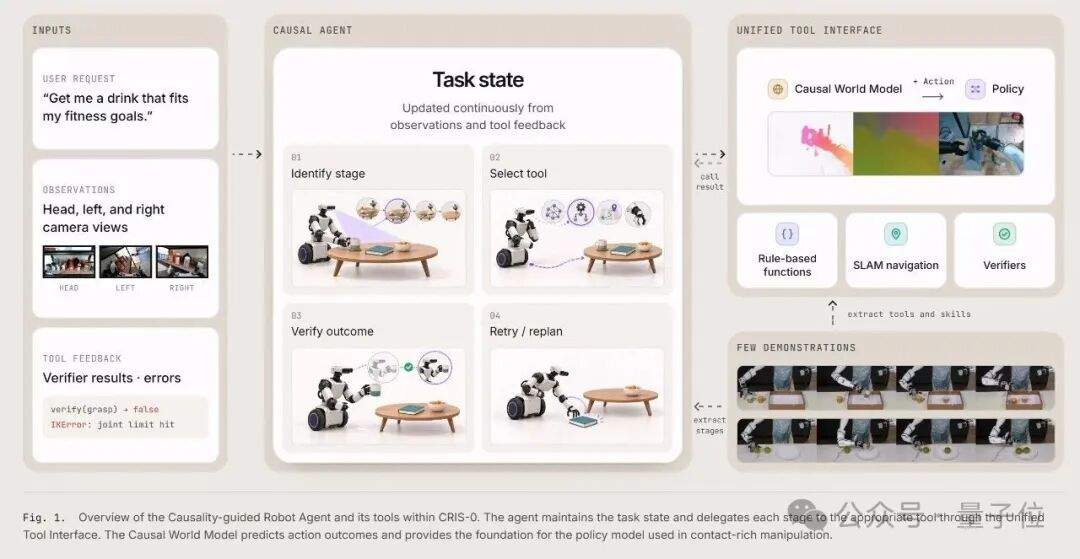
1. タスクを状態として捉える:物理的因果変数の抽出
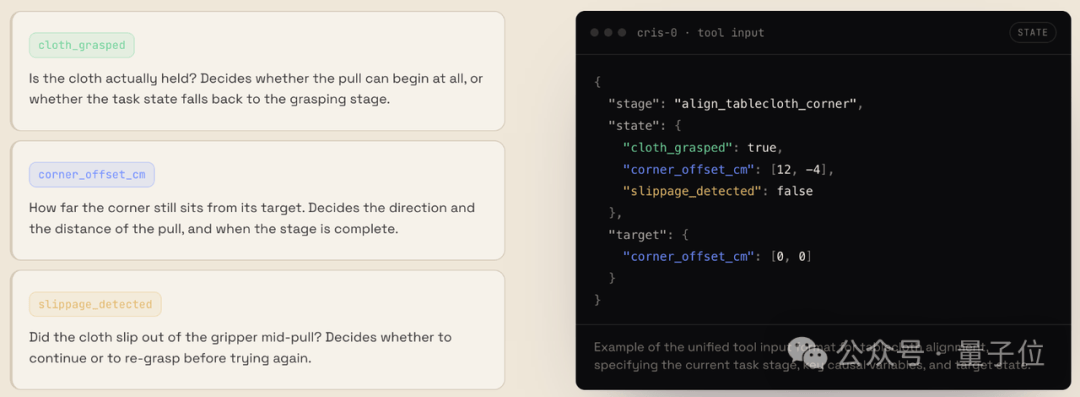
これは、CRIS-0アーキテクチャにおける最も中核的な第一原理の変革です。すなわち、状態と因果変数の統合です。
従来のロボットの知覚システムは主に高次元の画像ピクセルを処理していましたが、CRIS-0が関心を寄せるのは環境の表層的な見え方ではなく、タスクが位置する因果状態の進捗です。
ロボットがテーブルクロスを敷く作業を例にとってみましょう。システムはテーブルクロス全体の各ピクセルの3次元座標を一つひとつ計算するのではなく、いくつかの核となる因果変数をリアルタイムで追跡します。テーブルクロスがグリッパーで安定して把持されているか、テーブルクロスの角と目標位置姿勢との偏差、引っ張る過程で相対的な滑りが発生していないか、などです。
把持が外れて落下した場合、システムは「把持」という因果変数が条件を満たしていないと瞬時に判断し、タスクの状態を直接「再把持」フェーズへロールバックします。作業全体を一からやり直すこともなければ、何もない空間に向かって空振りのまま引っ張り続けることもありません。
コーヒー抽出の外乱テストでは、コーヒーマシンが繰り返し動かされたり急激な照明変化が起きたりしても、システムは平均2秒以内に主要な因果変数の変化を捉えて局所的な再計画を完了し、90%の外乱リカバリ率を達成しました。これこそが因果変数の価値です。想定外の事態が発生した際、システムは障害の発生箇所とロールバックすべき境界を明確に判断できるのです。
2. 統合ツールインターフェース:単一ポリシーへの依存を排除
動作実行のレイヤーにおいて、CRIS-0はTool Call(ツール呼び出し)ベースのモジュール化メカニズムを採用し、Unified Tool Interface(統合ツールインターフェース)を通じて分業と協調を実現しています。
そのアーキテクチャには、マクロなスケジューリングを担当するPlanner(プランナー)が含まれており、基盤となる多様なツールセットを調整します。
- ルールベースの運動関数(Rule-based functions):ビジュアルポジショニングと逆運動学(IK)を組み合わせ、広範囲の空間移動と粗い位置決めを効率的に解決します。
- スキルポリシーモデル(Policy models):水を注ぐ、精密な挿抜を行うなど、難易度の高い接触を伴う作業(Contact-rich tasks)を専門に担当します。
- ナビゲーションモジュール(SLAM):グローバルな移動経路の誘導を担当します。
- 検証器(Verifiers):各主要ノードで物理状態の検証を実行します。
- 因果世界モデル(CausalWM):アクションが引き起こす可能性のある物理的な結果のシミュレーションを担当します。
その中でも、因果世界モデル(CausalWM) が極めて重要なコアとなっています。
現在主流の世界モデルは、リアルな未来の映像フレームを生成することに注力しがちですが、CRIS-0のCausalWMは、アクション(Action)が環境にもたらす実質的な物理的影響により焦点を当てています。
その動作原理は、現在の状態に基づき、候補となるアクションがどの因果変数の変化を引き起こすかを予測し、将来の物理状態を導き出すことにあります。
ロボットアームは、実際のアクションを出力する前に、事前にフォワードシミュレーションを完了させています。アクションBを実行した場合、物理的な因果変数はどのように推移するか、対象の物体は不安定にならないかなどを検証します。シミュレーションモデル上で目標を達成できることが確認されて初めて、Action Headを呼び出して低遅延コントローラーへ出力するのです。
3. 構造化ループとネイティブに組み込まれた安全性
これらのメカニズムは、閉ループシステム(Loop)内で協調して稼働します。
複雑なタスクに直面した際、Plannerは高次元の目標を構造化された実行フローへと分解します。まずルールベースの運動関数を呼び出してエンドエフェクタを目標付近まで素早く移動させ、次に専用のポリシーモデルを呼び出して高精度な接触把持を実行します。単一モデルではエンドツーエンドでの解決が難しかった複雑なタスクが、決定性の高い複数の局所的サブタスクへと分解されます。
このプロセスは、動的に進化するタスクグラフ(Task Graph)を構成します:状態認識 → ツール選択 → 実行 → 検証 → 調整。
各ステップが完了するたびに、検証器は物理的な事前条件/事後条件を即座にチェックします。基準を満たしていない場合、システムに組み込まれた3段階のリカバリメカニズムが順次作動します。まず現在のフェーズで局所的な自己修復を試み、効果がなければ局所的な経路再計画を行い、必要に応じて人間の介入を要請します。特定の外乱に対するリカバリ経路が一度成功すると、そのロジックはタスクグラフに蓄積され、以降の同様のシナリオにおける実行効率が向上します。
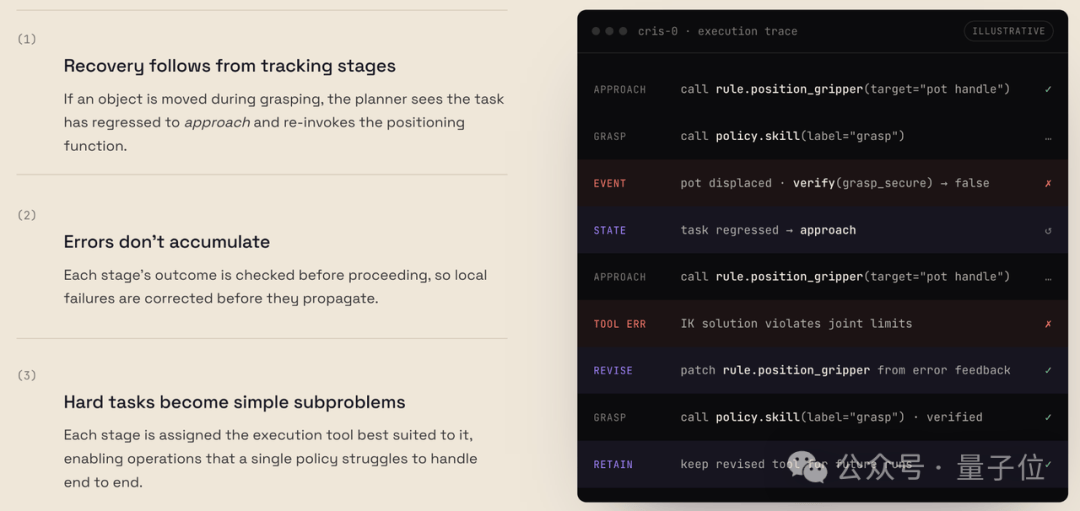
これこそが、リビングでの長時間の片付けタスクにおいて、システムがクラッシュすることなく数十ステップを連続して実行できる理由です。各ステップで因果状態を検証しているため、局所的な誤差は発生した段階で収束・解決され、誤差の拡散チェーンが断ち切られます。
同様に、これが0.2秒の安全緊急停止を実現する基盤ロジックでもあります。
CRIS-0では、安全制約が各因果状態に深く組み込まれています。電子レンジのドアを閉めるフェーズでは、割り込んできた人間の手は安全制約を破る危険な変数として判定され、知覚層で瞬時に捉えられて最高優先度のブレーキがトリガーされ、0.2秒での停止を実現します。一方、現在のタスクが人間にコップを渡すことである場合、差し出された手はインタラクション対象の変数として分類され、システムは通常の協調プロセスを維持します。
CRIS-0が発揮するシステムレベルの能力は、チームが積み重ねてきた先行学術研究に裏付けられています。
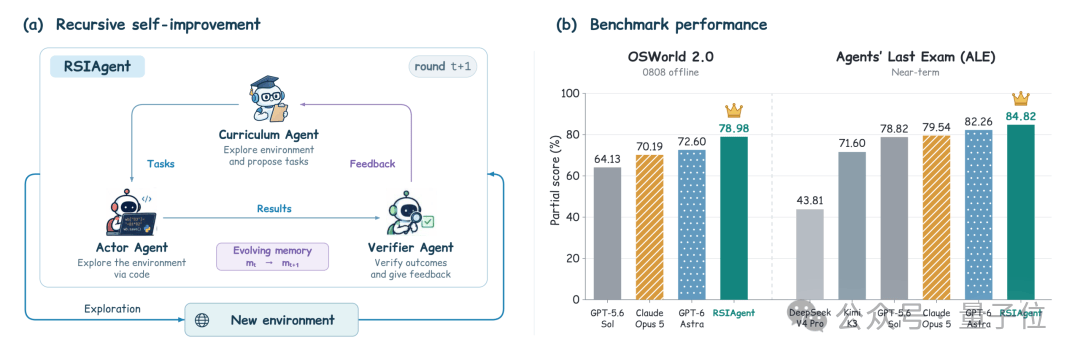
エージェント能力の評価において、Aether AIが以前開発した因果エージェントフレームワーク RSIAgent は、OSWorld 2.0ベンチマークテストで78.98%のPartial Scoreを記録しました。このソリューションは、基盤モデルのパラメータをファインチューニングすることなくオープンソースモデルのAgent能力を向上させ、GPT-6 Astraなどの商用モデルを上回る評価結果を示しました。
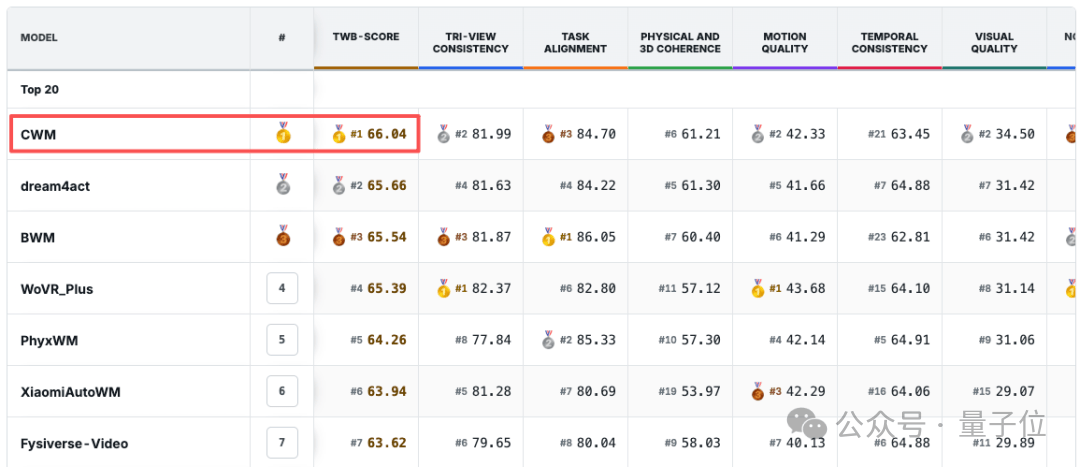
また、同社の第1世代因果世界モデル CausalWM も、ロボット向け世界モデルのベンチマークであるTriWorldBenchにおいて首位(Top-1)を獲得しています。
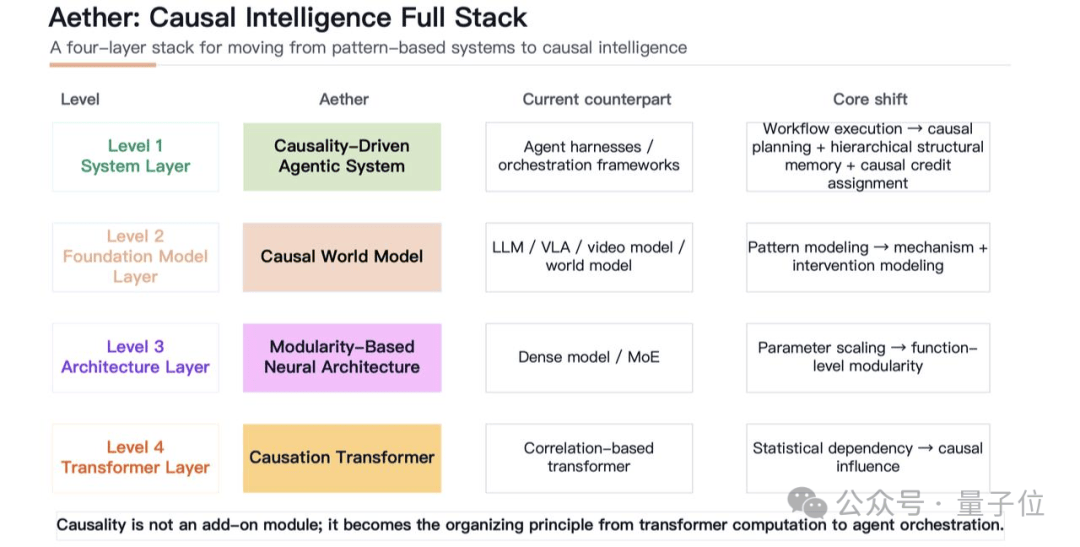
これら2つの技術レイヤーが、今回のシステムデモの中核的な骨格を形成しています。
さらに、この技術体系では別の2つのアーキテクチャの進化も進められています。1つは、異なる物理メカニズムに対応し、組み換えや置き換えが可能なモジュール型ニューラルアーキテクチャ。もう1つは、表面的な統計的相関ではなく因果メカニズムを捉えることに特化した Causation Transformer です。
物理世界は丸暗記を許さない
個別のロボットデモにとどまらず、因果AIが産業界でますます注目されている背景には、具現化AIの根底にあるボトルネックが存在します。
大規模言語モデルの急速な発展は、自然言語そのものが人間による高度に記号化され、抽象化された概念空間であることに大きく支えられています。膨大な常識や論理パターンがテキストの表層にすでに組み込まれており、高次元の確率統計とデータスケールの積み重ねによって、強力な汎化能力を示すことができます。
しかし、現実の物理世界は純粋な確率的推論には従いません。
摩擦や重力などの客観的な法則は絶対的なものであり、テキストデータの統計的分布によって変化することはありません。極めて動的な実世界において、表層的な特徴のフィッティングだけに依存していては、システムはいずれScaling Law(スケーリング則)の限界収穫逓減に直面することになります。
物理的なインタラクションデータが相対的に不足している中で、高いロバスト性を備えた物理インタラクションシステムを構築するには、モデルに科学者のような帰納能力が求められます。すなわち、限られた観測から根底にある因果メカニズムを抽出し、特定の行動が物理世界にどのような変化をもたらすかを推論する能力です。このような因果関係を中心とした構造化モデリングは、具現化AIの分野において新たなスケーリングパラダイムを探索する重要な方向性となりつつあります。
因果探索や因果表現学習は、数学や統計学の理論的基礎に対して極めて高いハードルが要求されるため、深い理論的知見と複雑なシステム工学の実装力を兼ね備えたチームは世界的に見ても希少です。
黄碧薇氏は長年にわたりこの分野を深く探求してきました。CMU因果学派の創始者であるClark Glymour氏、Peter Spirtes氏、著名な研究者であるBernhard Schölkopf氏、Kun Zhang氏らに師事し、因果学派を代表する研究者の一人です。3世代にわたる因果学派の理論的進化が、Aether AIの現在の技術ロードマップの確固たる基盤となっています。
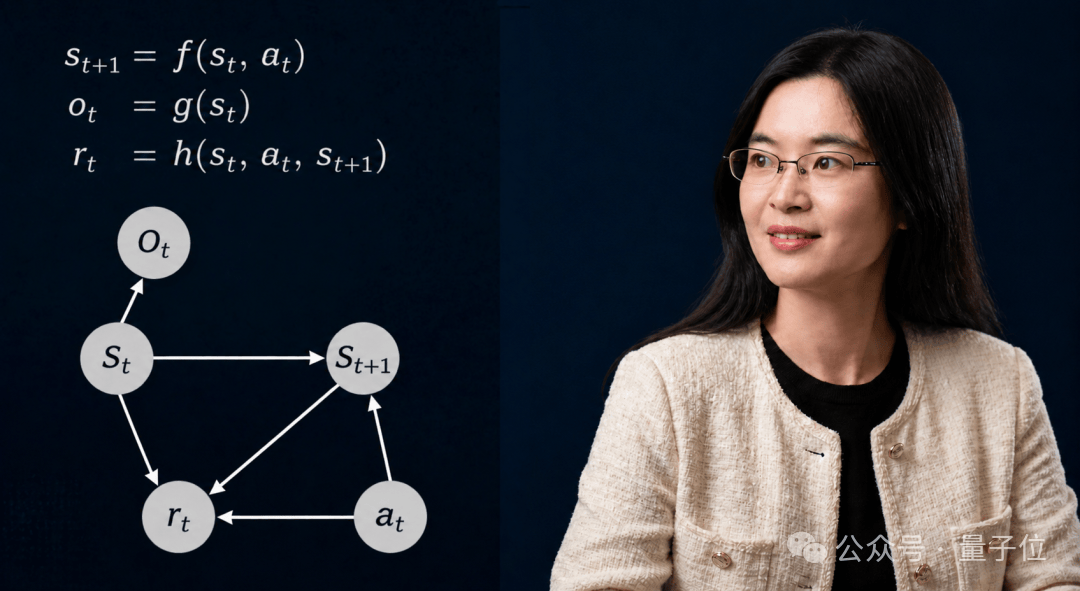
カーネギーメロン大学やマックス・プランク研究所での理論検証から、CRIS-0による実際の物理ロボットアームへの実装に至るまで、因果AIは物理的なインタラクションに向けた決定的な飛躍を遂げました。
ある計算アーキテクチャが因果変数を抽出し、物理的ダイナミクスをモデル化し、行動の前に未来の状態を推論する能力を備えたとき、その応用範囲は家庭用アシスタントにとどまりません。複雑な動的システムにおける長期的なトレンド予測、新規材料の開発、計算生物学などの先端領域においても、因果表現学習は幅広い応用の可能性を秘めています。
AIを純粋なデジタルのチャットボックスから解き放ち、複雑で変化に富んだ現実の物理世界にしっかりと立脚させるための重要な鍵として、因果メカニズムの存在感が急速に高まっています。