
物理世界 AI の次の一歩
AI が画面の中から現実の物理世界へと踏み出すにつれ、マルチモーダルモデルは今、アーキテクチャのパラダイム変革を迎えています。
Om AI 聯汇は、物理世界向けの世界初となるエッジ側ストリーミング型マルチモーダルモデルシリーズ「VLX」を正式に発表しました。業界で初めて「ストリーミング・マルチモーダル」という新しいモデルアーキテクチャを提唱しています。従来の動画理解モデルが、動画全体をフレームに分割して一括でオフライン処理する方式とは異なり、VLX シリーズは物理世界で絶えず流れ込む動画ストリームを対象に、ストリーミング符号化とキャッシュ増分推論によってミリ秒レベルのリアルタイム認識を実現。さらにエッジ側で初めて、「継続認識→精密位置特定→行動判断」という一連の閉ループをつなぎました。
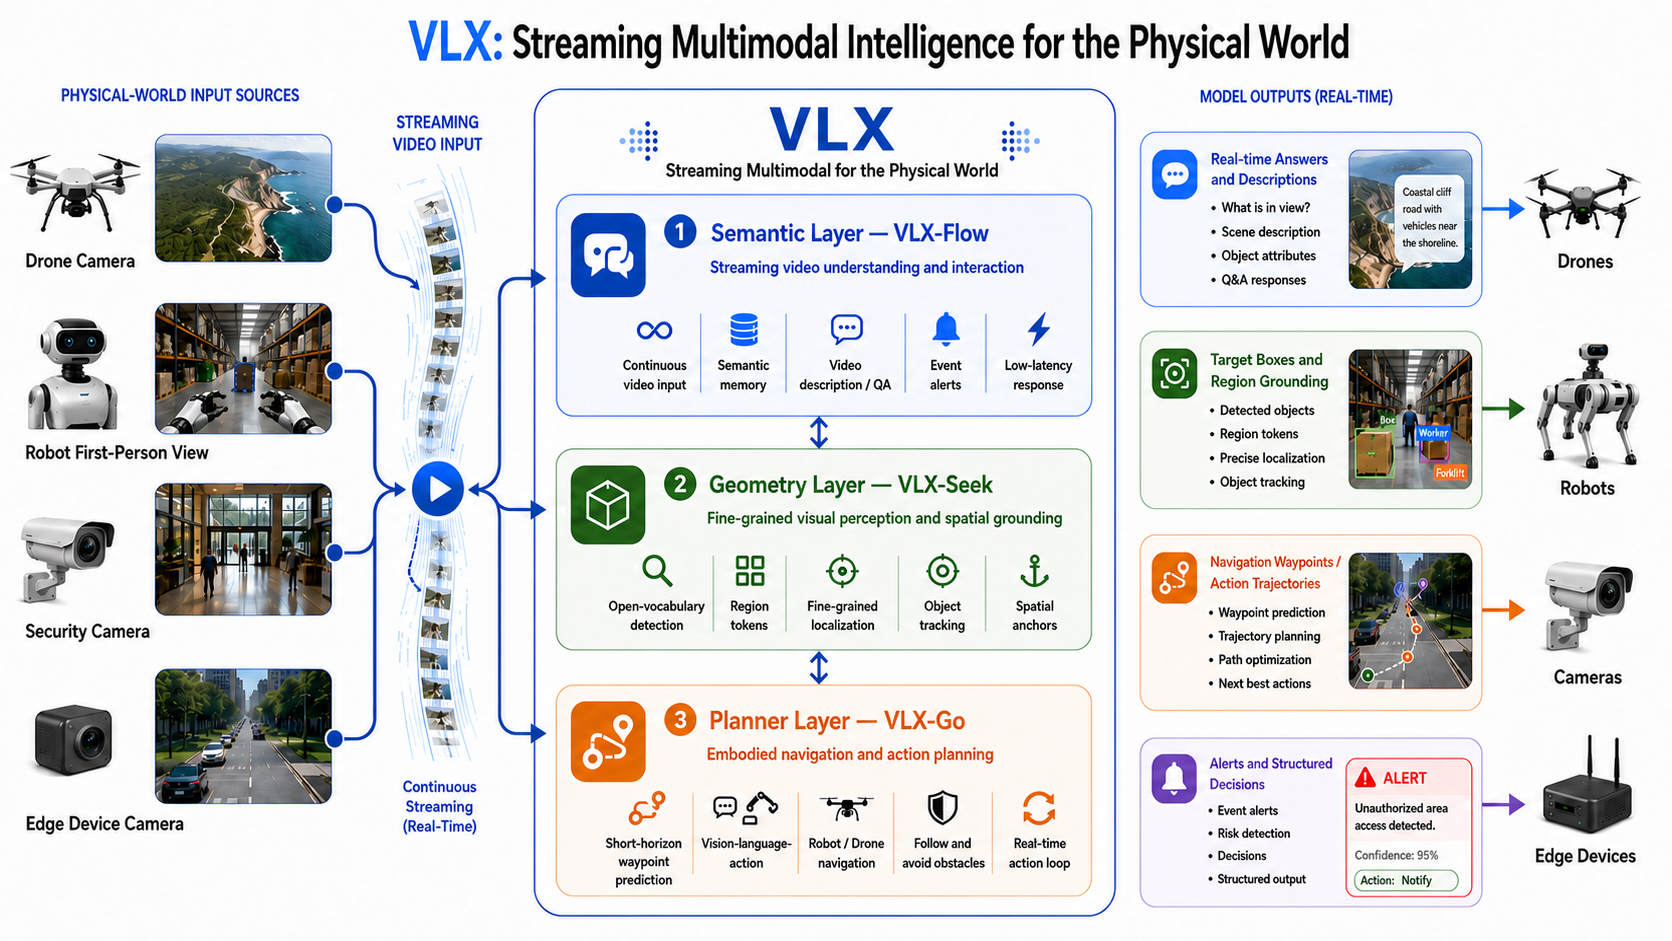
VLX シリーズは、3 つのモデルの協調によって構成され、リアルタイムの物理知能を中心に完整な能力体系を築いています。VLX-Flow は継続認識を担い、増分エンコードとキャッシュ推論の仕組みにより、モデルが人間のように環境を継続的に観察できるようにします。新しい映像は常に取り込み、質問が来た瞬間に応答します。VLX-Seek は精密位置特定を担当し、座標生成を領域検索へと革新的に置き換えます。つまり、モデルに座標を「当てさせる」のではなく、候補領域の中から「領域を選ばせる」ことで、エッジ端末に信頼性の高い空間認識能力を提供します。VLX-Go は行動実行を担い、視覚理解をロボットが実行可能な短期ウェイポイントと移動軌跡へ直接変換します。テキストによる助言を出すのではなく、デバイス自身が追従、障害物回避、ナビゲーションを自律的に完了できるようにします。
この新しいパラダイムでは、視覚情報は「1 枚切り取って」モデルに入るのではなく、「連続する流れ」として継続的に入力されます。モデルは「見終わってから話す」のではなく、「見ながら理解し、必要に応じて自ら行動する」のです。これは単なる「より良い人間と機械の対話体験」ではなく、「AI の自律作業能力が質的に変わる」ことを意味します。
物理世界で AI を実現するには、3 つの硬い制約に真正面から向き合う必要があります。時間は連続的であり、環境は動的に変化し、端末の計算資源は限られています。VLX シリーズは、リアルタイム動画ストリームとエッジデバイスを前提に、ゼロから設計されています。クラウド側のモデルを圧縮して端末に押し込むのではなく、アーキテクチャの段階からエッジ実装の具身知能向けに再設計し、「速い(ストリーミング推論、単一路の最低遅延 0.06 秒)」「小さい(軽量構成、0.6B から 10B までをカバー)」「高精度(高粒度の位置特定)」「実行できる(認識と実行の閉ループ)」という 4 つの強みで、継続認識から行動判断までのエッジ側閉ループを実現します。
マルチモーダルモデルが「画像を見て答える」段階から「継続的に認識する」段階へと進み、AI が画面の中から現実の物理世界へと歩み出すとき、VLX エッジ側ストリーミング型マルチモーダルモデルシリーズは、物理 AI の進化に新しいアーキテクチャのパラダイムを提示します。すべての端末が、継続的な理解、即時の判断、自律的な行動の能力を備えられるようにする——それこそが、物理世界の AI があるべき姿です。