
「コスパモデル」価格は見せかけ値下げ、実質値上げ
クレイシー 発信 凹非寺
量子位 | 公式アカウント QbitAI
ついさっき、Claudeがまた更新された。
ただし今回はフラッグシップではなく、Anthropic が新しいコスパモデル Sonnet 5 を発表した。
A社はこれを、これまでで「最も仕事ができる」Sonnet と位置づけ、タスクの計画を自分で立て、ブラウザやターミナルも呼び出せるとしている。
ベンチマークは自社最上位の Opus 4.8 に迫る一方、価格はその6割ほど。まさに「Opus の代替」といえるモデルだ。
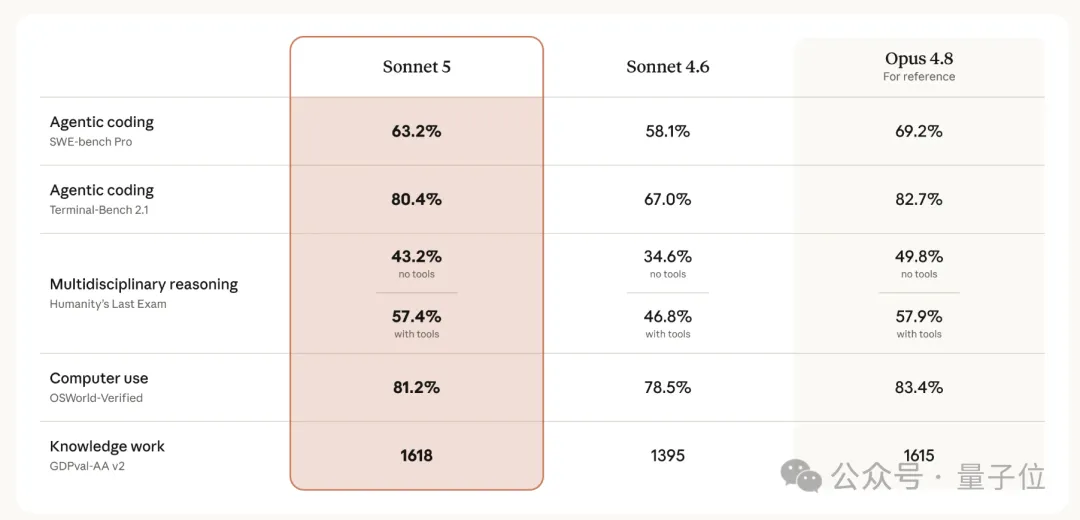
具体的な数字を見ると、agentic coding のベンチマーク SWE-bench Pro では 63.2% を記録し、前世代の Sonnet 4.6 を5ポイント上回った。
価格は 4.6 とまったく同じで、発表会の説明どおりなら、性能は上がって価格は据え置き。
本当に据え置き……なのか?
開発者の Simon Willison は、同じ文章を新旧2つのモデルにそれぞれ入力してトークン数を数えるという、シンプルな検証を行った。
すると、Sonnet 5 は表向きの価格こそ同じでも、請求書上のトークン消費量がひそかに3割増えていることが分かった。
なんてやり方だ、A社。ここでそんな“看板の掛け替え”をやるとは。
「Opus の代替」
Sonnet 5 の今回のアップグレードで特に重視されたのは、Agentic 能力の向上だ。
モデルが自分でタスクを分解し、ブラウザやターミナルといったツールを呼び出して、複数ステップの作業を一気にやり切れる。途中で止まらず、終わったあとには自分の出力を自らチェックするので、人の指示を挟む必要がない。
ベンチマークでも、その伸びがはっきり見える。
agentic coding テストの SWE-bench Pro では、Sonnet 5 が 63.2 点、Sonnet 4.6 が 58.1 点、Opus 4.8 が 69.2 点。Sonnet 5 は両者の間に位置し、Opus との差は 6 点まで縮まった。
computer use テストの OSWorld-Verified では、Sonnet 5 が 81.2%、Opus 4.8 が 83.4% で、差は 2.2 ポイントまで縮小している。
さらに知識労働系のテスト GDPval-AA v2 では、Sonnet 5 が 1618 点を獲得し、なんと Opus 4.8 の 1615 点を3点上回った。
このモデルをいち早く使った2社からのフィードバックも、その傾向を裏づけている。
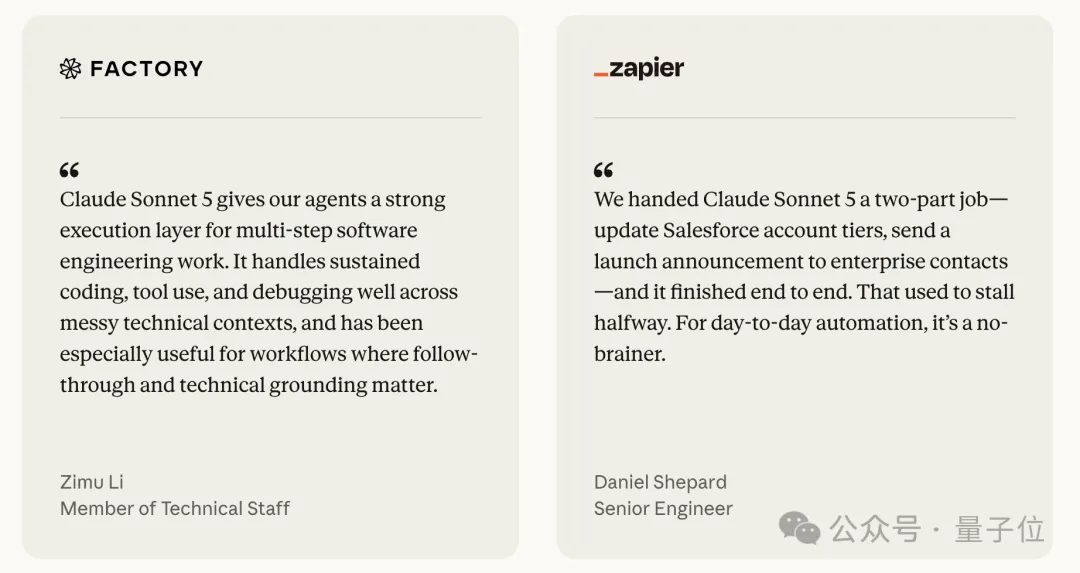
AI コーディングプラットフォーム Factory のエンジニア Zimu Li は、Sonnet 5 が同社のエージェントにしっかりした実行力を与え、散らかった技術環境の中でもコーディング、ツール呼び出し、問題切り分けを継続できると評価した。特に、長時間の追跡が必要で、技術的な細部への要求が高いワークフローに向いているという。
自動化プラットフォーム Zapier のエンジニア Daniel Shepard は、より具体的な例を挙げた。彼らは Sonnet 5 に2段階のタスクを任せた。まず Salesforce の顧客アカウントのランクを更新し、その後、法人顧客に製品リリース告知メールを送る、というものだ。
こうしたタスクは以前、途中で詰まることが多かった。たとえばアカウントの更新まではできても告知メールが送れない、あるいはその逆だ。だが今回は、Sonnet 5 が2つの工程を最初から最後までやり切り、途中で人の引き継ぎを待つこともなかった。
Shepard は、日常の自動化用途なら、迷わずこれを使うべきだと述べている。
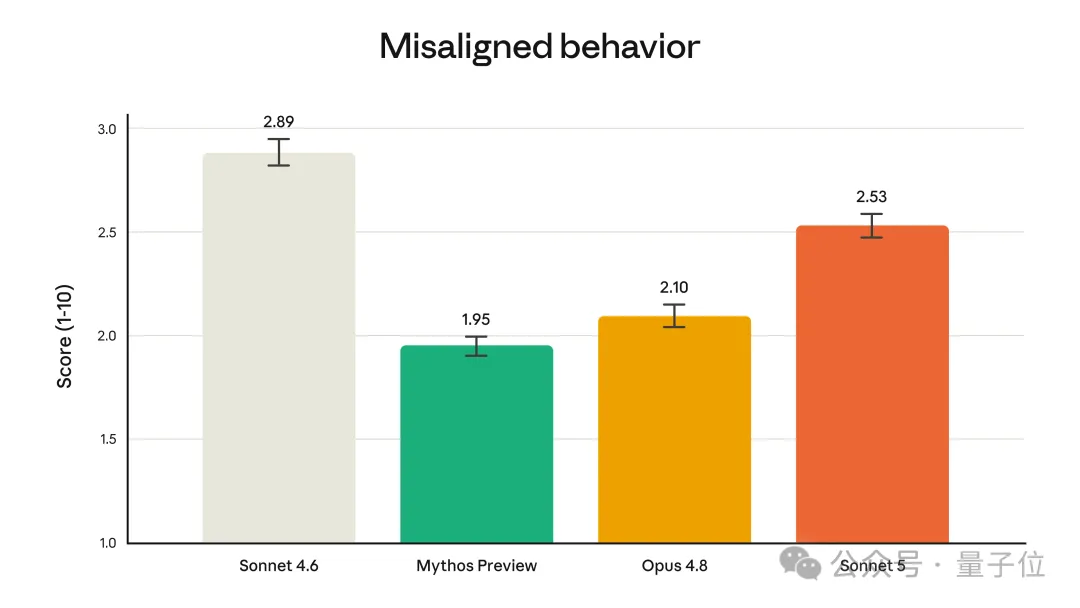
Anthropic があわせて公表した安全性評価も、この流れと整合的だ。
Sonnet 5 は Sonnet 4.6 より幻覚率が低く、迎合的な傾向も抑えられている。さらに、自律的にツールを使う場面では、プロンプトインジェクションのような乗っ取り攻撃への耐性も高い。
しかも、この性能数字を価格の横に並べてみると、意味合いがよりはっきりする。
Opus 4.8 の標準価格は、入力/出力トークン 100万あたり 5/25ドル。一方、Sonnet 5 は 3/15ドルで、Opus のおよそ6割にすぎない。さらに8月末までは期間限定割引があり、その場合は4割ほどになる。
表の上では、性能は相手の9割以上に届き、価格は4〜6割。つまり Sonnet 5 は実質的に Opus の代替モデルだ。
Sonnet 5 は、本当に安いのか?
性能の話はここまで。価格の話になると、別の顔が見えてくる。
Sonnet 5 では新しいトークナイザ、つまり文章をトークンに分割する方式が採用された。
この新トークナイザでは、同じ文章が以前より多くのトークンに分割されるため、計算上の総コストは自然と上がる。
これに気づいたのが、開発者の Simon Willison だ。
彼は公式の「価格は変わらない」という説明をそのまま受け取らず、自作のトークンカウントツールで複数言語の実文書を実測した。
英語版では、Sonnet 4.6 が 2356 トークンだったのに対し、Sonnet 5 は 3341 トークンで 42% 増。スペイン語版も 33% 増えた。
4279 行の Python コードでは、トークン数が 44014 から 56118 に増え、27% 増。
ただし簡体字中国語だけはほとんど変わらず、3334 から 3360 へ、1% 増にとどまった。
同じトークナイザ変更でも、言語によって影響が40ポイント以上も違う。このギャップ自体が、値上げ以上に注目すべき点かもしれない。
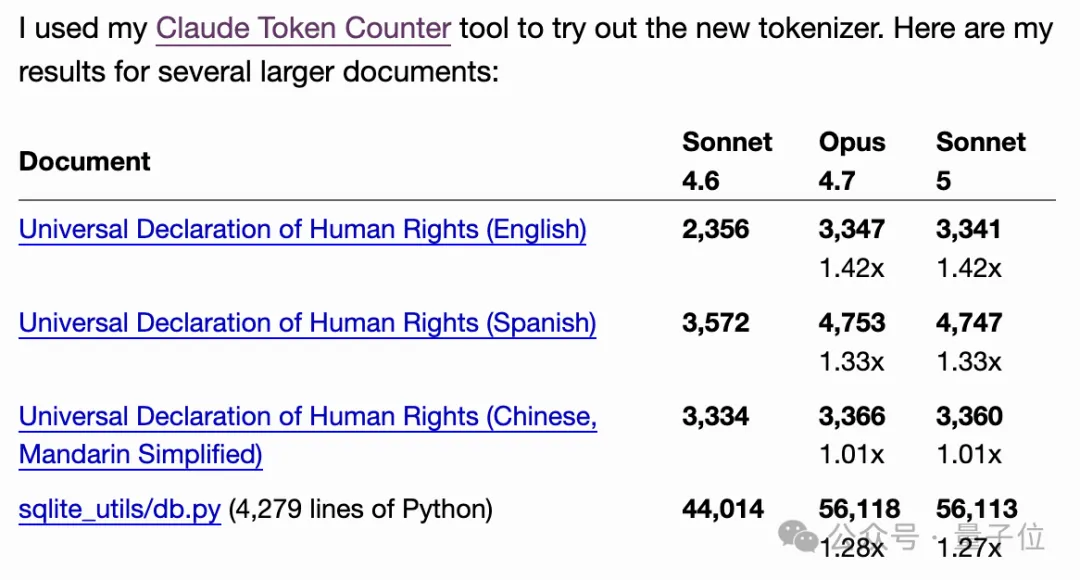
これらの数字を並べると、「単価は変わっていない」という説明は嘘ではないが、全体を言い切ってもいないことが分かる。
同じ英語の文章でも、今では Sonnet 4.6 時代より4割以上多く支払うことになる。
とはいえ、こうなると Opus よりは安いはず……と思いきや、すぐにそれを覆す報告が出てきた。
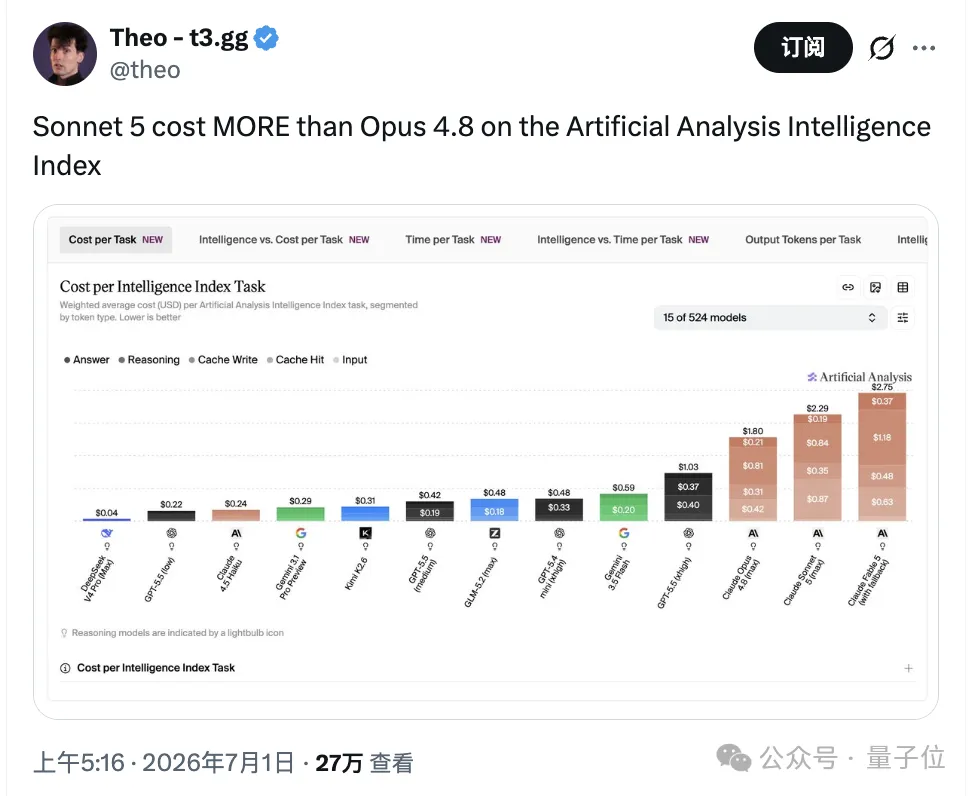
その開発者によると、実運用では Sonnet のほうが Opus より高くつくという。
Artificial Analysis Intelligent Index のあるタスクを実行すると、Opus 4.8 の平均(加重)コストは 1.8ドルだったのに対し、Sonnet 5 は 2.29ドルで、27%高かった。
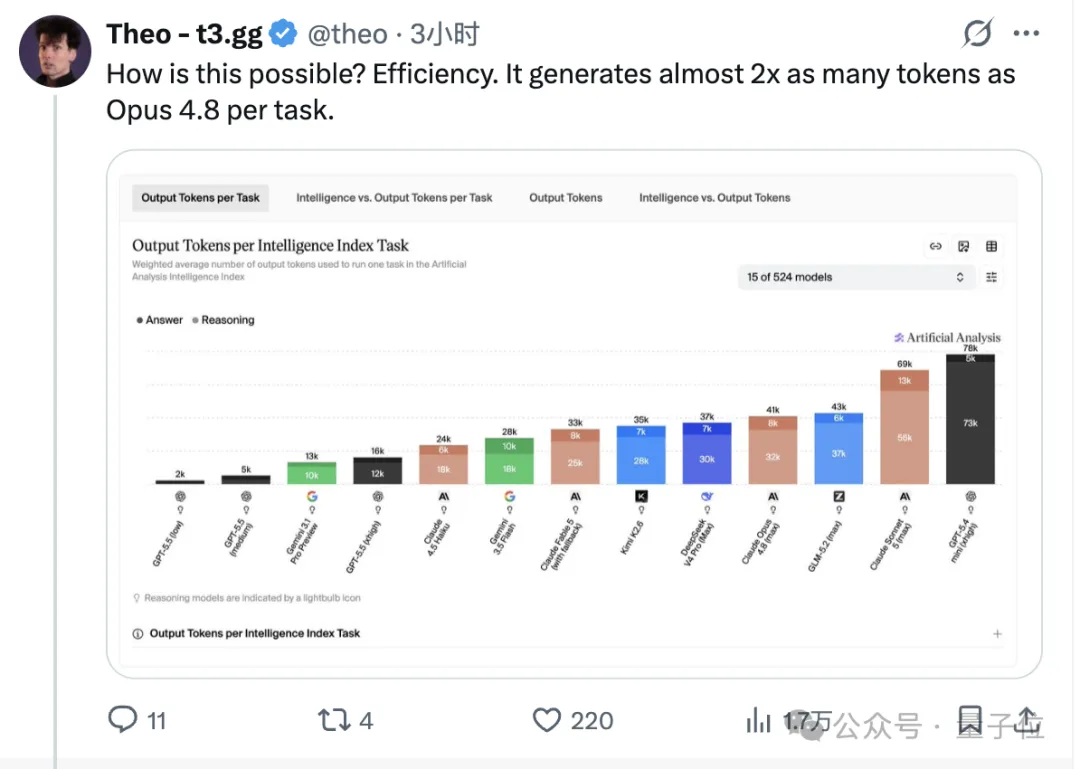
さらに調べると、同じタスクでも Sonnet 5 の消費トークン数は Opus の2倍にも達していた。
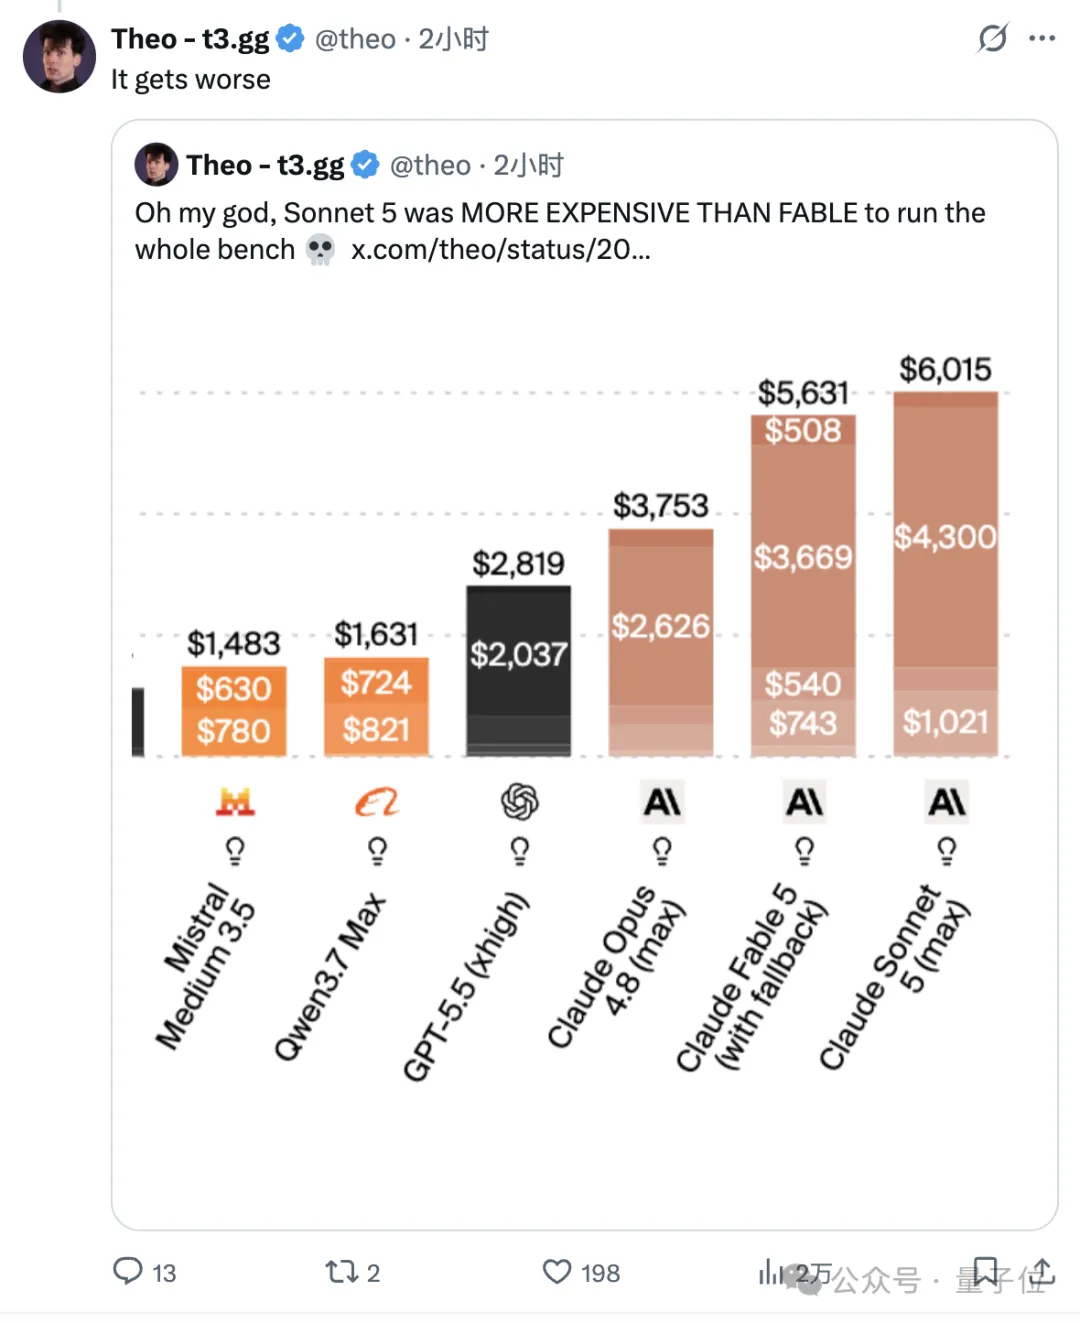
ベンチマーク全体を通した消費量で見ても、Sonnet 5 のコストは fable より 6.8% 高かった。
幸い、この違いはトークンカウントツールで正確に測れる。Willison が発表当日の夜に、こうした「隠れ値上げ」をすぐ明るみに出せたのもそのためだ。
一般ユーザーなら、月末の請求書を見て初めて「今月、なんだか高い気がする」とぼんやり気づくくらいだろう。まさに気づかぬうちにやられるわけだ。
開発者はどう選ぶべきか?
この Sonnet 5 の「表向き値下げ、実質値上げ」を業界全体の流れに重ねると、値上げ自体はここ2年ほど珍しくない。本当の違いは、そのやり方にある。
OpenAI は今年4月、GPT-5.5 の価格改定を行ったが、こちらは正面からの値上げだった。入力/出力トークン100万あたりの価格を 2.5/15ドルから 5/30ドルへと、ちょうど倍にしたのだ。価格ページを開けば、誰でも数字の変化が分かる。
一方 Sonnet 5 は別の道を選んだ。価格欄の数字は1文字も変えず、値上げ分をトークナイザ更新という技術的な細部に隠した。自分で測らなければ気づけない。
Sonnet 5 へのワークフロー移行を考えている開発者にとって大事なのは、「価格表が変わったかどうか」を覚えることより、まず自分の実データをトークンカウントツールで測り、実際の料金を見積もることだ。
結局のところ、価格表で分かるのは単価だけ。請求書で初めて、本当にいくらかかるのかが見える。
密かに書き換えられた請求書。実は「Opus の代替」という言葉も、その裏表にすぎない。
Sonnet 5 は確かに、より低い価格で Opus に近い能力を手に入れた。ただ今回は、その「より低い価格」の裏に、目盛りの変わった物差しが隠れていたのだ。
最後に、別の開発者は視野を広げれば、Claude だけが選択肢ではないと指摘している。
この開発者によれば、Sonnet は A社内ではコスパの高い選択肢だが、智譜 GLM-5.2 の性能は Sonnet 5 とほぼ同等だという。
しかも価格面では、GLM-5.2 の入力価格は Sonnet 5 の7割にすぎず、出力価格に至っては半分にも満たない。
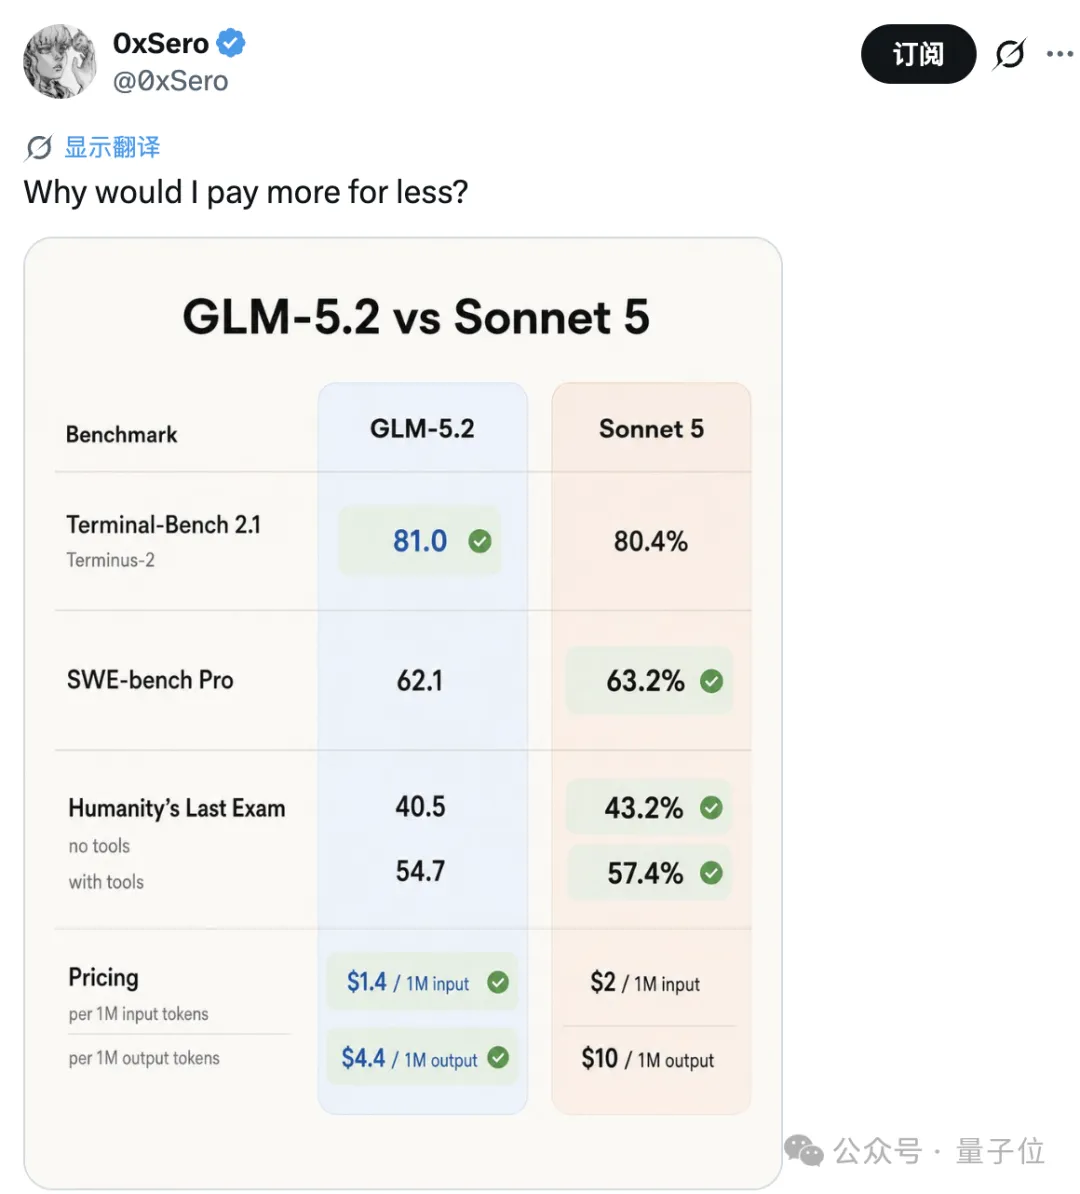
この開発者の言葉を借りれば、わざわざもっと高い金額を払って、より少ないものを買う必要があるのだろうか。
参考リンク:
[1]https://www.anthropic.com/news/claude-sonnet-5
[2]https://simonwillison.net/2026/Jun/30/claude-sonnet-5/