
Hugging Face Community Evals が EvalEval とどのように連携するか
Every Eval Ever(EEE)と Hugging Face Community Evals は、すでに相互互換になっています。オープンソースモデル、ランキング、標準化された一元的なメタデータストレージと結びつけながら、評価結果の相互公開と解釈を支援します。
EEE は 2026 年 2 月に EvalEval Coalition のプロジェクトとして公開されました。これは、AI の評価結果が当事者や第三者によって報告される際、その見せ方を改善することを目的とした、機関横断の初の取り組みです。Hugging Face も同じく 2026 年 2 月に Community Evals を公開し、Hub 上のベンチマークスコアを分散的に管理できるようにしました。両者を組み合わせることで、評価やモデルを信頼し、理解し、選択する際にユーザー、研究者、政策立案者が直面していたギャップを埋めます。
評価結果は、モデルの能力を測定し、モデル同士を比較し、推論の安全性やガバナンスを考えるための手段です。しかし、こうした結果はしばしば分散していて、比較しづらいものです。論文、ランキング、ブログ記事、評価フレームワークのログなど、さまざまな場所に存在し、しかも形式もバラバラです。同じモデルを同じベンチマークで評価しても、実行者や設定が違えば異なるスコアになることは珍しくありません。たとえば、LLaMA 65B は MMLU で 63.7 と 48.8 という 2 つの異なる結果が報告されたことがあります。こうした差は、私たちが確認しているにもかかわらず、広く報告されていない評価設定に起因する場合があります。
EEE が解決するのは、結果の報告に関する問題です。評価結果を記述するための JSON schema を用意し、以下を記録します。
- 誰が評価を実行したか
- どのモデルか
- どのようにアクセスしたか
- 生成設定
- 指標が実際に何を意味するか
- [推奨] サンプル単位の出力に対応する JSONL ファイル
この schema は研究者や政策研究者からのフィードバックをもとに設計されており、あらゆるソースからの結果を受け付けます。そのため、評価フレームワークのログ、ランキングのスクレイピング結果、論文中の数値なども、最終的にはすべて同じ形式に統一されます。GitHub リポジトリ には、変換ツール、サンプル、コントリビューションガイドが用意されています。公開以来、Hugging Face 上の datastore は約 22.9 万件の評価結果まで拡大し、2.2 万以上のモデル、2200 のベンチマーク、31 種類の異なる報告形式をカバーしています。これらを最初から再実行するには数十万ドルかかる可能性があり、すでにコストをかけて生成したデータを再び散逸させるべきではないことがよく分かります。
この schema やコントリビュート方法の詳細は、こちら をご覧ください。
そして今、さらに良い統合と帰属表示が可能になりました。コントリビューターは EEE の結果を Hugging Face Community Evals に送信できます。私たちは変換ツールを用意し、EEE のレコードを Hugging Face が必要とする小さな YAML ファイルに書き出せるようにしました。これにより、同じ結果を 2 つの形式で手作業管理する必要がありません。
これは既存の EEE コントリビューター向けの新機能であるだけでなく、評価結果を公開・閲覧するすべての人に関係します。自分のモデルを一方評価する人も、他人のモデルを第三者評価する人も、Community Evals と EEE の両方へ同時に投稿できます。一方、Hub 上で閲覧する人は、完全な記録までたどれる結果を見ることができます。所属機関の公式 Hugging Face アカウントからデータを送信すると、結果には EvalEval 上で検証済みバッジが表示され、数値が直接ソースから来ていることを読者に示せます。以下では、Community Evals の仕組みと変換ツールの役割を紹介します。
Hugging Face Community Evals は EvalEval とどのように連携するか
Hugging Face Community Evals には 2 つの構成要素があります。
ベンチマークはデータセットリポジトリに置かれ、eval.yaml を追加することで登録します。登録されると、そのデータセットページには、Hub 全体で報告されたそのベンチマークのスコアが集約され、ランキングとして表示されます。公式ベンチマーク の一覧も継続的に拡充されています。
モデルのスコアは、モデルリポジトリ内の .eval_results/*.yaml に保存されます。これらはモデルカードに表示され、対応するベンチマークのランキングにも反映されます。モデル作者自身が提出した結果も、誰かが pull request で提出した結果も集約され、各スコアには、それが作者提出、コミュニティ提出、または独立検証済みのいずれかを示すバッジが付きます。誰でも、正しい YAML ファイルを含む PR を送ることで任意のモデルにスコアを追加できますし、モデル作者は PR を閉じたり、自分のリポジトリ内で結果を非表示にしたりできます。
以下は、そのランキングの例です。
Hub 上の Humanity’s Last Exam における Community Evals のランキング
これが EEE と Community Evals が結びつくポイントです。ある結果を両方に送ると、2 つのことが起こります。1 つ目は、そのスコアが Hugging Face のモデルページに表示され、対象ベンチマークのランキングに取り込まれること。2 つ目は、その結果にソースバッジが付与され、生成設定、フレームワークのバージョン、再現性に関する説明、さらにはインスタンス単位のデータを含む完全な EEE レコードへ直接リンクされることです。
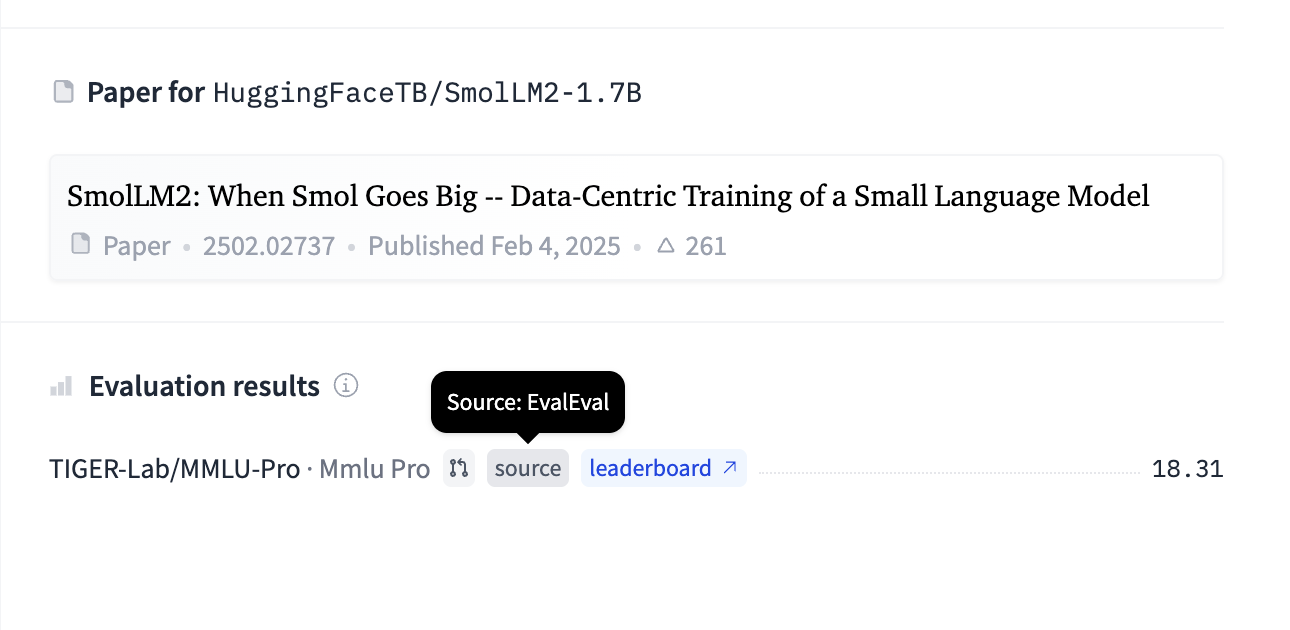
EEE datastore の評価(MMLU-Pro)が、ファイルレベルで Hugging Face のモデルカード(b)と相互リンクされています。ソースの EvalEval バッジは完全な JSON レコードへリンクします。
この 2 つの行き先は、同じ目標に対して異なる役割を担っています。Hugging Face は、結果を人々がモデルを見る場所に置き、ソースへのリンクを添えます。EEE は、結果を解釈可能にするための完全な構造化レコードを保持し、その上で Eval Cards を支えます。 データを両方に送ることで、1 つの評価結果を「見える」状態と「読める」状態の両方にできるのです。それこそが、評価を公開する意義です。
この相互運用性は、下で確認できます。上のモデルカードに表示されていたのと同じ GPQA のスコアが、Eval Cards 上でもレンダリングされます。Eval Cards は EEE の実行データとベンチマークおよびモデルのメタデータを組み合わせ、解釈可能なレコードにします。同じ評価結果でも、表示のされ方が異なるだけです。
仕組み
Hugging Face は評価スコアをモデルリポジトリに保存します