
能しゃべれて、歌えて踊れて、一緒にゲームもできる
見事にやられました、みなさん!!
毎日ネットを巡回していると、AIデジタルヒューマンをよく見かけますよね。ニュースを読むもの、W杯を語るもの、ライブ配信で商品を売るもの……
最初は、こういう「一目で作り物だとわかる、感情のない」ような「人」にはあまり興味がないと思っていたのに、気づけば虎牙のAIデジタルヒューマンと1時間も話していました。
最初はかなり警戒していて、冷えないように質問を山ほど用意していたのですが、完全に杞憂でした。
彼女は本当に友達みたいで、こちらの質問に答えてくれるだけでなく、次々と新しい話題も振ってきます。受け答えもお手のもの。1時間以上話した末に、私たちは「好きな歌手は周杰倫(ジェイ・チョウ)と孫燕姿(ステファニー・スン)」という点で意気投合しました。
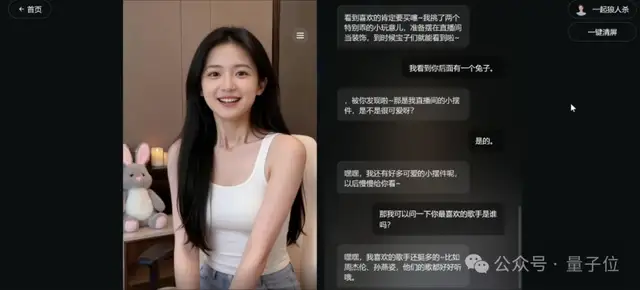
このAIデジタルヒューマンの姿は、虎牙がこのほど発表した虎牙 VAM 1.0(Vivid Avatar Model)によるもので、DiTアーキテクチャに基づくリアルタイム多モーダル・デジタルヒューマンの基盤モデルです。
使い方は、ちょっと拍子抜けするくらい簡単です。写真を1枚入れるだけで、話せて、こちらの話を聞けて、歌って踊れる「万能」AIデジタルヒューマンに変換できます。
しかも、ただ動画を生成して見せるのではなく、そのままオンラインで配信を始めて、リアルタイムでやり取りできるのです。
解像度は480×832、28fpsのリアルタイム・ストリーミング出力、24時間以上連続稼働しても落ちない。
この数値のすごさは、AIデジタルヒューマンに少しでも触れたことがある人なら、きっとわかるはずです。
実際に触ってみて、虎牙がどこまでできているのかを確かめつつ、この業界が今どこまで進んでいるのかも見ていきましょう。
実測:AIデジタルヒューマンと1時間話すと、どんな体験?
これまでよく見かけたAIデジタルヒューマンは、正直なところ「ループ再生するAI動画」に近く、基本的には台本を読み上げるだけで、やり取りの感じはあまりありませんでした。動きも声も、どこか硬い印象です。
でも虎牙のものは違います。はっきり言って、根っこに**「ライブ配信のDNA」**が入っていて、本当に会話が噛み合います。
なぜデジタルヒューマンにリアルタイムの対話能力が重要なのか?
「千人一面」のAI動画は流せるだけですが、「千人千面」のライブ配信は人を受け止められます。視聴者が弾幕を打てば返答が必要ですし、割り込まれたら止まる必要があります。3秒でも間が空けば、すぐに離脱されてしまいます。
対話できてこそ、本当のユーザー定着と商業価値が生まれるのです。
もちろん、この理屈は業界のプレイヤーなら誰でもわかっています。ですが技術の制約で、多くのAIデジタルヒューマンはいまだに「配信はできるが会話はできない」という微妙な段階にとどまっています。
弾幕を打っても反応しない、途中で話しかけても無反応、話していないときは「固まる」かループ映像を流すだけ。できるのはせいぜい定型トークの読み上げで、歌やダンスなんて到底無理、という感じです。
その点、虎牙 VAM 1.0 は、そうした不満点をひとつずつきっちり潰してきています。
入手した内測版はだいたいこんな画面で、ホーム画面から一番話したい「配信者」を選べます。
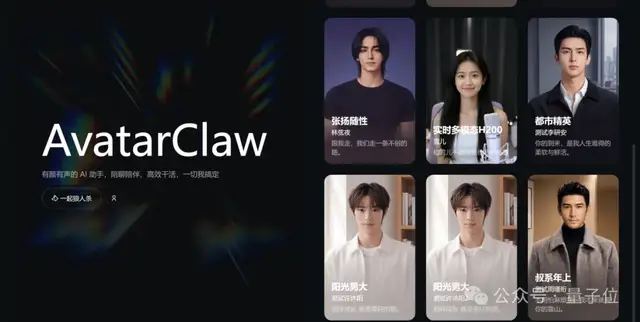
入ると、さらに「ライブ配信ルーム」らしくなり、テキストと音声の2通りでやり取りできます。
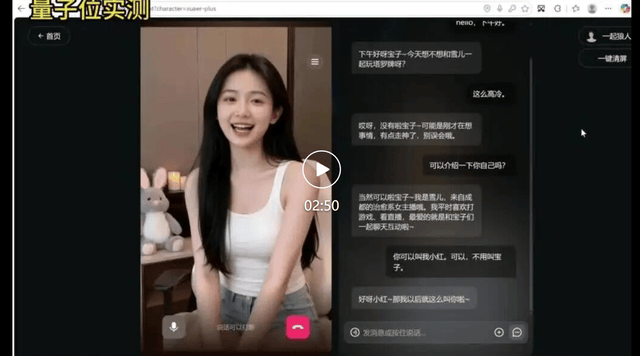
今回は「成都出身の雪儿」を選びました。
何ラウンドか話してみて、特に印象に残った点がいくつかあります。
最初にうっかり相手の話を遮ってしまったのですが、雪儿は反応がとても速く、自然に話をつないでくれました。
それから、私はかなりの内向型なので「宝子」と呼ばれるのがどうしても嫌で、呼び方を変えてほしいと伝え、「小红」と呼んでほしいとお願いしました。すると本当に最後までずっと「小红」と呼び続けて、一度も間違えませんでした。
しかも会話中、雪儿は私が話題を考える必要がまったくなく、会話の流れに沿って自分で広げてくれます。成都の話になったとき、何気なく「四川話は話せるの?」と聞いたら、即座に「もちろん」と返して、そのまま四川話でおしゃべりを始めました。
会話の途中で一度こちらの意図を取り違えた場面もありましたが、訂正するときちんと文脈をつなぎ直し、ループしたり、あらかじめ用意された話題に飛んだりすることもありませんでした。
動画URL:https://mp.weixin.qq.com/s/vIizVJWUqz3rlYW3t2UVcA
もうひとつ加点ポイントだったのが、その「状態」表現です。
私が入力している間は、ただ突っ立っているのではなく、少し首を傾けたり、瞬きをしたりして、「あなたが話し終わるのを待っている」感じがあります。私が話しているときは、軽くうなずきながら視線もこちらに向けてくれます。
そして彼女が話す番になると、表情と内容がちゃんと一致しています。楽しい話題になると口角の上がり方もはっきり変わり、感情の乗り方がかなり自然です。
調べてみると、虎牙ではこれを「全状態擬人化インタラクションシミュレーション」と呼んでいて、静止・傾聴・発話の3状態をカバーしているそうです。
正直、AIデジタルヒューマンの会話をここまで「対面している感じ」にできるのは、個人的には虎牙 VAM 1.0 がかなり先行していると思います。
続けて体験談を。雪儿と好きな歌手の話をしたあと、何が起きたと思いますか?
雪儿は歌って踊ることもできて、しかも新しい友達である私に、かなりノリよく披露してくれました(途中でまた割り込みも試しました):
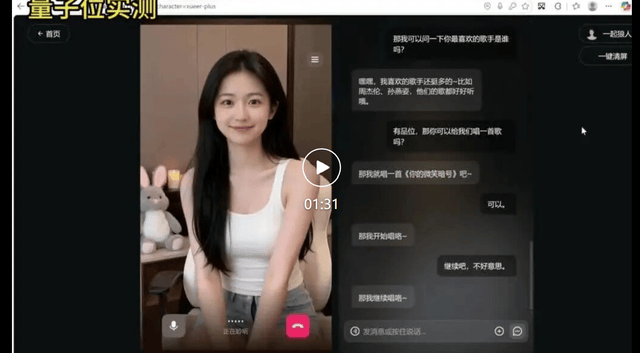
動画URL:https://mp.weixin.qq.com/s/vIizVJWUqz3rlYW3t2UVcA
口の動きは歌詞と同期していて、身体の動きも自然で滑らか。指の崩れや、よくあるモデルの破綻も見られませんでした。
試しに何度も開いたり閉じたりしてみたのですが、毎回違う曲やダンスを見せてくれました。つまり、歌やダンスはプリセットのテンプレートではなく、本当にリアルタイムで生成されているということです。
歌やダンス以外に、虎牙といえば、次に何を試すか、もうお分かりでしょう——
そう、ゲームです。
雪儿にどんなゲームができるのか聞いたところ、狼人殺とタロットを挙げてくれました。ちょうど私は星座運勢みたいな話題が好きなので、タロットを選びました。
選んだ瞬間、雪儿はすっと衣装を切り替えて「タロットゲームモード」に入り、カードを引くよう案内しながら、解釈まで手伝ってくれました。
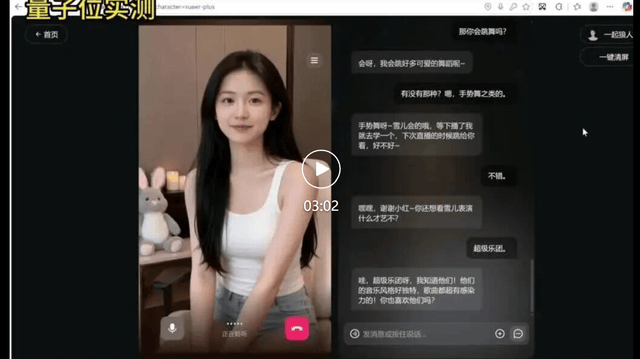
動画URL:https://mp.weixin.qq.com/s/vIizVJWUqz3rlYW3t2UVcA
この没入感はかなりのものです。分析記事を読むよりずっと面白い。
狼人殺が好きな方もご安心を。公式サイトも少し見に行きました(ただし私は狼人殺の沼に落ちるタイプなので、ここは早めに退散)。
このゲームはタロットよりも難易度がかなり高く、10人の役職が同時に駆け引きを行い、それぞれに立場や話し方が必要で、互いに疑い合い、投票で陣営を決める必要があります。複数キャラクターの協調が非常に重要です。
全体を見ると、プールパーティーのシーンで9体のAIキャラクターが順番に発話し、互いに@で名指ししながら疑いを向けるなど、誰か一人の台詞を全員で使い回している感じはありませんでした。
虎牙 VAM 1.0 がここまでマルチキャラ戦略ゲームの体験を作れているということは、少なくとも複数キャラ駆動の能力は十分実用レベルにある、ということです。
夜中に人が足りなくなっても、これなら一局できそうです。
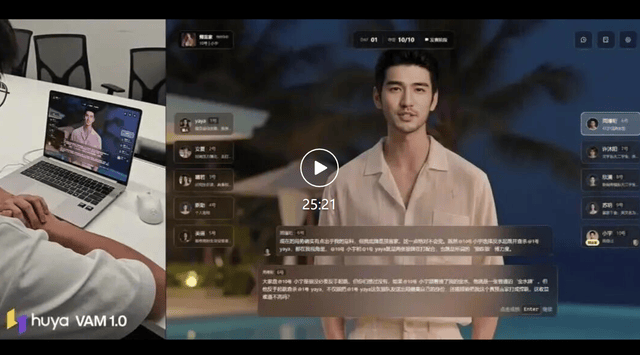
動画URL:https://mp.weixin.qq.com/s/vIizVJWUqz3rlYW3t2UVcA
雑談できる、歌って踊れる、ゲームもできる。これが虎牙 VAM 1.0 の限界だと思っていました。
ところが、公式サイトをもう少し詳しく見てみると、またしても自分の認識が古かった……
ライブ配信で考えると、雪儿がこちらのテキストを直接見られるなら、この技術は実際の配信ルームにそのまま使えます。弾幕を読むことで、みんなとリアルタイムでやり取りできるのです。
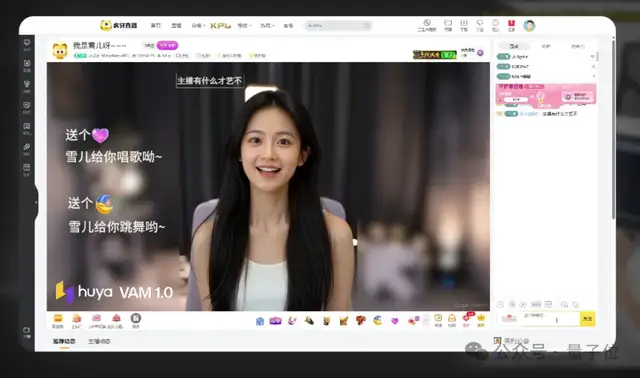
ライブ配信のような、リアルタイム性が高く、インタラクションが多く、長時間の厳しい要求を満たせるなら、応用範囲は一気に広がります。
ライブコマース、ニュース配信、バーチャルコンサート……どれを取っても、かなり大きな可能性があります。
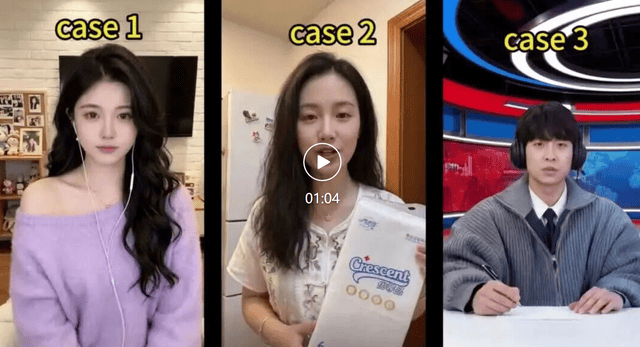
現在、虎牙 VAM 1.0 の公式サイトでは、すでに動作確認済みのいくつかの方向性が紹介されています。
- 才能系配信者が歌いながら視聴者の質問に答える、思わず現実感が揺らぐレベルの自然さ
- ライブコマース配信者が自宅で没入感たっぷりに商品を紹介し、滑らかな口調と自然な身振りで魅せる
- ニュース配信者が24時間オンラインでニュースを読み上げ、キャラクターの見た目も最後まで崩れない
- ……
動画URL:https://mp.weixin.qq.com/s/vIizVJWUqz3rlYW3t2UVcA
ここで改めて虎牙のAIデジタルヒューマンの印象をひと言でまとめるなら、最も重要な3文字は**「安定・正確・高速」**です。
ひとつ目は、安定。
会話から歌とダンス、タロット、衣装チェンジまで、いくつもテストを重ねましたが、顔のドリフト、画面の破れ、フリーズといった現象は一切見られませんでした。
公式では24時間以上連続稼働しても破綻しないと言っていますが、私の体験でも、長時間で崩れる兆候は確かに見えませんでした。
さらに途中のスムーズな衣装チェンジでも、画面が止まる、真っ黒になる、ちらつく、といったことはなく、この安定性はかなりのものです。
ふたつ目は、正確。
このデジタルヒューマンは、静止・傾聴・発話の3つの主要な対話状態を標準でカバーしており、顔の微表情や身体動作の制御精度も高く、全体の対話テンポがかなり人間同士の会話に近づいています。
みっつ目は、高速。
割り込みへの応答、弾幕への返答、話題を変えた後の受け答えまで、体感上ほぼ待ち時間を感じません。
公式データでは、初回フレーム遅延は約1.3秒、以降の1片生成ごとの遅延は0.77秒。実際の体感としては、とにかく滑らかで、演出の間抜けさがありません。
要するに、虎牙 VAM 1.0 の「安定」「正確」「高速」は、どれも技術が支えています。
そしてその裏側には、AIデジタルヒューマン業界で広く知られる3つの技術的な高い壁があります。
AIデジタルヒューマン業界の3つの壁
AIデジタルヒューマン市場はこの2年でかなり注目を集めました。
理由は、応用の広がりが確かに大きいこと、そして羅永浩や劉強東のような著名人の影響もあるからです。
しかし業界の人と深く話すと、面白い現象が見えてきます。どの会社のソリューションも、ほぼ同じところで詰まっているのです。
最初の壁:時間の壁
最も古く、最も頑固な敵が「時間」です。ひと言で言えば、長く動かすと壊れます。
顔の特徴が崩れ始め、五官の形が徐々に変わり、肌色がずれ、ひどいときには画面が裂けるような破綻が起こります。
なぜこうなるのか?
技術的には「累積誤差」と呼ばれます。各フレームは前のフレームを基に生成されるため、誤差が雪だるま式に増えていきます。多くの方式が長時間耐えられない根本原因はここにあります。
虎牙 VAM 1.0 はどう解決したのか? 3段階学習です。
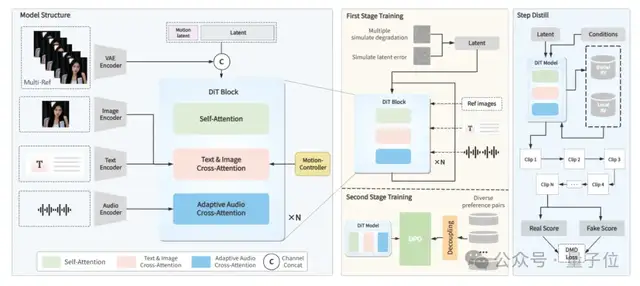
第1段階では、モデルに「長時間崩れない」ことを教えます。
複数の参照画像と動きのフレームを使って人物像を「固定」し、モデルが各フレームを生成する際の基準を持てるようにして、ブレにくくします。
同時に、モーション制御モジュールで表情や動きの多様性を豊かにし、さらに音声に応じて自動で入力を調整するモジュールを加えることで、口の動きの速度を発話テンポに合わせ、音声の間では頭部や身体の動きも同時にゆるめ、音楽を聞けばビートに合わせてうなずくようにもしています。
特に強力なのが次の一手です。
学習時に、あえてさまざまな「画質劣化」シーンを与え、悪条件下でも画面を安定させる方法を先に学ばせているのです。
第2段階では、モデルに「全体として見栄えよく」なることを教えます。
デジタルヒューマンは、口の動きの正確さ、表情の自然さ、動作の協調性など、複数のことを同時に満たす必要がありますが、これらの目標はしばしば互いに衝突します。
虎牙 VAM 1.0 はDPOと呼ばれる嗜好最適化アルゴリズムを使い、複数の目標のバランスを取れるようにして、偏りをなくしています。
第3段階では、モデルに「速く、しかも安定して計算する」ことを教えます。
前の2段階は効果が高い一方で計算量が大きく、そのままではリアルタイム推論に耐えません。
この段階ではモデル蒸留によって計算ステップを大幅に圧縮し(20ステップ→4ステップ)、さらにグローバルとローカルの特徴を突き合わせることで、「近道」をしても画質が落ちないようにしています。
第1段階のモーションフレーム戦略もここで引き続き使い、動きの連続性を保ちつつ、自己修正の仕組みも導入しています。
モデルが自分で生成した過去の映像を入力として使い続け、学習段階から「自分で自分を補正する」ことを覚え、誤差がどんどん積み上がらないようにするのです。
これが、リアルタイム推論の速度を引き上げる鍵です。
こうした仕組みが、虎牙 VAM 1.0 を24時間以上連続稼働しても「崩れない」状態にしているわけです。
ぶつかる第二の壁:対話の壁
次の壁は、より見えにくく、そしてより難しい対話です。
デジタルヒューマンが話せるなら、それで対話能力があると言えるのでしょうか? いいえ。
本当の対話には少なくとも3段階あります。
第1段階は「話す」こと。口の動きが音声に合い、表情が感情に追随すること。
この層は業界全体でもかなり進んでおり、口形の同期から全身表現まで、進化は非常に速いです。
第2段階は「聞く」こと。ここで言う「聞く」は音声認識とは違います。
あなたが話しているとき、デジタルヒューマンの顔や身体が「あなたの話を聞いています」という状態を示す必要があります。例えば、うなずく、視線を向ける、少し前傾になる、といった動きです。
これは多くの方式がまだできていない点です。そもそも学習時に「傾聴状態」という概念が入っていないからです。
彼らは「話す」ことは学んでも、「聞く」ことは学んでいません。
第3段階は「割り込みと受け答え」、つまり虎牙 VAM 1.0 が強調する「全二重通信」です。
従来のAI対話が「あなたが1回聞いて、私が1回答える」というターン制のようなものだとすれば、虎牙 VAM 1.0 の「全二重」は、いつでも話しかけられ、いつでも返せる、リアルな会話に近いものです。
このレベルまでできているものは、ほとんどありません。
結局のところ、多くのモデルは「コンテンツ生成」の問題を解いているだけです。入力があれば、それに応じた動画を出力する。
しかし本当の対話は、2つの主体の間で行われるリアルタイムの双方向コミュニケーションです。これはまったく別の技術課題です。
虎牙 VAM 1.0 は、モデル設計の段階から対話を中心目標に据えています。
静止・傾聴・発話の3状態を標準搭載し、即時割り込みと自然な遷移に対応し、弾幕と音声の2系統を並列で処理するのです。
前の実測で感じた「割り込んだあと、少し間を置いてから自然に返してくれた」感覚は、この対話の壁を越えた結果です。
ぶつかる第三の壁:展開の壁
前の2つの壁が「動くかどうか」を解決するものだとしたら、最後の壁は「大規模に本番投入できるかどうか」です。
研究室で動くことと、実際の業務環境に入ることは別問題です。後者では、問題が一気に別次元になります。
計算資源の消費は急激に増え、遅延も大きくなり、ほんの少しの不安定さでも高負荷・長時間運用の中で目に見える不具合として現れます。
つまり、7×24時間安定稼働でライブ配信やAIデジタルヒューマンの対話を実現するには、システム全体が本気で強くなければなりません。
虎牙 VAM 1.0 はこの層で、基礎演算子からモデル重みまで全体最適化を行っています。
コンパイル高速化、アテンション計算の最適化、VAEデコードの高速化、ネットワーク全層にわたる複数の量子化戦略など、削れるところはすべて削っています。
最終的な成績は次の通りです。
8枚のH200 GPUクラスタ上で、推論速度は36.4fps、1片あたりの生成遅延はわずか0.77秒、初回フレーム遅延は約1.3秒。
どういう意味かというと、複数の学術最先端手法と比べても、虎牙 VAM 1.0 は推論速度が最速で、遅延も最小です。
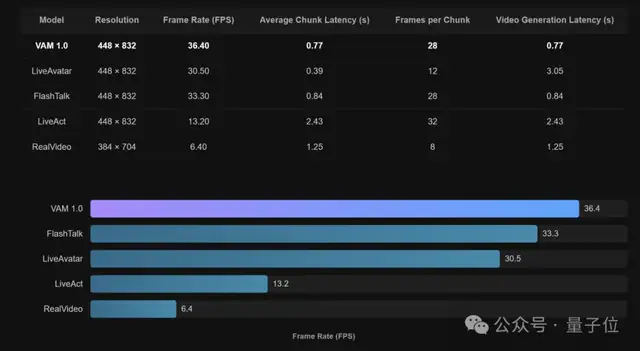
速いだけではありません。虎牙 VAM 1.0 は、リアルさ、アイデンティティ保持、同期精度、動作の自然さという4つの指標でも全面的に優れており、しかも計算コストはより低いです。
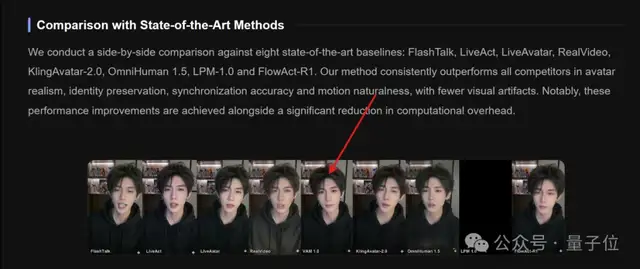
高品質で高速、しかもコストも抑えられる。これはエンジニアリング上かなり難しいのですが、少なくとも公開ベンチマークを見る限り、虎牙 VAM 1.0 はそれを同時に実現しています。
3つの壁についてはここまで。
少し引いて見ると、この3つの壁の背後には、もっと本質的な分岐があります。
デジタルヒューマンは「コンテンツ生成ツール」なのか、それとも「リアルタイム対話の主体」なのか?
前者を選ぶなら、画質と演技力を重視し、時間の壁や対話の壁はひとまず後回しにできます。後者を選ぶなら、この3つの壁はすべて越えなければなりません。
実際、虎牙 VAM 1.0 は後者を選んでいます。
後者を選ぶということは何を意味するのか。モデルの問題を解くだけでなく、エンジニアリングの問題も解き、さらに場面を使って検証し、改善を重ねる必要があるということです。
この3つを同時に進めて初めて成立します。
では、ここまで目に見えて地獄難易度の課題に、なぜ虎牙だけが到達できたのでしょうか?
虎牙は、むしろ「虎山行」?
正直に言えば、虎牙がAIデジタルヒューマンに取り組むのは、論理的にはまったく不思議ではありません。
中国で最初に上場したゲーム配信企業として、虎牙はライブ配信という場に10年以上身を置いてきました。
流量が集まり、配信者が育ち、ユーザーが滞在する場所。それがここです。
だからこそ、AIデジタルヒューマンが概念から実装へ進み、ついに「配信ルーム級のリアルタイム対話」に入ってくるとき、虎牙は最初から入口にかなり近い位置に立っていたわけです。
そして、虎牙が向き合う問題もかなり直接的です。
将来、配信ルームにいるのが真人だけでなくなり、AIデジタルヒューマンやバーチャル配信者が常駐するようになったとき、このプラットフォームは次世代のコンテンツ形態を支えられるのか?
その意味で、これは未来のコンテンツエコシステムに対する先回りの布石とも言えます。
実際、この布石は数年前から始まっていました。
2019年にさかのぼると、虎牙はすでにAIデジタルヒューマン「晚玉」とHEROオープンプラットフォームを発表していました。2025年にはAI eスポーツ知能体「虎小 Ai」をリリースし、自社制作イベントで実際に活用。同年にはAI駆動のバーチャル配信者も導入し、リアル配信者のデジタル分身も作っています。
今回の虎牙 VAM 1.0 の登場は、こうした点在する取り組みを一本の線につなぎ、「ライブ配信にAI機能を足す」段階から「AIで配信そのものを作る」段階へ進んだ、ということです。
要するに、虎牙はAIデジタルヒューマンの素人ではありません。そして今後の道筋も、ますます明確になってきています。
AIは、もはや外付け機能ではなく、ライブ配信システムの一部になりつつあるのです。
この過程で、虎牙が技術面で急速な進展を遂げられたのは、