
密度と score 推定のための Transformer の学習
📄 技術レポート: arxiv.org/abs/2511.05924

機械学習や科学計算における多くの問題は、実は同じ種類の課題に帰着します。つまり、データ点の集合が与えられたとき、それらがどの分布から生成されたのかを復元したい、という問題です。どの値がよく現れ、どの値があまり現れないのかを知るには、分布の密度と、高次元で特に有用な score の 2 つを推定する必要があります。密度は、ヒストグラムを滑らかにしたものと考えるとわかりやすいでしょう。データ点が集まっている場所では密度が高く、まばらな場所では低くなります。score は対数密度の勾配であり、密度が最も急に増加する方向を指します。score に沿って点を動かすと、より起こりやすい領域へと近づいていきます。
拡散ベースの生成モデル(Stable Diffusion や DALL·E などの AI 画像生成の背後にある技術)は、ランダムノイズから始まり、score の方向へ少しずつ進みながら、ノイズを写実的な画像へと変換します。同じ score は、ベイズサンプリングや、プラズマのような系をシミュレーションする粒子法にも使われています。
限られたサンプルから密度と score を抽出するのは難しく、既存の手法では汎化性と精度のどちらかを犠牲にしなければならないことがよくあります。代表的な古典手法である核密度推定(kernel density estimation, KDE)は、ある点の周囲にあるデータ点に基づいてその位置の密度を計算します。近くに点が多いほど密度は高くなります。学習不要で任意の分布に適用できますが、次元が上がると精度は急速に低下します。もう一つの方法として、ニューラルネットワークによる score matching モデルがあります。これらは score を予測するように学習され、高次元空間でも高い精度を保てますが、各モデルは特定の分布を学習する必要があり、別の分布に対しては最初から再学習しなければなりません。
そこで私たちは、DiScoFormer(Density and Score Transformer) という新しい手法を提案します。これは 1 つのモデルだけで、データ点の集合が与えられれば、1 回の順伝播で分布の密度と score を同時に推定でき、再学習も不要です。
[
](#training-a-transformer-for-density-and-score-estimation)
  密度と score 推定のための Transformer の学習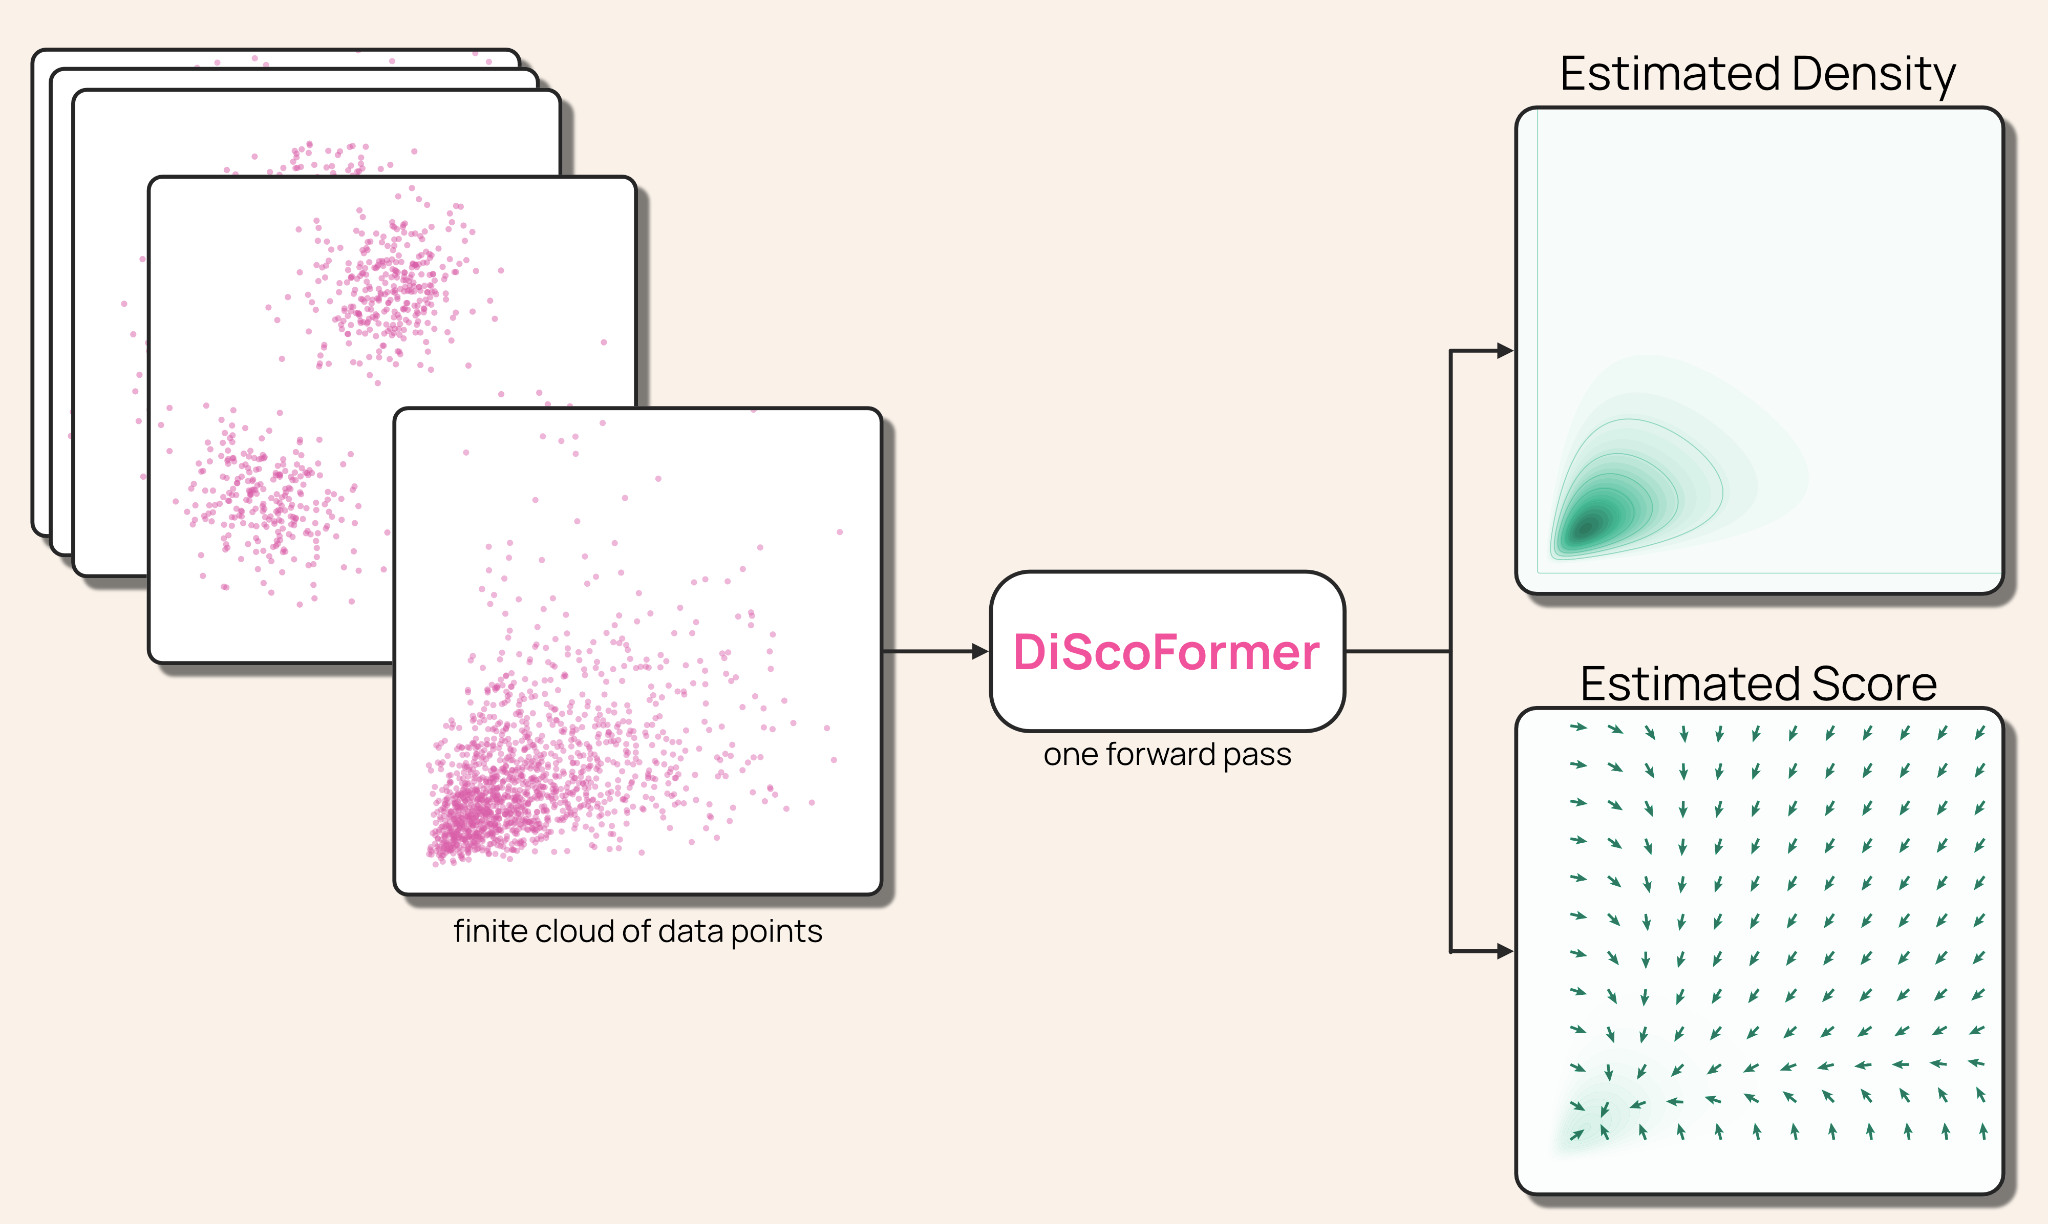
DiScoFormer は、積み重ねた Transformer block を使って、入力されたサンプル全体をその背後にある分布の密度と score に写像します。このモデルは cross-attention を利用することで、既存のデータ点上だけでなく任意の位置で密度と score を評価できます。score と密度は数学的に関係しており、score は密度の対数の勾配です。私たちはこの関係を利用し、共通の backbone に 2 つの出力 head を持たせました。1 つは密度、もう 1 つは score を出力します。
この結合は、単にパラメータを節約するだけではありません。score head は各 query point において、log-density head の勾配と一致していなければならないため、両者のずれはラベル不要の consistency loss として使えます。推論時にはこれを活用し、context を固定したままこの consistency loss を数ステップ分だけ勾配更新することで、DiScoFormer は真の密度や score を監督信号として与えられなくても、その場で分布外入力に適応できます。
Transformer アーキテクチャがこの課題に適しているのには、数学的な理由があります。核密度推定には bandwidth、つまり各点の影響範囲が 1 つだけあり、事前に決めた値をすべての位置に一様に適用します。attention 機構はその厳密な一般化です。私たちは解析的に、単一の attention head の重みがデータ上の Gaussian kernel にほぼ一致することを示しました。つまり、cross-attention block 1 つで KDE の密度と score を再現できるのです。さらにその上で、モデルは複数のスケールを学習し、データに応じて自律的に調整できます。DiScoFormer は古典的手法を単にブラックボックスで置き換えるのではなく、KDE を特別な場合として内包しつつ、その上で改善を加えています。
では、DiScoFormer の学習にはどのようなデータを使うのでしょうか。主に 2 つの理由から、私たちは Gaussian Mixture Models(GMMs)を採用しました。第 1 に、GMM は汎用的な密度近似器です。十分な数の成分があれば、ほぼ任意の滑らかな分布を任意に小さい誤差で近似できます。第 2 に、GMM の密度と score は閉形式で表せるため、常に厳密な教師信号を得られます。この 2 つの性質を活かし、各 batch ごとに新しい GMM をサンプリングすることで、モデルに事実上無限の目標分布例を与えつつ、各 GMM の厳密な密度と score を用いて学習させます。
[
](#performance)
  性能
全体として、DiScoFormer は密度推定と score 推定の両方で KDE を上回っており、その差は KDE が最も苦戦する領域で特に顕著です。100 次元空間では両者の差は歴然で、最適に手作業で調整した KDE と比べても、score 誤差を約 6.5 倍、密度誤差を 37 倍以上削減しました。さらに、サンプル数が増えても性能は向上し続ける一方で、KDE はすでにメモリ不足に陥っています。また、訓練データの範囲外への汎化も良好で、学習時より多いモード数を持つ混合分布や、Laplace 分布・Student-t 分布のような非ガウス形状に対しても高い精度を維持しました。KDE の主な強みは依然として速度であり、特にデータセットが小さい場合にその傾向が強くなります。
私たちが DiScoFormer で最も期待しているのは、score 推定が生成モデリング、ベイズ推論、科学計算など多くの分野で共通の基盤能力である点です。事前学習済みでそのまま使える推定器が、高次元でも高精度を保ち、しかも問題ごとの再学習コストを不要にできるなら、これらの分野全体のコストを同時に下げられる可能性があります。1 つのモデルで、score と密度が必要なあらゆる場面をカバーできるのです。
さらに詳しくは、ぜひ私たちの技術レポートをご覧ください。