
大規模言語モデル(LLM)は今や、コード生成、数学問題の解法、要約生成、文書理解、そして開発者のさまざまなワークフローにおけるデフォルトのインターフェースとなっています。しかし、その内部では、多くの LLM がテキストを生成する仕組みはいまだに同じです。つまり、一度に 1 つの token を生成し、各 token は直前までに生成された token に依存します。そのため、この種のモデルは自己回帰(autoregressive)と呼ばれます。自分自身が生成した出力を入力として消費するからです。
この自己回帰(AR)方式は、驚くべき成功を収めてきました。学習は安定しており、サービス提供もシンプルで、現代の言語モデルの大きな進歩を牽引してきました。しかし一方で、厳しい制約もあります。新しい token を 1 つ生成するたびにモデル全体を再度実行する必要があり、計算を始める前にすべての重みをメモリから読み込まなければなりません。低レイテンシのアプリケーションを構築したい場合や、小さなバッチサイズで動かしたい場合、あるいは最新の GPU をより有効に活用したい場合、token を逐次生成する方式では、性能の余地が十分に活かしきれません。なぜなら、GPU の大半の時間が計算ではなくメモリアクセスに費やされるからです。
さらに、自己回帰モデルが一度生成した token は最終結果となり、モデル自身にそれ以前の token を修正する能力はありません。そのため、誤りは生成の途中でそのまま伝播していきます。
Nemotron-Labs Diffusion は新しいアプローチを提供します。これは拡散言語モデル(DLM)であり、複数の token を並列に生成し、その後、複数ステップにわたってそれらを反復的に洗練していきます。しかも、この種のモデルは現代の GPU の計算パターンをよりよく活かせるため、実行時性能の大幅な向上も期待できます。加えて、生成済み token を修正できるため、既存テキストの言い換えや、中間挿入(fill-in-the-middle)タスクにもより適しています。この「生成してから精錬する」という特性により、推論予算を制御するための組み込みの仕組みも提供されます。精錬ステップ数を減らせば、実行時の計算要求を下げることができます。
クイックリンク:モデル、学習レシピ、技術レポート
Nemotron-Labs Diffusion シリーズには、3B、8B、14B 規模のテキストモデルが含まれ、いずれも商用利用に配慮した NVIDIA Nemotron オープンモデルライセンスのもとで公開されています。さらに、8B 規模の視覚言語モデル(VLM)もあり、こちらは NVIDIA ソースコードライセンスのもとで公開され、より広い研究上の柔軟性を提供します。ラインアップ全体として、NVIDIA はベースモデルと、指示微調整済みのチャット版の両方を公開しています。NVIDIA はまた、これらのモデルを学習したコードを NVIDIA Megatron Bridge フレームワーク を通じて公開しています。
1つのモデルにおける3つの生成モード
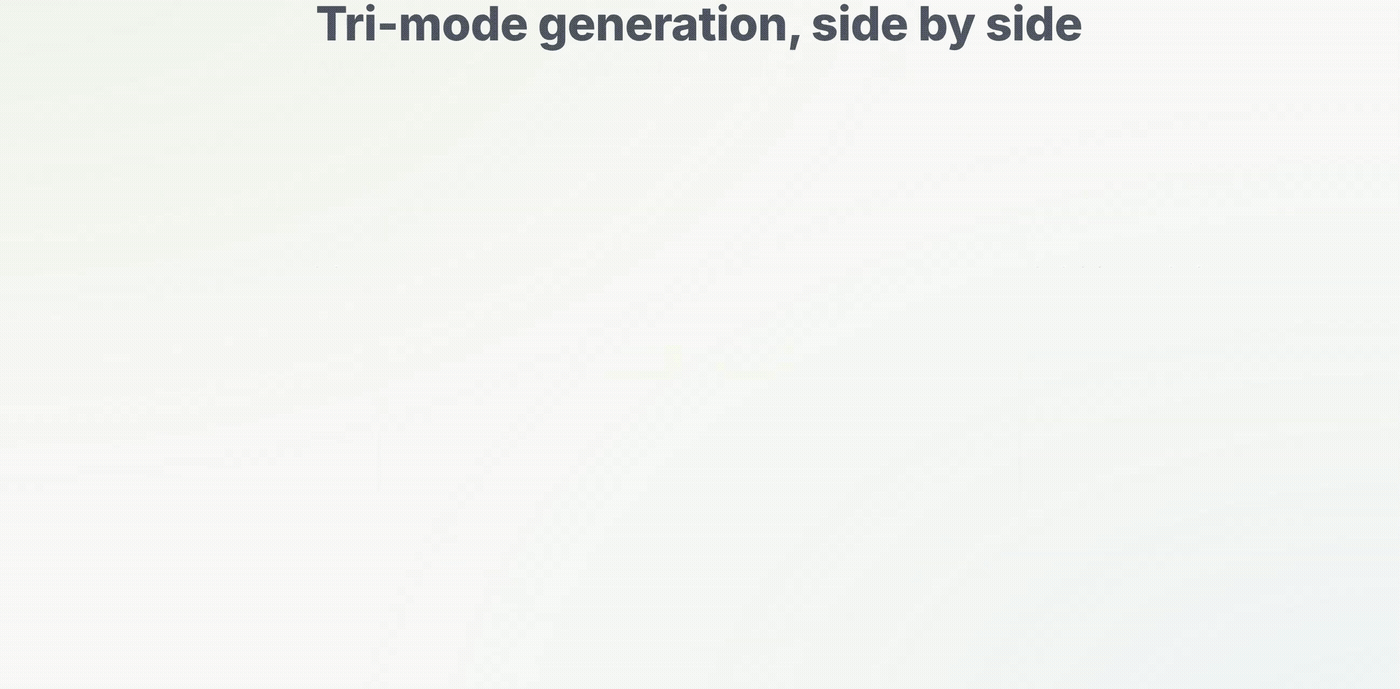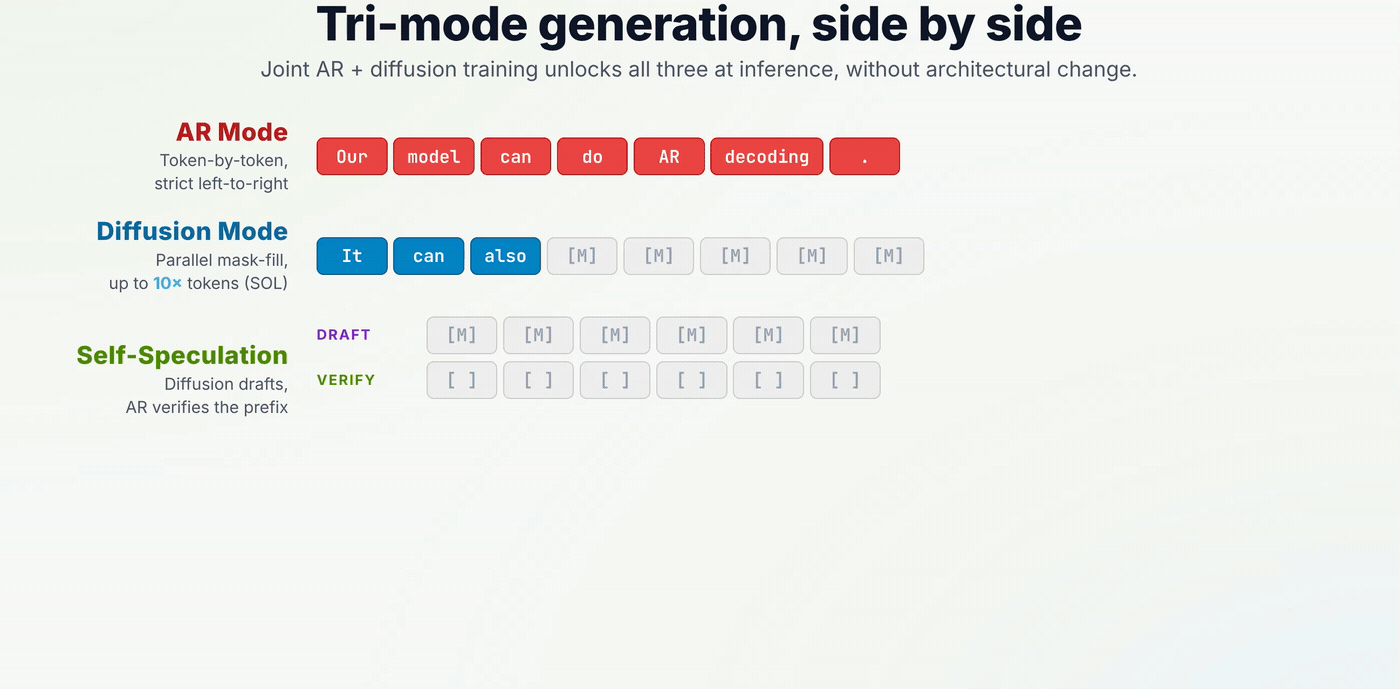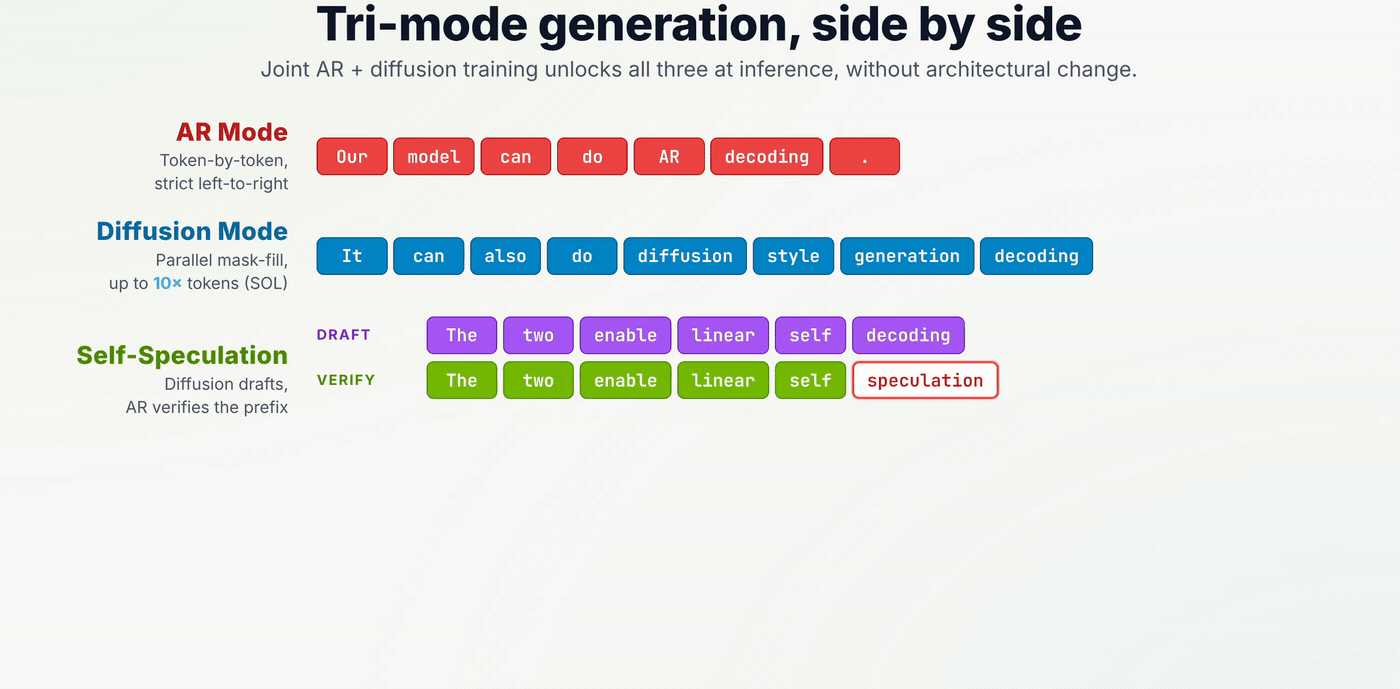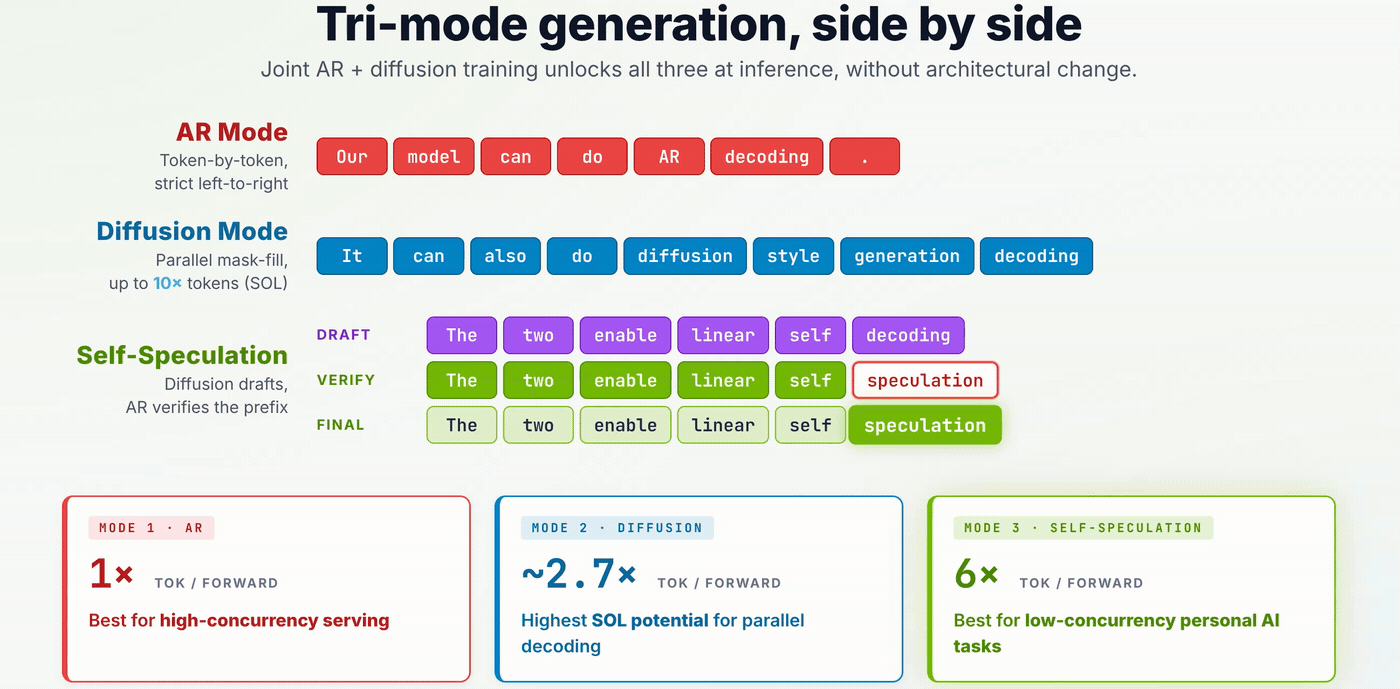
Nemotron-Labs Diffusion の設計は、ひとつのシンプルな考え方に基づいています。自己回帰生成と拡散生成は、別々のモデルファミリーであるべきではなく、同じモデルが持つべき能力である、という考え方です。このモデルは 3 つの生成モードをサポートしています。
自己回帰モード は、標準的な左から右への LLM として動作します。これにより、開発者がすでに慣れ親しんでいる生成ワークフローとの互換性が保たれます。
拡散モード は、ブロック単位で生成を行い、複数ステップにわたって token を徐々に生成します。
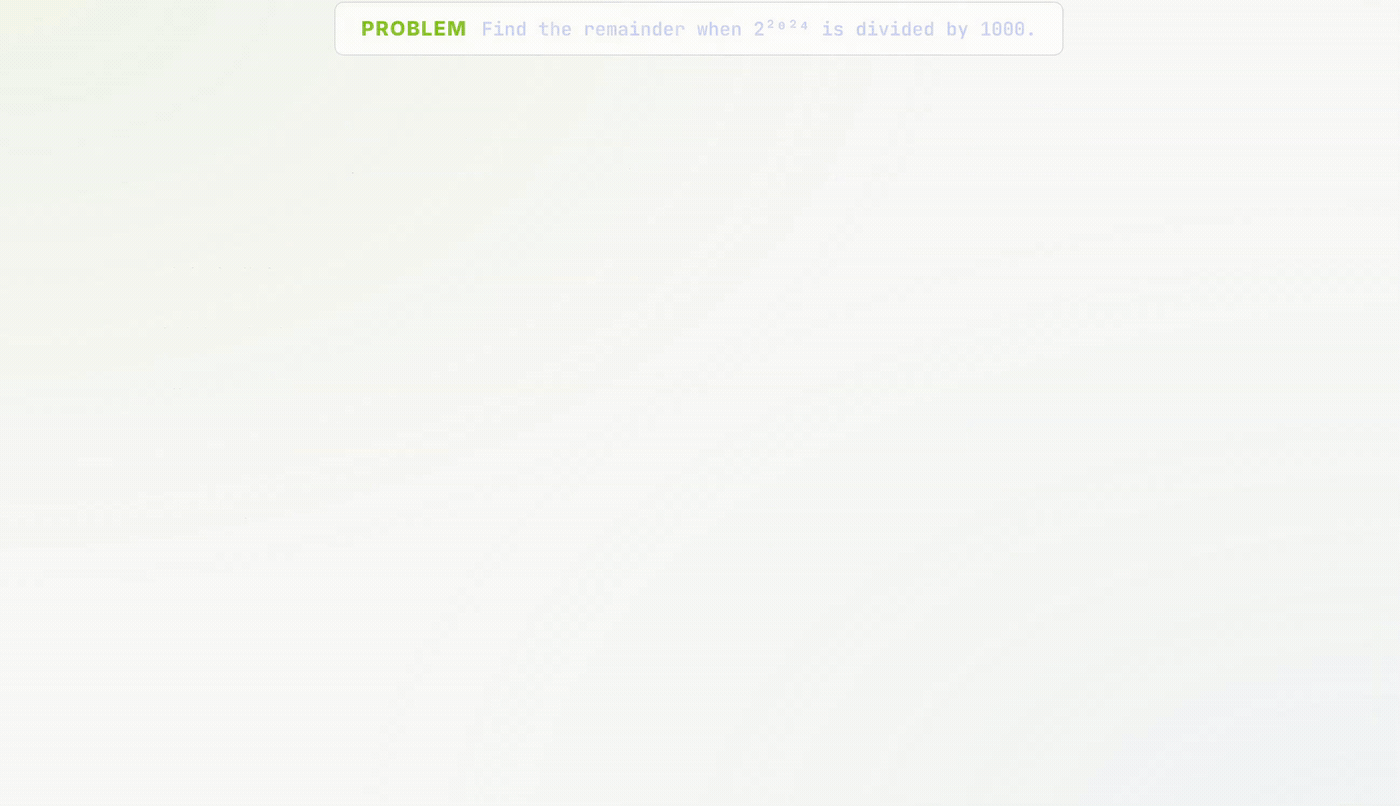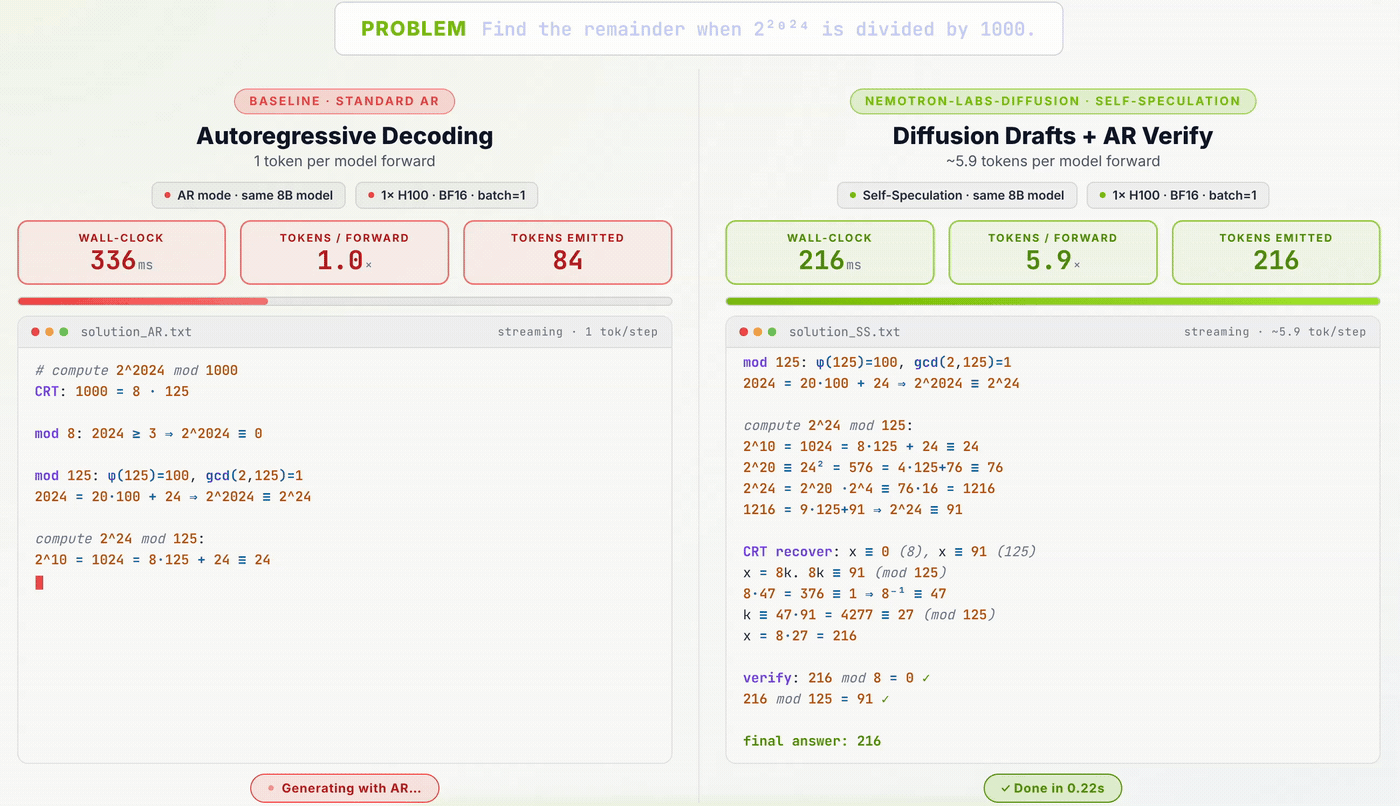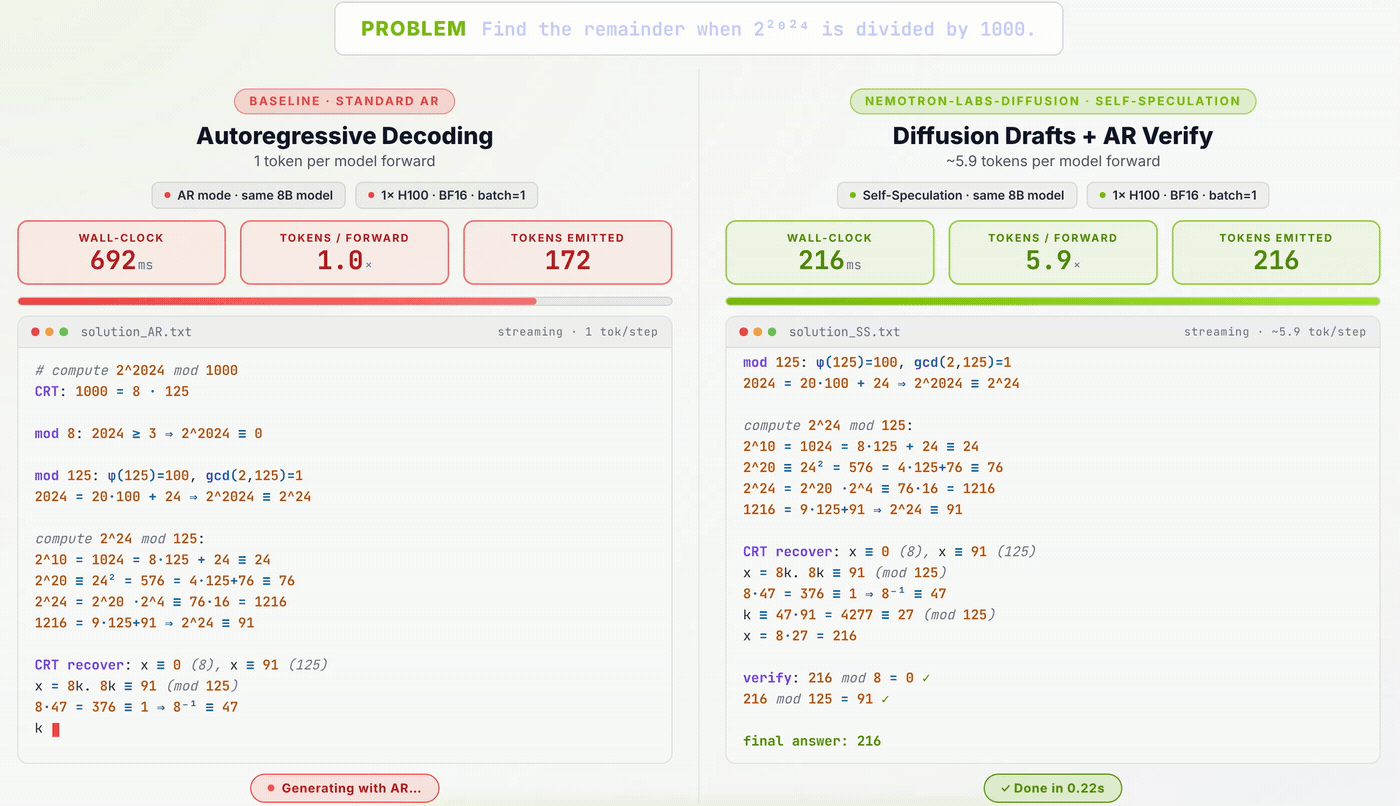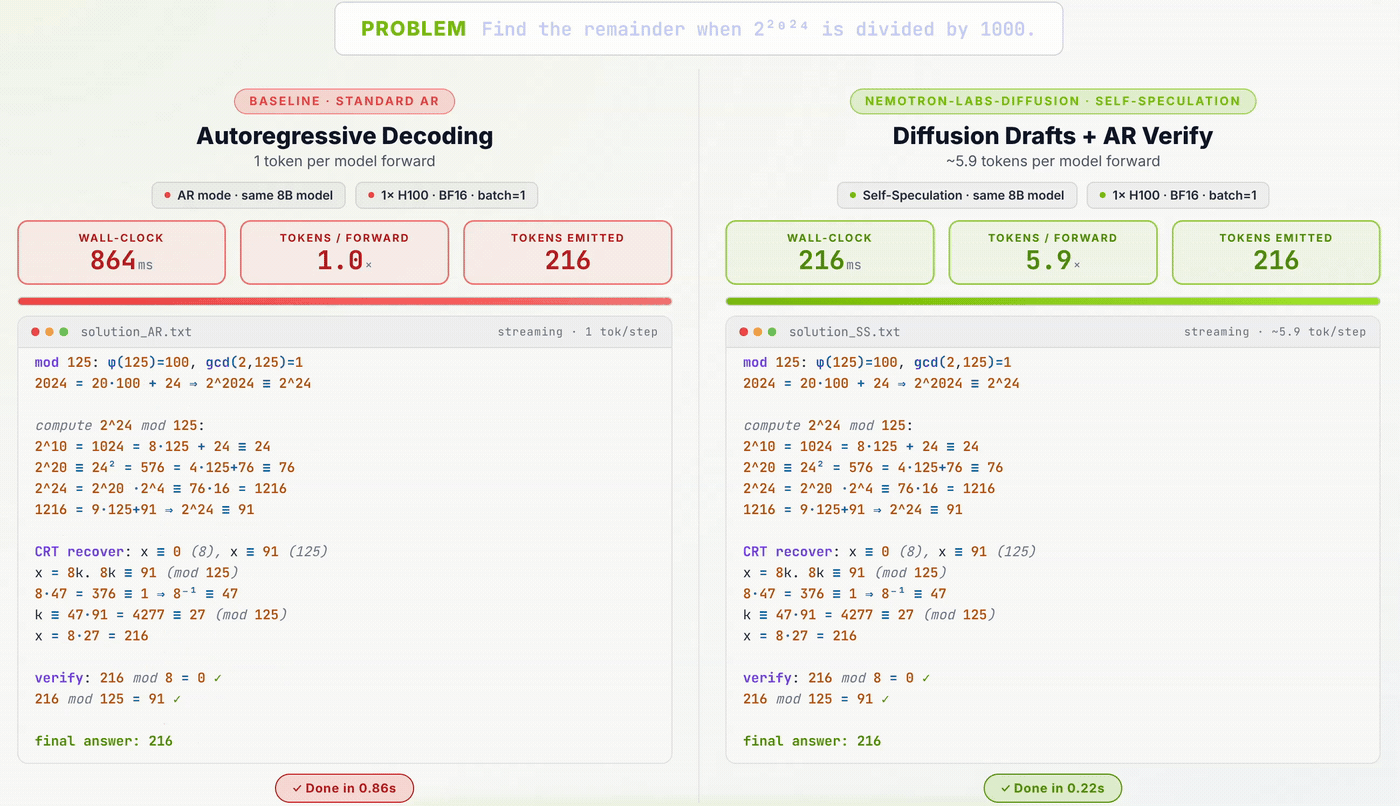
self-speculation モードは、拡散を使って複数の候補 token を下書きし、それを自己回帰デコードで検証します。これにより、拡散による下書きの速度ポテンシャルと、AR 検証の信頼性を組み合わせています。
この柔軟な設計は、開発者にとって重要な特長です。バッチサイズが予測できないワークロードや、単一クエリの場面(batch size=1)でも、速度と精度の両立が可能になります。必要な推論モードを選んでも、アプリケーション側の変更はほとんど不要です。これは単なるデプロイ時の設定にすぎないからです。そのため、開発者は現在使っているモデルからシームレスに切り替えたり、Nemotron-Labs Diffusion を複数の推論モードで使い分けたりして、非常に高速な生成を実現できます。
性能のハイライト
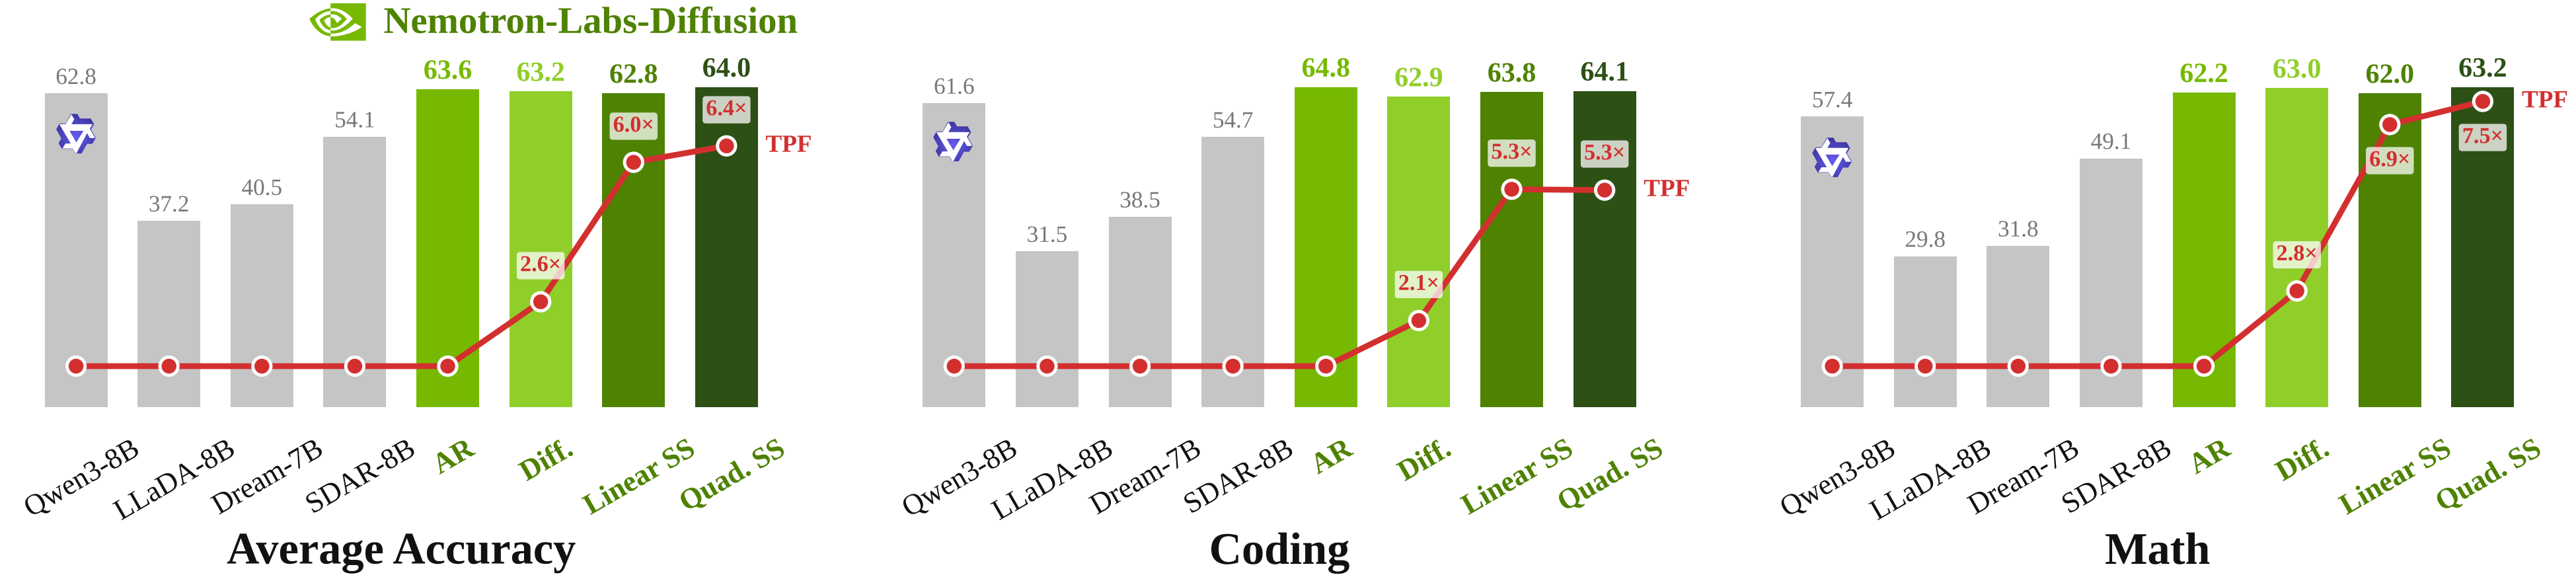
Qwen3 8B と比較すると、Nemotron-Labs Diffusion 8B は平均精度が 1.2% 向上しています。推論速度を 1 回の forward pass あたりの token 数(TPF, token per forward pass)で、ハードウェア非依存の token デコード効率指標として測定すると、拡散モードの TPF は AR モデルの 2.6 倍です。さらに self-speculation により、この値は linear self-speculation で 6 倍、quadratic self-speculation で 6.4 倍まで向上し、評価したタスクにおける精度は同等でした。
Nemotron-Labs Diffusion の学習方法
拡散言語モデルは長年有望視されてきましたが、歴史的にはいくつかの実用上の障壁がありました。強力な AR モデルと比べて精度が低いこと、学習が難しいこと、そして KV キャッシュとの互換性が限定的であることです。
近年の研究により、この状況は変わりつつあります。Efficient-DLM は、継続事前学習を行い、注意機構をブロック処理方式に切り替えることで、事前学習済みの AR モデルを拡散言語モデルへ変換できることを示しました。この設計は、AR モデルの能力を維持しつつ、KV キャッシュに適した並列デコードを可能にします。
Nemotron-Labs Diffusion は、同じ実践的な洞察、つまり既存の AR モデルに拡散能力を加えるという発想の上に成り立っています。このモデルは AR と拡散の संयुक्त目的で学習されており、初期の AR 学習で獲得した知識を保ちながら、拡散によって並列的な下書き能力を追加しています。まず NVIDIA Nemotron 事前学習データセット 由来の 1.3T token で事前学習され、その後 NVIDIA Nemotron 後学習データセット 由来の 45B token を用いて追加の教師あり微調整が行われました。