
最速トップ級!智譜、コードを「噴いて」るんじゃないの?
400 tokens/s
金磊 発信 凹非寺
量子位 | 公众号 QbitAI
AIよ、その速度、まるで噴射してるみたいだ!
よく見て、絶対にまばたきしないで:
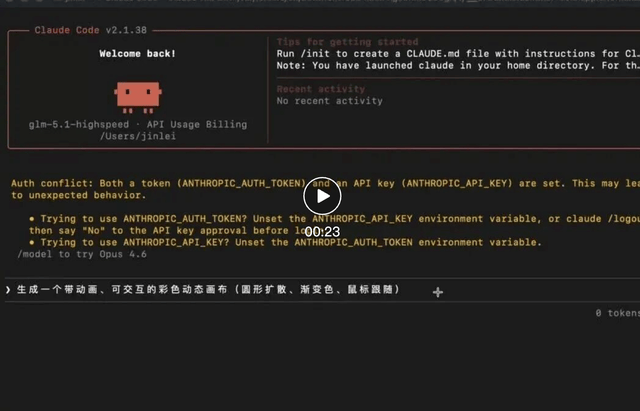
動画アドレス:
https://mp.weixin.qq.com/s/Wn1-SzjpEkQLTyZnJKDRwg
こんなに大量のコードが、まさに**「パッ」と一気に**噴き出してくる感じ。
以前のAIのコード生成は、CPUでレンダリングしているみたいに、少しずつ打ち出される感じだった。
でもこのAIのコード生成は、むしろGPUみたいだ:
こんなに速く生成されたコード、本当に使えるの?
答えは、使える。
これが智譜が新たに出した高速版API——GLM-5.1-highspeedだ。
公式によると、このフラッグシップモデルのAPIは、現在のトップクラスモデルの中で最速で、すでに400 tokens/sに達している!
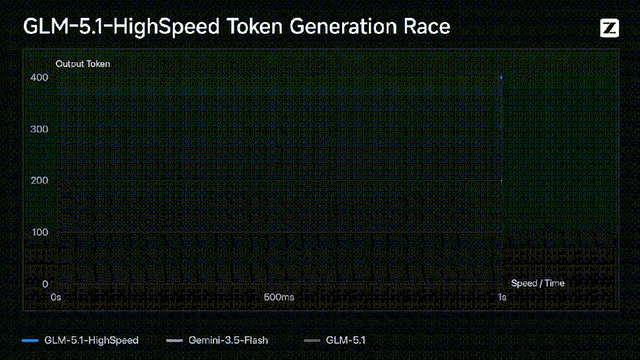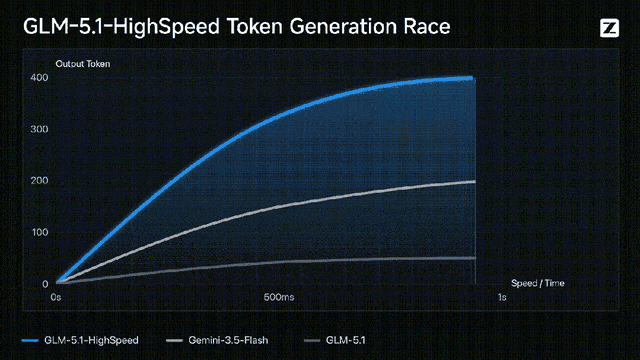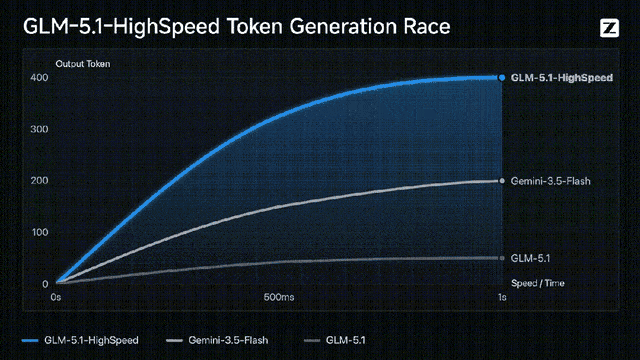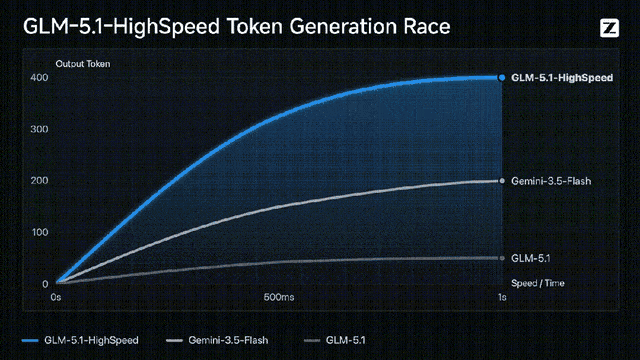
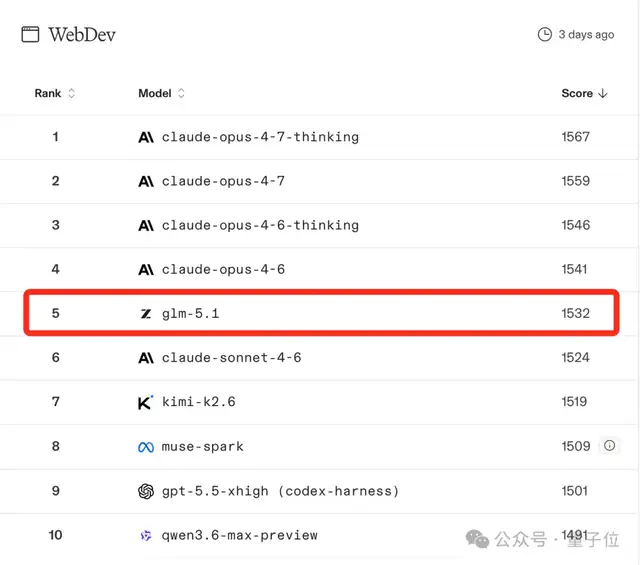
しかもこのGLM-5.1は、すでに1か月以上前に出ているにもかかわらず、今なおオープンソースモデルの中でCoding最強クラスだ:
では、いつものように、実測にいってみよう〜
直接実測 GLM-5.1-highspeed
AIのコード生成が倍速再生みたい
まずは、冒頭よりもさらに複雑な例を試してみる。Prompt はこんな感じ:
ひとつのWebページを作って。画面中央には呼吸しているような星雲を表示。ユーザーが再生をクリックすると、粒子はシミュレートした音声リズムに合わせて拡散・集合・変色するようにして。さらに、速度、密度、残像、グロー強度など、いくつか調整できるパラメータも付けて。
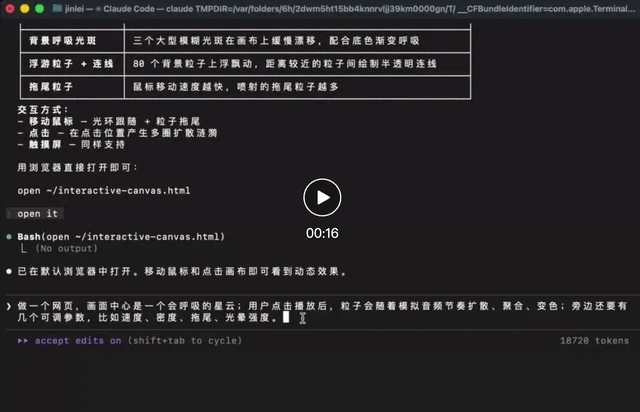
動画アドレス:
https://mp.weixin.qq.com/s/Wn1-SzjpEkQLTyZnJKDRwg
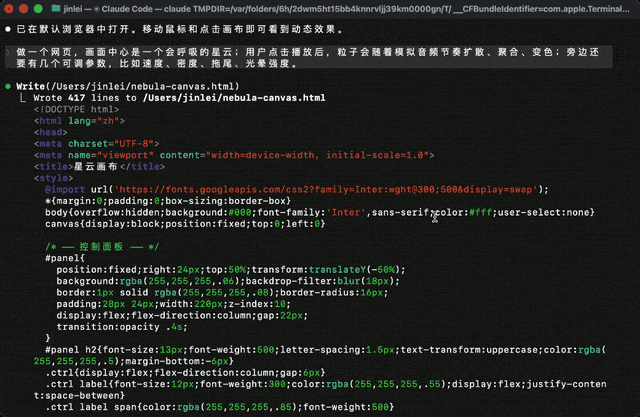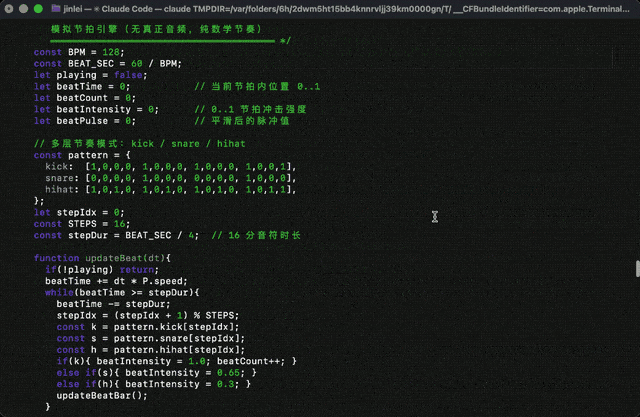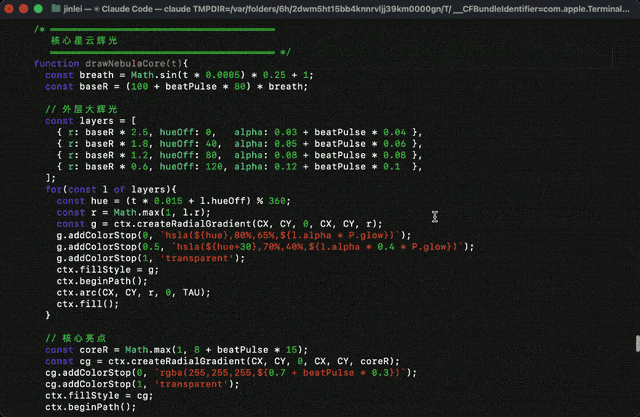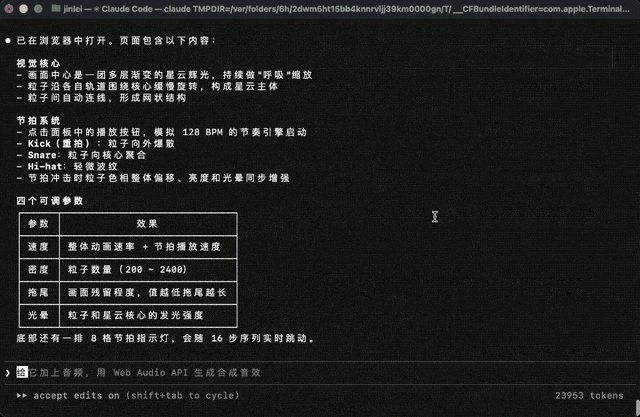
同じく、これだけ多くの行数のコードを、AIは十数秒考えたあと、やはり一気に噴き出すように出してきた。
この手のタスクの難しさは、フロントエンドの構造、Canvasアニメーション、状態管理、視覚パラメータ、インタラクションロジックを同時に処理しつつ、しかも見た目がダサくなりすぎないようにしなければならない点にある。
結果を見ると、確かにPromptの要求は満たしている:
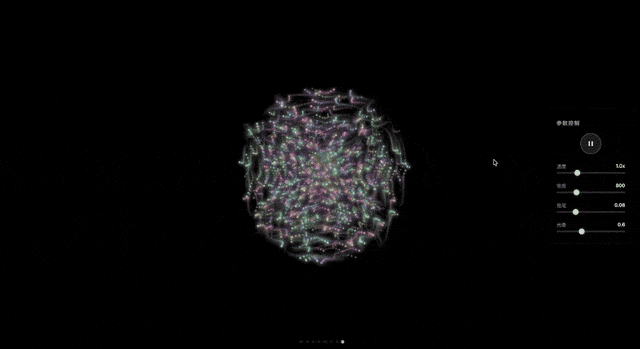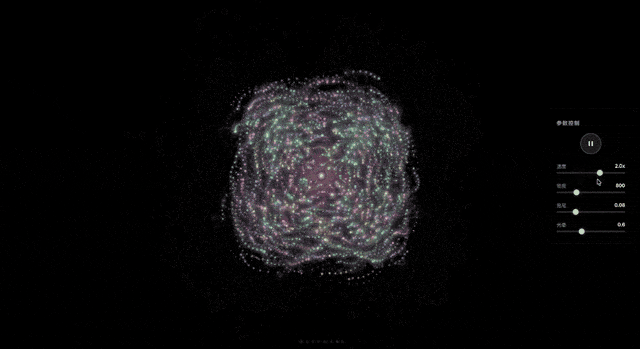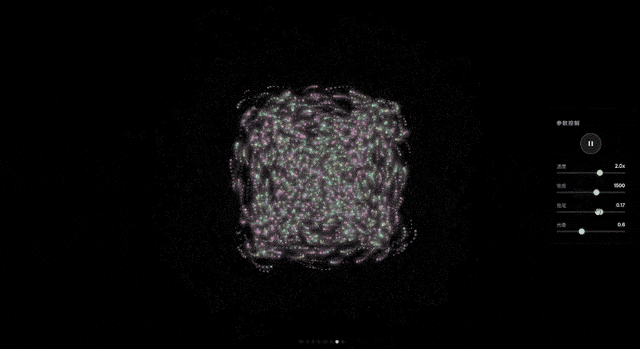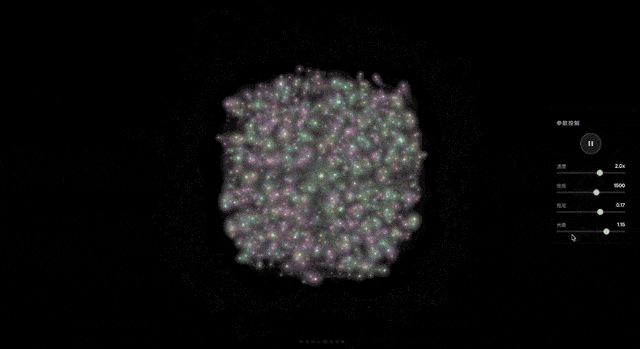
デザイナーと同じキャンバスを前にしているみたい
2つ目のテストは、さらに面白い。
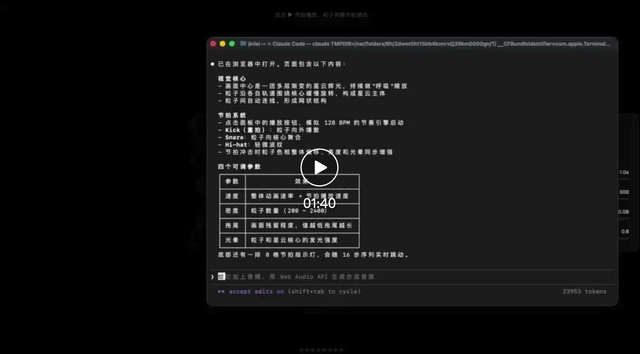
前のコードをベースに、さらに要望を追加していく。
「この波紋、もう少し速く。」
「グローの色は、少し暖色寄りで。」
「粒子が散るとき、あまり硬くしないで、もっと柔らかく。」
「背景は真っ黒じゃなくて、少しだけ濃い青の階調を入れて。」
動画アドレス:
https://mp.weixin.qq.com/s/Wn1-SzjpEkQLTyZnJKDRwg
まず、こうした指示はどれもかなり曖昧で、「42行目の speed を 0.6 から 1.2 に変えて」といった精密なものではない。つまり、モデルはまずこちらの意図を正確に理解する必要がある。
次に、GLM-5.1-highspeed は速度が十分速いので、プロジェクトを進めるときの体感自体が変わる——
AIと並んで座って、一緒にキャンバスを見ながらパラメータを調整しているような感覚に近い。
これこそ、高速APIが見過ごされやすいポイントだ。AIと共同作業でプロジェクトを進める体験が、今ではよりリアルタイムに近づいている。
モデルをゲームディレクターにする
3つ目のテストでは、さらに一歩踏み込む。
もしモデルが十分速いなら、ゲーム内で世界をリアルタイムに変えられるのか?
たとえば、小さな2Dゲームを作る:
プレイヤーがキャラクターを操作して3Dマップ上を移動し、シーン内には障害物、敵、アイテム、天候、ライティング、ランダムイベントがある。文字を入力できるダイアログボックスがあり、シーンは入力された文字に応じてリアルタイムに変化する。
そして、モデルには固定スクリプトを与えず、代わりにディレクターの指示のようなものを次々に出す。
「雪にして」「雨にして」「爆発させて」……
動画アドレス:
https://mp.weixin.qq.com/s/Wn1-SzjpEkQLTyZnJKDRwg
この種のテストは、Webページを作るよりもさらに厄介だ。
なぜならモデルは、ゲームの状態、コード構造、インタラクションロジックを理解しつつ、どの変更が体験に影響するかも判断しなければならないからだ。
そして高速APIによって、これまで遅延のせいで成立しなかったプロダクト形態が実現可能になる。たとえば、ゲーム内でモデルがゲーム世界の状態をリアルタイムに変える、といったことだ。
もちろん、ここにはまだ多くのエンジニアリング課題が残っている。たとえば安定性、安全境界、状態の一貫性、コスト、同時実行数などだ。ただ少なくとも速度という観点では、400 tokens/s級のAPIによって、この手のアイデアはもはやPPTの中だけの話ではなくなった。
10秒で万字コンテンツを処理
4つ目の実測は、コンテンツ業界に戻る。
AIに1万字級の長文素材を読み込ませ、次の処理を一気に実行させた:
- いちばん目を引く3つのポスター用メインタイトルを抽出する;
- 15字以内のショート動画用ナレーション文を6本生成する;
- 3種類の製品キャッチコピーを出力する(公式サイトのトップページ向け);
- そのまま公众号に投稿できる文章(800字)を生成する;
- 最後に、すべての内容をJSON形式でまとめる。
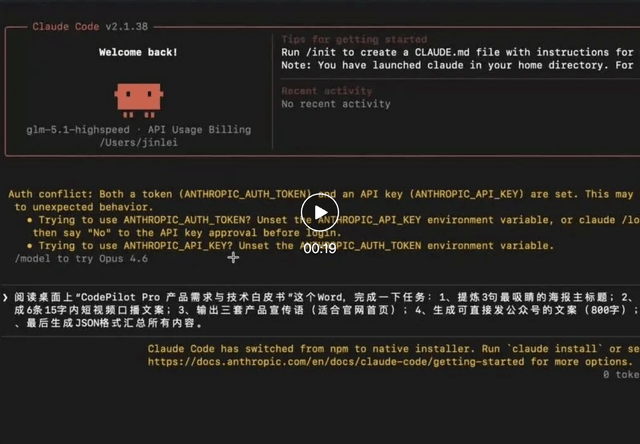
動画アドレス:
https://mp.weixin.qq.com/s/Wn1-SzjpEkQLTyZnJKDRwg
かかったのは、わずか10秒!
しかも仕上がりは、しっかり要点を押さえていた:
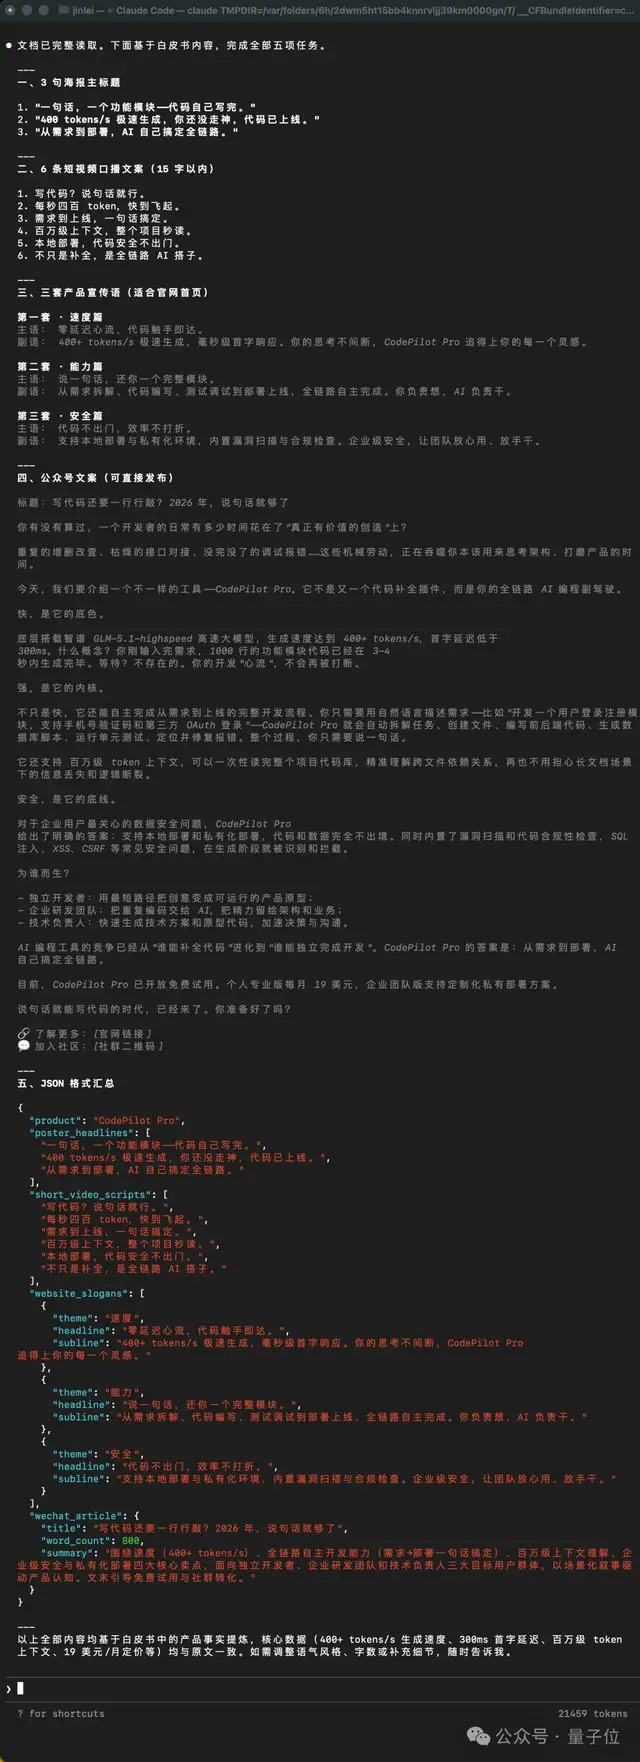
AIの速度が上がると、人間はより早く判断フェーズに入れる。
その結果、人とAIの協働は、一発発注というより、何度も磨き上げる往復作業に近づいていく。
Agent が高速時代へ
400 tokens/s という数字だけを見ると、モデルを小さくしたから速い、と理解してしまいがちだ。
だが実際には、GLM-5.1-highspeed で注目すべきなのは、単なる低遅延の小型モデルではなく、フラッグシップモデルの高速版を前面に打ち出している点だ。
その裏にはシステム工学がある。
智譜のGLMチームとTileRTチームは共同でGLM-5.1-highspeedを構築し、推論エンジン、スケジューリングシステム、基盤インフラの3層で最適化を行った。
推論エンジンはGLM-5.1のアーキテクチャ特性に合わせてコア推論パスを書き直し、スケジューリングシステムは動的バッチ処理、リクエスト統合、KVキャッシュのスケジューリングなどによって高並列時のテールレイテンシを低減。基盤インフラでは、推論クラスタの配置、ネットワークリンク、ロードバランシングを協調最適化している。
簡単に言うと、大規模モデルの推論は、GPUで計算すれば終わり、という話ではない。
実際のオンラインシステムでは、リクエストをどう並べるか、どうまとめるか、KVキャッシュをどう調整するか、複数GPU間でどう通信するか、ネットワークリンクをどう負荷分散するか、といったすべてが最終的な遅延に影響する。
TileRTの考え方はさらに一歩進んでいる。
従来のoperator/kernelよりもさらに下の、tileレベルまで推論スケジューリング単位を掘り下げ、コンパイル時の静的なオーケストレーション、GPU常駐のpersistent Engine Kernel、host側スケジューリングやクロス演算子同期の削減などによって、推論プロセス内のスケジューリング、データ移動、同期のオーバーヘッドを圧縮している。
もっと噛み砕いて言えば、こうだ。
以前は、作業員たちがレンガを1個運ぶたびに、親方の指示を毎回待たなければならなかった。
今は、ルート、役割分担、リズムをあらかじめ決めておき、作業員が現場で継続的にライン生産のように協調できるようにしている。
大規模モデル推論の高速化は、より強力なチップだけでなく、システム内のあらゆる遊休時間を削り取ることによっても実現されることが多い。
高速APIの競争とは、本質的にはモデル能力、推論エンジン、スケジューリングシステム、基盤インフラを総合した戦いなのだ。
もちろん、速度を神格化してはいけない。
本当にAPIを本番環境に入れるなら、見るべきはモデル品質、安定性、コスト、コンテキスト能力、ツール呼び出しの信頼性、並列処理能力、そして複雑なタスクでのエラー率だ。
とくに400 tokens/sのような速度指標は、より多くのタスク、より多くの時間帯、より多くの同時接続条件で継続的に検証する必要がある。
だが少なくとも今回のテストから、ひとつ明確な流れは見えている:
国産大規模モデルAPIの競争は、単に「うまく答えられるか」から、さらに「速く、しかも安定して働けるか」へと進んでいる。
GLM-5.1-highspeed の意義は、まさにここにある。
フラッグシップモデルの能力と高速推論システムが重なったとき、AI Agent の体験は非常にわかりやすく変わる。待ち時間は減り、フィードバックは細かくなり、タスクの進行はより連続的になる。
Codingの時代、速さは気持ちよさそのものだ。