
具身空間知能を評価するための新ベンチマーク
听雨 発自 凹非寺
量子位 | 公众号 QbitAI
ImageNet のあと、李飛飛が再び動いた!
李飛飛チームが新たに発表したのは ESI-Bench——具身空間知能を評価するための新しいベンチマークだ。
これまでの空間知能評価は、モデルに最適な観測結果を与えるのが前提だったが、ESI-Bench は最初に「観察者」を「行為者」に変え、感知-行動ループを閉じた。
これは、具身空間知能分野に体系的な評価フレームワークを提供するもので、人間の中核的な空間認知能力を 4 つの観点からカバーしている。
論文の核心的な結論はこうだ。今の AI は画像を見るのは非常に得意だが、「動ける」「触れられる」「自ら答えを探しに行ける」空間知能にはまだほど遠い。
ESI-Bench とは何か
ESI-Bench が登場した背景には、現在の空間知能ベンチマークがどれも「受動的な感知」しか測っていないという問題がある。
画像を 1 枚、あるいは数枚モデルに渡して、「A 物体は B 物体の左か右か」「このコップはどれくらい水が入るか」「引き出しの中に物はあるか」といった問題を出す。こうした評価が測っているのは、モデルの“視力”であって、空間推論能力そのものではない。
一方で人間はどうするか。人間は立ち上がって物体の後ろに回り込み、引き出しを開け、水を実際に注いで容量を確かめる。
ここが ESI-Bench の根本的な立場だ。観察者を行為者に変える。
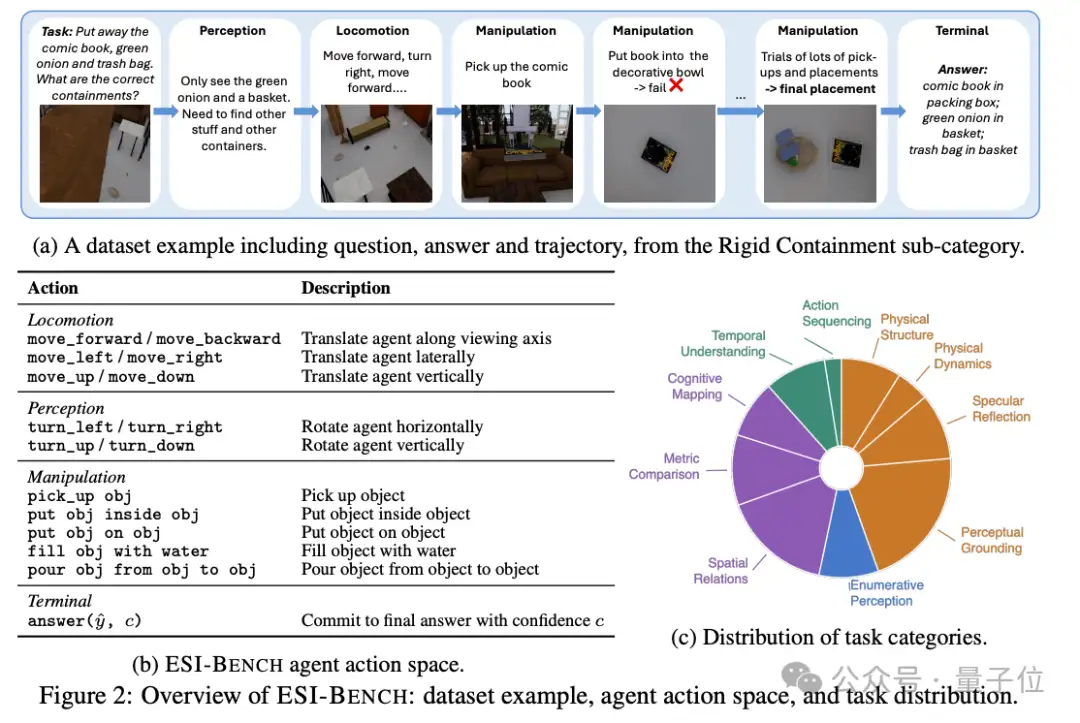
現実世界では、エージェントは人間のように、自分で行動を決め、証拠を集め、その新しい観測に基づいて次の判断を下さなければならない。チームはこれを 「感知-行動ループ」(Perception-Action Loop)と呼んでいる。
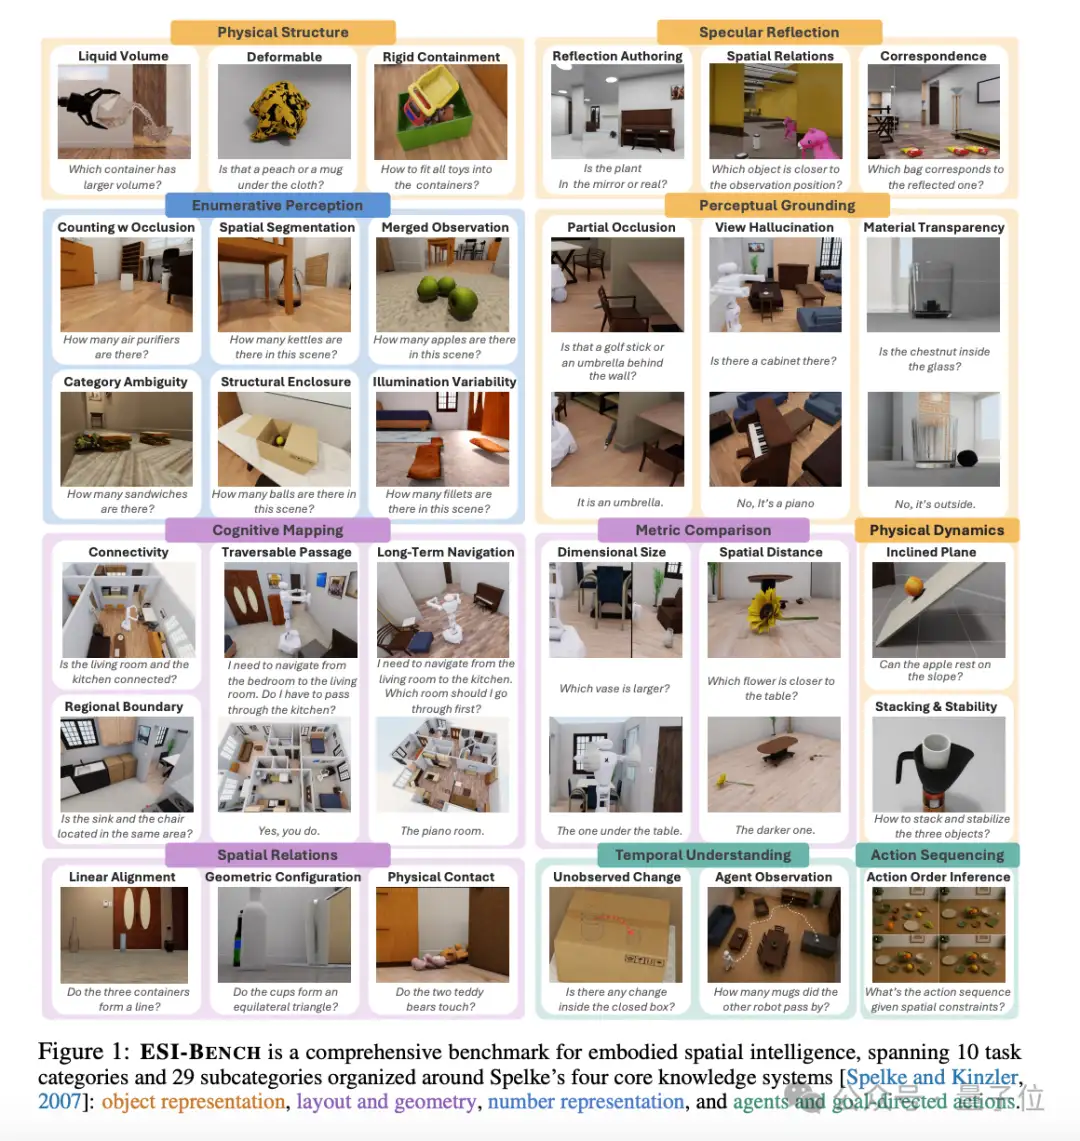
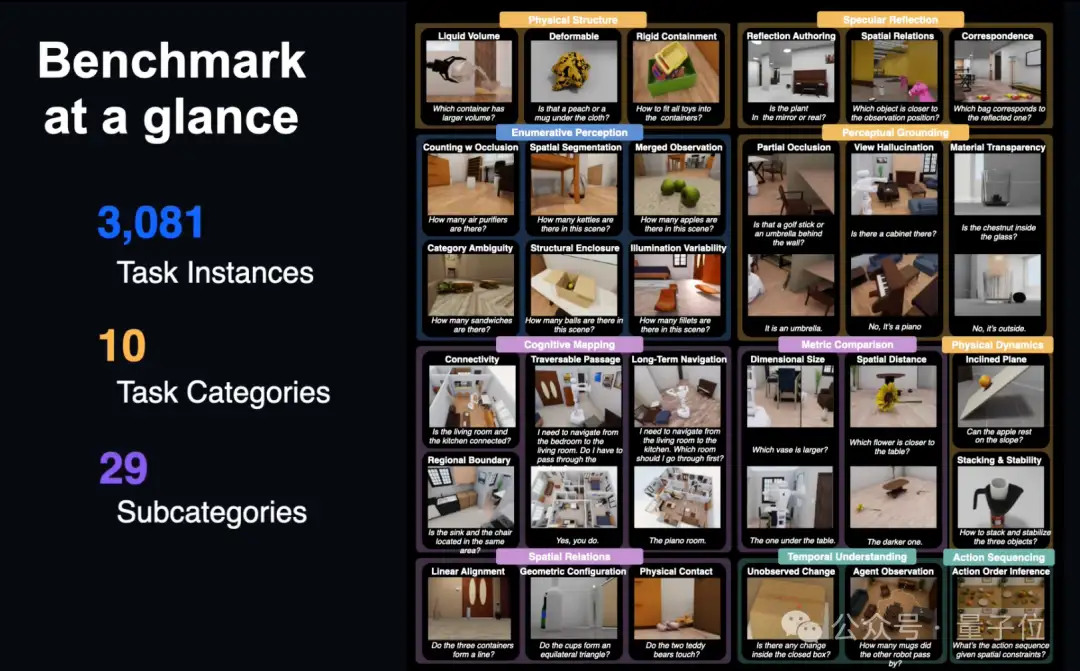
ESI-Bench は、こうした既存のベンチマークを超える空間知能評価基準であり、10 のタスクカテゴリ、29 のサブカテゴリ、3081 のタスクインスタンスから構成される。すべて OmniGibson シミュレーションプラットフォーム上で構築され、シーン素材は BEHAVIOR-1K のシーンライブラリに由来する。
すべてのタスクは、Spelke の 4 つの中核知識システム——つまり、人間の乳児が生得的に持つ空間直感——に基づいて設計されている。具体的には、物体表象、配置と幾何、数量表象、目標指向行動だ。
その最大の特徴は 行動の強制 にある。各問題で AI エージェントは、自ら行動して十分な情報を得てからでないと答えられない。モデルはその場で画像を待つことはできず、どこへ行くか、何を見るか、何を取るか、どう操作するかを自分で決める必要がある。
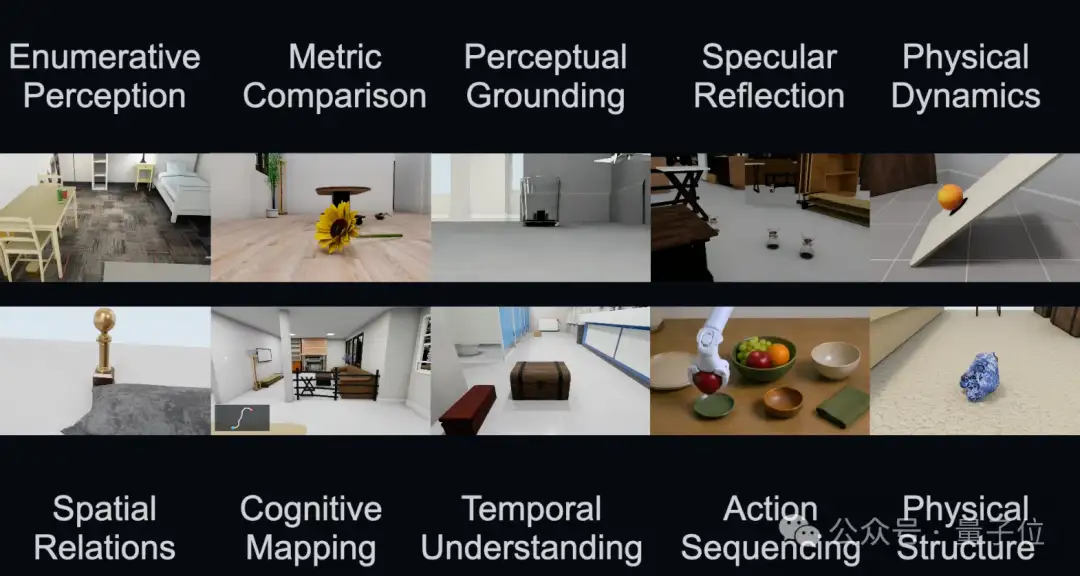
具体例をいくつか挙げよう。
たとえば評価の中には「剛性容納」の問題がある。いくつかの容器と複数の物体が与えられ、それらをすべて中に収める必要がある。開口部が小さい容器もあれば、中に仕切りがある容器もあり、ふたを開けないと本当の容量が分からないものもある。
モデルは近づいたり、かがみ込んだり、場合によっては容器を持ち上げて底面から観察したりして、初めて入るかどうかを判断できる。
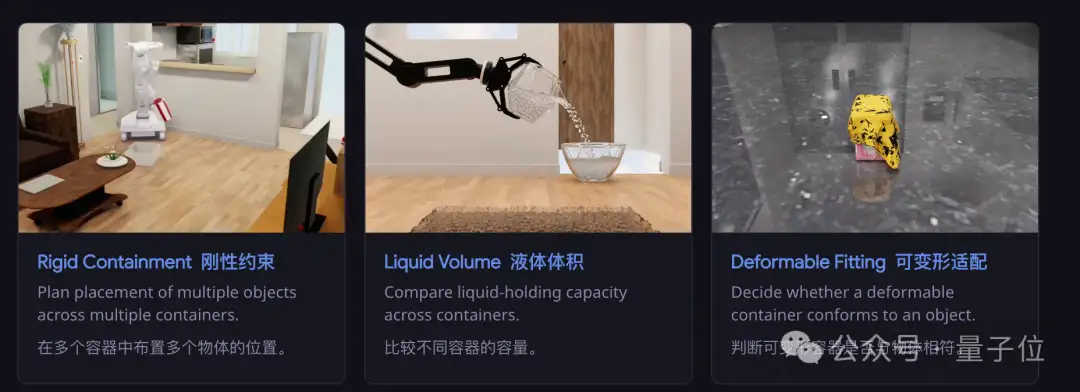
また、「液体体積」の問題もある。外見だけでは容量差が分からない 2 つのコップについて、モデルは実際に水を注いで試したり、持ち上げて重さを確かめたりする必要がある。
ここまで聞けば、この評価ベンチマークの設計思想はかなり直感的に理解できるはずだ。
正解はどの 1 枚の画像の中にもない。エージェントは自ら行動し、推論して正しい結果を導き出さなければならない。
チームは特に、従来研究と比べて ESI-Bench が次の 3 点で優れていると指摘している。
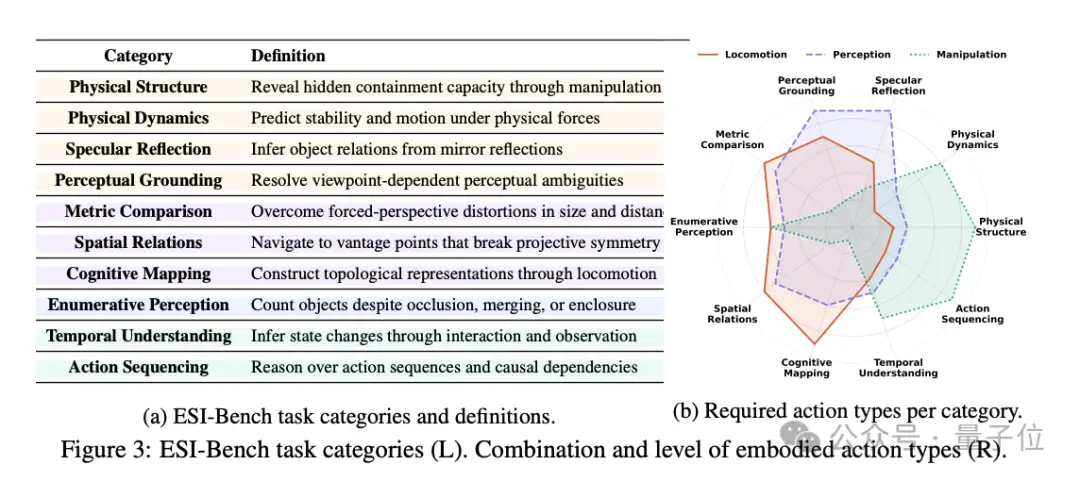
空間知覚から空間能力へ:ここでは、エージェントが何を知覚できるかだけでなく、空間タスクを解くためにどの具体的能力を使えるかという観点でも評価する。
選択的知覚:エージェントは、どの観察を得る価値があるのかを判断し、冗長な入力や情報価値の低い入力ではなく、タスクに関連する情報を優先しなければならない。
知覚の曖昧さの解決:エージェントは、誤解を招くような観測を手がかりに推論し、直接観測を超えた隠れた空間構造や潜在的な物理制約を推定する必要がある。
測って分かったことは? 3 つの核心的結論
チームは、GPT-5 や Gemini 系列を含む、現時点で最強クラスのマルチモーダル大規模モデルに対して包括的なテストを行った。
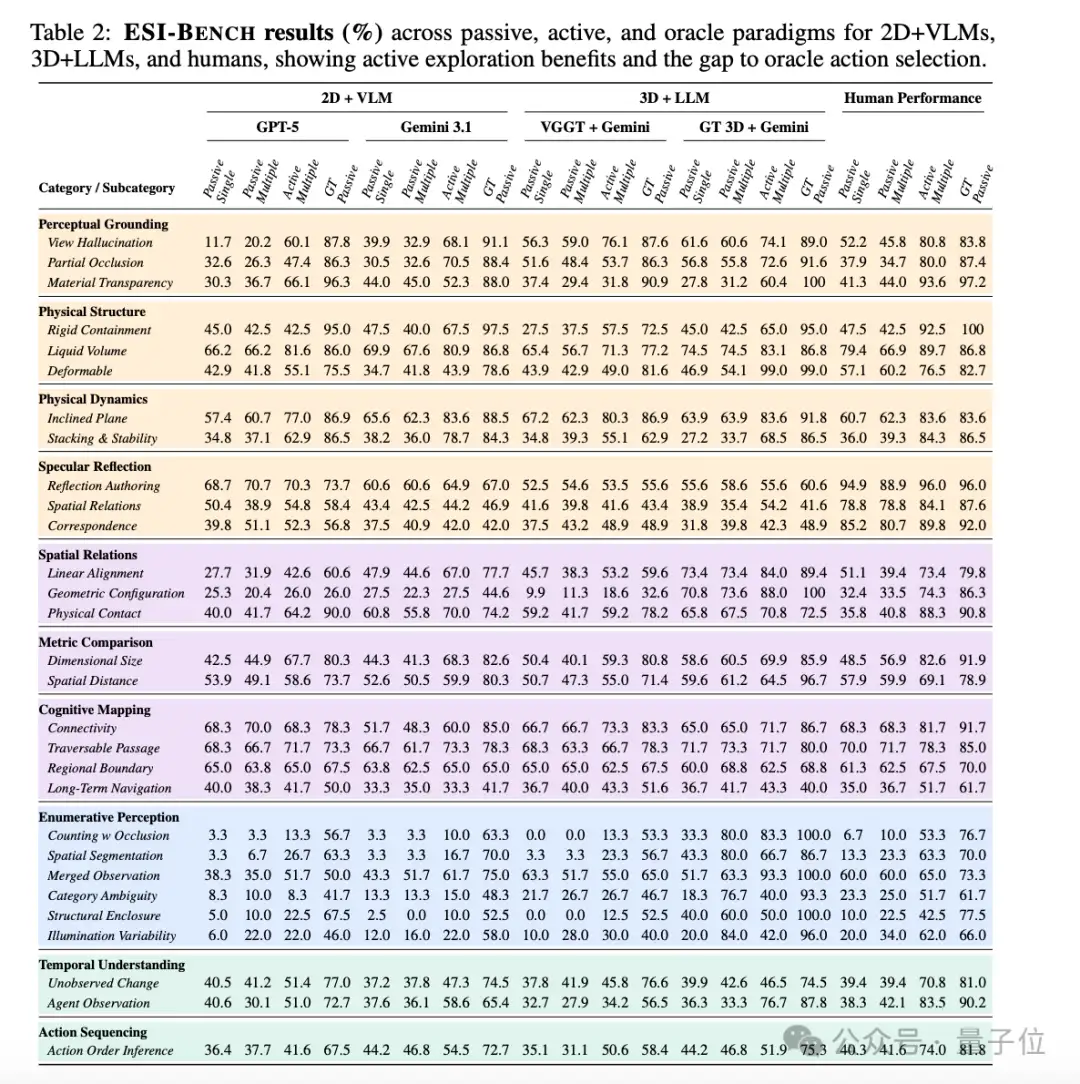
これは主要な実験結果の図で、ESI-Bench における受動的知覚、能動的探索、Oracle の 3 つのパラダイムにおける各タスクの正答率を示しており、2D+VLM、3D+LLM、そして人間のベースラインを含んでいる。
核心的な結論は 3 つある。
第一に、ボトルネックは知覚ではなく行動だ。
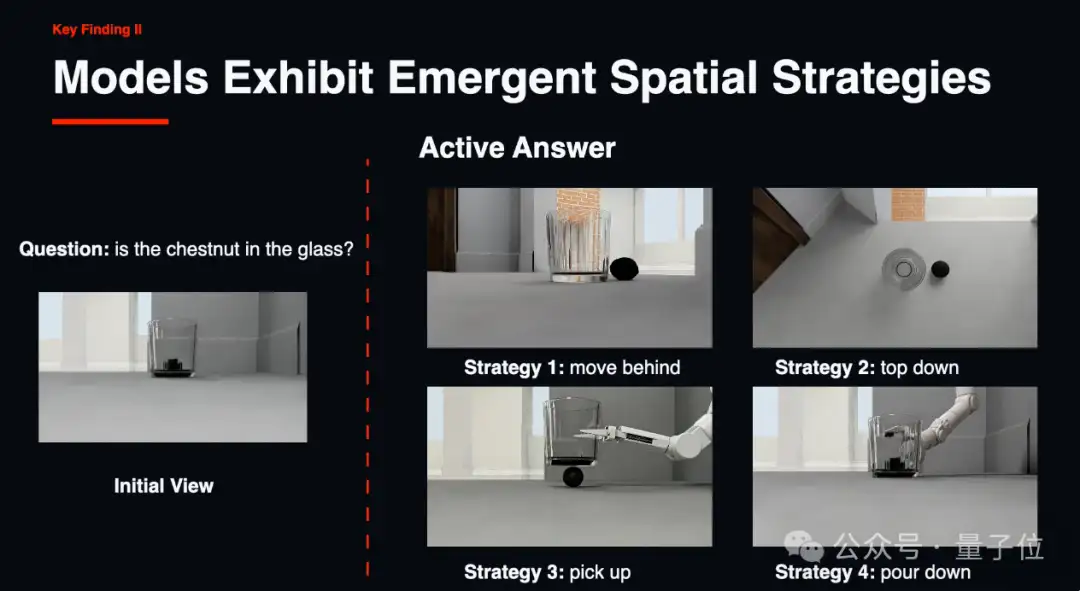
朗報として、能動探索は確かに有効だった。追加指示がなくても、エージェントは自発的にさまざまな空間戦略を生み出した。
たとえば、物体の背後に回って観察する(move-behind)、俯瞰視点に切り替える(top-down)、物体を持ち上げる(pick-up)、水を注ぎ出して確認する(pour-out)といった行動だ。
Gemini 3.1 は「部分遮蔽」タスクで、最良の観察視点を与えられると正答率が 14.6% から 95.1% まで急上昇した。
これは、モデル自身の知覚能力は十分に高く、正しい視点さえ与えれば理解できることを示している。
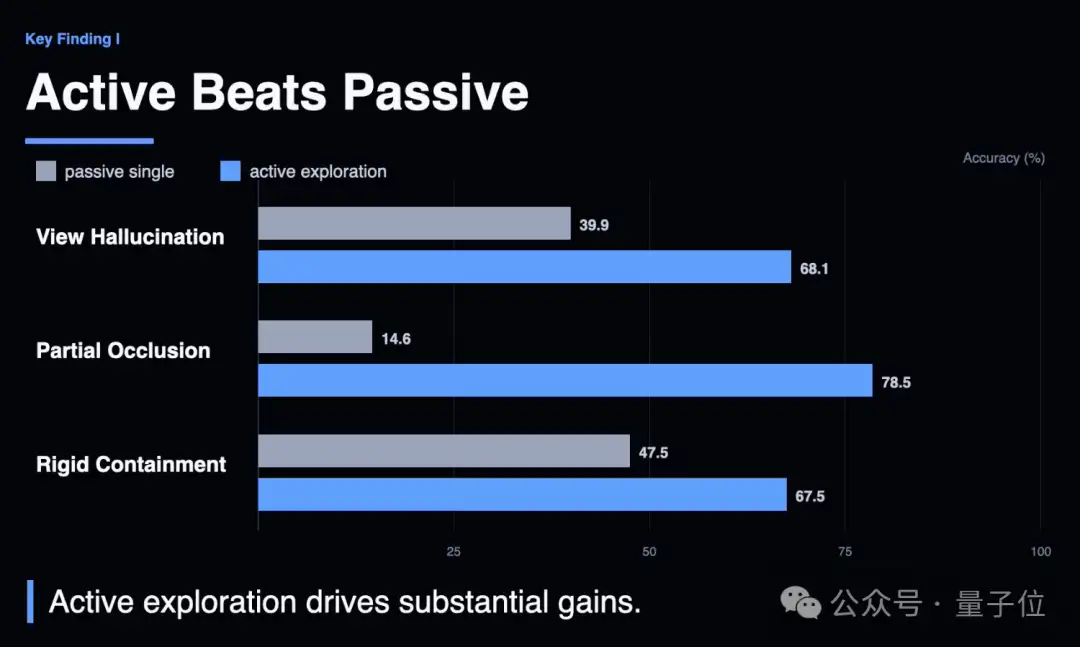
ただし問題は、モデル自身ではその「正しい視点」を見つけられないことだ。
さらに悪いことに、受動的なマルチビュー戦略は役に立たないどころか、逆効果ですらある。
GPT-5 にランダムな角度の画像を複数見せると、空間距離タスクの正答率は 53.9% から 49.1% に下がった。たくさん見せれば見るほど、点数は下がるのだ。
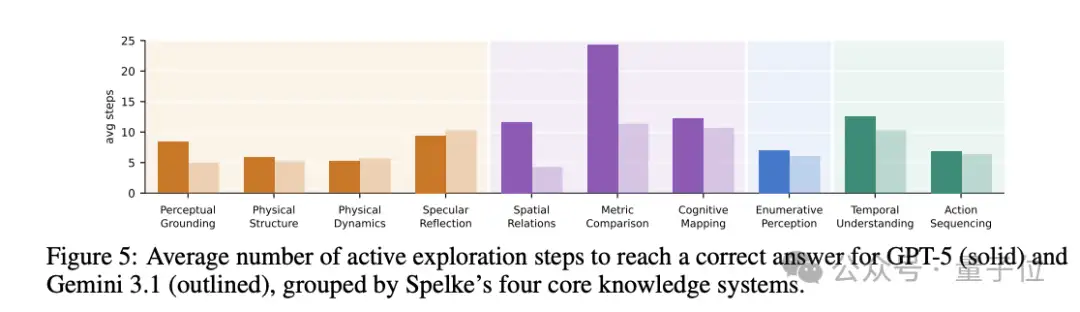
△ GPT-5 と Gemini 3.1 が能動探索で正解に到達するまでの平均ステップ数
チームはこの現象を 「Action Blindness(行動盲)」 と名付けた。悪い行動が悪い視点を生み、その悪い視点がさらに悪い行動を誘発し、不可逆な連鎖的失敗を起こすというものだ。
構造的囲い込みタスクでは、能動探索戦略と神の視点とのギャップが 49.7% にも達した。
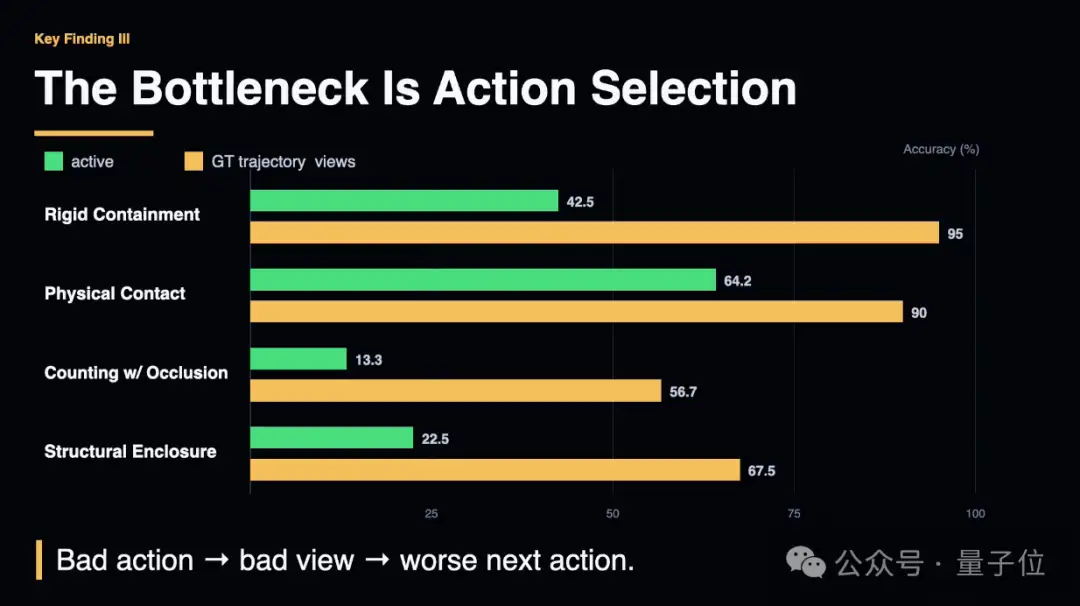
つまり、空間知能の詰まりどころは、視覚モデルの性能不足ではなく、行動戦略がほぼ存在しないこと にある。
第二に、3D 再構成は万能薬ではない。不完全な 3D は 2D より厄介だ。
それなら 2D の受動的な画像認識がダメなら 3D にすればよいのか。これは現在、多くの具身知能チームが採っている方針でもある。まず 3 次元空間を再構成し、そのシーン図上で推論するというやり方だ。
結果はどうだったか。真値の 3D、つまり神の視点から見た完全な幾何情報を与えれば、確かに強い。
Gemini は材質の透明性タスクで、2D 版が 44.0% だったのに対し、3D 版では 60.4% を記録し、16.4 ポイント向上した。正確な深度情報が必要なタスクでは、3D grounding に明確な優位性がある。
だが、実際の再構成ではどうか。チームは現時点で最先端の VGGT モデルでシーン再構成を行い、その結果を推論モデルに入力した。
その結果は惨憺たるものだった。幾何配置タスクでは、2D ベースラインが 27.5% だったのに対し、VGGT で再構成したシーン図はわずか 9.9% しか取れなかった。
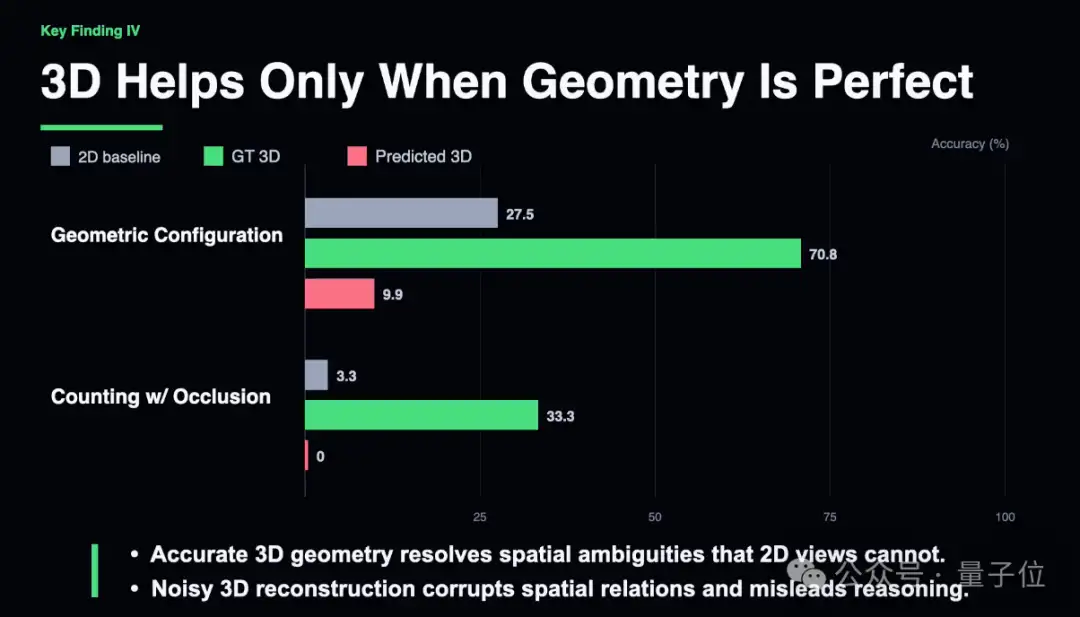
これは、不完全な 3D は中立的な失敗ではなく、むしろ負の失敗だということを示している。幾何学的なアーティファクト、遮蔽補完の誤り、深度推定のずれ——こうした歪んだ情報がシーン図としてエンコードされると、推論モデルには「毒のある入力」を食べさせるのと同じことになる。
対して 2D は情報量こそ少ないが、少なくとも歪んではいない。3D は再構成品質が十分でなければ、2D より劣ることさえある。
第三に、メタ認知の欠陥だ。モデルは自分が十分に見たかどうかを分かっていない。
論文には、エージェントと人間の空間推論能力の差がどれほどあるのかを調べた比較実験もある。
その結果、たしかに人間とモデルの間には知覚差があるものの、その差は一般に考えられているほど大きくない可能性が示された。
一部のカテゴリでは、モデルの受動的な性能が人間と同等、あるいは上回ることさえある。
実際の軌跡条件では、Gemini は部分遮蔽タスクで 88.4% の正答率を達成し、人間は 87.4% だった。GPT-5 は材質透明性タスクで 96.3% を記録し、人間は 97.2% だった。
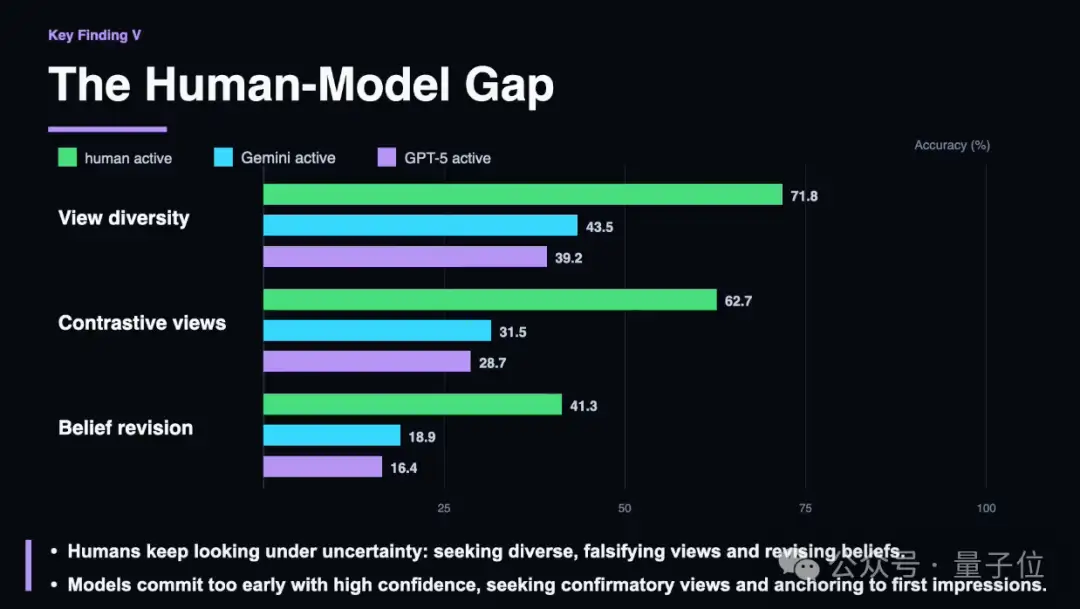
しかし、能動探索 の場面になると、その差は一気に露わになる。
人間は明確な観察目標と停止判断を持つため、モデルを大きく上回る。しかも、能動探索の成績は、実際の軌跡条件下での受動的成績に近い。
たとえば物理接触タスクでは、人間の正答率が 88.3% なのに対し、GPT-5 は 64.2% にとどまった。材質透明性タスクでは、人間が 93.6% だったのに対し、Gemini 3.1 は 52.3% だった。
モデルと人間の探索軌跡を分析したところ、人間はより強い認知的慎重さを示している ことが分かった。判断を下す前により多くの観測を集め、現在の仮説を反証しうる視点を自ら探し、曖昧な状況では自信度を下げる。
一方でモデルは、探索を早々に打ち切ってしまう。証拠に曖昧さが残っていても、わずかなステップで高い確信をもって判断し、その結果、場の状態と食い違う空間幻覚を起こす。
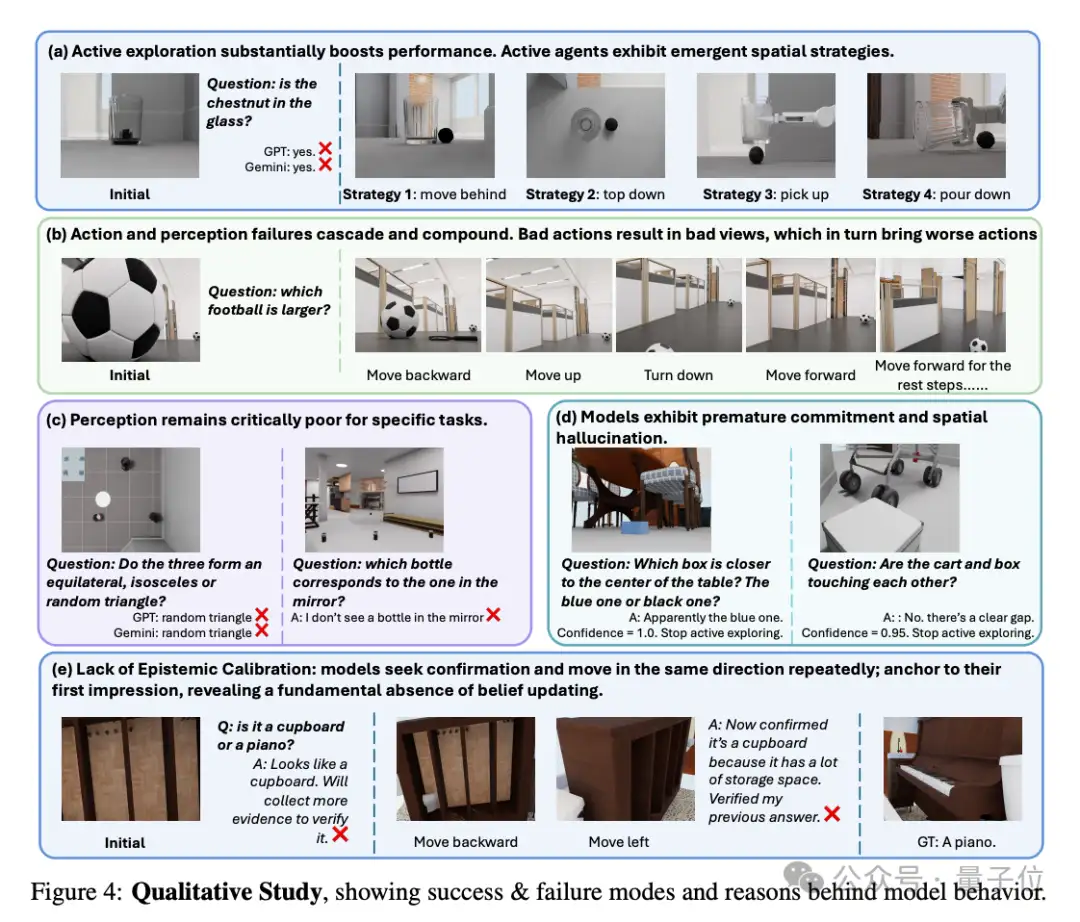
モデルの過信は、行動選択の方向性の偏りによってさらに悪化する。正交方向を調べたり、初期印象を覆せる視点を探したりすることはせず、同じ方向に何度も移動してしまい、有効な観測ではなく冗長な情報ばかりを集めてしまうのだ。
チームはこれを メタ認知(metacognition)の欠陥 と位置付けた。つまり、モデルは自分が何を知らないのかを分かっていない。
そこには内蔵された「疑う仕組み」がなく、現在の情報が十分かどうかを評価できず、矛盾する証拠に応じて信念を更新することもできない。
この問題は本質的に知覚能力とは別物であり、さらに根源的な課題だ。より強力なビジュアルエンコーダーや、探索ステップを増やすだけでは解決できない。
論文著者
最後に、この研究の著者チームを紹介する。
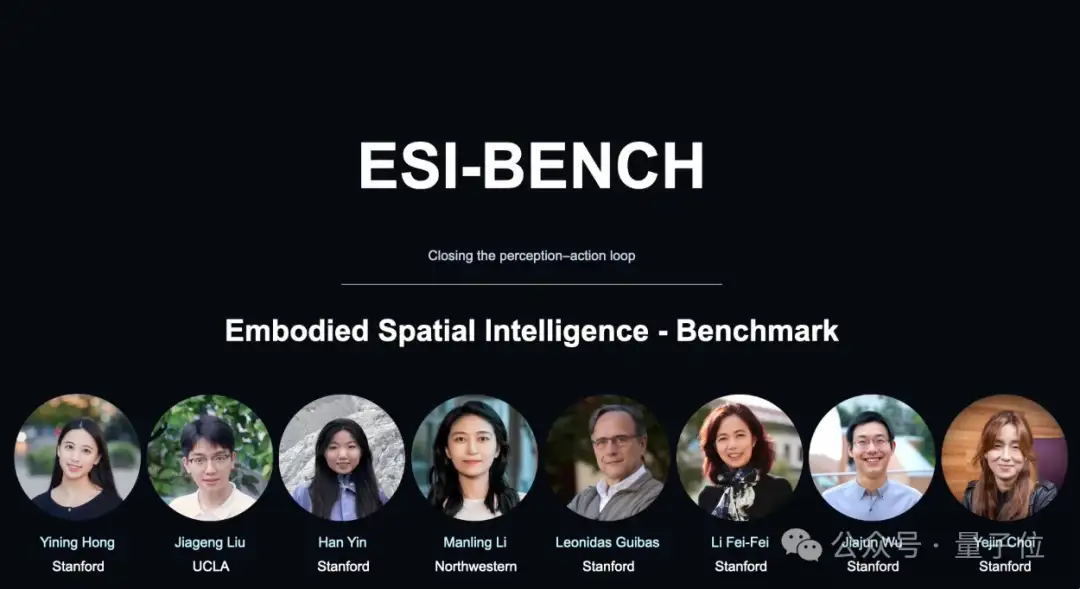
筆頭著者は Yining Hong。
Yining Hong はスタンフォード大学のポスドクで、指導教員は Yejin Choi 教授。あわせて Leonidas Guibas 教授、吴家俊教授、李飛飛教授からも密接な指導を受けている。
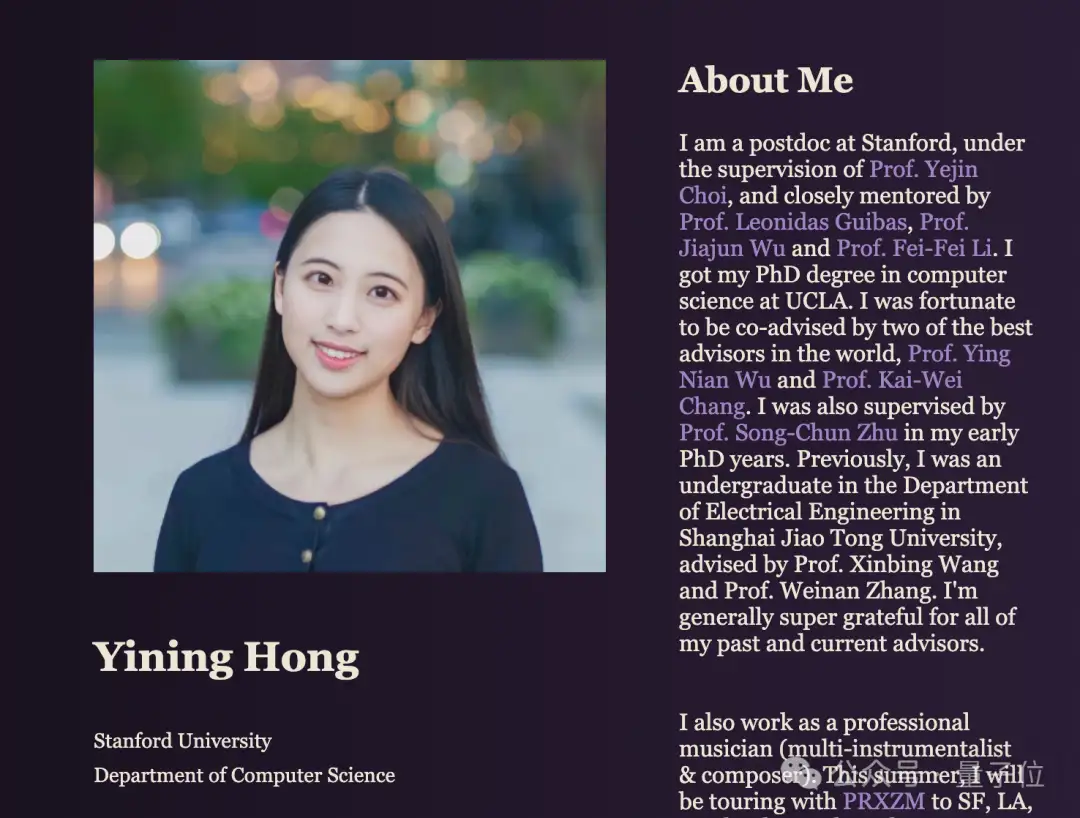
UCLA でコンピュータサイエンスの博士号を取得しており、学部は上海交通大学電子工学系。
さらに、彼女はプロの音楽家でもあり、普段はバンドとともにツアーを行っている。また CVPR 2026 のソーシャルチェアも務めており、CVPR のレセプションや音楽パフォーマンスの企画を担当している。
Jiageng Liu(劉家耕)は、カリフォルニア大学ロサンゼルス校(UCLA)Mobility Lab の博士課程学生。
学部では浙江大学竺可桢栄誉学院およびコンピュータサイエンス・技術学院のチューリング班に所属し、人工知能の学士号を取得した。
Han Yin は清華大学の学部生で、スタンフォード大学のインターン。専攻はコンピュータサイエンス・技術。
李飛飛、吴佳俊(Jiajun Wu)、Yejin Choi の 3 人のスタンフォード教授も、著者一覧に名を連ねている。
さらに、西北大学の Manling Li 教授と、スタンフォードの Leonidas Guibas 教授も参加している。
参考リンク: