
Ettin Reranker シリーズの紹介
公開日: 2026年5月19日
TL;DR
本日、各スケールで最先端性能を達成した、6つの新しい Sentence Transformers の CrossEncoder リランキングモデル(reranker)を公開しました。これらのモデルは Ettin ModernBERT エンコーダーを基盤として構築されており、あわせて、これらのモデルの生成に使用したデータと完全な学習レシピも公開しています。
cross-encoder/ettin-reranker-17m-v1cross-encoder/ettin-reranker-32m-v1cross-encoder/ettin-reranker-68m-v1cross-encoder/ettin-reranker-150m-v1cross-encoder/ettin-reranker-400m-v1cross-encoder/ettin-reranker-1b-v1
これらのモデルは蒸留レシピで学習されています。具体的には、cross-encoder/ettin-reranker-v1-data 上で mixedbread-ai/mxbai-rerank-large-v2 のスコアに対して、点ごとの MSE(平均二乗誤差)で学習しています。このデータセットは lightonai/embeddings-pre-training のサブセットに、lightonai/embeddings-fine-tuning のリランキング用サブセットを組み合わせたものです。
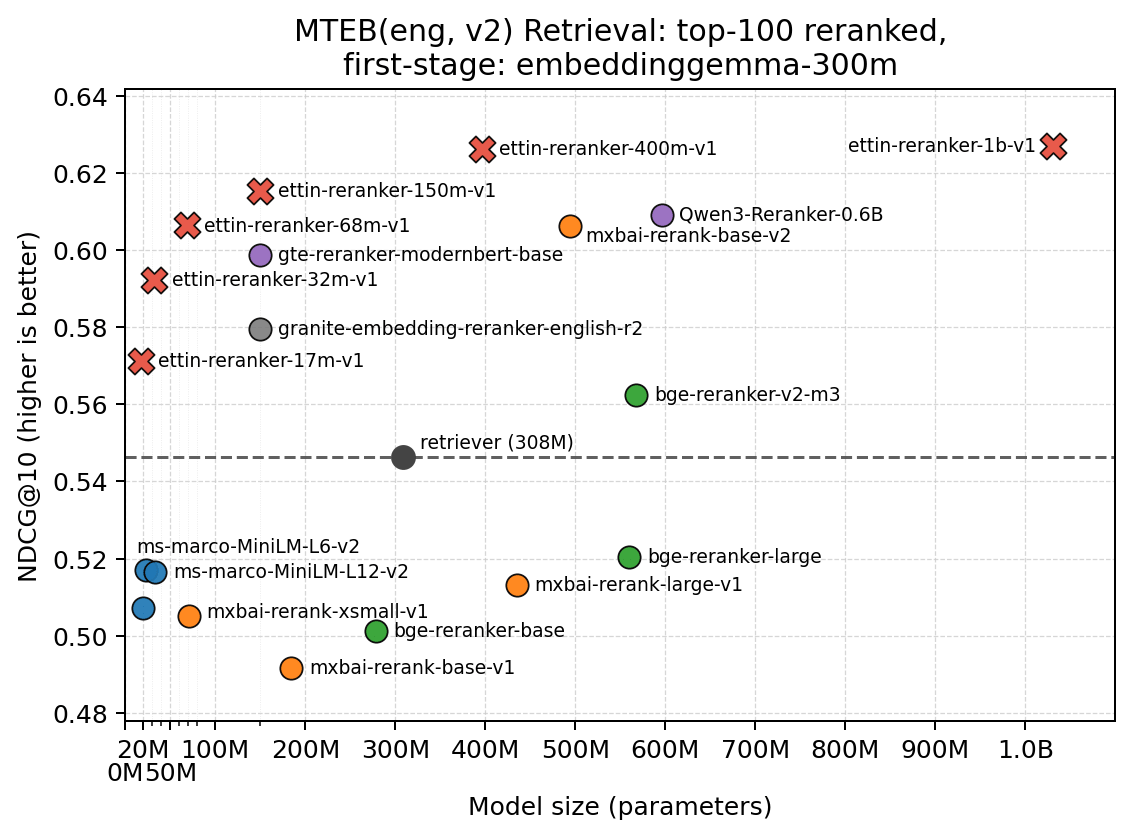
この6つのリランキングモデルを google/embeddinggemma-300m と組み合わせた場合の、MTEB(eng, v2) Retrieval における性能です。その他の embedding モデルとの組み合わせは Results をご覧ください。
reranker を初めて使う方で、まず「なぜ使うのか」を知りたい場合は、reranker とは何か、そしてなぜ embedder と組み合わせるのか? へ進んでください。モデルをすぐに使いたい場合は、用法 へ進んでください。自分のモデルを学習したい場合は、学習 へ進んでください。
以下の学習レシピの起点として、Sentence Transformers v5.5.0 で新たに追加された
train-sentence-transformersAgent Skill を使用しました。これはhf skills add train-sentence-transformers [--global] [--claude]でインストールでき、AI コーディングエージェント(Claude Code、Codex、Cursor、Gemini CLI など)に対して、あなたのデータを使ったSentenceTransformer、CrossEncoder、またはSparseEncoderモデルのファインチューニングを指示できます。