
OlmoEarth v1.1:より効率的な地球観測モデルファミリー
チーム記事、2026年5月19日公開
🧠 モデル:https://huggingface.co/collections/allenai/olmoearth | 📄 技術報告書:https://allenai.org/papers/olmoearth_v1_1 | 💻 コード:https://github.com/allenai/olmoearth_pretrain
私たちは 2025年11月に OlmoEarth(v1)を公開しました。それ以来、パートナーはこれを幅広いタスクに適用してきました。たとえば、マングローブの変化追跡、森林損失の要因分類、数日以内での国レベルの作物種マップの生成、そして国家規模、さらには大陸規模・地球規模への展開などです。リリースを重ねるたびに、私たちは使命に一歩ずつ近づいています。それは、人類と地球の保護に取り組む組織やコミュニティに、最先端の AI を届けることです。
OlmoEarth が衛星画像を処理し、数万から数十万平方キロメートルの範囲で予測を行うとき、効率性が多くの可能性を左右します。OlmoEarth のライフサイクル全体、つまりデータのエクスポート、前処理、推論、後処理を通じて、最も大きなコスト要因は間違いなく計算資源です。より効率的なモデルであれば、OlmoEarth Platform 上でより多くのパートナーを支援できるようになりますし、独自に OlmoEarth を運用するユーザーにとっても、より高速かつ低コストでこの技術を活用できることを意味します。
そこで私たちが構築したのが OlmoEarth v1.1 です。これは、私たちがパートナーと共同で構築した一連の研究ベンチマークとタスクにおいて、OlmoEarth v1 の性能を維持しながら、計算コストを最大 3倍 削減する新しいモデルファミリーです。
シーケンス長を短くして効率を向上させる
OlmoEarth のモデルは transformer ベースです。transformer は、現在の機械学習において最も支配的なアーキテクチャのひとつです。リモートセンシングデータを扱うには、まずそれをモデルが入力できる token の列に変換します。
transformer モデルの効率に影響する重要な要素は 2 つあります。モデルサイズ(そのため、私たちはさまざまなサイズのモデルを提供し、ユーザーが計算予算に応じて適切なものを選べるようにしています)と、token シーケンス長です。計算コストは token シーケンス長の二乗に比例して増えるため、わずかに短くするだけでも、モデルの実行コストを大幅に下げられます。
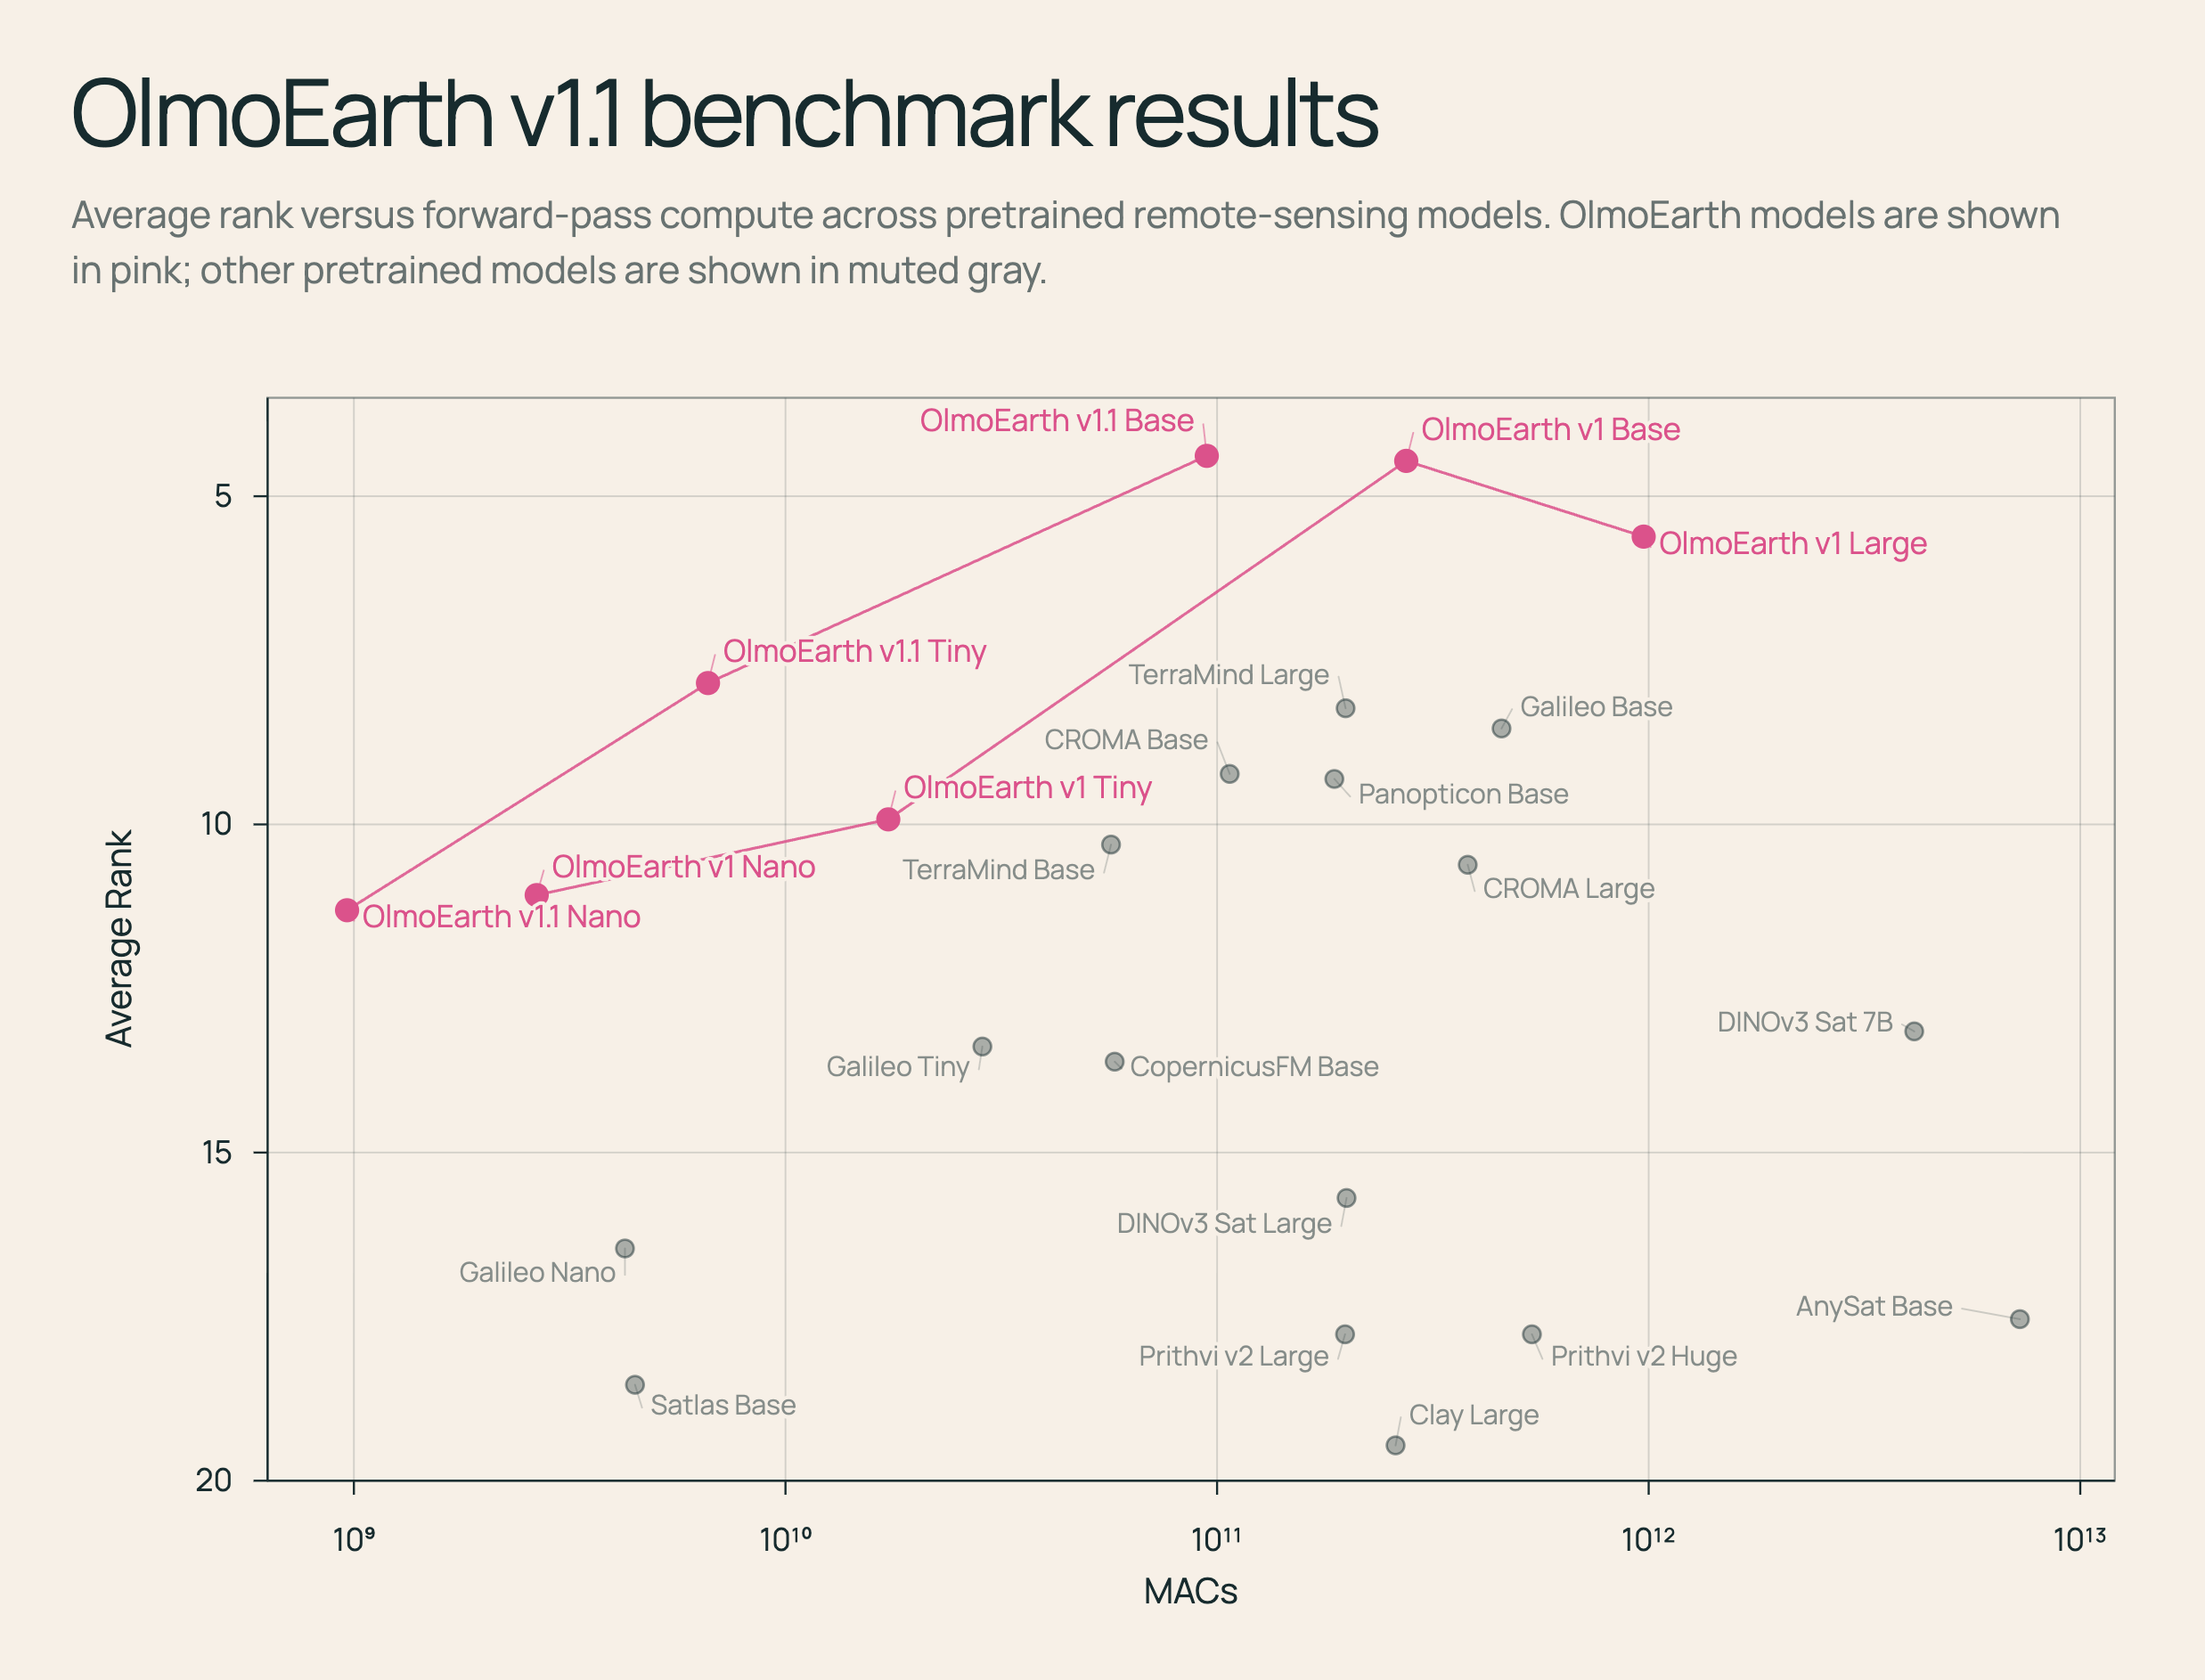
MACs(乗算加算回数)は、1 回のモデルの順伝播に必要な計算量の目安です。MACs が低いほど、一般に推論コストは低く、速度は速くなります。縦軸が逆向きなのは、平均順位は低いほど良いからです。ラベルはモデルファミリーと規模を示しています。図にプロットされた点は、すべて図中に示された MAC/順位の値を使用しています。
トークンの設計
ここで、transformer ベースのリモートセンシングモデルにおける重要な問いが浮かびます。token は何を表すべきか?
私たちがよく扱う代表的なモダリティである Sentinel-2 画像を例に見てみましょう。Sentinel-2 の入力は、高さと幅(H、W はそれぞれ緯度方向・経度方向のピクセル数を表す)、時間次元 T、そして Sentinel-2 の 12 チャンネルを持つテンソル([H, W, T, D=12])になります。
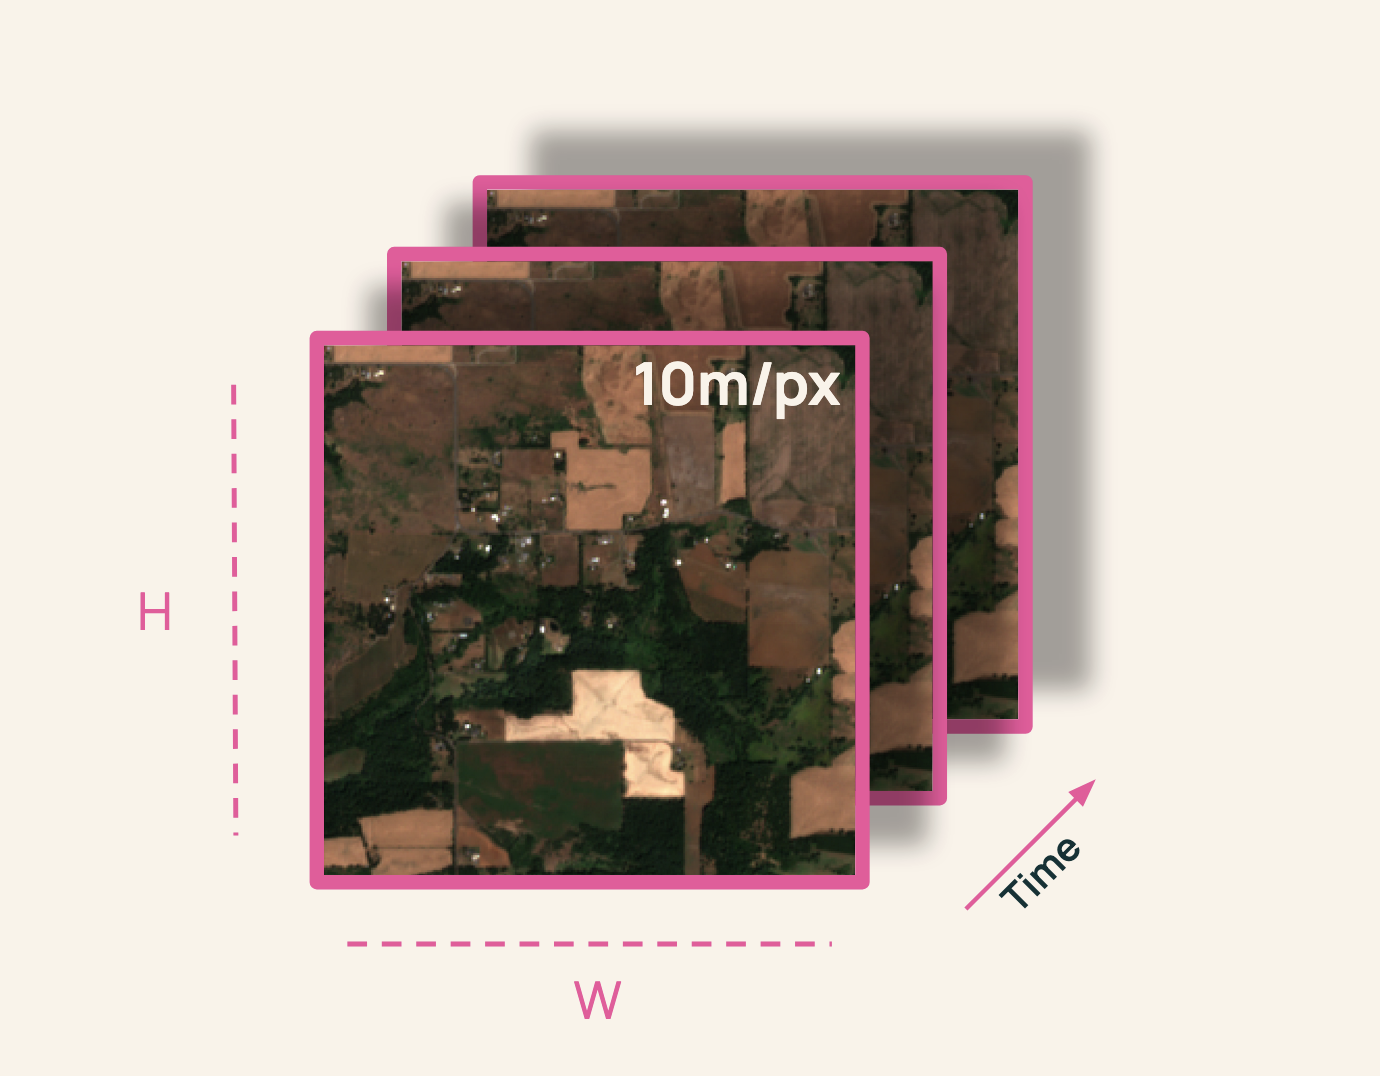
現在、私たちはデータを 解像度ベースの patch に分割しています。具体的には、空間的な patch サイズ p を決め、Sentinel-2 画像全体を p x p の patch に切り分けます。
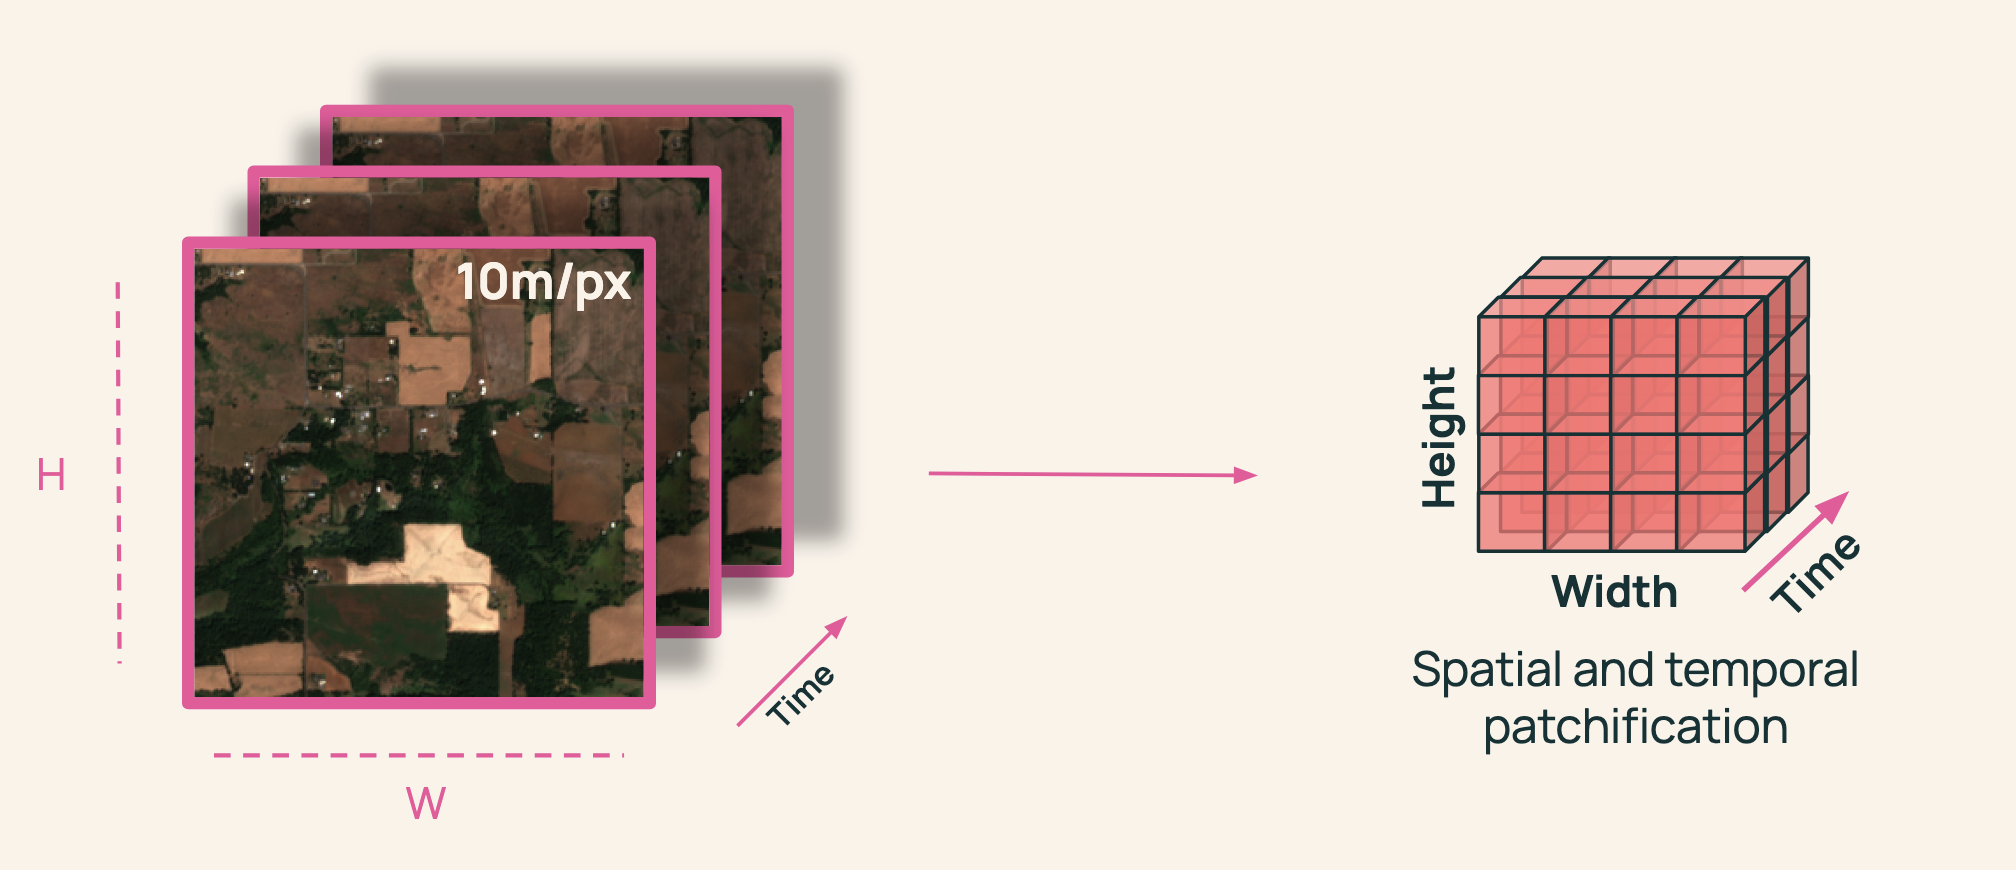
各 patch について、各時間ステップ、各解像度ごとに token を作成します。したがって、2 つの時間ステップを含む Sentinel-2 入力では、各 patch から 6 個の token が生成されます(2 つの時間ステップ × 3 つの解像度、10m、20m、60m)。
全体として、[H, W, T, D=12] の Sentinel-2 入力は、H/p × W/p × T × 3 個の token を生成します。
各解像度に固有の token を割り当てる方法は、Sentinel-2 データを扱う際によく使われる手法です。たとえば Galileo や [SatMAE](https://arx