
私は、PyCon US 2026 で行った 5 分間のライトニングトークで使った、注釈付きスライドをまとめました。これは、私の最新版の注釈付きプレゼンテーションツールを使っています。


6 か月という期間はかなりちょうどよく、私が2025 年 11 月の転換点と呼んでいる時期を含んでいます。11 月は LLM 分野、特にコーディングにおいて重要な月でした。

まず、「最良」と見なされるモデルの座(もちろんかなり主観的ですが)は、3 大プロバイダーの間で 5 回も入れ替わりました。

いつものように、モデル間の違いを示すために、私の「自転車に乗るペリカンの SVG を生成する」テストを使いました。
なぜこのテストなのか? ペリカンを描くのは難しいし、自転車を描くのも難しい。しかもペリカンは自転車に乗れない……そして、どの AI ラボも、こんなばかばかしいタスク専用にモデルを訓練する可能性はまずありません。
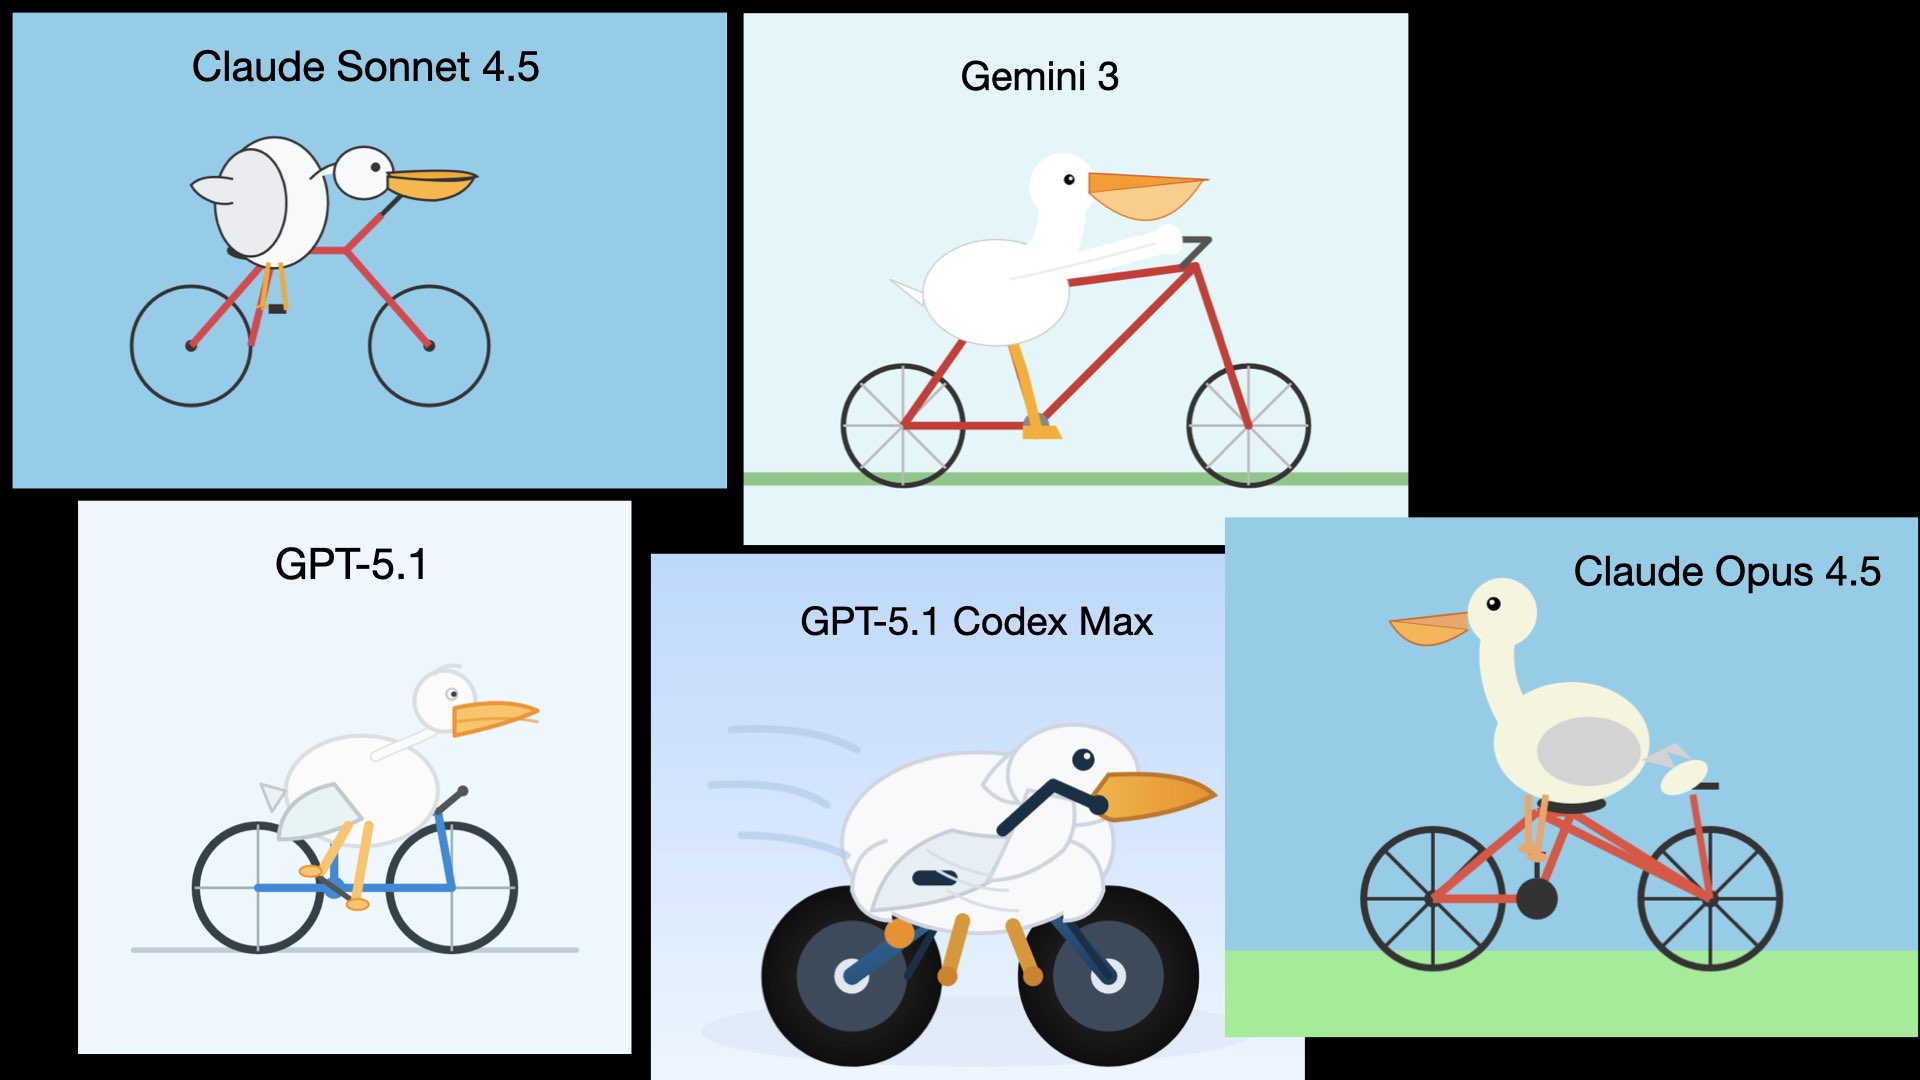

11 月初の時点で、広く「最高」と認識されていたモデルは、2025 年9 月 29 日に公開された Claude Sonnet 4.5 でした。これがこのペリカンを描いてくれました。
その後 11 月の間に、GPT-5.1、Gemini 3、GPT-5.1 Codex Maxに次々と抜かれ、最終的には Anthropic がClaude Opus 4.5で王座を取り返しました。
この中では Gemini 3 が描いたペリカンが一番良いと思いましたが、ペリカンだけがすべてではありません。実務者の大半は、Opus 4.5 がその後数か月にわたってトップの座を維持したことに同意するでしょう。

これはしばらくしてからはっきりしてきたのですが、11 月の本当のニュースは、コーディングエージェントが使えるレベルになったことでした。
OpenAI と Anthropic は 2025 年の大半を通じて、モデルのコード生成品質を高めるために検証可能な報酬に基づく強化学習を行っていました。特に Codex や Claude Code などのエージェントフレームワークと組み合わせることで、その効果が大きく出ました。
11 月になると、その成果が表れ始めました。コーディングエージェントは「かなり使える」から「ほぼそのまま使える」段階へと進み、質的な一線を越えたのです。もはや、愚かなミスを何度も直すことに大半の時間を費やさなくても、日々の主力ツールとして本当に仕事を任せられるようになりました。


休暇シーズンの 12 月から 1 月にかけて、多くの人がその新しいモデルやコーディングエージェントを試し、何ができるのか確かめていました。
できることは本当に多かったのです! そのせいで、少し熱くなりすぎた人もいました。私自身も、野心的なプロジェクトをいくつか立ち上げて、どこまで押し進められるか試し始めた結果、軽く LLM 由来の錯乱状態に陥りました。