
連続バッチ処理における非同期能力を解き放つ
公開日:2026年5月14日
RL:CPU と GPU のワークロードを分離することで、推論において大幅な性能向上を実現する方法を説明します。
これは、高効率な LLM 推論シリーズの第2回です。第1回では、第一原理に立ち返って continuous batching を解説しました。そこでは、後続で使うことになるいくつかの概念、たとえば KV キャッシュ、FlashAttention、Attention mask などを導入しました。
Inference Endpoints では、H200 1台の料金はおよそ1時間あたり5ドルです。時間単位ではそれほど高く見えませんが、1日中使えば120ドルになります。このような状況では、GPU をできるだけ高い稼働率で使いたいところです。
これまで見てきたように、continuous batching は、ぴったり詰めたバッチをスケジューリングすることで padding による無駄を減らし、GPU の利用率を高めます。しかし、continuous batching でも別の種類の無駄は解消できません。デフォルトでは同期的に動くためです。つまり、CPU と GPU が交互に作業します。GPU が計算している間は CPU が待機し、CPU が次のバッチを準備している間は GPU が待機します。1秒あたり数百ステップも回るループでは、こうしたアイドル時間が積み重なり、後で示すように、全体の実行時間の4分の1近くを占めることもあります。GPU を100%の時間、計算に使い続けるには、こうした隙間をなくす必要があります。
そのために使えるのが 非同期バッチ処理 です。CPU によるバッチ準備と GPU によるバッチ計算を切り離し、両者を並行して動かすことで、GPU を常に効率よく稼働させます 🔥
同期バッチ処理
まず、素朴な同期バッチ処理がどのように動くかを見てみましょう。
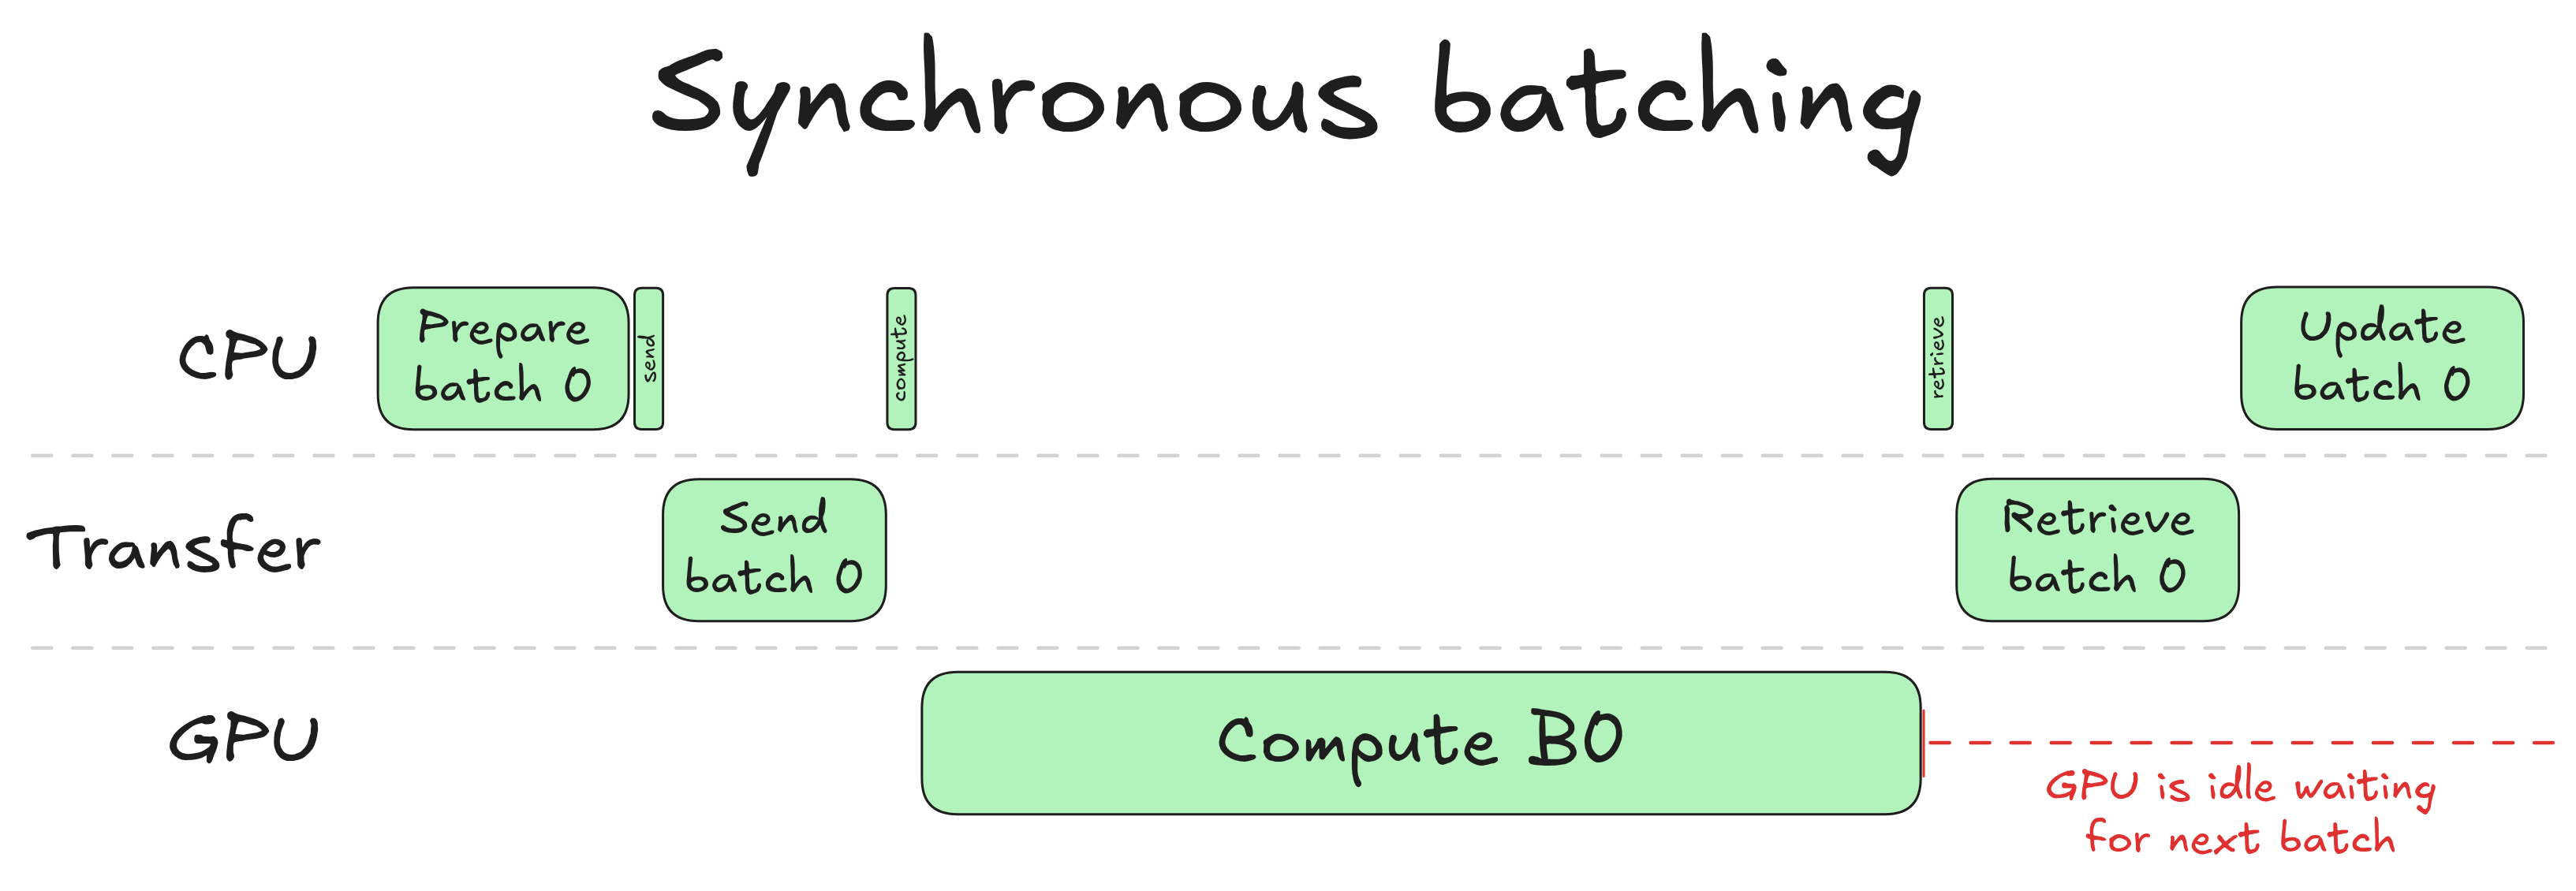
CPU が新しいバッチを準備するときは、どのリクエストを含めるかを選び、KV キャッシュ表を更新し、前回のラウンドですでに完了したリクエストを追い出し、空いた領域を埋めるために新しいリクエストを受け入れます。これらが終わると、準備した入力を GPU に転送します。GPU は forward pass を実行し、各リクエストに対して新しい token を sampling(つまり選択)します。その結果が CPU に返され、CPU は各リクエストが直前にどの token を生成したかを把握できます。そして、この一連の流れが再び繰り返されます。
右側の赤い注記に注目してください。GPU は計算を終えると、すぐにアイドル状態に入ってしまいます。次のバッチは、CPU が更新処理を終えるまで開始できません。つまり、output token の sampling、リクエスト状態の更新、バッチの再スケジューリングが必要です。
これが同期バッチ処理の根本的な非効率さです。CPU と GPU が交互にしか働けないのです。GPU が計算している間は CPU が空き、CPU が更新している間は GPU が空きます。どちらも同時に有用な作業をすることはできません。単発の forward pass だけ見れば小さなコストに見えるかもしれませんが、1秒あたり数百ステップで回る continuous batching のループでは、こうしたアイドル時間が積み重なって、実際のスループット低下につながります。
これを示すために、8B モデル、batch size 32、8K token 生成時に CPU と GPU に費やされた時間を分析しました。