
AWS 上で基盤モデルの学習と推論に用いられる構成要素
企業記事 2026年5月11日公開
基盤モデルにおいて、長らく「スケーリング」とは実質的に一つの意味しかありませんでした。つまり、事前学習により多くの計算資源を投じれば、能力は向上するという考え方です。この見解は、Kaplan ら(2020) のような実証研究によって裏づけられてきました。同研究では、モデルのパラメータ数、データセット規模、学習計算量 を拡大すると、損失関数が予測可能なべき乗則に従って変化することが報告されています。実際、こうした傾向は、大規模なアクセラレータ計算資源と、それを効率的に活用するために必要な分散基盤へ継続的に投資する根拠となってきました。
しかし最前線は進化しています。スケーリングはもはや一つの曲線だけではありません。NVIDIA が提唱する「1本から3本のスケーリング則へ」という表現は、事前学習に加えて、性能が 後学習(たとえば教師あり微調整(SFT)や強化学習(RL)ベースの手法)や テスト時の計算資源(「長い思考」、検索/検証、マルチサンプル戦略)によっても、ますます向上していることを的確に示しています。
図1: NVIDIA のブログ記事 「AI の3つのスケーリング則を解説する」 をもとに改変。
総合すると、これらのスケーリング・パラダイムは、基盤モデルのライフサイクル――事前学習、後学習、推論――における基盤インフラ要件を収束させつつあります。つまり、密に連携したアクセラレータ計算、高帯域・低遅延ネットワーク、そして分散ストレージ・バックエンドです。また、リソース管理のオーケストレーションの重要性を高めるとともに、クラスタの健全性を維持し、大規模環境で性能異常を診断するうえで、アプリケーション層とハードウェア層の両方における可観測性が不可欠であることを強調しています。
もう一つの重要な潮流は、基盤モデルのライフサイクルが、モデル開発フレームワーク、クラスタのリソース管理、運用ツールを含むオープンソースソフトウェア(OSS)エコシステムへの依存を強めていることです。クラスタ層では、リソース管理は通常 Slurm や Kubernetes のようなシステムによって提供されます。モデル開発や分散学習は通常、PyTorch や JAX のようなフレームワークで実装されます。監視と可視化――すなわち可観測性――は、一般に Prometheus によるメトリクス収集と、Grafana による可視化・アラートを通じて実現され、インフラとリソース管理の上位に位置する運用レイヤーとして機能します。図1はこの階層アーキテクチャを示しており、ハードウェア基盤がリソースオーケストレーションを支え、そのリソースオーケストレーションが ML フレームワークを支援し、さらに可観測性がすべての層にまたがって作用することを表しています。
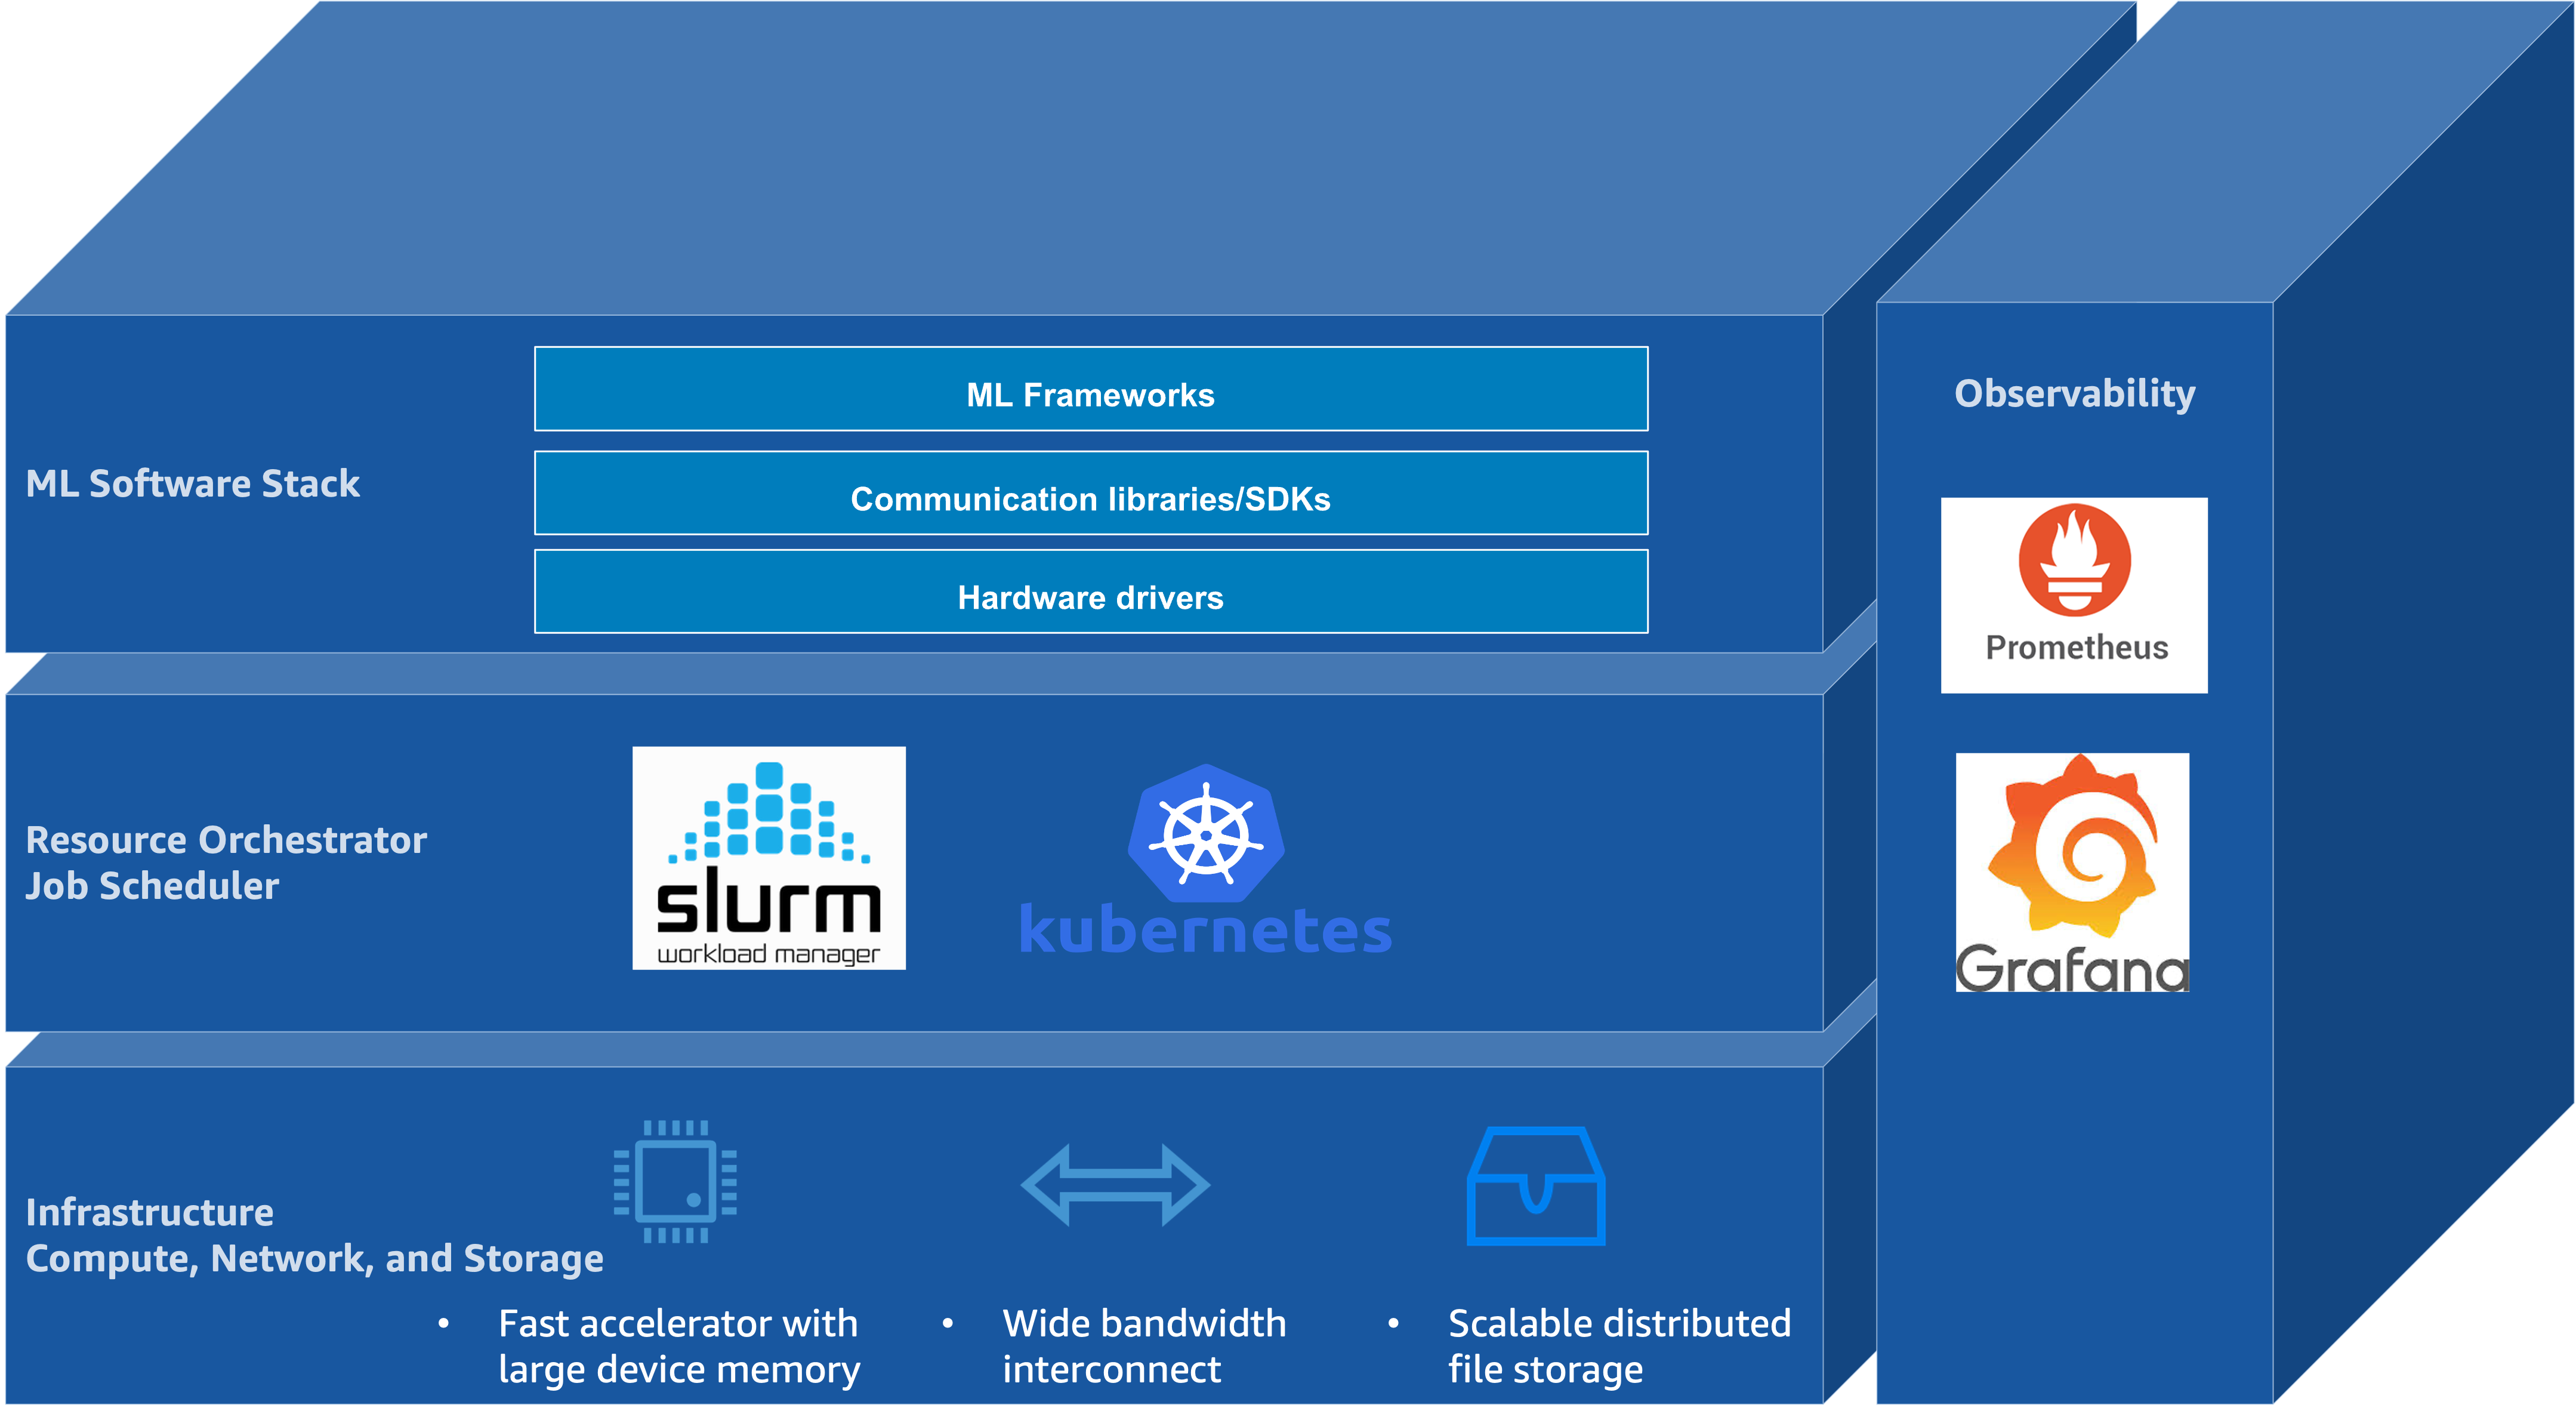
図1:基盤モデルの学習と推論に向けたオープンソースソフトウェアスタックの階層アーキテクチャ
この記事は、基盤モデルの学習と推論に携わる機械学習エンジニアおよび研究者を対象としており、重点的に……