
vLLM V0 から V1 へ: RL ではまず正しさを担保し、その後で修正する
2026 年 5 月 6 日公開
Rafael Pardinas rafapi-snow をフォロー
PipelineRL は、rollout 生成の推論エンジンとして vLLM を使用しています。推論エンジンは token をサンプリングして token の logprob を返し、トレーナーはその logprob を使って policy ratio、KL、clip rate、entropy、reward を計算します。logprob の計算に少しでも違いがあれば、学習ダイナミクスは変化します。これが、vLLM V0 から V1 への移行において、訓練と推論の不一致を取り除かなければならなかった理由です。
要約。 4 つの点を修正した結果、vLLM V1 は、当社の vLLM V0 参照実装と整合しました。具体的には、処理後の rollout logprob、V1 特有の実行時デフォルト値、オンライン重み更新パス、そして最終射影に使う fp32 lm_head です。RL の目標を変更する前に、まずバックエンドの挙動を修正しました。
参照ランは vLLM 0.8.5 を使用し、V1 ランは vLLM 0.18.1 を使用しています。図 1 は最終結果を示しています。赤い曲線が最初の V1 試行で、緑の曲線が、以下で説明する修正後の最終的な V1 ランです。
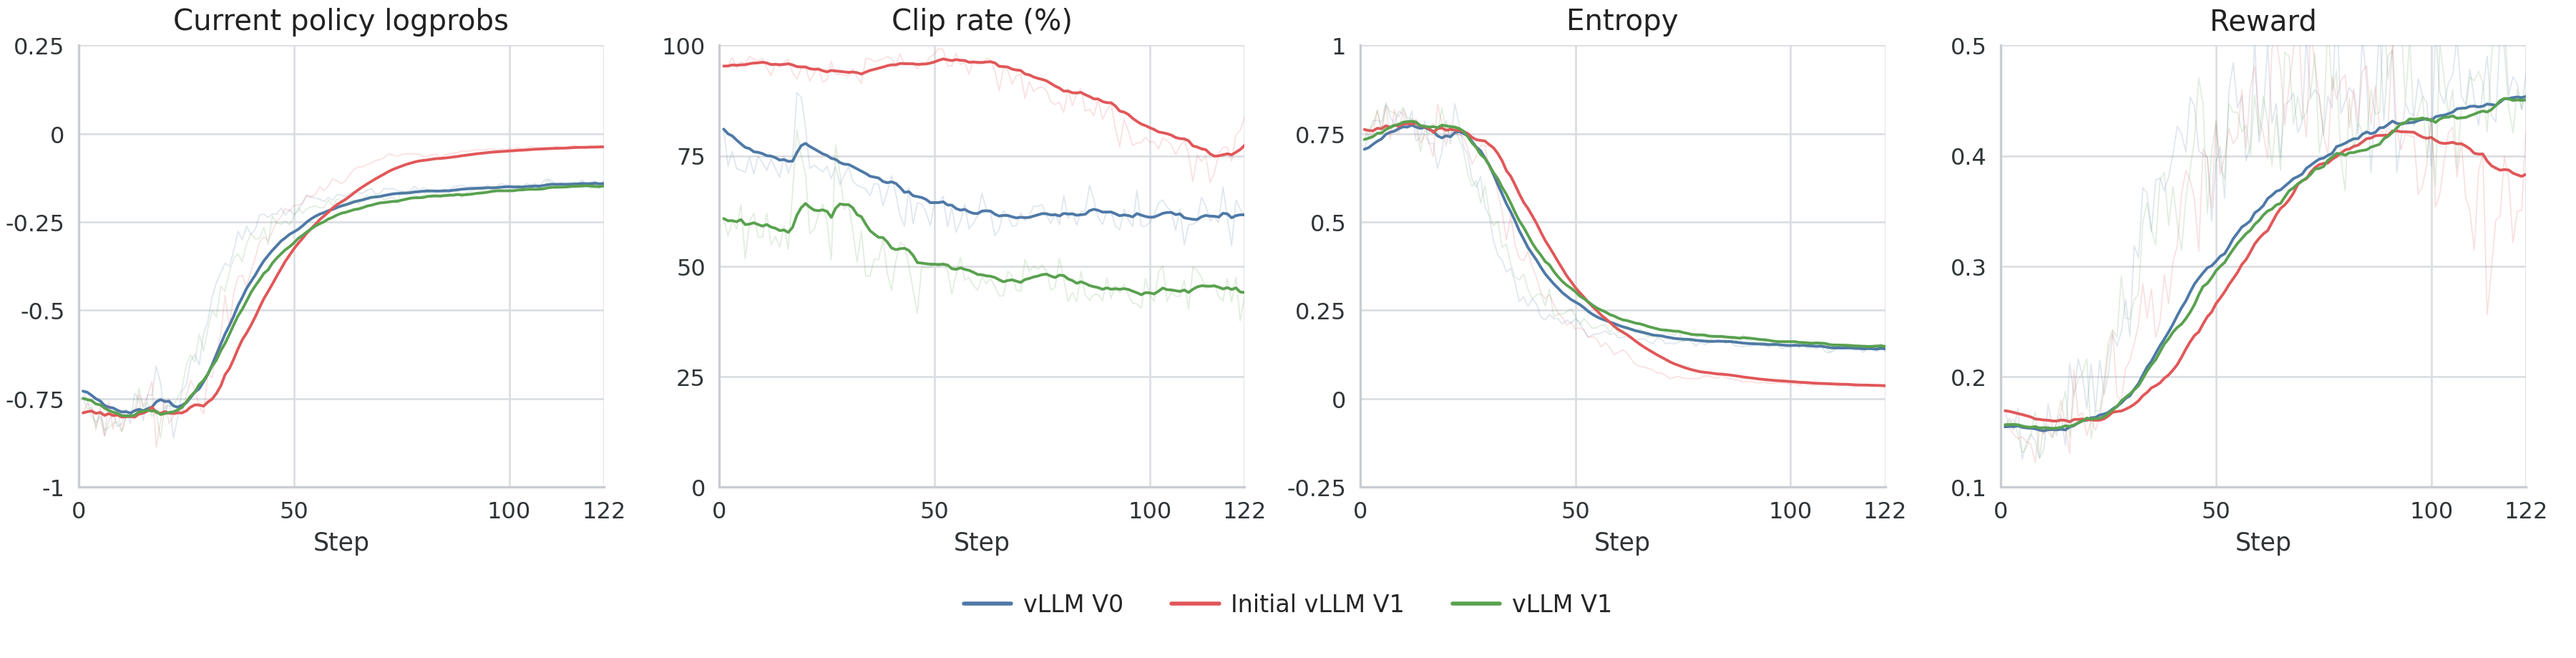
図 1. vLLM V0 参照版(青)、最初の vLLM V1 試行(赤)、および修正後の最終 vLLM V1 ラン(緑)の、fp32 lm_head を含むトレーナー側メトリクス。最終的な V1 ランは、clip rate、KL、entropy、reward のいずれについても V0 の軌跡に近い結果となっています。
移行の目的
vLLM V1 は、V0 エンジンを大規模に書き直したものです。そのため、移行の目的は意図的にかなり狭く設定しました。
- V1 が返す rollout logprob が、トレーナーが想定する形式に合っているかを確認する
- 同じワークロードを再実行し、V0 の参照結果と比較する
- バックエンドの整合性を回復した後でのみ、目的関数レベルの変更を評価する
最初に目に見えて現れた症状は次のとおりでした。
clamp_log_ratio_new_old_indicatorkl_new_oldentropyreward
これらの指標は GSPO の学習ランから得られたもので、今回の実験で使ったのもこの目的関数です。同様の不整合は、PPO、GRPO、あるいは rollout 側の logprob を最適化対象の一部として扱う他のオンライン RL システムでも発生し得ます。
最初の V1 ランは、問題を明確に示していました。トレーナー側の logprob と reward は、学習のかなり早い段階で V0 の参照結果からずれ始めていました。
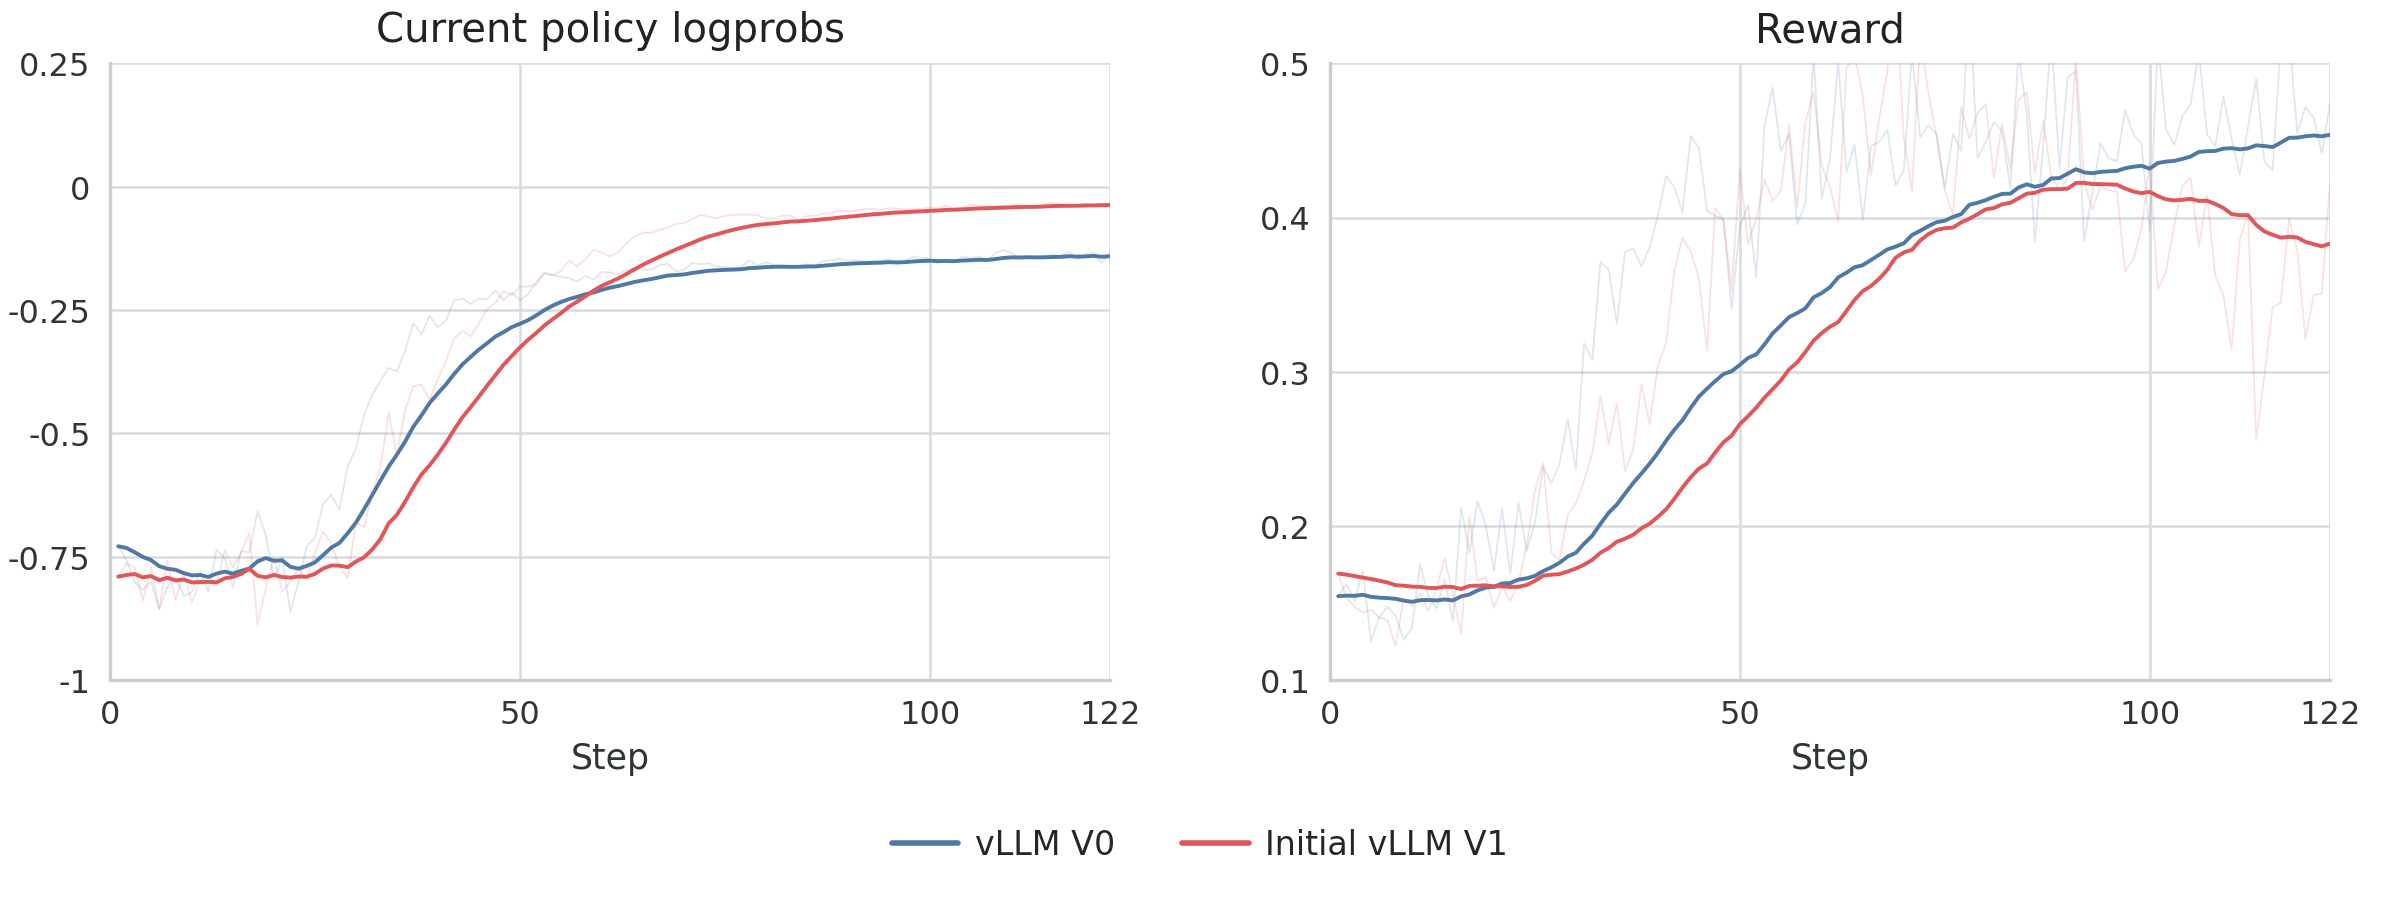
図 2. 学習の更新中にトレーナーが計算した current policy の logprob(左)と reward(右)。最初の vLLM V1 ラン(赤)は、vLLM V0 参照(青)から徐々に乖離しています。
同じパターンはトレーナー側の指標にも表れていました。最初の比較で最も見やすいシグナルが clip rate でした。
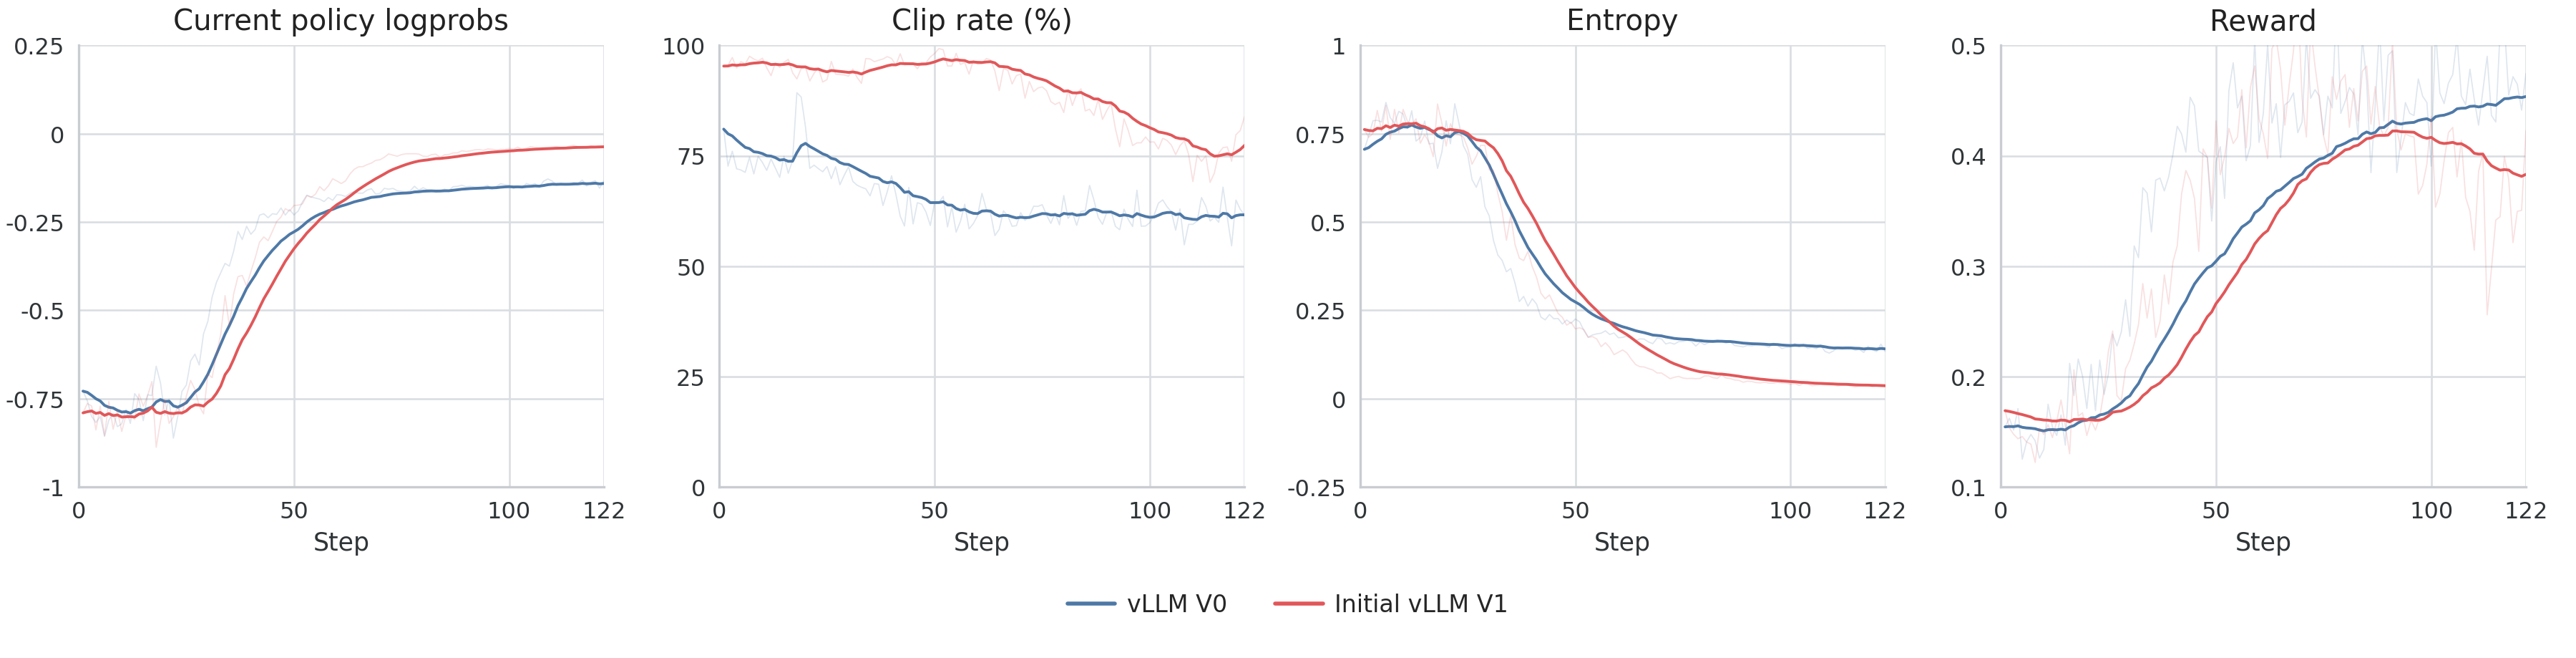
図 3. vLLM V0 参照版(青)と最初の vLLM V1 試行(赤)のトレーナー側メトリクス。clip rate は rollout とトレーナーの policy の差を反映しており、entropy と reward は、その差が学習にどう波及するかを示しています。
失敗パターン
考えられる原因は、3 つの層に分けて整理しました。
- セマンティクスの不一致: バックエンドが返す logprob の意味が、トレーナーの想定と異なっている。
- 推論パスの不一致: キャッシュ、スケジューリング、リクエスト処理に関する実行時デフォルト値が異なり、同じ prompt が別の実行経路に乗ってしまう。
- 目標の不一致: RL の目的関数自体を調整する必要がある。