
Amplitude 如何借助 OpenAI 在 1–2 天内交付产品改进
2026年11月12日
Amplitude 的主动型产品智能体(Agent)Wave 主要基于 OpenAI 模型构建,能够识别待构建的功能、帮助团队借助编程智能体交付变更,并衡量实际影响。
-
地区: 北美
-
行业: 科技
-
产品: Codex
-
公司规模: 中端市场
-
160%:一天后智能体互动率相比对照组的提升幅度
-
1–2 天:使用 Wave 交付产品改进的预计时间
-
51%:在 Amplitude 的数据科学智能体(Data Science Agent)评估中,GPT‑6.1 Sol 每次调度的平均模型成本降低幅度
-
$1.34:在 Amplitude 的机会调研器(Opportunity Investigator)评估中,GPT‑6.1 Sol 的模型成本
Amplitude 一直在帮助团队了解用户究竟如何使用他们的产品。其主动型产品智能体 Wave 则能帮助团队将这些洞察转化为实际交付的产品改进。据 Amplitude 介绍,Wave 大约 80% 的能力由 OpenAI 模型驱动,包括 GPT‑6.1 Sol、GPT‑6 Luna 和 GPT‑Image‑2.5 Flare。Wave 会将产品洞察转化为实施计划,供团队交付给包括 Codex 在内的编程智能体执行,并随后衡量其影响。
Amplitude 估计,Wave 可以帮助团队将交付产品改进的时间从大约一个月缩短至 1–2 天。在 Amplitude 自己的主页上,Wave 帮助实现了建议卡片的个性化,使通过卡片触发的消息发送量提升了 160%。
“AI 现在可以发现那些我们从未想到要分配给它的有价值的工作。OpenAI 的模型能够调查问题、编写并运行代码,并根据结果决定下一步尝试什么。”
——Spenser Skates,Amplitude 首席执行官
从产品数据到交付改进
Wave 是 Amplitude 的主动型产品智能体。团队只需为它指定一个产品领域以及希望改进的目标和指标。Wave 就会整合 Amplitude 数据、会话回放(Session Replays)、客户反馈和代码,以识别机会并划分优先级、制定解决方案,并协调人员和编程智能体进行实施。随后,它会跟踪结果,并利用这些经验为下一轮改进提供参考。
在该工作流的背后,Amplitude 针对不同任务使用了不同的 OpenAI 模型。GPT‑6.1 Sol 为机会管理器以及针对代码和数据的深度调研提供支持。GPT‑6 Luna 处理高频、低成本的任务,例如扫描代码和运行小型评估检查。GPT‑Image‑2.5 Flare 则使用会话回放中的截图作为视觉参考,生成产品原型图(Mockups)。
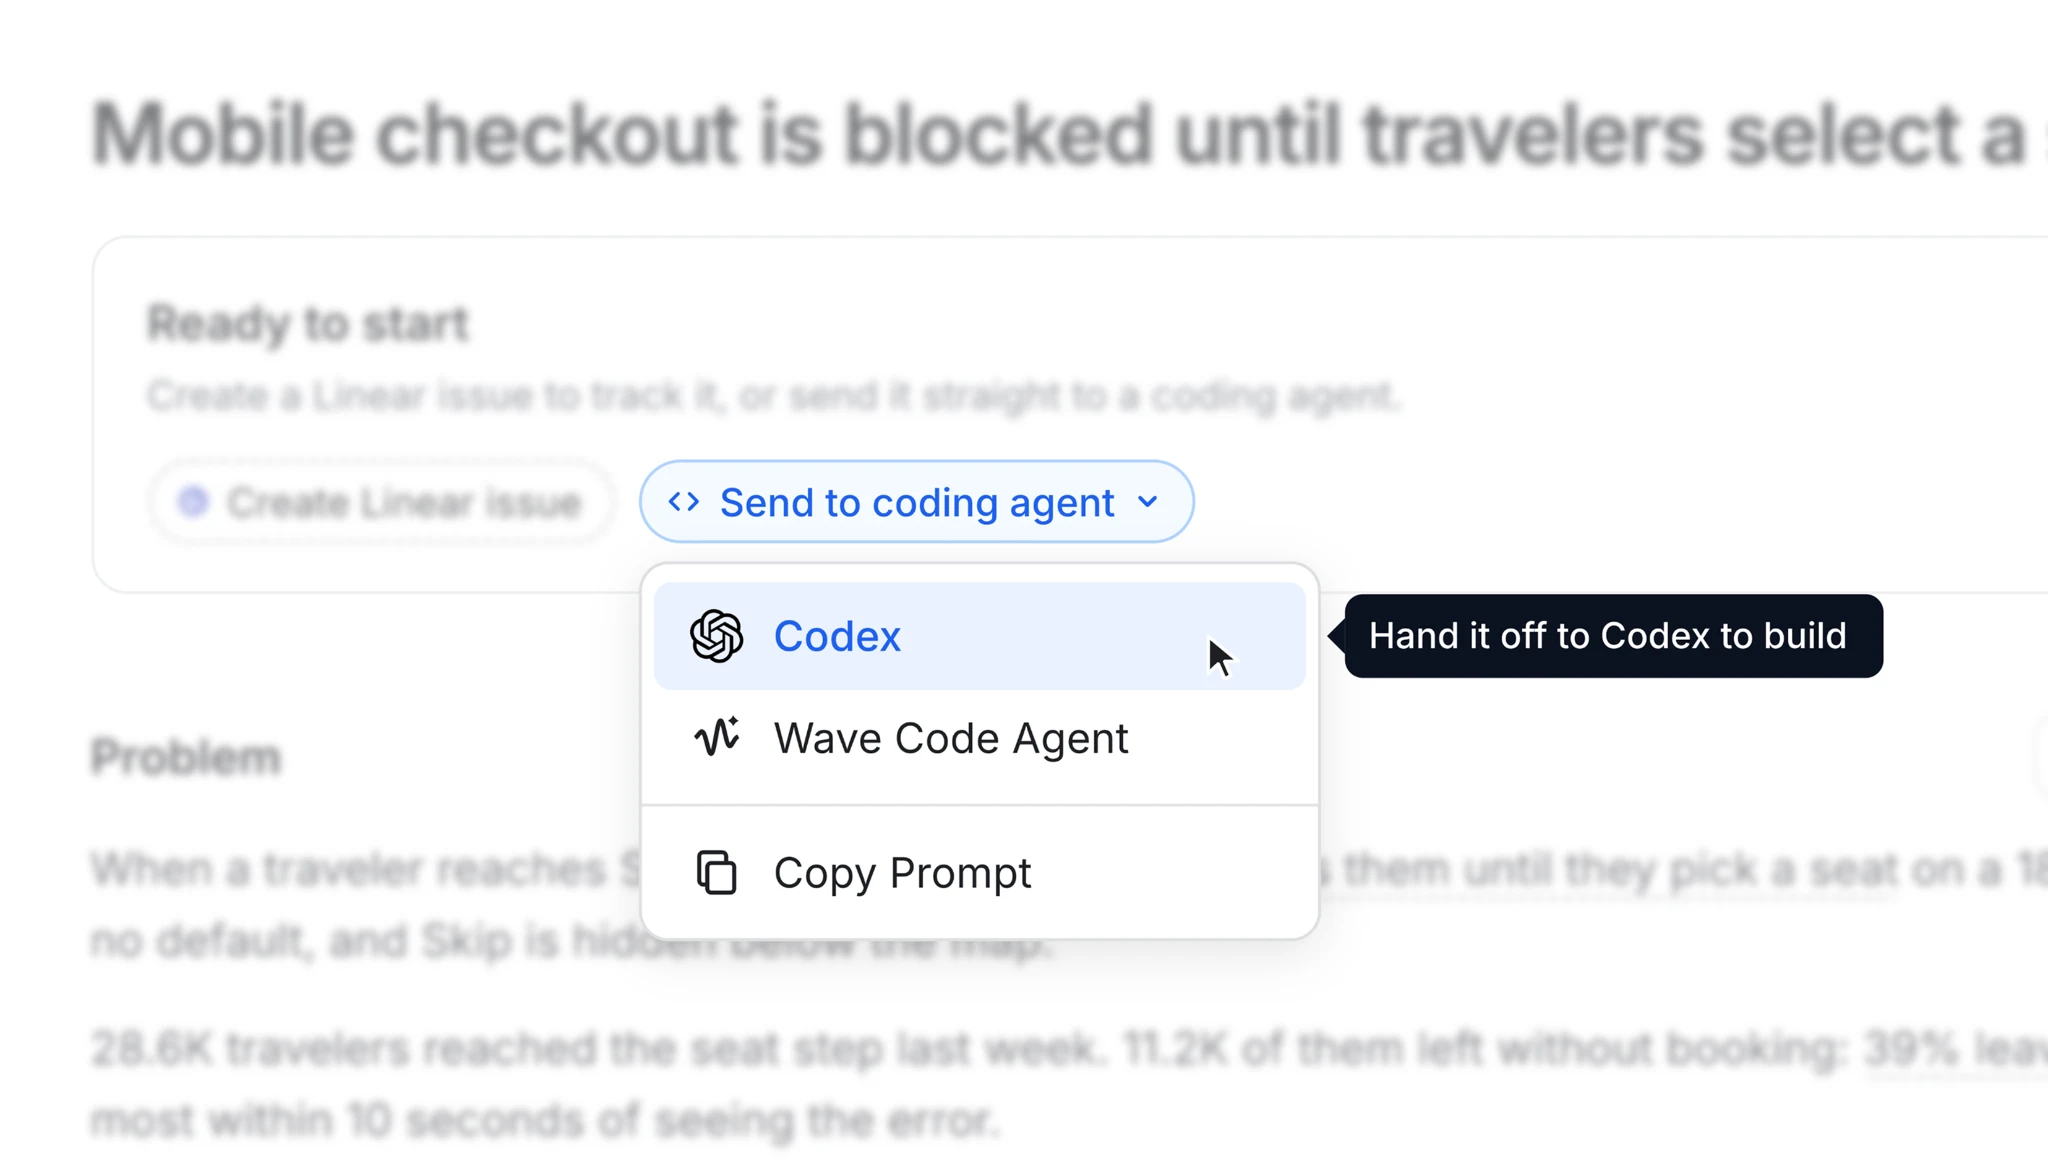
当某个改进机会准备好构建时,团队可以将其直接从 Wave 发送给包括 Codex 在内的编程智能体,并附上技术计划和验收标准以指导实施。
Wave 如何推动智能体互动率提升 160%
Amplitude 首席 AI 产品经理 Jacob Newman 解释道:“Wave 的理念是提供一个统一的平台,让智能体梳理海量的会话回放、分析数据和代码,从中寻找改进产品的机会。”
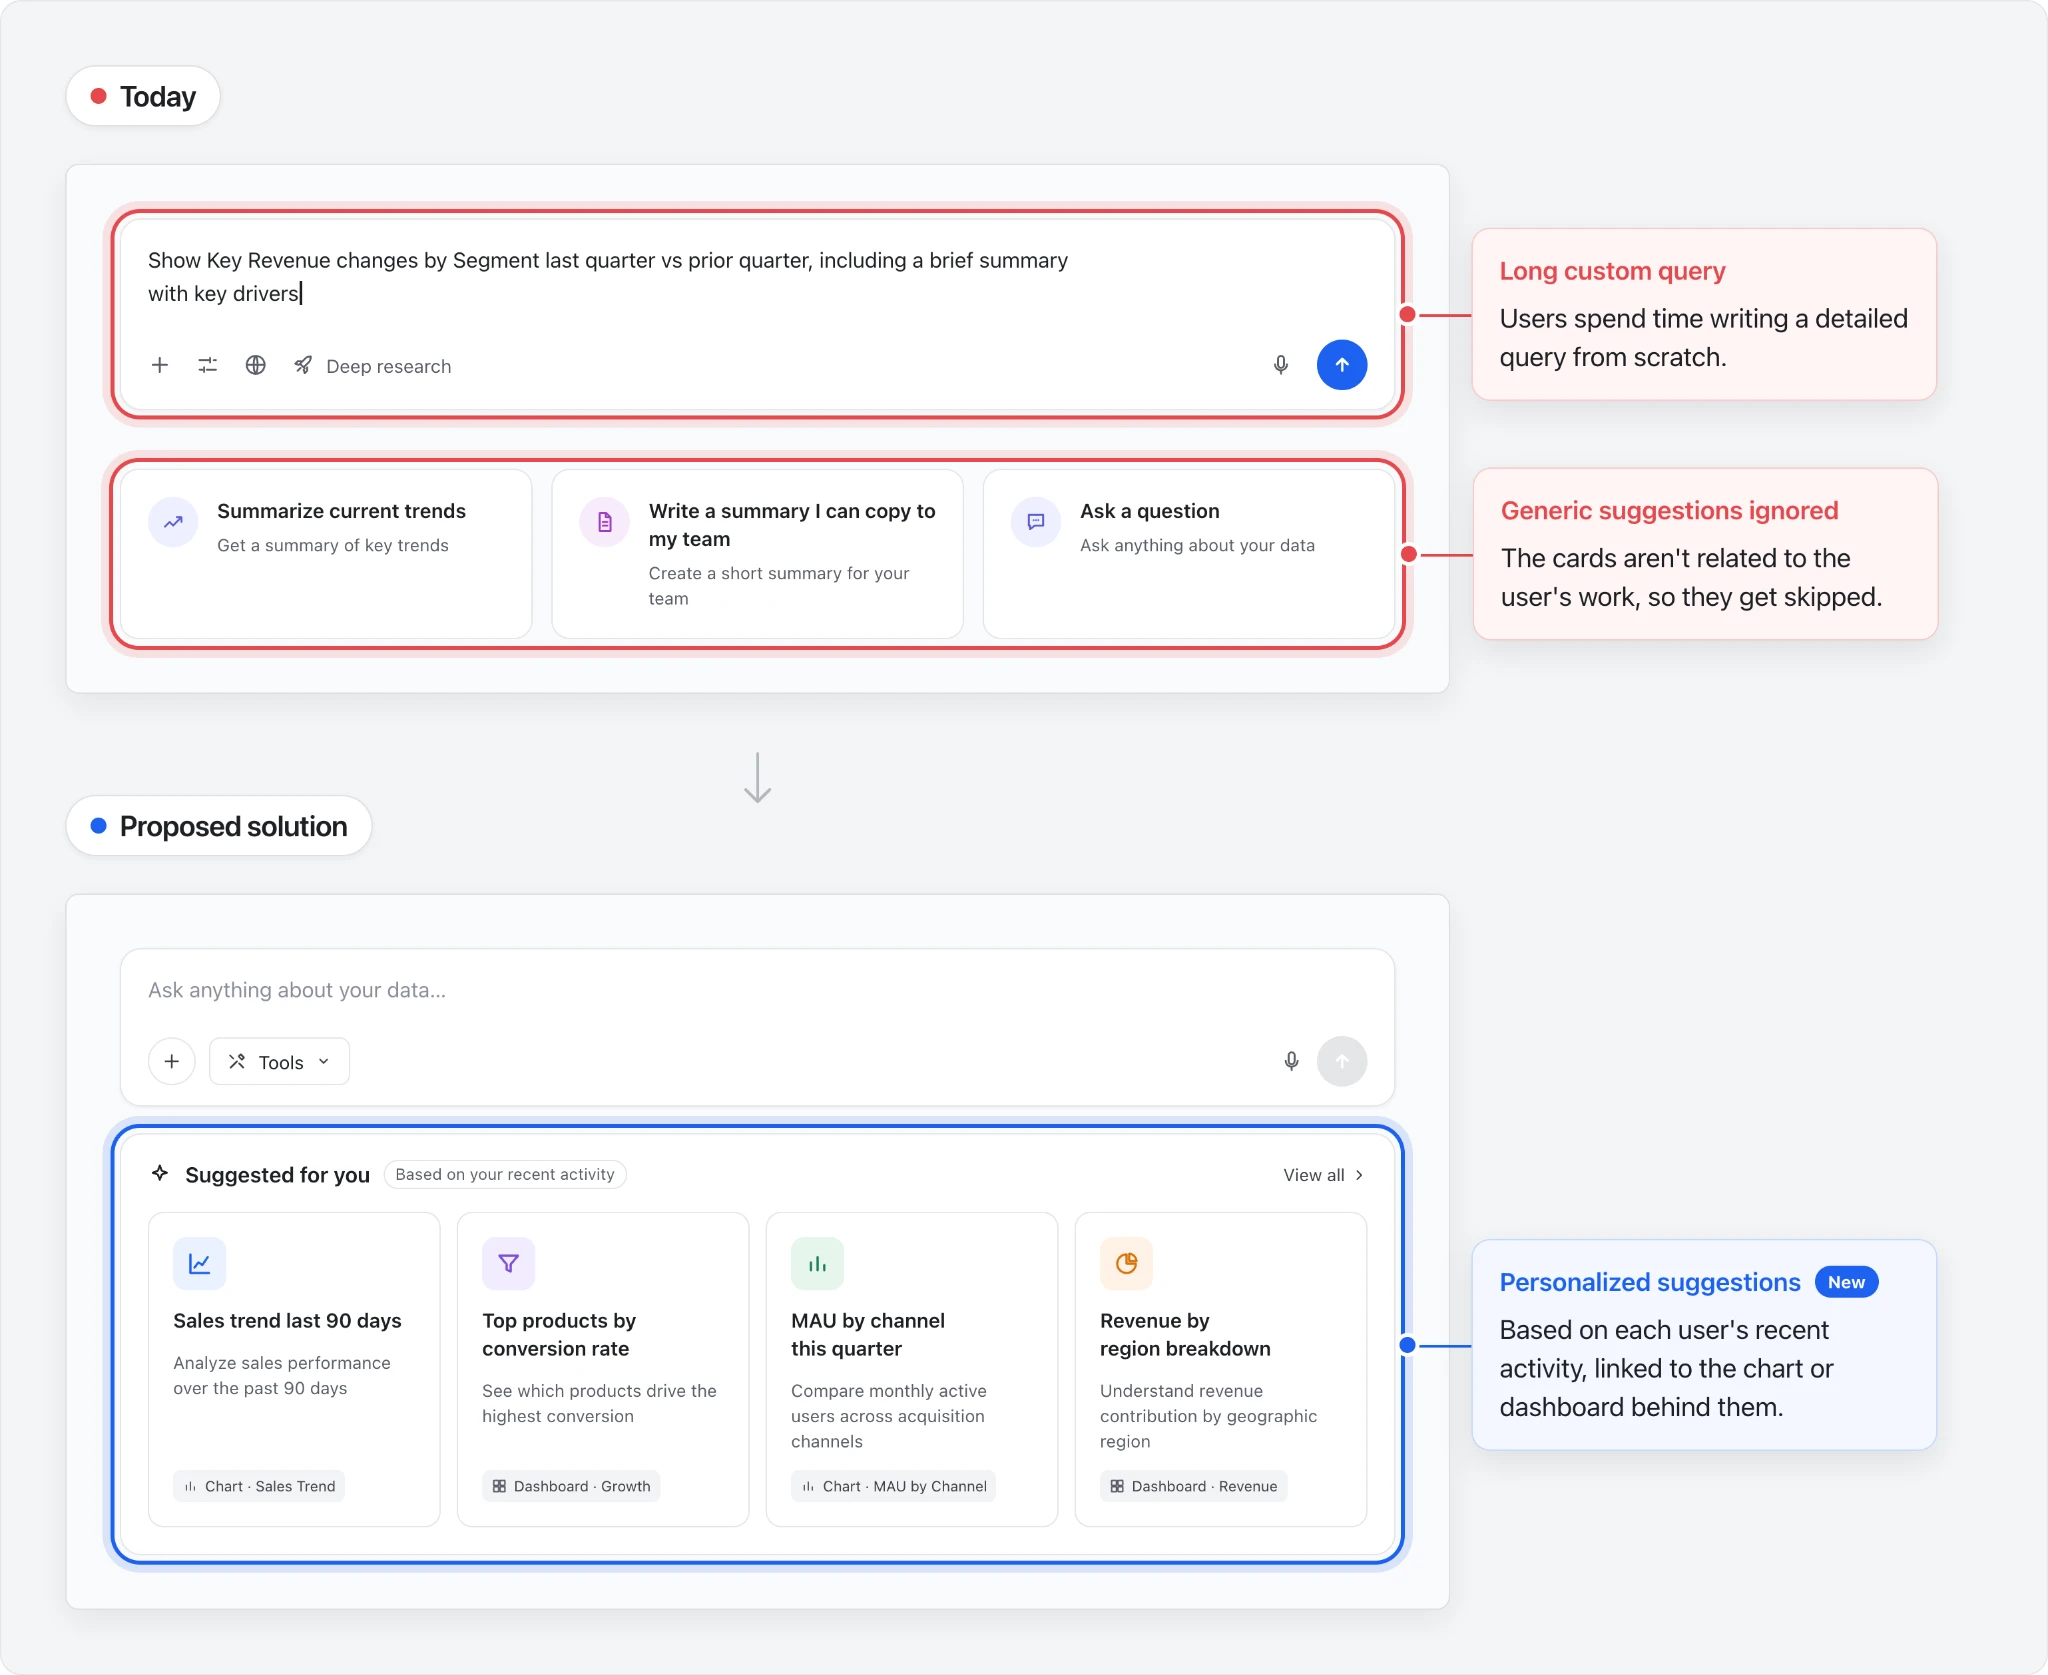
Amplitude 在自己的主页上测试了 Wave。主页上原本设有通用的建议卡片,旨在帮助用户开启与 AI 智能体的对话。Wave 发现人们经常忽略这些卡片:在 100 个会话回放样本中,有 80 名用户自己输入了问题,只有 12 人选择了建议卡片。
Wave 提议根据用户最近查看的图表、仪表盘或来源页面对卡片进行个性化设置。它展示了变更后的效果并生成了一份技术计划,其中包括保留自由输入功能,以及在缺乏个性化上下文时显示通用建议。经过简短审核后,团队将工作交给了编程智能体,并对这一变更进行了 A/B 测试。
在 Amplitude 分享的实验结果中,上线一天后,通过主页建议卡片发送的消息量相比对照组增加了 160%。Amplitude 高级首席 AI 工程师 Eric Carlson 解释说:“这是一个绝佳的例子,说明那些平时容易被忽视、算不上颠覆性的小细节,也能以意想不到的方式提高功能的采用率。”
为每项任务选择合适的 OpenAI 模型
Wave 的各项任务对模型提出了不同的要求。深度调研需要强大的推理能力和有理有据的结论;而重复数百次的小型检查则需要快速且低成本。Amplitude 会评估每项任务对质量、延迟和成本的要求,然后据此分配模型。
“OpenAI 为我们同时提供了强大的推理模型和更小、更快的模型,使我们能够在整个产品中平衡质量、延迟和推理成本。”
——Spenser Skates,Amplitude 首席执行官
对于 Wave 的机会调研器(Opportunity Investigator),Amplitude 评估了模型是否能够证实发现、避免误报(False Positives)、吸收评估器反馈、从工具故障中恢复,并保持结论与证据一致。GPT‑6.1 Sol 在满分 5 分中获得了 4.06 分。