
坏了,真让 MiniMax 把多模态给玩明白了😭。
继开源视频旗舰 H3 广受好评后,最新的图像模型——H3-Image,再次席卷全网。
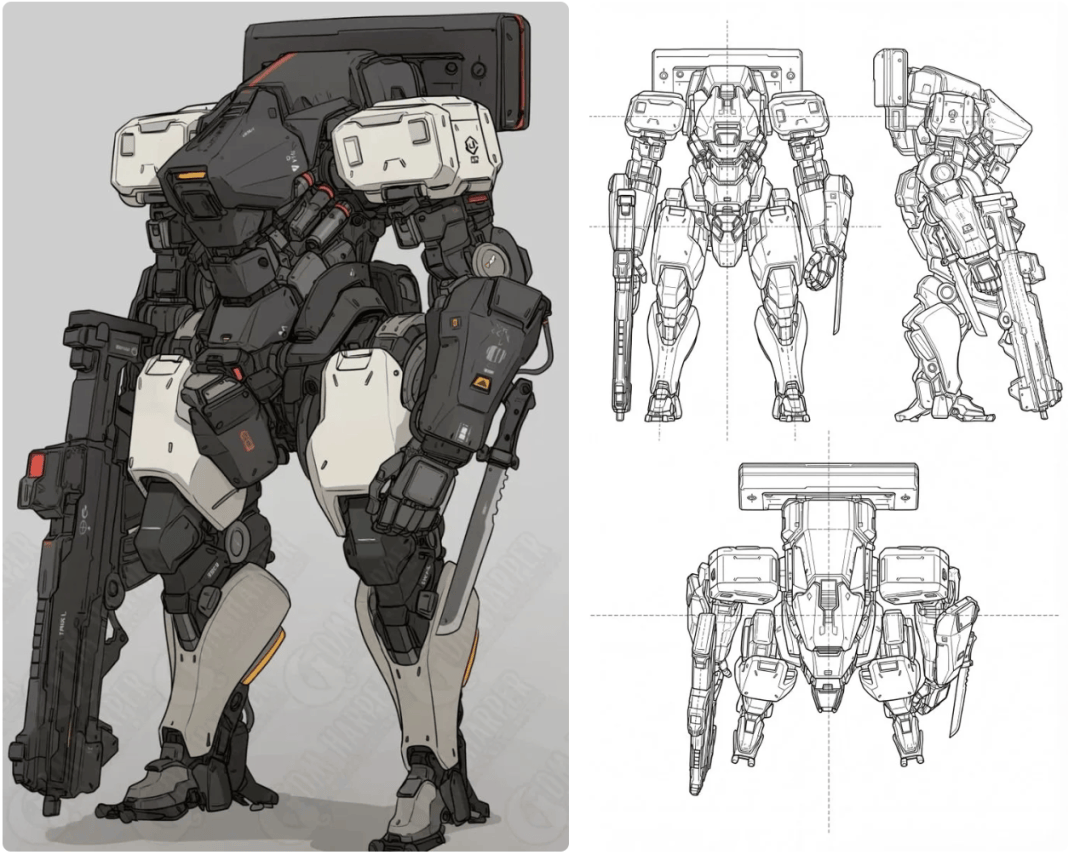
热度最高的是「CAD 拆解」:丢一张参考图,H3-Image 能直接把你的小手办给“开盒”了……
还有给宇树机器狗做 CAD 拆解的。
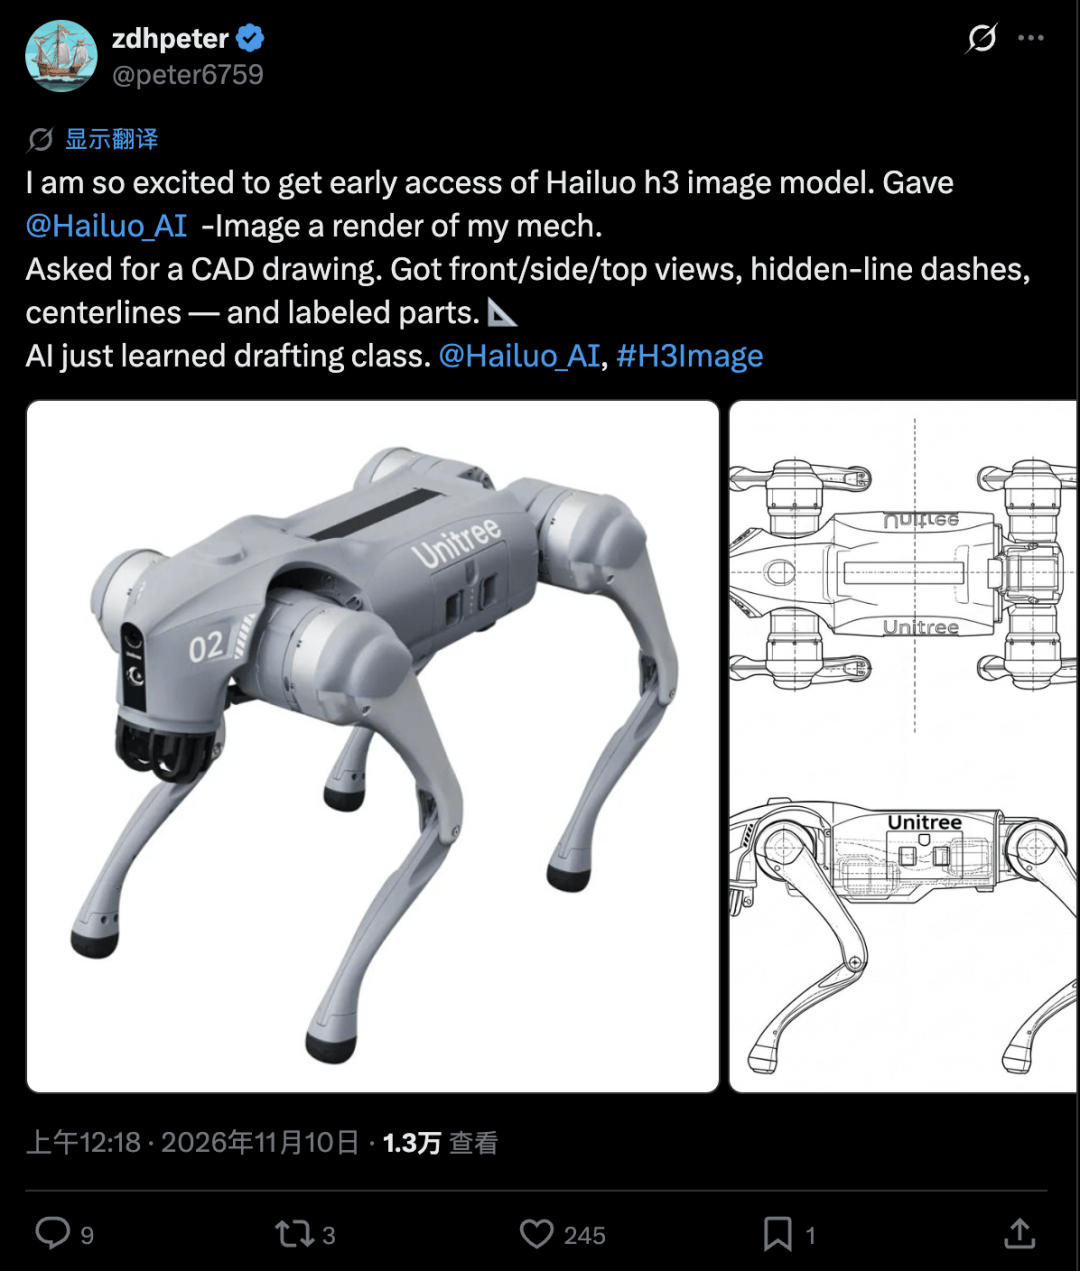
总之就是万物皆可拆解,还能把零件一一标好。
我自己也实测了一下,你还别说,真有点东西啊……
除此之外,从海外网友的实测来看,其他类型的复杂生图任务它也能轻松 Handle 住,比如——游戏。
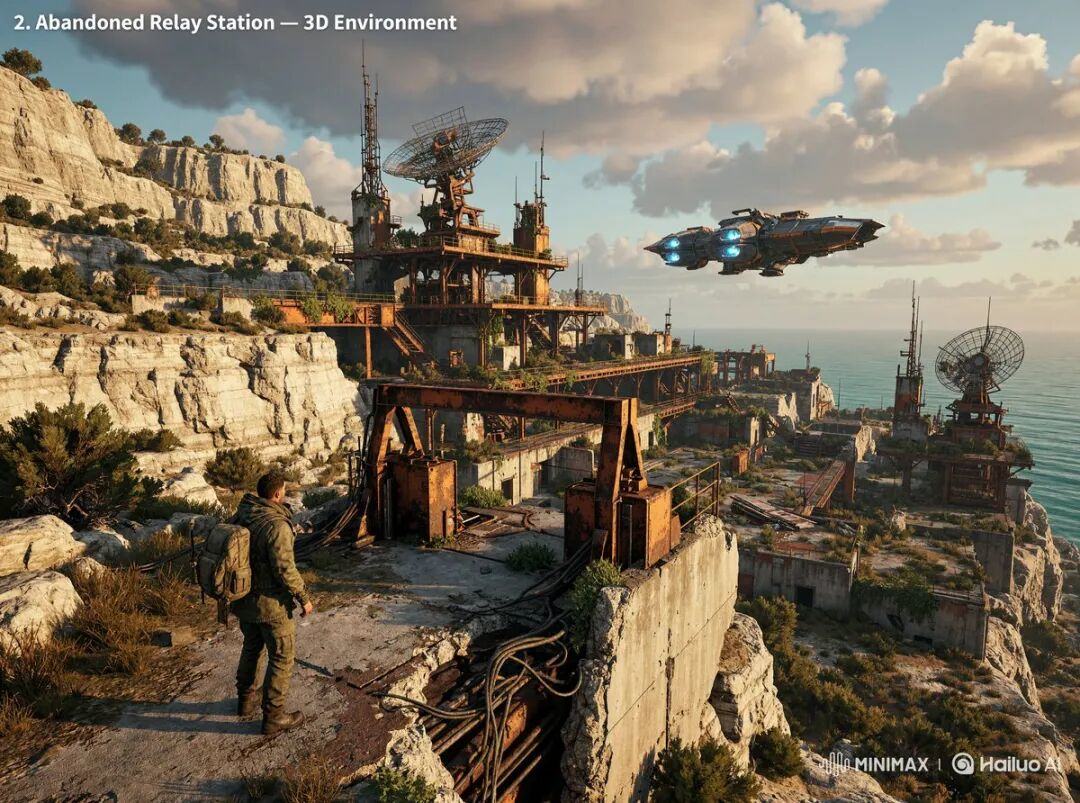
这这这,你要不说,我还以为是用 GPT 编程做出来的呢😭。
如果只是做点电商用的简单资产,那就更轻松了。
但我没想到的是,这家伙居然还是个“文理双全”?
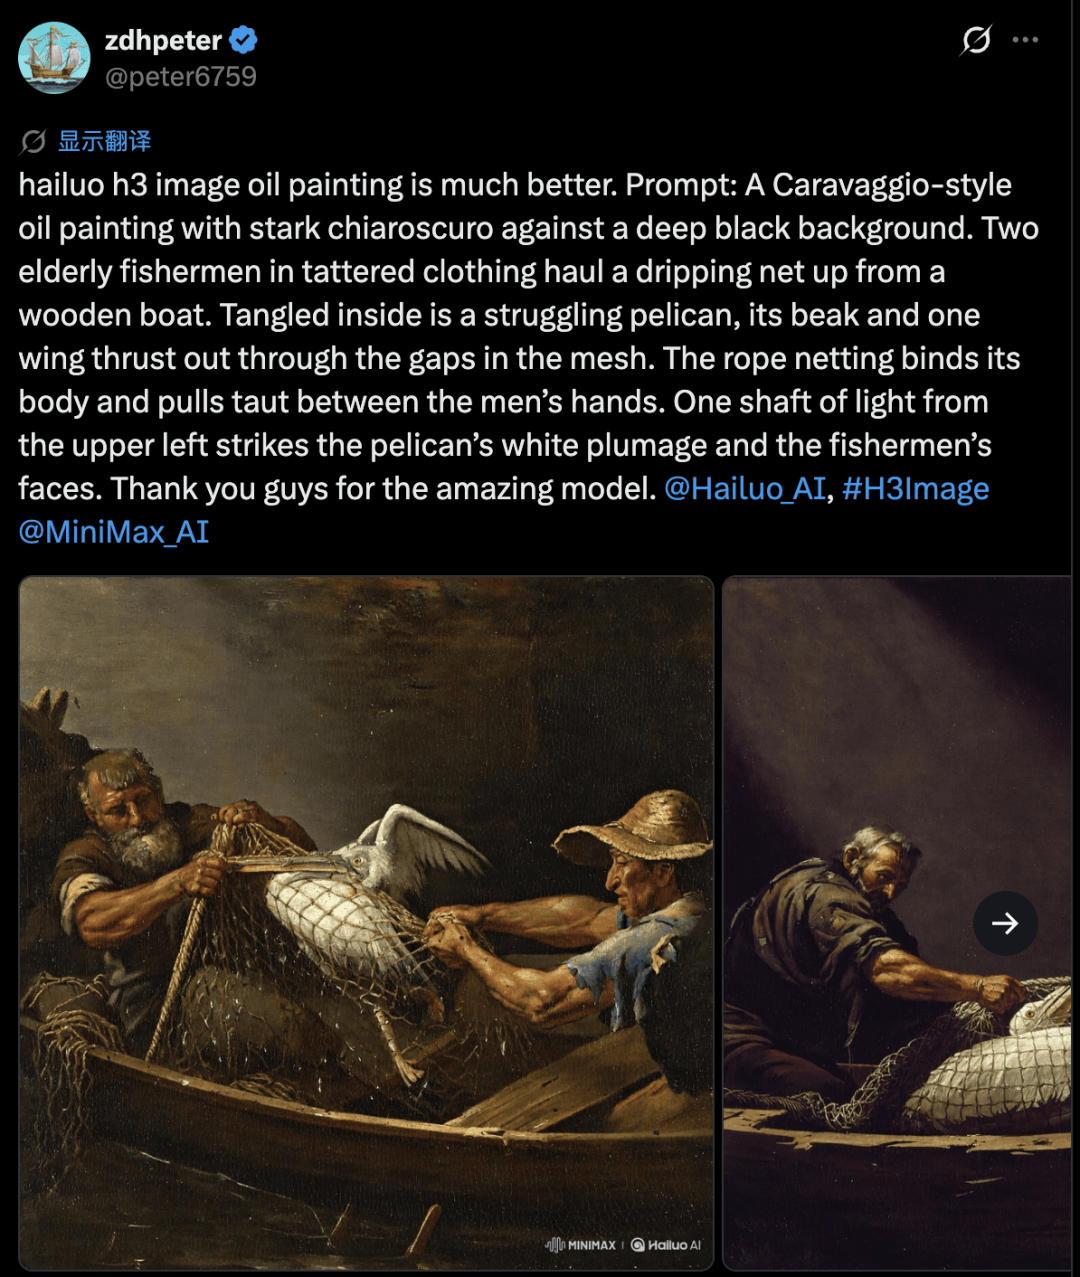
在保证智商在线的前提下,H3-Image 的审美也有点东西。
对了,还有件事。
这种质量的图像生成模型,你跟我说居然是开源的???
那还说啥了。
我宣布,MiniMax 就是多模态领域的「源神」(bushi)。
告别塑料「美商」
过去我们一提到 AI 生图,脑子里的第一反应就是:油光满面,皮肤光滑得像剥了壳的鸡蛋,眼神呆滞,伪人感极重。
总之就是一股浓浓的「AI 味」。
GPT Image 2 在这方面进步非常大,但用多了之后,恐怖谷效应依然会涌上心头。
而这次的 H3-Image,我感觉应该基本解决这个问题了。
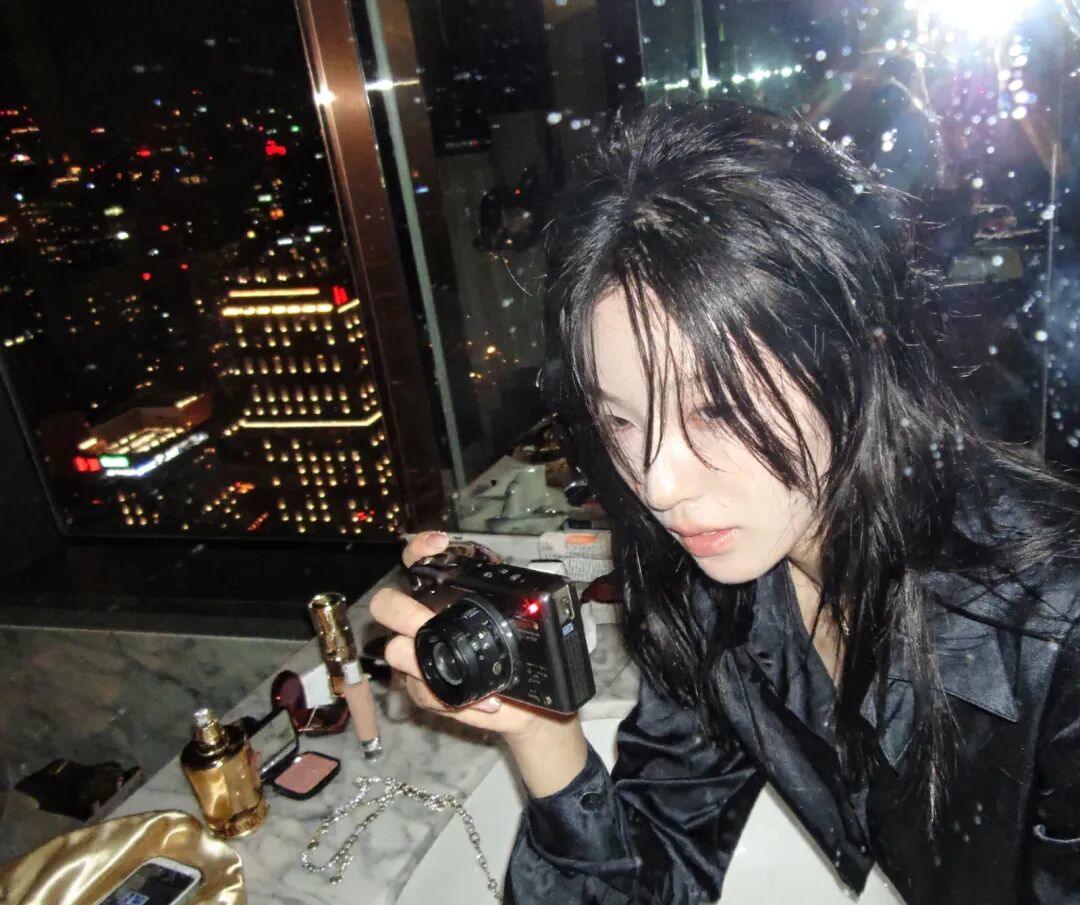
生成完我都懵了:不是,兄弟,这谁看得出来是 AI 啊??
最重要的是人脸,毛孔、雀斑,甚至连面部绒毛都给你画出来了。
此外,像镜子上的水渍和灰尘、闪光灯打在镜头上形成的光晕,这些细节也处理得非常逼真,真就跟在小红书首页刷到的照片一样。
即便从仰视角度看,也能展现出不少面部细节。比如下面这张桌面即 Ins 照片的时尚杂志封面,你仔细看人物的眼神和微妙的面部肌肉牵引,都非常符合现实中的社交逻辑。
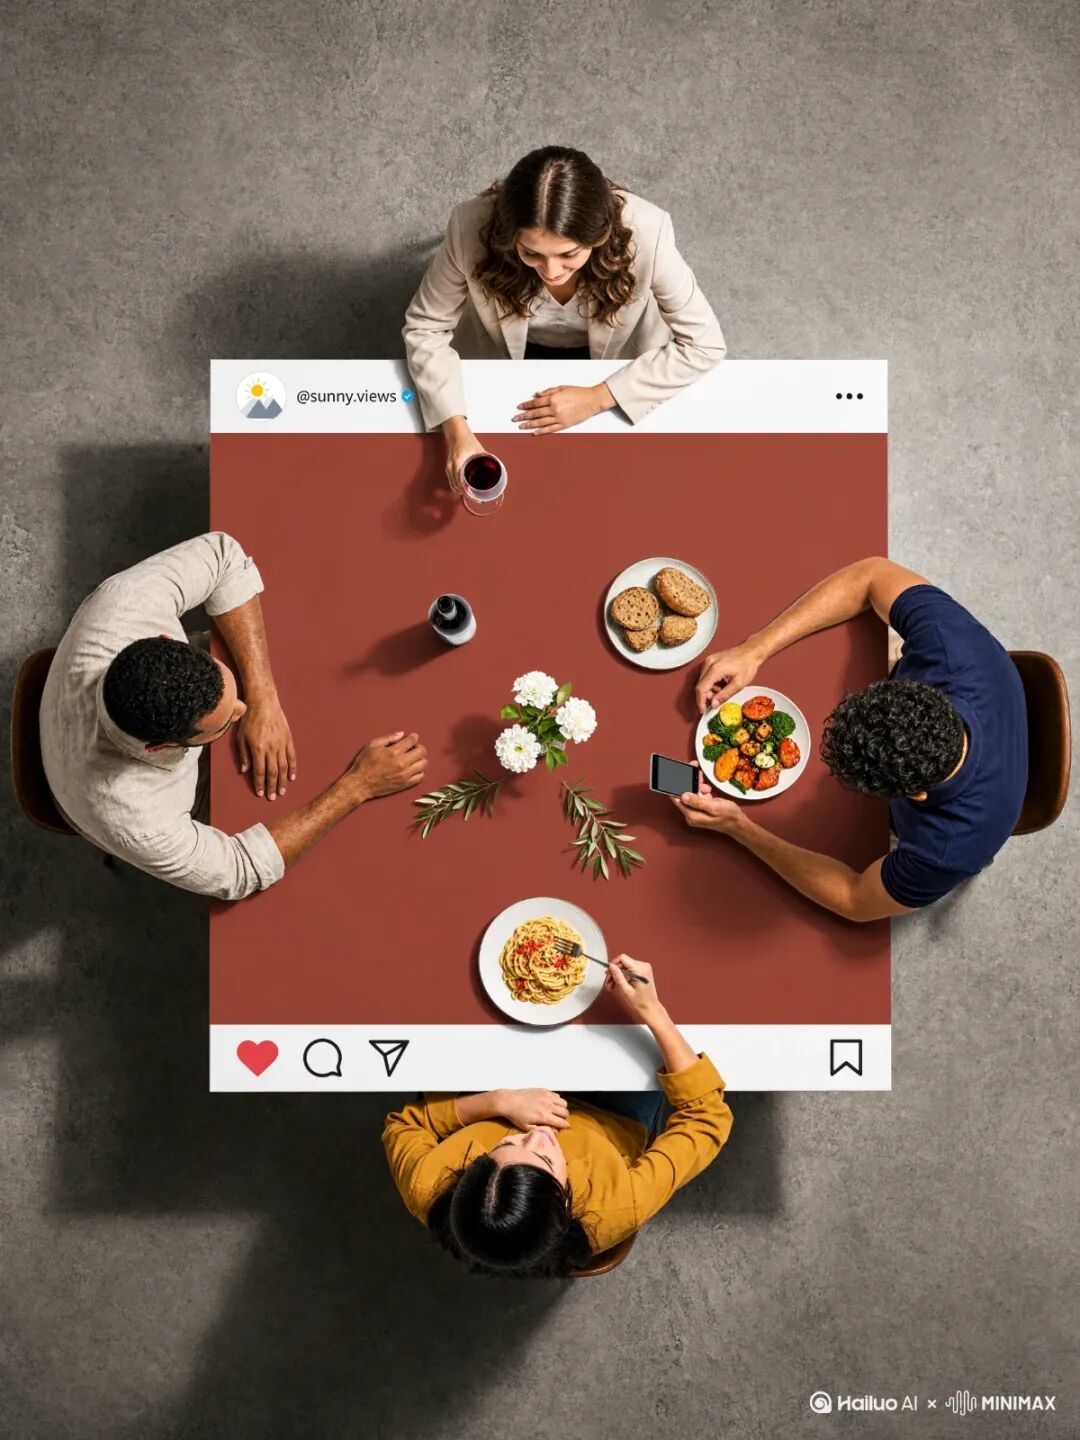
这也是我实测 H3-Image 时最大的一个感受:很多以前丢给老模型跑过的提示词,H3-Image 都能给出全新的诠释。
它的世界知识确实比较丰富。
至于人脸之外的主体,就更是手拿把掐了。
比如,把里约热内卢的城市地标做成一个立体纸雕风格的旅行手帐。
这微缩景观和光影厚度,总感觉有股 Fable 5 宣传片的味道。
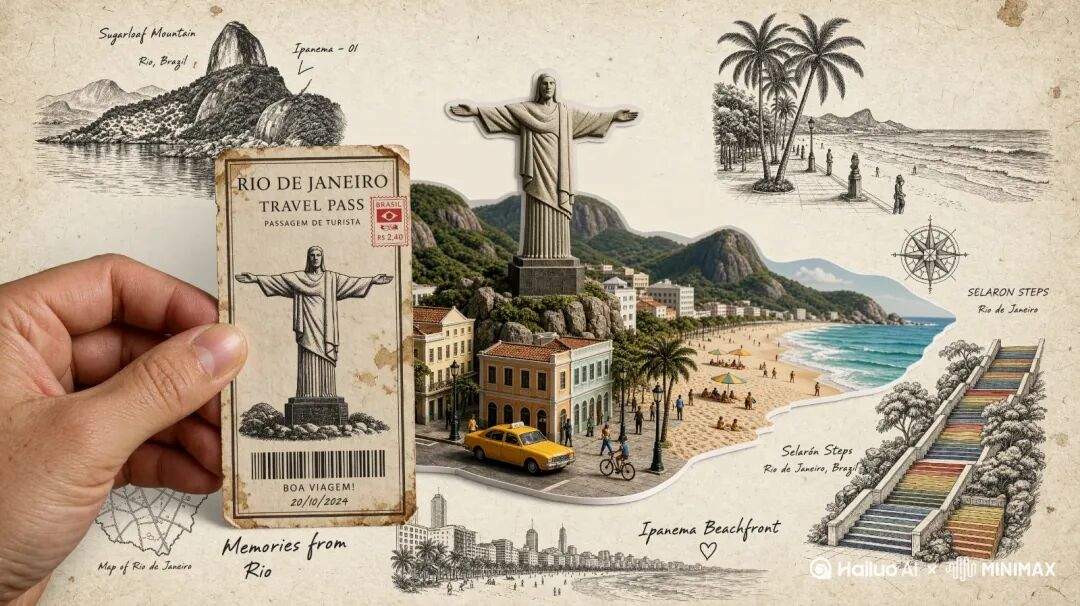
而且细节处理得极为惊人!
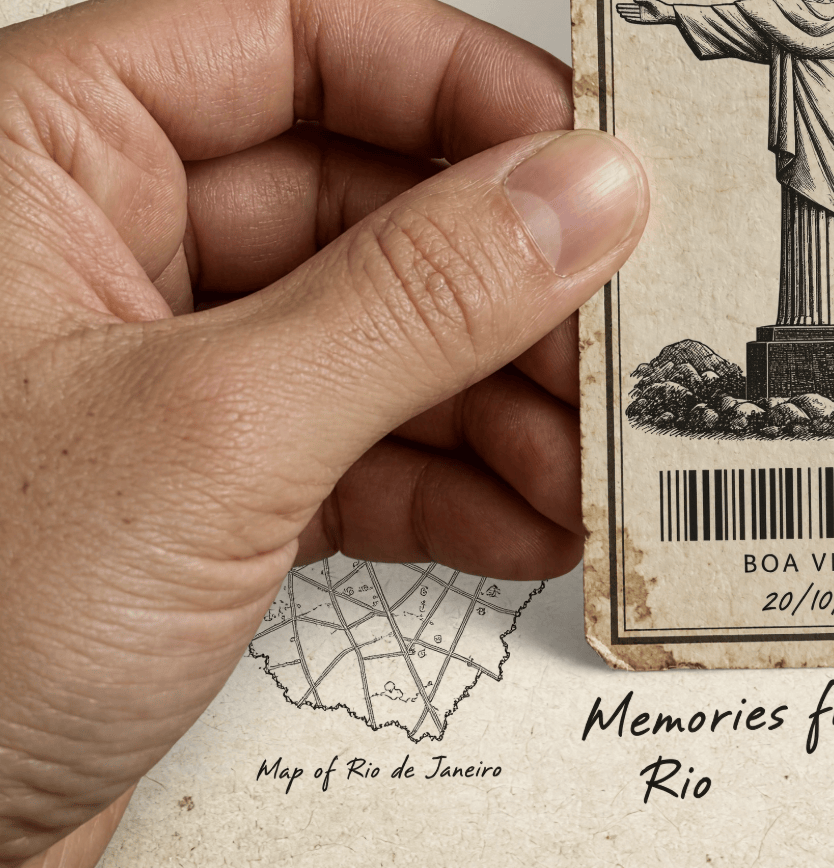
你看左下角这只手,看到没,它居然给大拇指关节附近加了几颗痣!!
放大看根本不会露馅,手指上的皮肤纹理、关节褶皱,甚至指甲边缘的自然光泽与质感,都还原得一清二楚。
有意思。
我觉得,H3-Image 之所以 AI 味这么少,很大程度上就归功于这些刻意为之的「瑕疵」。
任何人类主观创造的作品,必然充斥着随机性;过分追求完美,反而不符合人类大脑接收信息的习惯。
但这也不禁让我有点发怵。
我一直固执地以为,审美不是机器能学会的东西。
现在看来,似乎只要能摸清其中的 Trick,很多人类引以为傲的特质,可能真的没那么神秘……
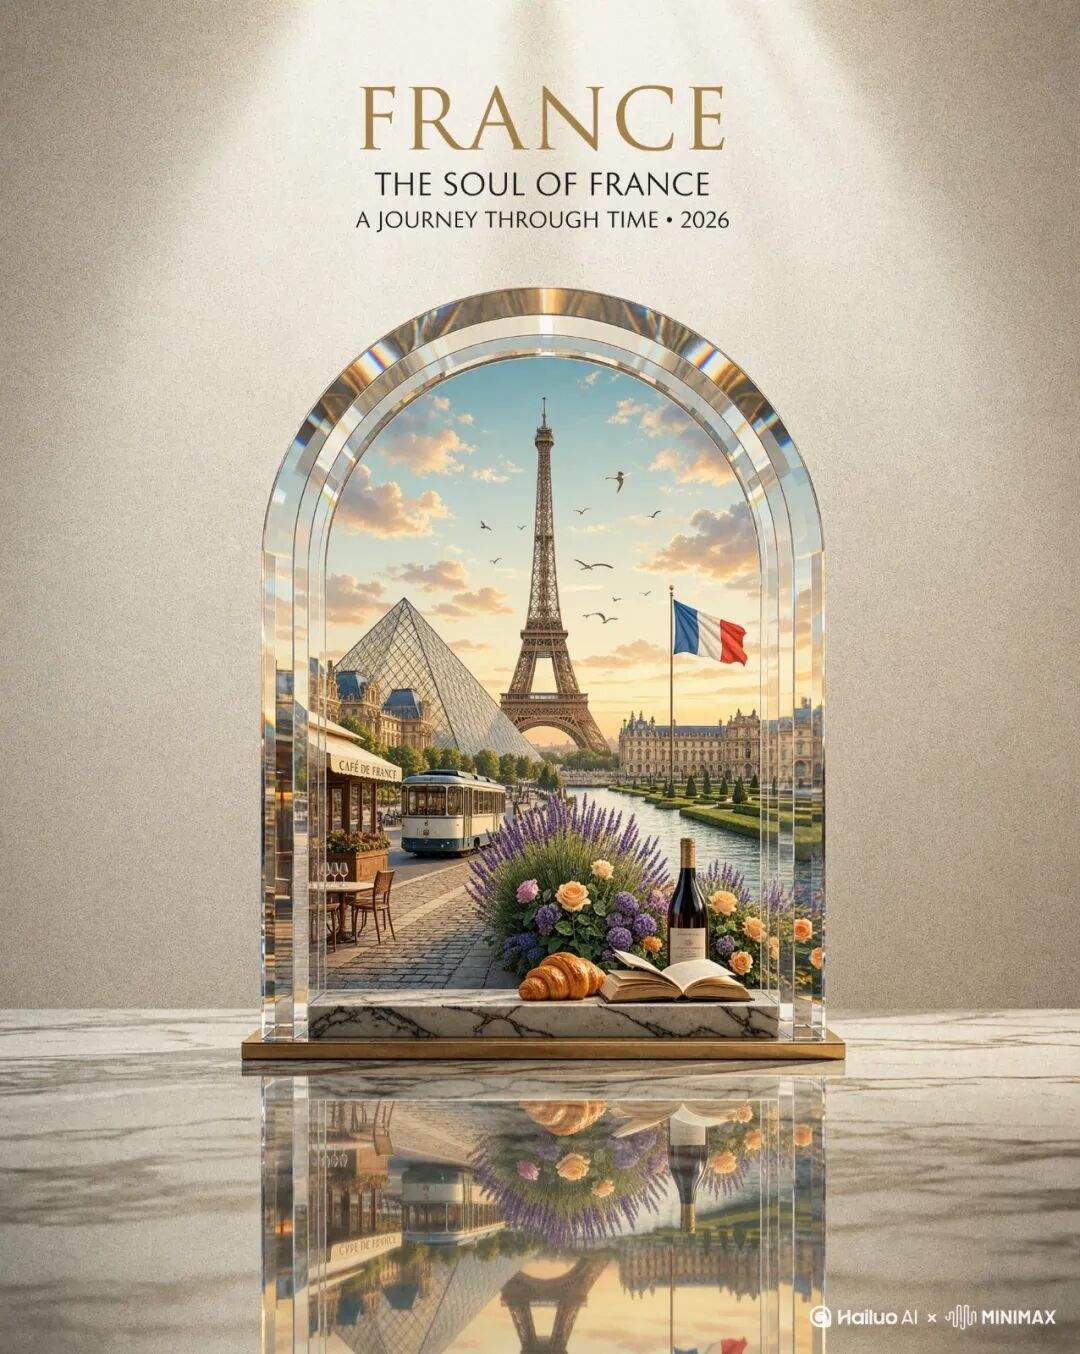
再给大家看个 Demo 吧,我拿 H3-Image 搓了一张法国旅游海报。
咋说呢,我真不太好意思评价,鄙人的艺术素养已经完全看不出门道了。
唉。
SOTA 级智力
还是整点我自己能搞明白的任务吧。
就多模态模型而言,我一直有两个评判标准——美商和智商。
美商就是上面测的这些,比较玄乎,只能聊聊主观感受。
但智商就可以好好说道说道了。
比如,H3-Image 就有一项非常特殊的技能点——世界理解能力。
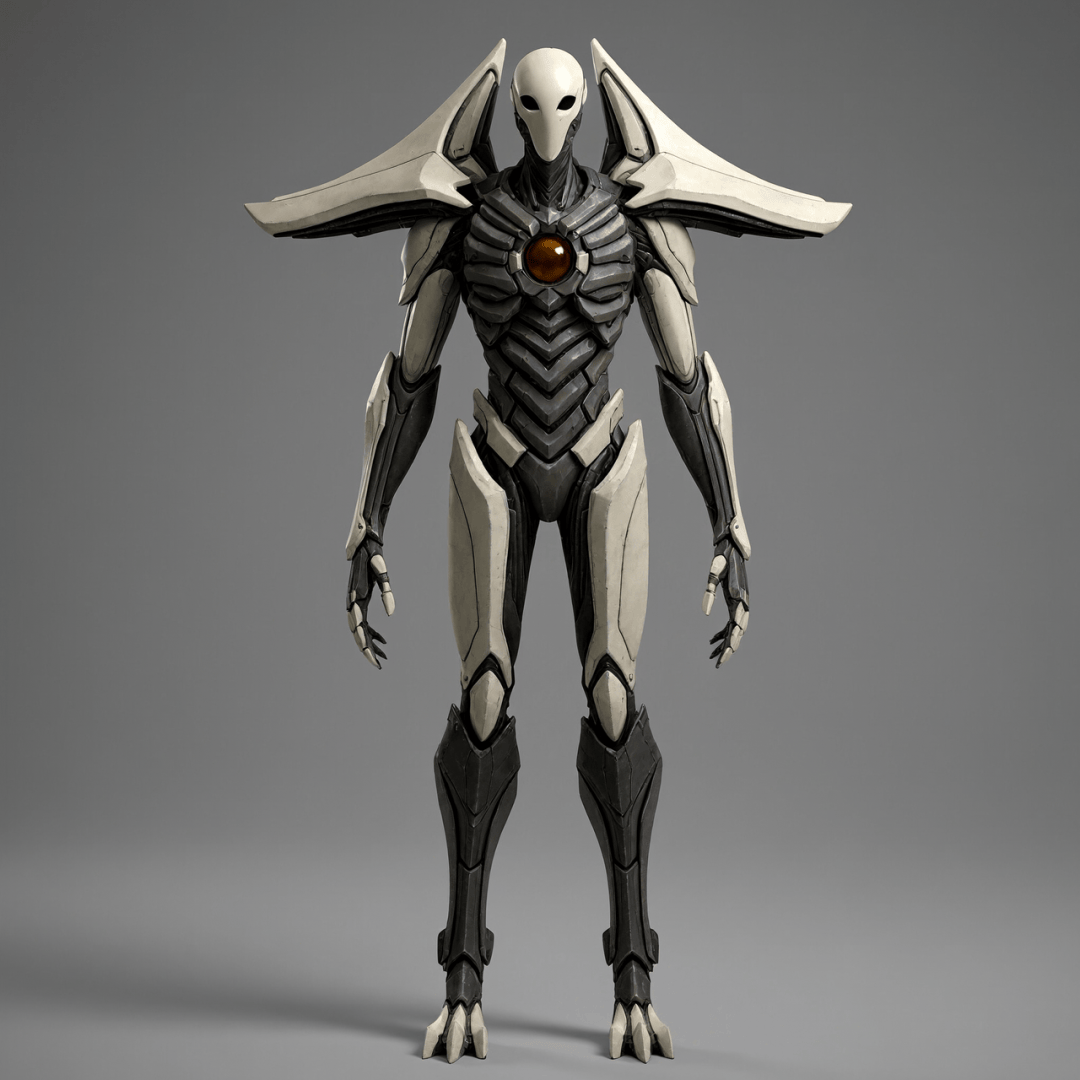
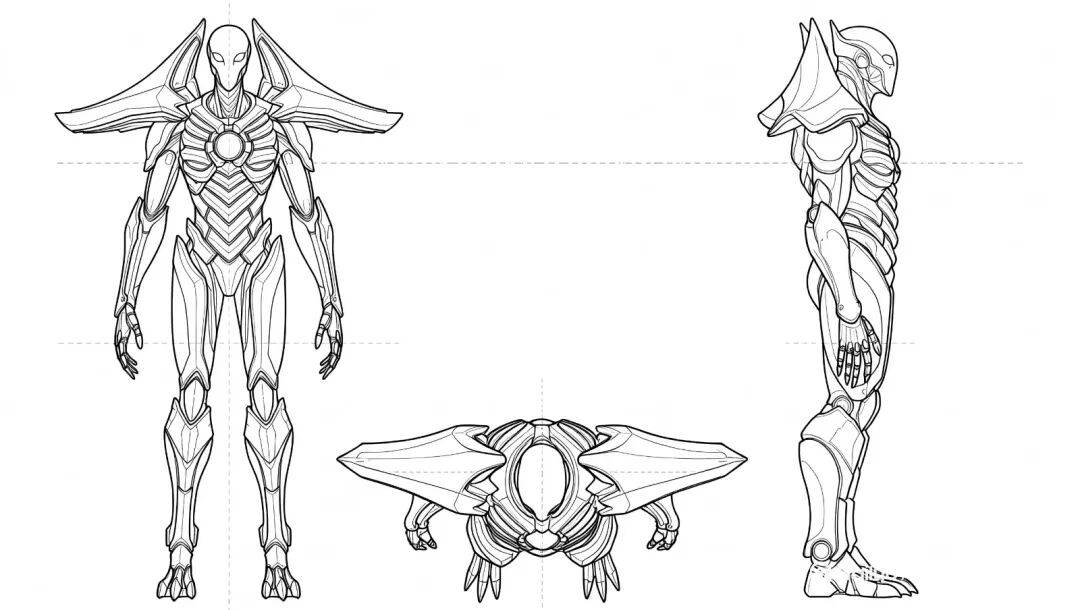
你可以拿它直接生成 CAD 图纸。
是的,只要给它一张产品的外观图,它就能自动推演出标准的正交三视图——
正视图、侧视图、俯视图,一个不差。
家人们,我惊呆了😭😭。
这还不算完。
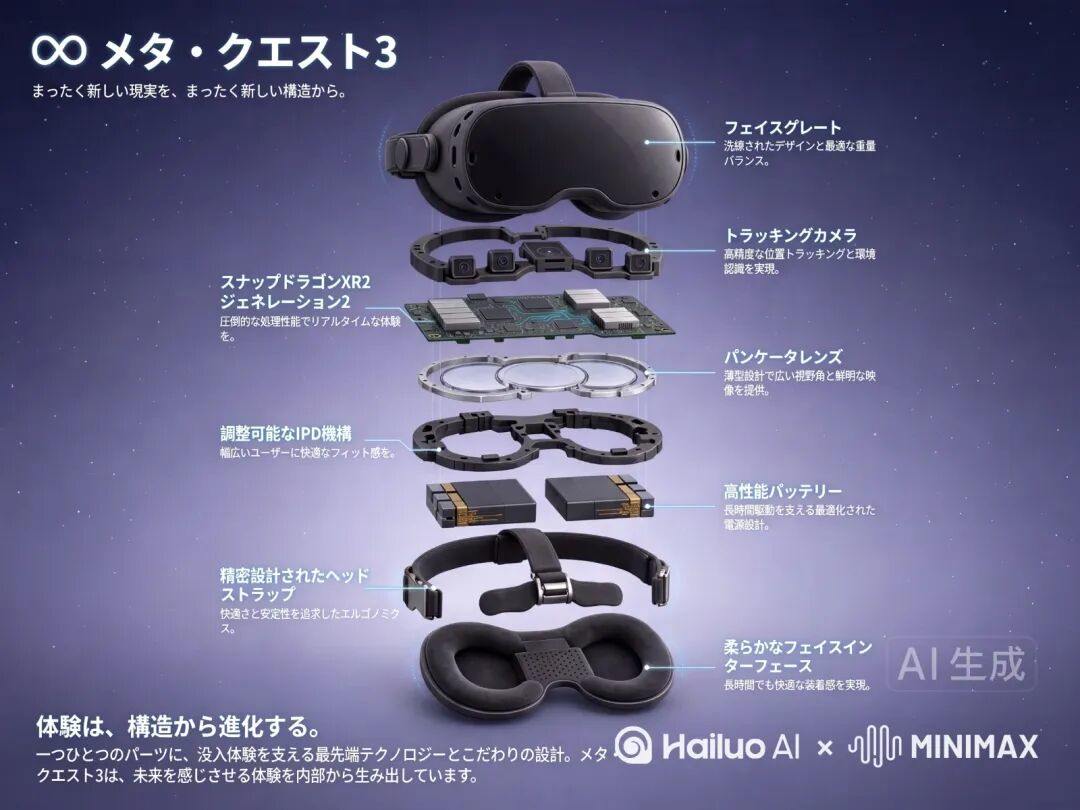
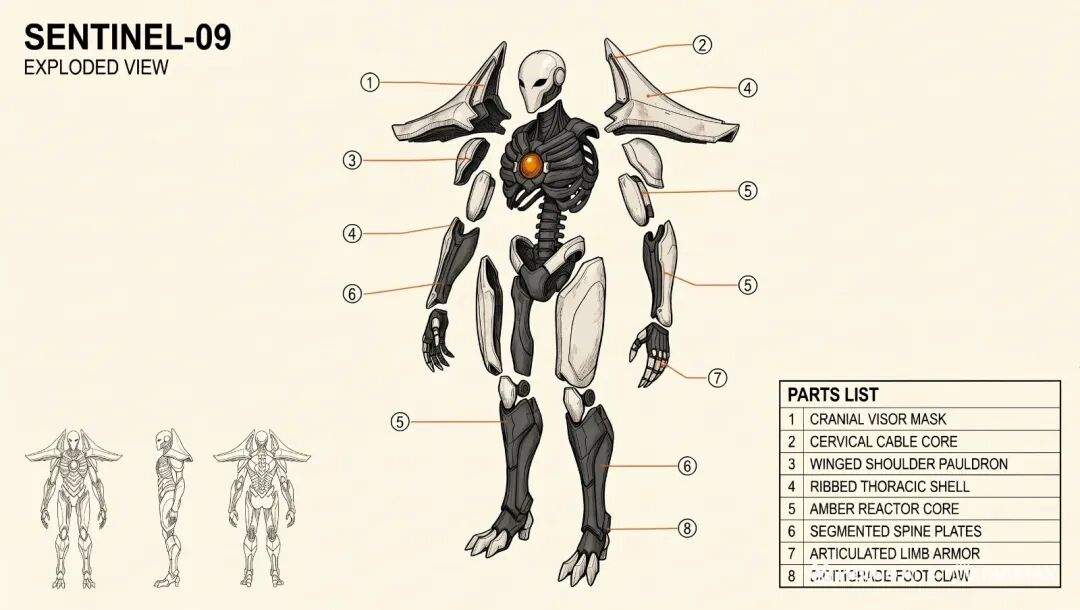
除了 CAD 图之外,你还能让这个模型「爆炸」开来。
让 H3-Image 画一张机械拆解的爆炸图,它能精准遵循机械装配逻辑,把零件分层清晰地展开,甚至连组件引线都给你标上。
这背后,无疑需要对三维几何与空间关系有着深刻的理解。
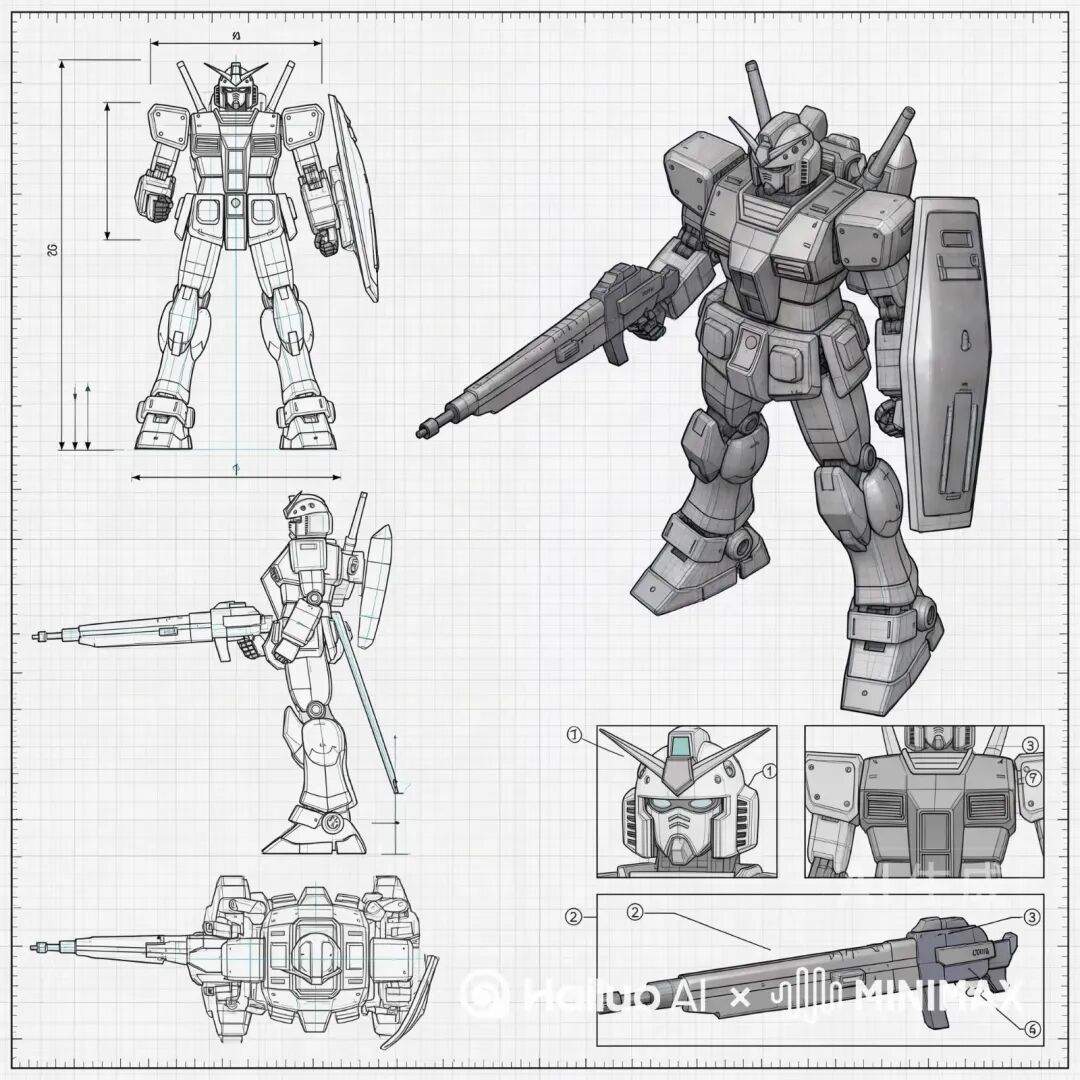
当然,对于这类功能属性明显的图片,指令遵循能力也非常重要。光靠「画」其实难度并不大,这主要考验的是模型的规划与推理能力。
不然的话,它根本搞不明白用户那一大堆提示词说的到底是啥。
当然了,真要切入严肃生产力场景的话,标准肯定得拉得很高,因为商业用途必须准确传达信息。
所以除了空间理解外,文本排版这个维度也非常重要。
于是,我又干了这么一件事——
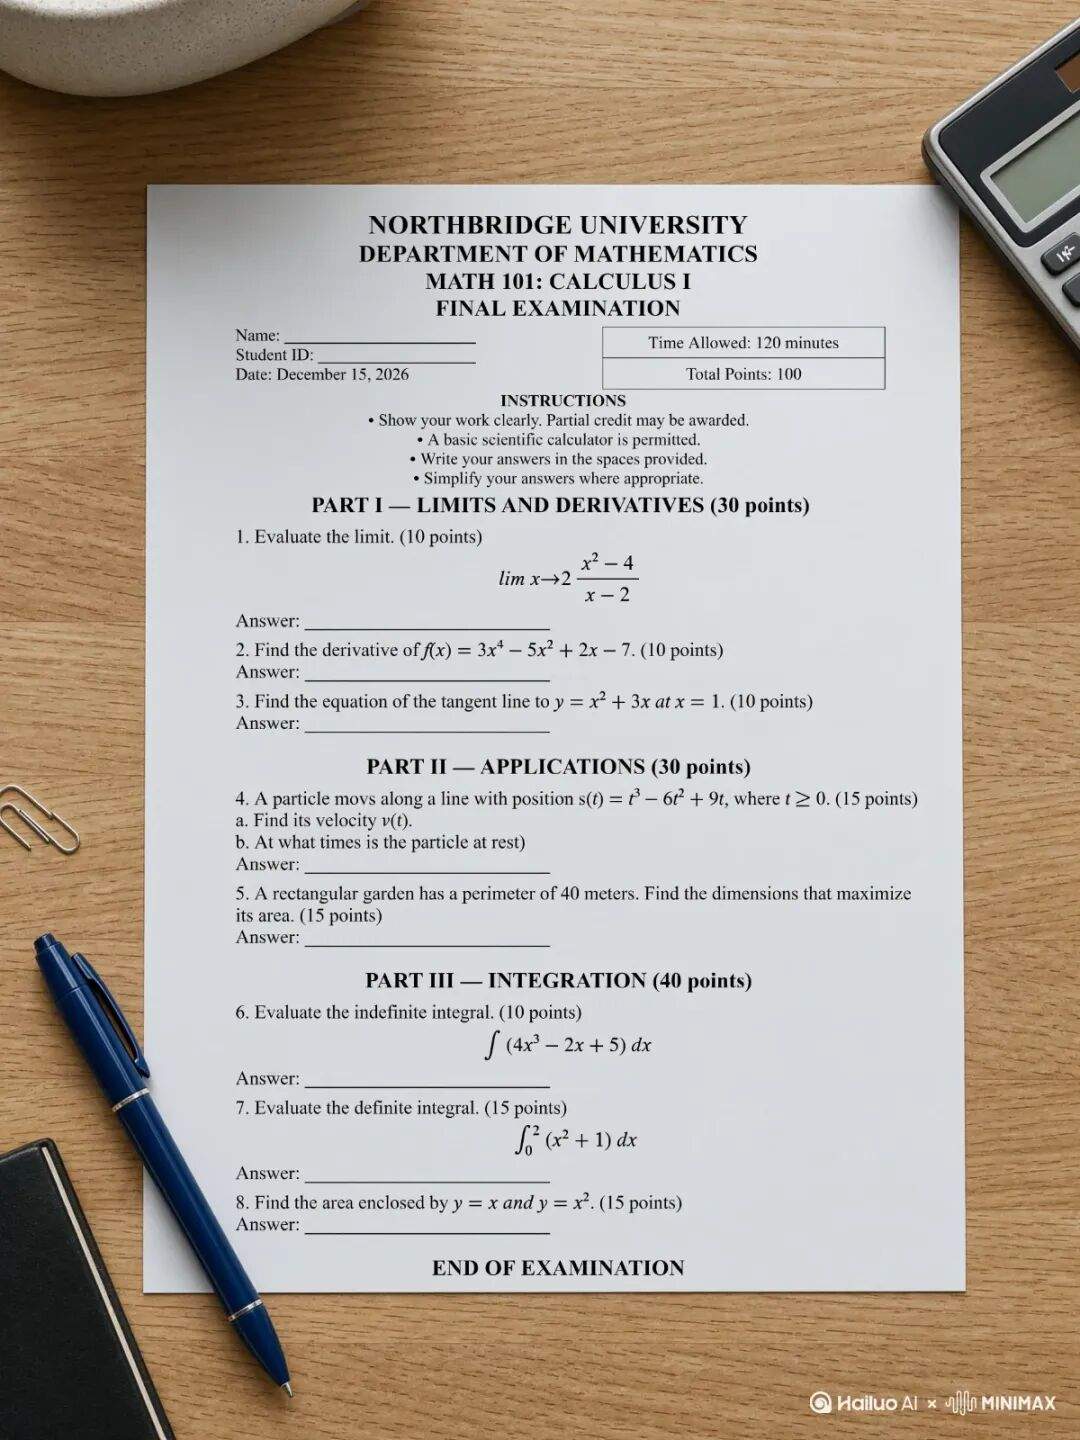
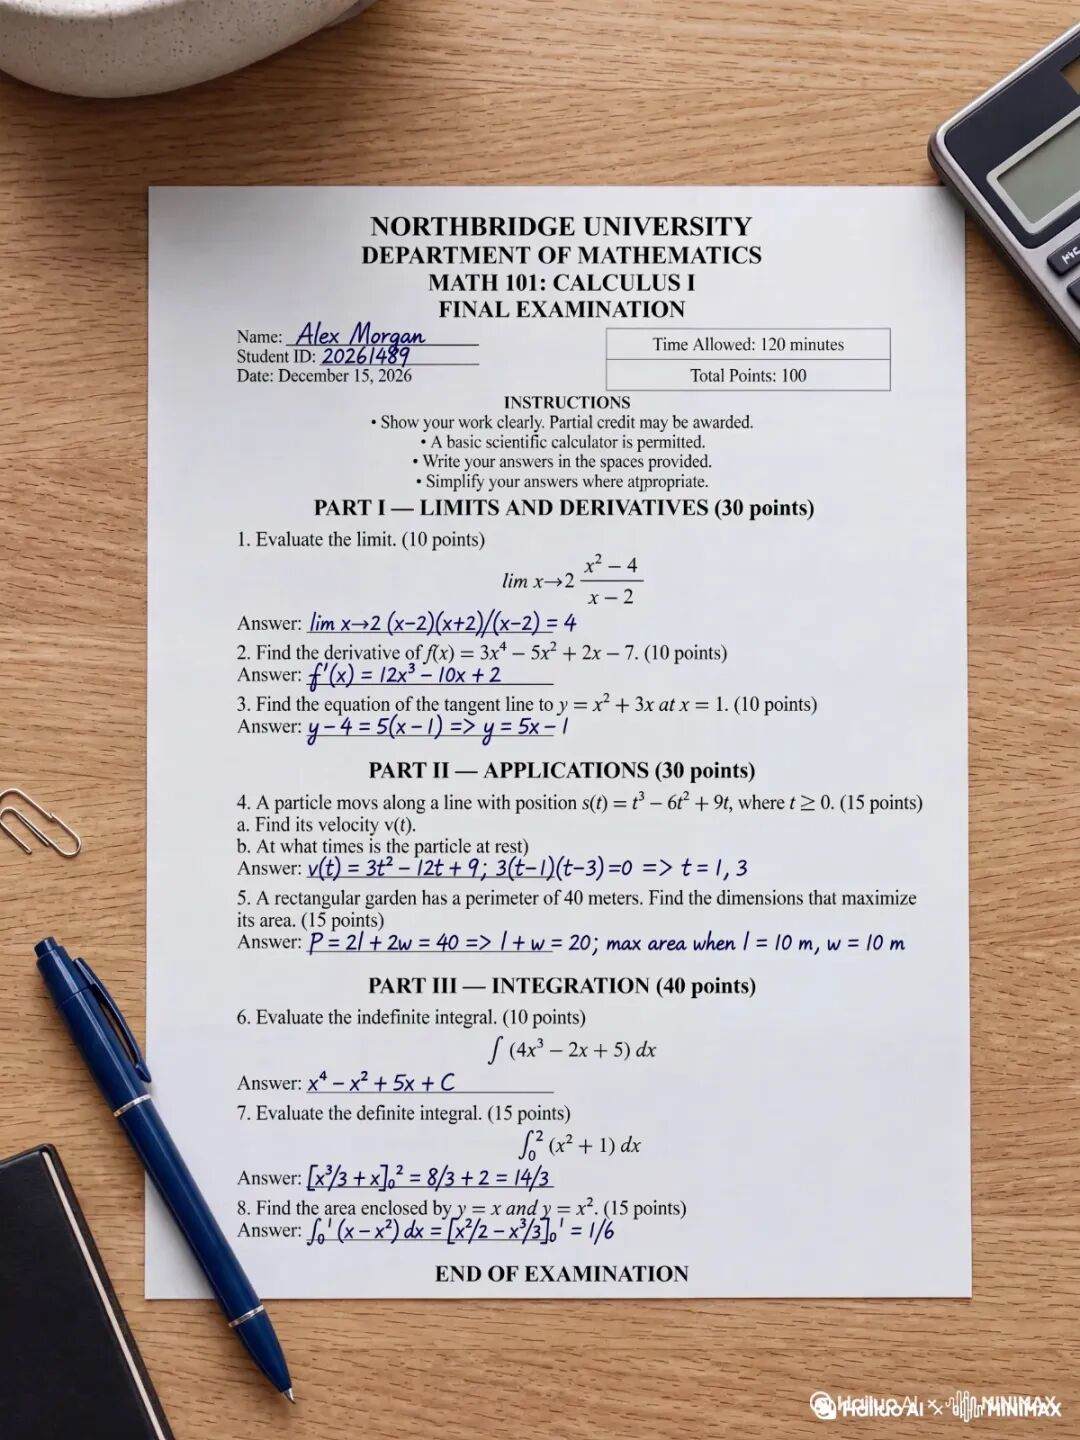
生成了一张高数期末考卷。
十多秒就生成出来了。
极限符号、复杂积分式……这种高密度的学术排版,居然一个字符都没乱码。
想必这还是太简单了,所以我又想出了一个天才提示词:
完成这份试卷。
打开一看,我整个人都震惊了——
什么叫图像生成模型的微积分水平比我还强???
凭借鄙人勉强结业的高数知识储备,我大概看了一下,发现答案居然是对的,甚至还有解题步骤!??
一时间无语凝噎。
当然,作为老本行,资产生成也不能少。
现在不是流行“Coding 吃掉一切”吗?Astra 降维打击 3D,Opus 5.5 降维打击视频。
但我一直觉得,很多都只是宣传口径。这些跟文本八竿子打不着的任务,我干嘛非要用文本模型来做?
只能说,纯文本领域确实资源更多、发展更快罢了。
从第一性原理出发,我还是更相信垂直模型这条路。各领域训各自的,不仅天花板更高,成本也更现实。
而且像 H3-Image 这种垂直模型,本身就是天选的专精模型,这与通用模型完全不矛盾,反而非常适合接入 Harness,让 Agent 直接进行 Tool Call。
这也是最近开始显现的趋势:不一定非得靠单个模型降维打击一切,通过通用模型去串联各个垂直模型,整体效用反而更高。
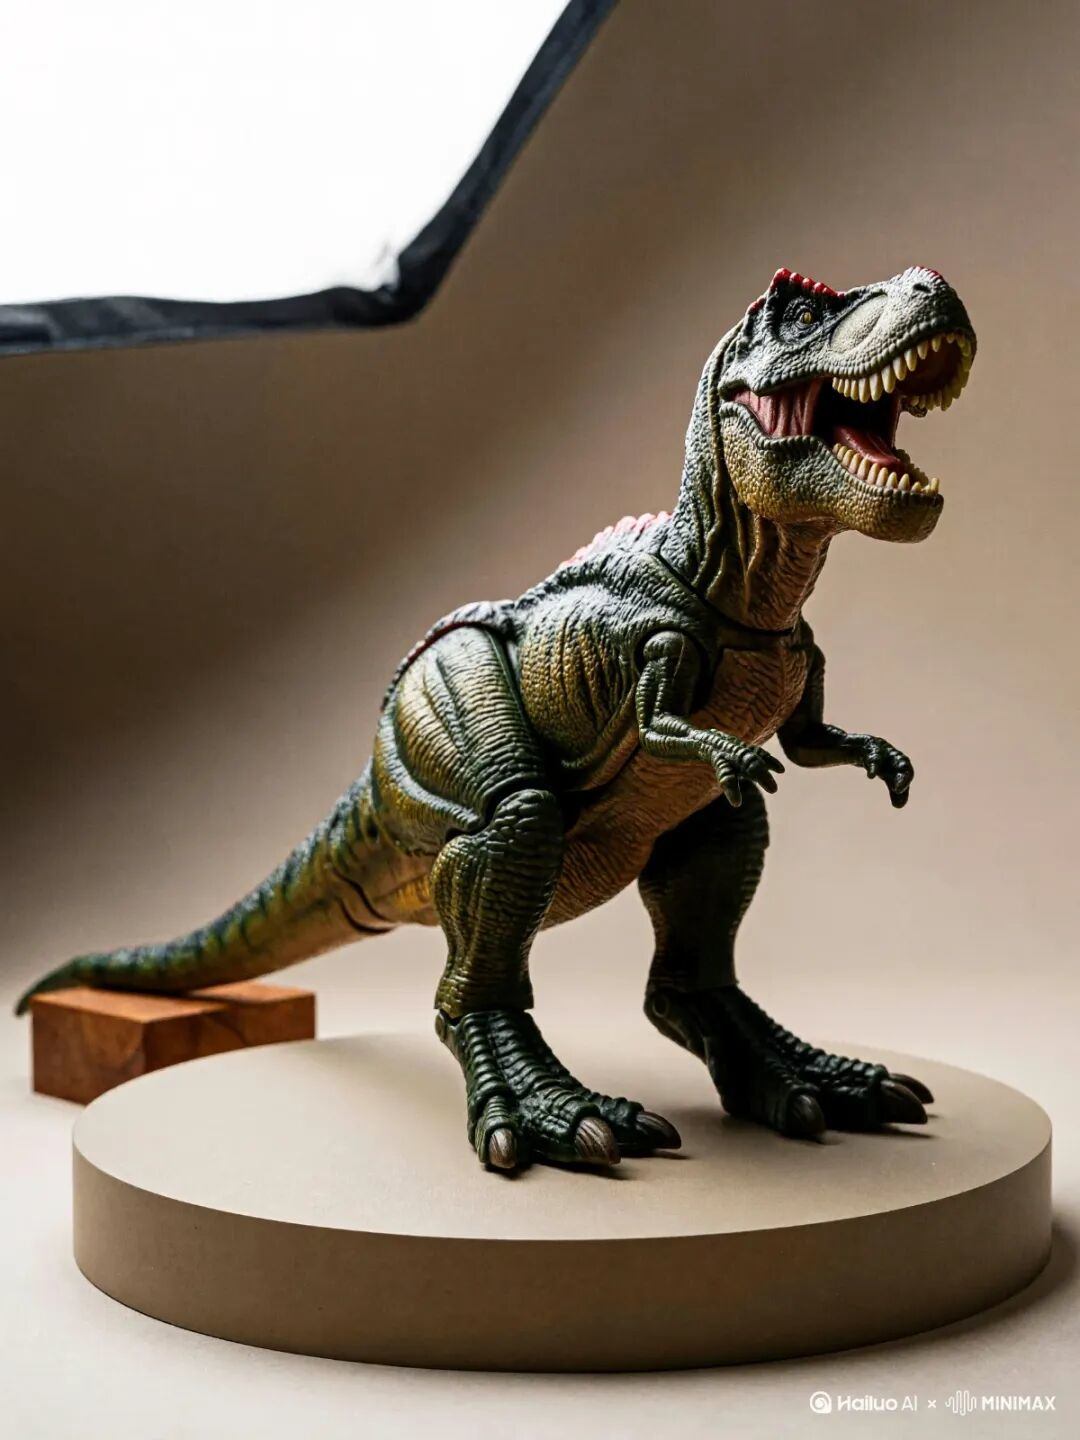
如果只是生成用来展示的资产(比如下面这种恐龙玩具),垂直图像模型明显是更优解,没必要用 Computer Use 折腾半天。
毕竟对于如今的图像模型来说,光影、几何等基本物理常识已经不再是问题。
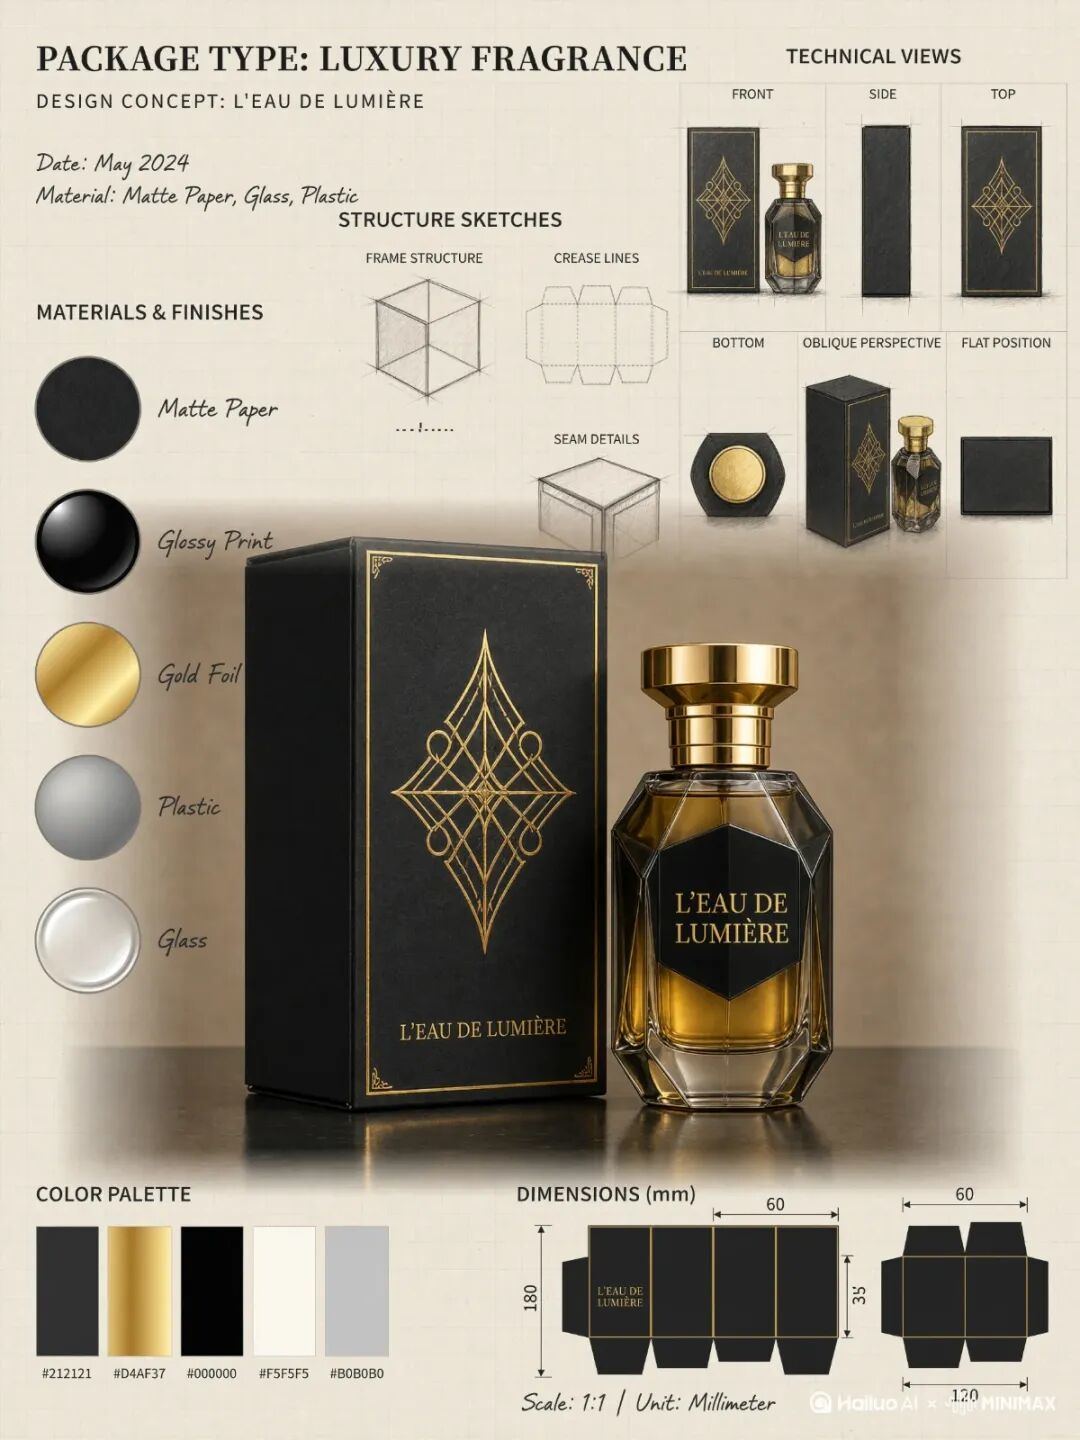
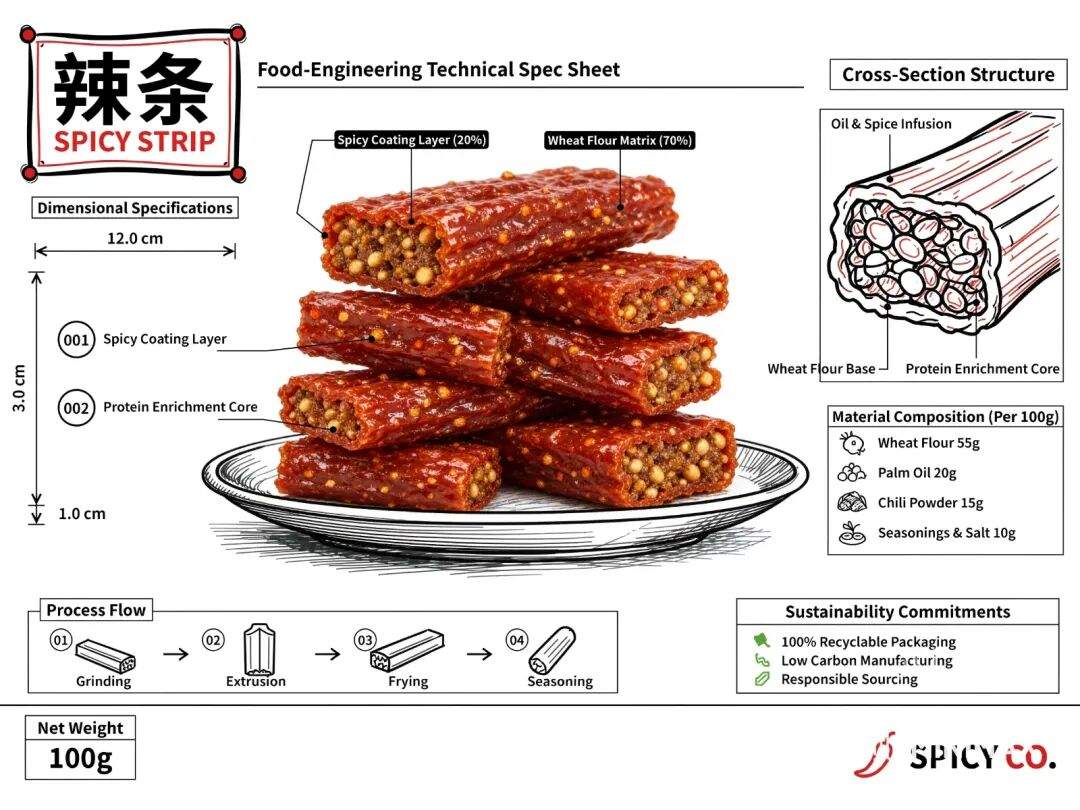
生成小零食包装之类的也没问题,且看我如何让中国辣条走向全球。
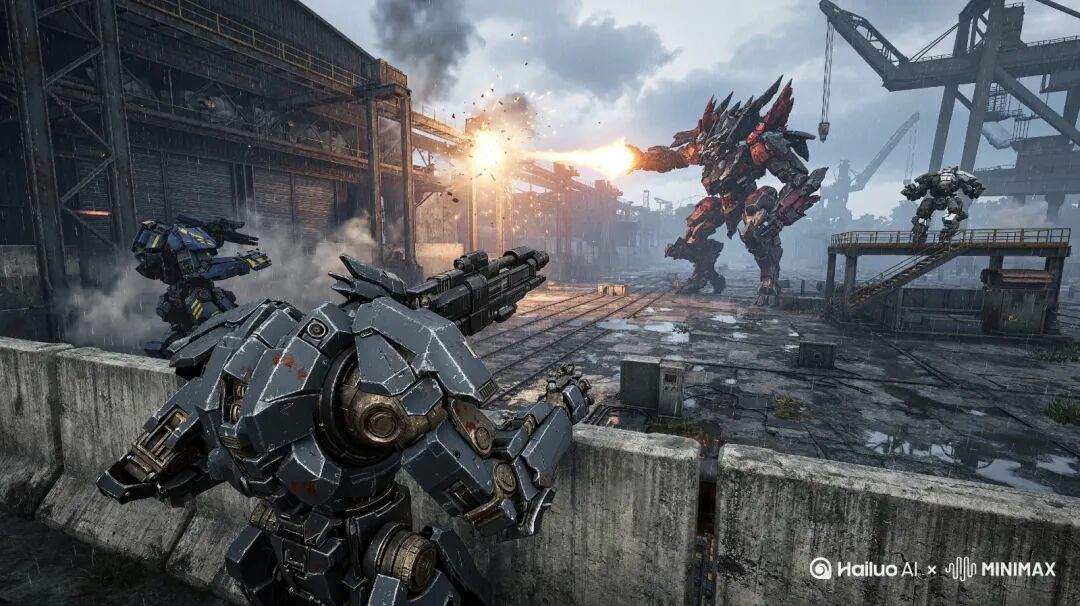
甚至连 3D 游戏画面也能生成,这属于是倒反天罡了😭。
一段长文本战术指令发下去——什么掩体、火力压制、侧翼包抄,它能立刻给你构建出一个具有真实纵深感和合理遮挡关系的 3D 战斗场景。
它能严密遵循游戏术语,生成的效果几乎可以直接用到概念设计里。
这我还等个啥 Astra Ultra 啊,反正都是看个 Demo,直接生成几张图片不就完事了。
(bushi)
多模态「源神」
测试内容基本上就这些。除此之外,作为一个旗舰图像模型,H3-Image 还放出了一些小福利。
最重要的是,H3-Image 直接把分辨率拉到了 16MP(4096×4096 像素),也就是原生 4K。
泪目了家人们,我终于不用在 GPT 生完图后,又丢给 Nano Banana 优化半天了🥹。
而且 4K 图像的生成速度也巨快,这么大的图,我在网页端体感也就 10-20 秒。
虽然但是,谁不想在等 GPT 磨洋工的时候,美美地来上一把贪吃蛇呢(bushi)。
扯远了。
除了这些,H3-Image 还有一个比较特别的参数——
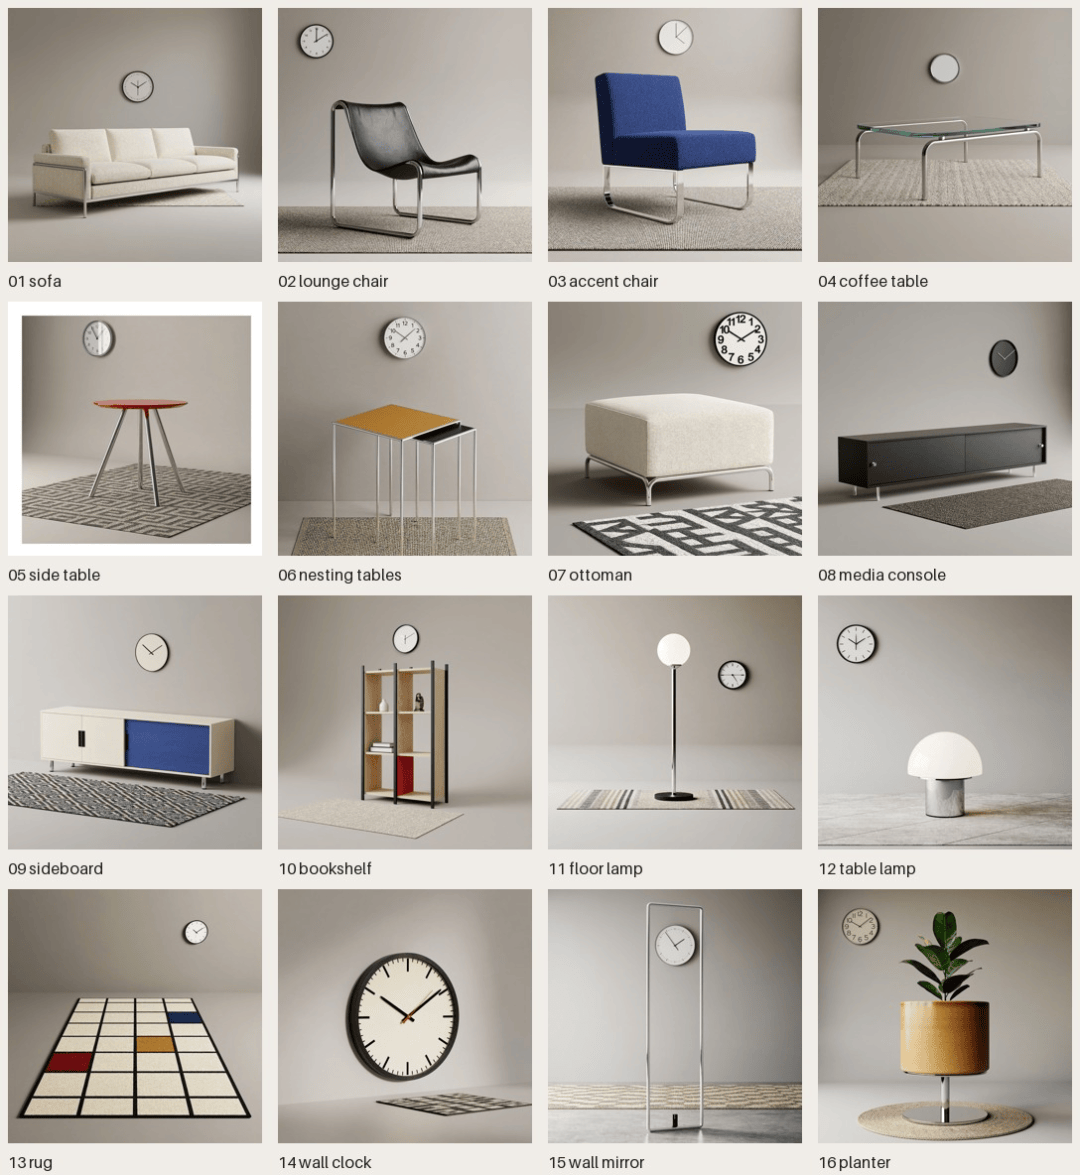
支持最多 16 张参考图输入。
真是容量拉满,堪称完美主义者的福音,在角色一致性、复杂分镜连续性上,给了创作者前所未有的自由度。
4K 日常创作,真正迎来了普及。
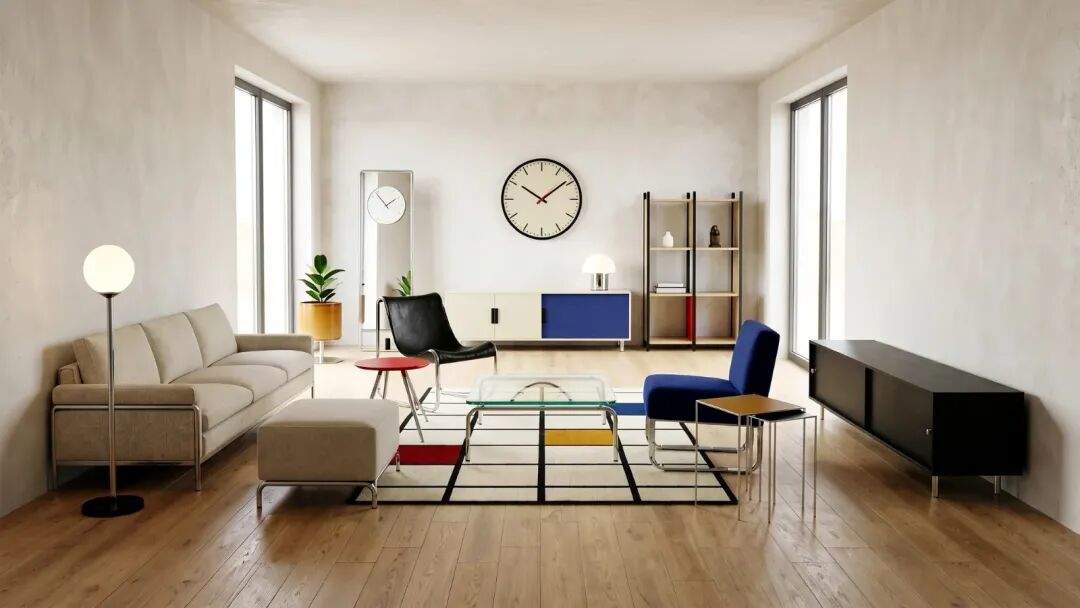
结果就是,你可以随手扔进几张参考图,再喝口水……
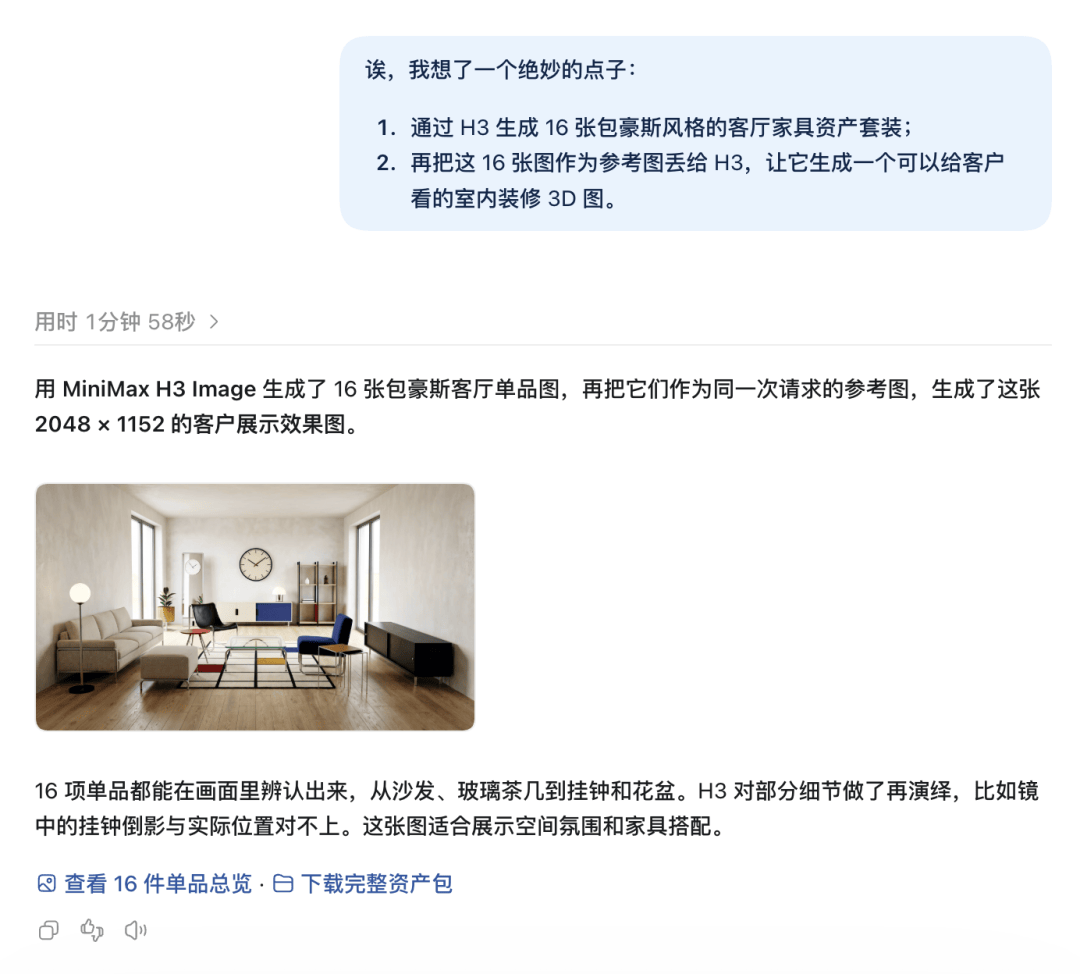
就能拿到这种质量的装修效果图。
这还要啥 Blender 啊😭。
但我万万没想到的是——
H3-Image,竟然是开源的???
继之前开源 SOTA 级视频模型 H3 之后,MiniMax 再次出手,又给全球开发者送上了一个可自由定制的 SOTA 底座。
多模态源神,不必多言。
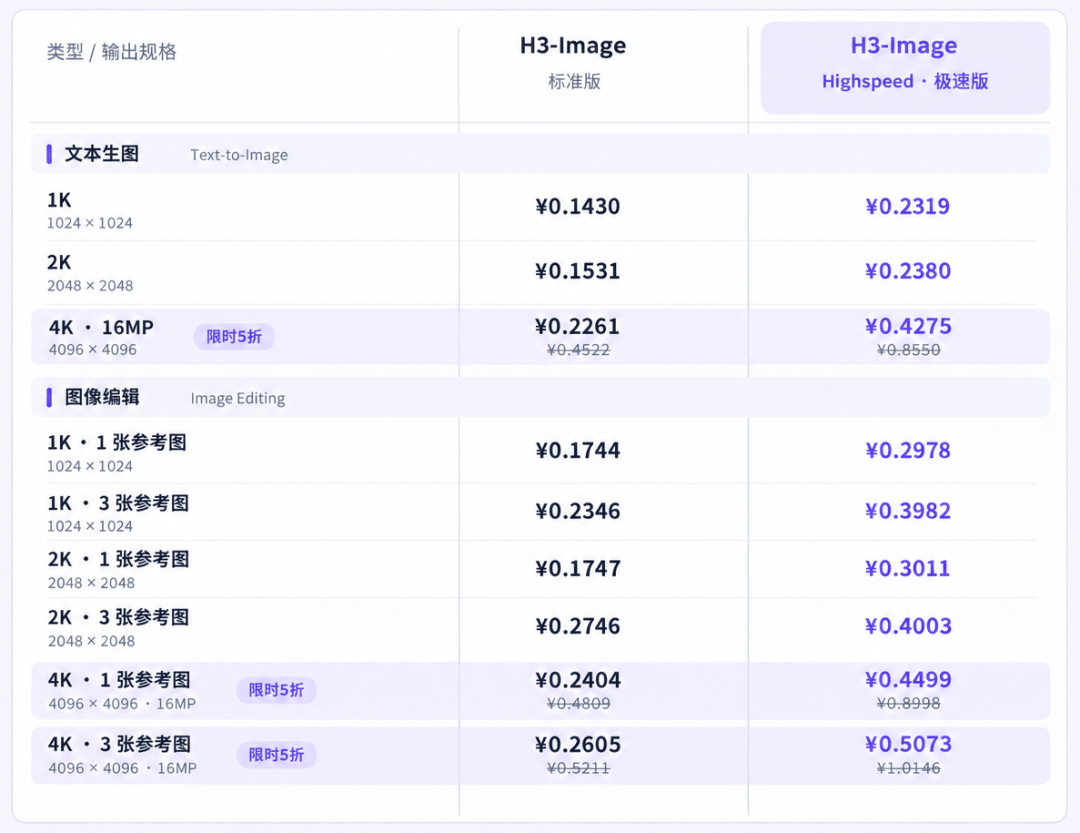
当然了,就算你没心思折腾本地部署,它的 API 调用也是白菜价。
价格只有主流竞品的 50% 到 70%,首周 16MP 请求还能再打五折(冲啊兄弟们!!)。
测到这里,我突然有种预感——
多模态生成,可能正在迎来属于自己的「Coding 时刻」。
过去 AI 生图在商业端常常「沦为玩具」,主要就是因为细节经不起推敲、塑料感太重,哪个甲方看到了都不乐意。
但如今,H3-Image 做到了三件事——
去 AI 味、可泛化的审美、严密的逻辑。
当这些条件被满足时,多模态的应用市场绝对不逊色于编程。
从高精度工业包装设计、商业插画,到多语言的跨境营销物料,新一代图像模型的出现,能大幅压缩传统工作流的周期。
再叠加上刚刚提到的这些 Buff:速度 + 开源 + 低价……
这会带来一个怎样的未来,简直难以想象。
最后,咱们还是把视线移回如今的 AI 圈吧。
当全球 AI 公司的目光几乎全部聚焦于纯文本时,MiniMax 仍然把很大一部分精力放在了多模态世界。
这也是这家公司一直以来的特点:从一开始就押注多模态,如今终于迎来了能力涌现。
都说多模态对 AGI 不重要,Coding 才有商业模式……
但我一直觉得,如果 AI 的定义里只容得下文本,那这个未来未免也太无趣了。
从改写视频生成格局的 H3,到如今在逻辑、结构与审美上全面突破的 H3-Image。
国产开源这把野火,已经彻底开始向多模态领域——
蔓延。