
发布于 2026 年 11 月 11 日
多向量嵌入(Multi-vector embedding)模型让每个查询词元(Query token)都有独立的机会在文档中找到匹配项。这使得它们在搜索任务中具备极强的表达能力,但随之而来的文档向量数量也会迅速膨胀。一个包含数百万篇文档的语料库可能包含数亿个向量!
词元池化(Token pooling)通过合并相似的词元向量来缩小这些表征的体积。然而,压缩得越激进,就越容易丢失有用的信息。池化感知训练(Pooling-aware training)能够教会编码器在合并向量时保留关键信息,从而帮助你在相同的存储预算下获得更好的检索效果。
在这篇文章中,我将解释池化的工作原理,使用 Sentence Transformers 训练一个用于压缩检索的模型,并探讨由此产生的质量与存储权衡。在 pool_factor=4(池化因子为 4)的设置下,我按常规方式训练的模型在将文档向量减少 4 倍的同时,保留了未池化时 94.6% 的 NanoBEIR nDCG@10 性能。而在相同的存储预算下,词元池化感知训练将这一保留率提升到了 97.8%!让我们来看看具体是如何实现的。
本文建立在 Stefan Josef 的 Learn to Pool 以及 LightOn 的池化正则化研究中所探讨的池化感知训练基础之上(后者还探索了定向训练和自适应预算)。在这里,我将重点介绍如何理解该方法,并通过一个简短、可复现的 Sentence Transformers 示例将其投入实际应用。
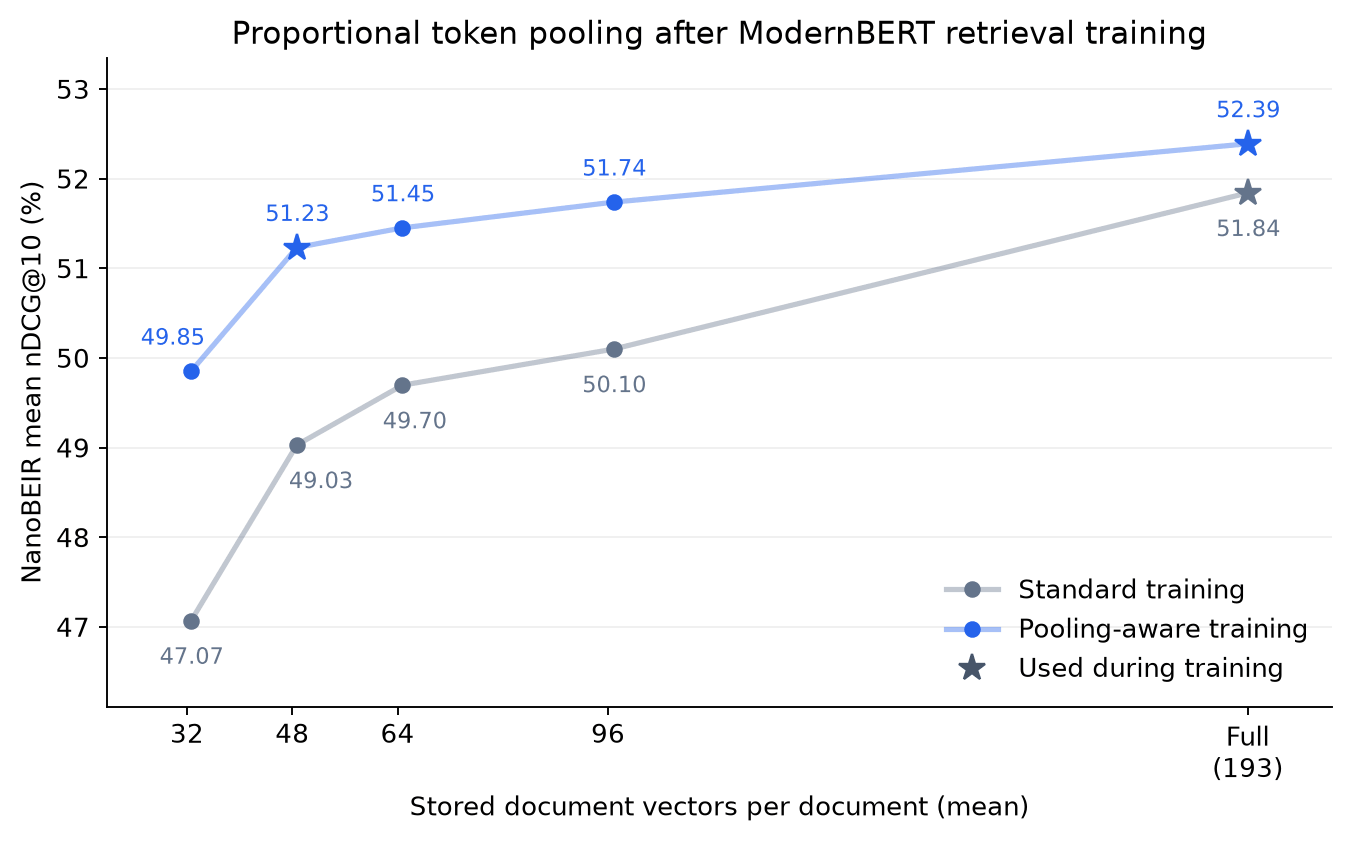
池化感知训练在相同的向量预算下提升了检索质量。详情如下。
目录
为什么多向量检索需要这么多向量
单向量嵌入模型会将整篇文档压缩成一个向量。而像 ColBERT 这样的多向量模型则会保留一组上下文词元向量,从而允许查询的不同部分与文档的不同部分进行匹配。
例如,一个关于“长续航笔记本电脑”的查询,可以在文档的一部分中找到关于笔记本电脑的证据,并在另一部分中找到关于电池续航的证据。通过 MaxSim(最大相似度)评分机制,每个查询向量都会选择其最佳匹配项