
蚂蚁灵波开源LingBot-Touch
太反差了。
明明给机器人装上了触觉,它怎么反而变得更笨了呢……
 △图片由AI生成
事情是这样的。
最近有个团队做了个实验:他们在Sharpa Wave灵巧手的五根手指上都装了触觉传感器,任务是让它把袋子的拉链拉上。
他们选用的动作模型是π0.5。在只靠摄像头的情况下,成功率为39%。
随后,团队把指尖传感器的读数原封不动地喂给模型。按理说,机器人多了一种感官,拉拉链应该更得心应手才对。
但您猜怎么着?
AUV(哎呦喂)……成功率直接掉到了15%!
而且这还不是个例。
同样是Sharpa Wave灵巧手加π0.5的组合,接入原始触觉后去做交接盒子的任务,成功率从57%掉到了48%。
即便把灵巧手换成XHand,6项任务平均下来,成功率也从49.71%降到了48%。
那么,机器人多了一种感官,反倒变得笨手笨脚,原因到底是什么?
答案是,问题出在读数上。
触觉数据和其他数据不太一样。机器人的手指大部分时间并不接触物体,所以读数差不多就是一大片“0”;即使开始接触物体,信号也是稀疏且带噪声的。
此外,不同的传感器各司其职:视触觉负责拍摄指尖软胶的形变,磁触觉负责测量磁场,压阻式触觉负责记录电阻……数据各不相同。
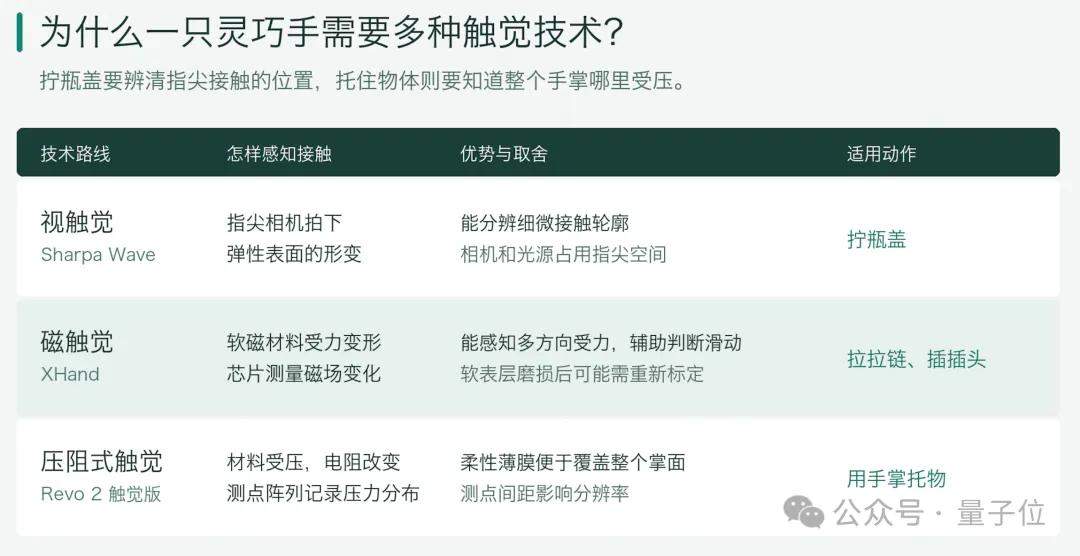 △三类触觉传感器如何感知接触,各有什么取舍
比如在捏住瓶盖这个任务上,三种传感器给出的是三种完全不同的数字。动作模型不仅看不懂,还得硬着头皮用,可以说是在帮倒忙。
那么,这个局该怎么破?
蚂蚁灵波给出的解法是:在传感器和动作模型之间加一个“翻译”。
(注:上面的实验就是蚂蚁灵波做的。)
简单来说,就是先把各种传感器读到的数据,翻译成动作模型能看懂的信息,例如手指碰在哪儿、用了多大力、力往哪个方向偏、有没有打滑,然后再交给动作模型。
还是那个π0.5,还是那个拉拉链的任务,这样操作之后,成功率直接飙升到59%,甚至比完全不用触觉还高出20个百分点;交接盒子任务的成功率,也从48%回升到63%。
而这个“翻译”,就是蚂蚁灵波今天最新开源的触觉预训练基础模型LingBot-Touch。
有了它的加持,前面提到的拧瓶盖动作就变得非常丝滑了:
视频地址:
https://mp.weixin.qq.com/s/b7PNN5A3W8e1bZDVNTd5tg
要知道,拧瓶盖最容易翻车的地方,恰恰是指腹和瓶盖贴在一起的那一小块:捏得稍微松一点,指腹就会在盖面上打滑,手腕转了半圈,盖子却纹丝不动。而这一幕,正是摄像头看不清的。
那么,LingBot-Touch这个“翻译”,究竟是怎么做到的?
灵巧手需要一个翻译
先来讲清楚LingBot-Touch干的是什么活儿。
简单来说,它负责接收磁触觉、视触觉、压阻式触觉三类传感器的信号,并统一编码成一种触觉Token,从中读出接触位置、受力大小,以及力的方向如何随时间变化。
它的位置刚好卡在中间:向下可以接入不同的传感器和灵巧手,向上则把这些Token交给不同的动作模型。
这样一来,无论各家传感器的信号多么五花八门,到了动作模型这里,都能被统一理解,可谓殊途同归。
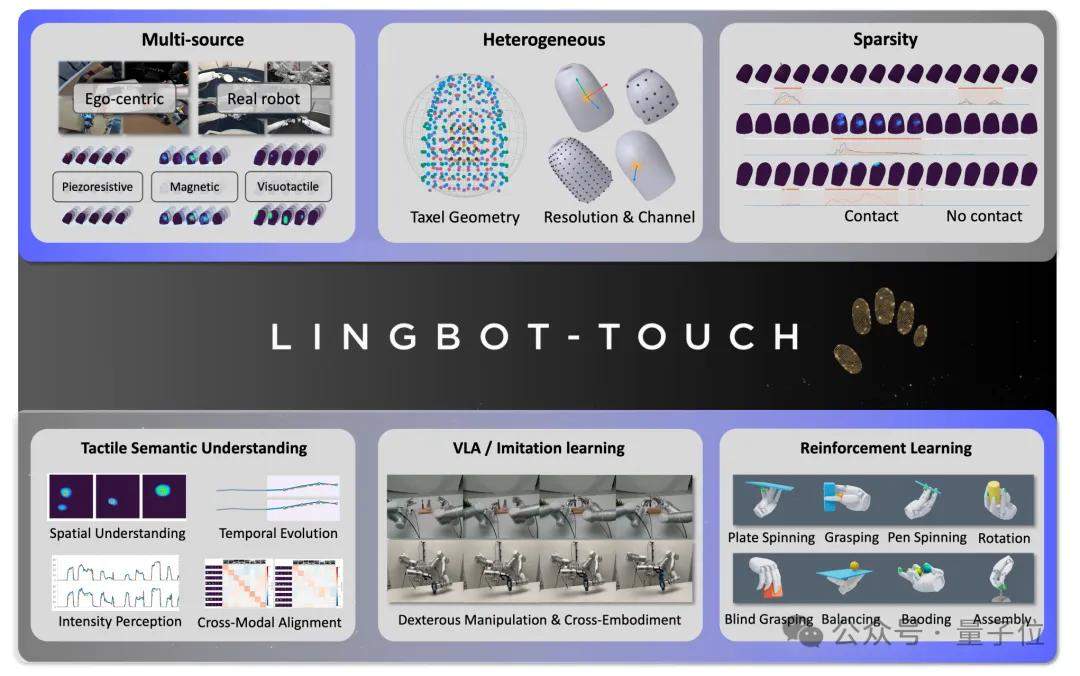 △LingBot-Touch连接多种触觉传感器与真实灵巧操作
此外,LingBot-Touch的轻量版LingBot-Touch-Tiny只有约532万参数。目前,技术报告、代码和模型权重均已开源。
那么,LingBot-Touch又是怎么练成的呢?
整体来看,蚂蚁灵波团队主要分了三步。
第一步:统一坐标。
团队遇到的第一个难题,是不同传感器的触点数量和排布差别实在太大。比如,有的灵巧手光是拇指上就布了116个触点,有的布料手套却只有一个3×3的小阵列。
如果按编号硬对,肯定对不上。
为此,团队先把所有传感器的触点映射到同一个标准化的指尖空间里,再给每个Token分配一个“地址”,这个地址由时间、手指和三维位置共同构成。
地址通过旋转位置编码(RoPE)输入模型。这样一来,模型不再要求触点数量固定,即便换一种布局,也照样能读。
在此基础上,三类传感器各有一个轻量的入口,负责把原始读数转成Token;入口之后,则共用同一个触觉Transformer主干。
也就是说,传感器之间的差异由各自的入口消化,而接触本身的规律,则放到主干里统一学习。
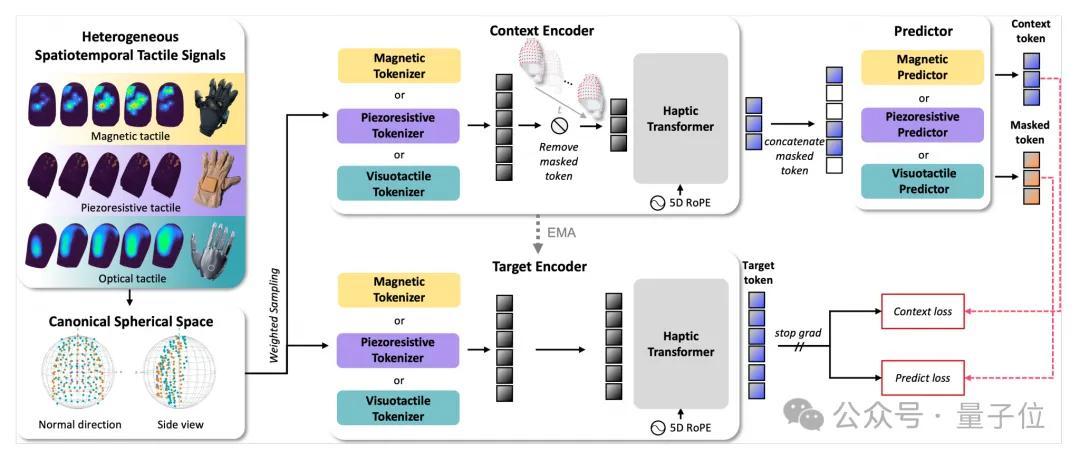 △LingBot-Touch整体架构:三类传感器各设入口,共用一个主干
第二步:在特征空间里做预测。
坐标统一之后,团队又碰上了第二个坑,也就是开头提到的那一大片“0”。
如果让模型去还原原始读数,它很快就会找到捷径:只要把“没碰到”的背景学好,损失就能降得很低。这样一来,分数虽然好看,真正有用的接触信息却没学到多少。
因此,LingBot-Touch选择了JEPA路线。
具体来说,训练时模型会随机遮住**90%**的触点,而且整段时间都遮着;然后,模型要根据剩下10%的变化,在特征空间里预测被遮住部分的表征,而无需逐点还原读数。
这样做的效果立竿见影:同样用1000小时数据训练,LingBot-Touch判断接触中心的误差是0.90毫米,而VAE和MAE都在3毫米以上。
再比如,用一段触觉去检索对应的视频画面,LingBot-Touch的前5召回率是32.07%,另外两种方法则都不到6%。
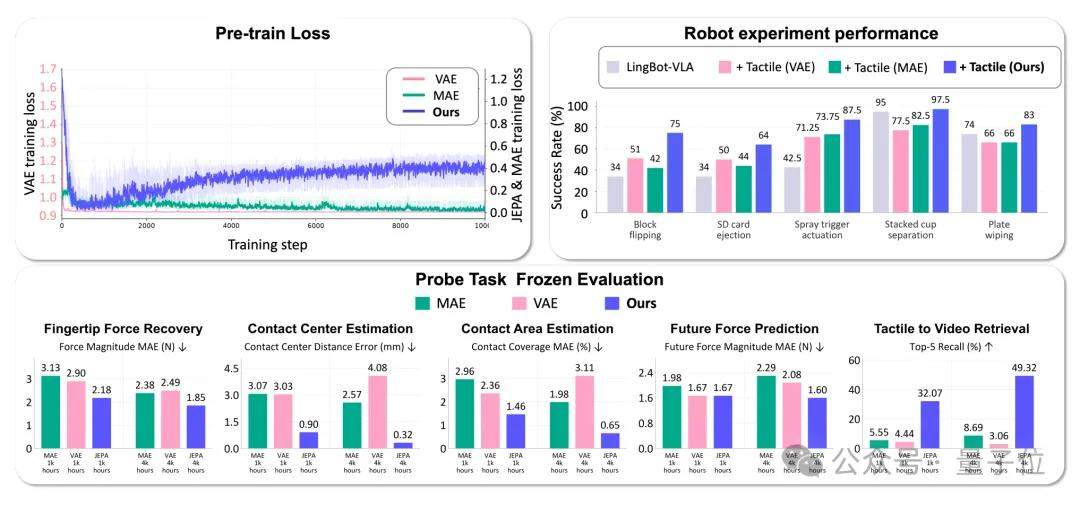 △同样的数据,特征空间预测与还原原始读数的效果对比
第三步:扩充数据,防止模型死记硬背。
LingBot-Touch的预训练数据共有4983小时、约13.3亿帧。其中三分之二来自人戴着触觉手套干活,剩下三分之一来自遥操作Sharpa Wave双臂机器人。
之所以大量使用手套,是因为它不需要机器人,一个人一天就能在普通环境里录上好几个小时。而且这些数据只标注了开、关、装配、倒水等任务类别,没有一帧标注过力的大小。
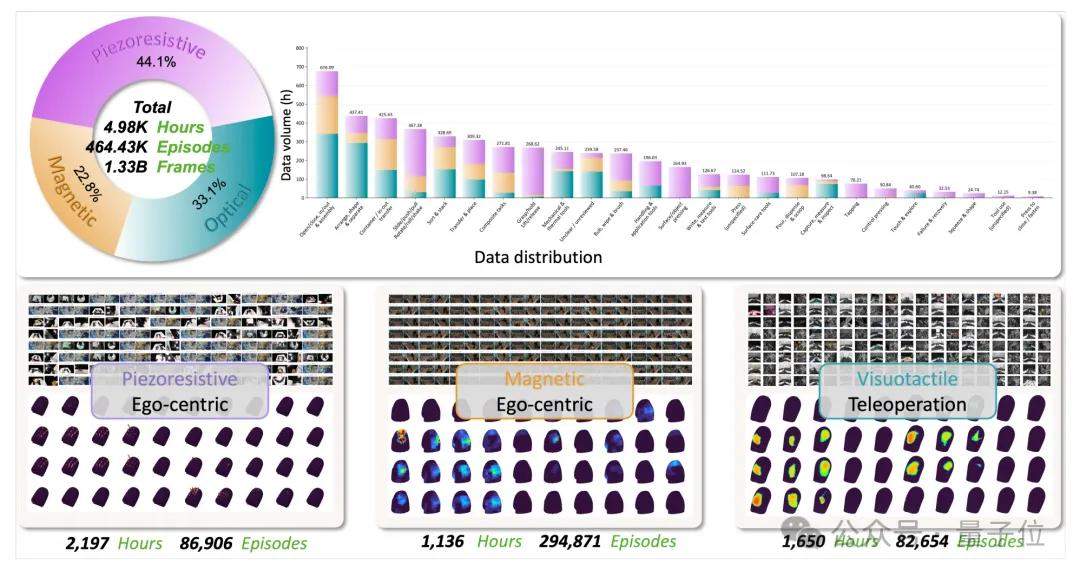 △预训练数据的构成,覆盖三类传感原理
不过,数据攒够了,团队还得防着模型“偷懒”。
预训练数据里只有三种传感器布局,模型很可能直接把这三套触点位置背下来,等碰到第四种布局就抓瞎了。
所以在训练时,团队会随机改变触点的采样密度,再把每个触点的位置小幅挪动,逼着模型去学习接触本身的规律。
三步走完,就该上真机检验了。
测试覆盖了两款灵巧手:高自由度的Sharpa Wave做20项任务,低自由度的XHand做6项,共26项。
参与测试的动作模型有四种,分别是Diffusion Policy、π0.5、LingBot-VLA和T-Rex。每种模型都要在不用触觉、直接喂原始信号、接入LingBot-Touch三种设置下分别测试。
结果显示,在两款手上,四种模型都是接入LingBot-Touch的那一组平均成功率最高。
和不用触觉相比,T-Rex、π0.5、LingBot-VLA的成功率分别提升了23.18、21.81、24.81个百分点,而代价仅仅是参数量增加了0.13%到0.16%。
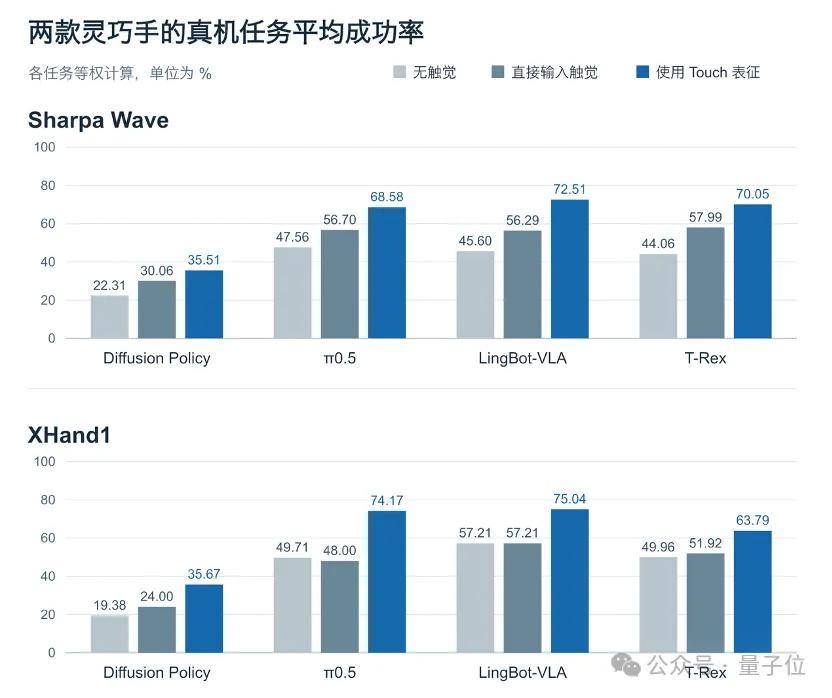 △两款灵巧手上,四种动作模型在三种设置下的平均成功率
就拿单手插吸管来说,这个任务的难点在于刺破封膜的那一下:吸管抵住透明封膜往下压,阻力越来越大,膜一破,手上又会突然一松。
摄像头很难分清封膜是被压凹了还是已经被扎穿,指尖却可以。要是收力慢了一步,吸管就会直接冲到杯底。
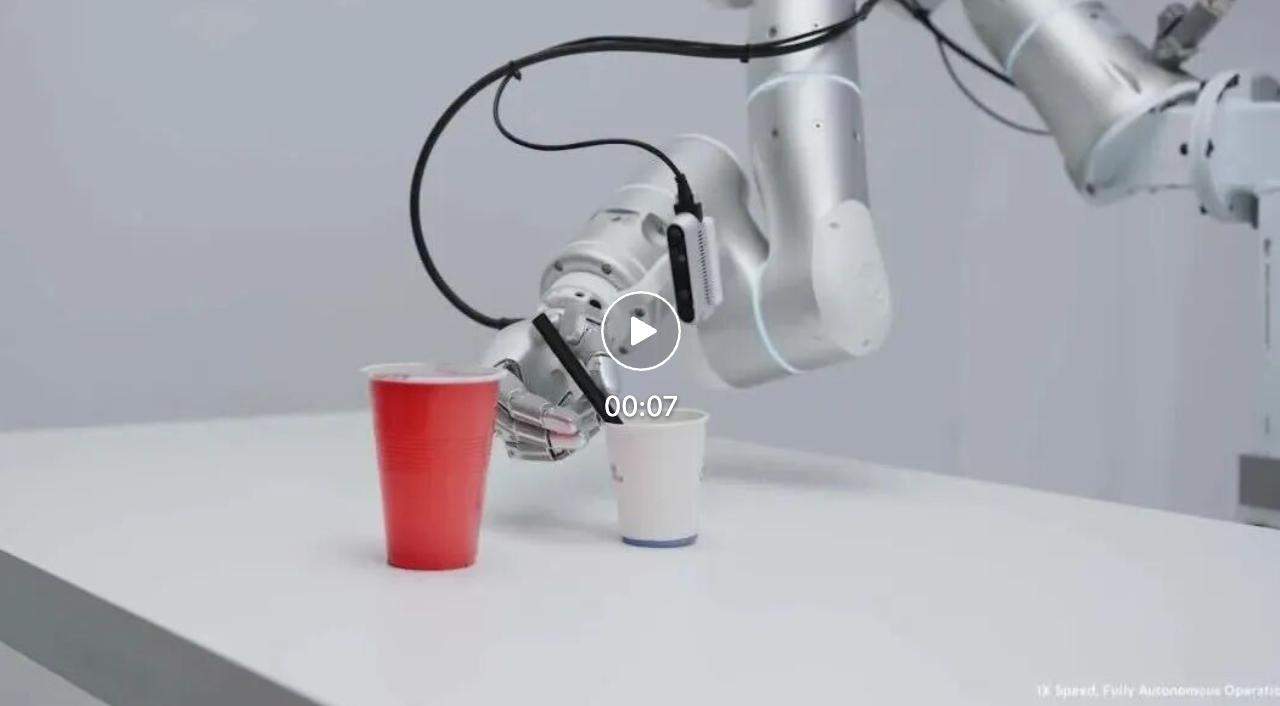
视频地址:
https://mp.weixin.qq.com/s/b7PNN5A3W8e1bZDVNTd5tg
当然,最能说明问题的,还得是XHand这组实验。
XHand所用的磁触觉传感器,型号从未出现在预训练数据中;而且预训练里的磁触觉数据,全部来自人戴的手套。接入XHand时,LingBot-Touch更是一个参数都没改。
即便如此,π0.5在6项任务上的平均成功率,还是从直接喂原始信号时的48.00%升到了74.17%。
其中分离叠杯一项,成功率更是从32.5%翻了一倍多,达到72.5%。
这个任务要求灵巧手只取走最上面的那只杯子:一只手扶住整摞杯子,另一只手捏着杯沿往外抽。如果阻力突然变小、指腹还稳稳贴着杯沿,说明杯子已经松脱,得马上收力;如果是指腹自己在杯沿上打滑,就该重新抓取。
这两种情况,手感截然不同。
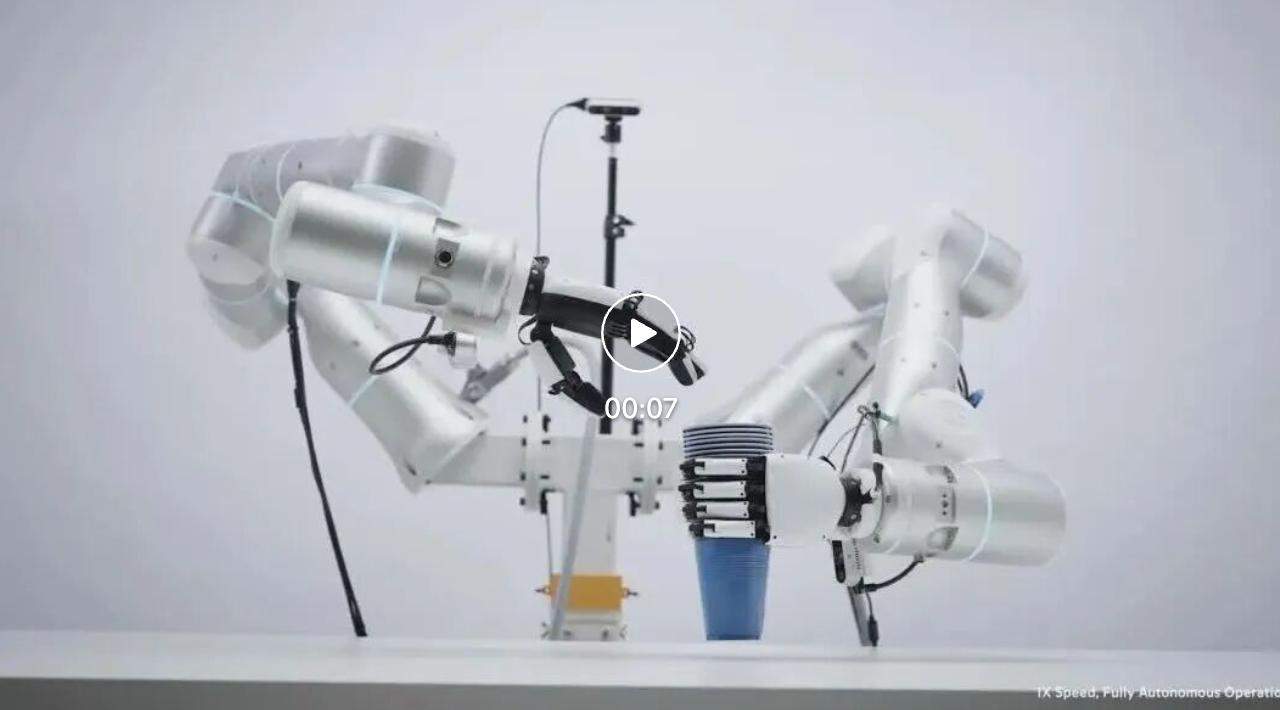
视频地址:
https://mp.weixin.qq.com/s/b7PNN5A3W8e1bZDVNTd5tg
换句话说,人手积累的经验,帮机器人读懂了一只它从没摸过的手。
此外,团队还拿LingBot-Touch和此前的触觉基础模型FTP-1做了对比。
在Sharpa Wave上判断接触中心时,FTP-1的误差是2.19毫米,LingBot-Touch则是0.12毫米;在XHand上,误差也从5.89毫米降到了0.16毫米。
要知道,FTP-1在这两只手上还分别配了专门的适配器,而LingBot-Touch用的是同一个冻结的编码器。
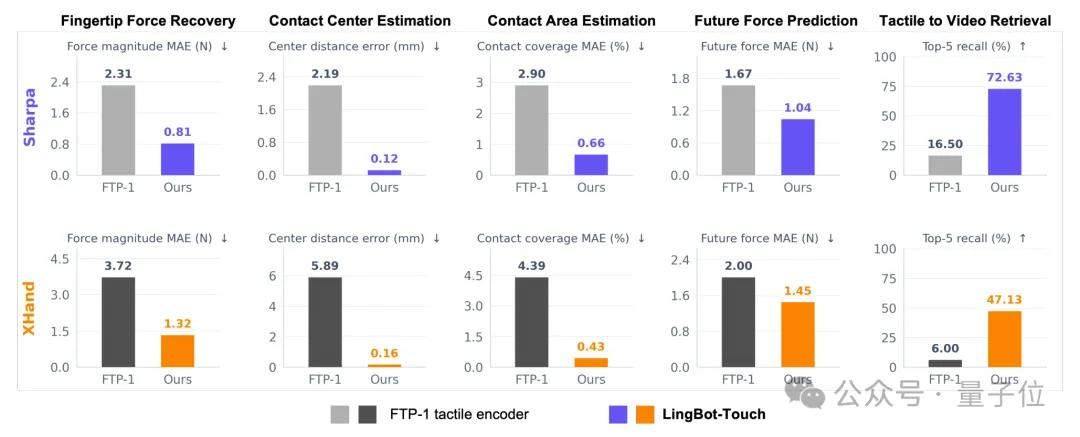 △与FTP-1在两款灵巧手上的对比
另外,LingBot-Touch的Scaling Law也已初步显现。
Tiny版在4000小时左右开始饱和,换成容量更大的Small版后,到5000小时效果仍在上涨;真机任务的成功率,同样随着预训练数据的增加而稳定提升。
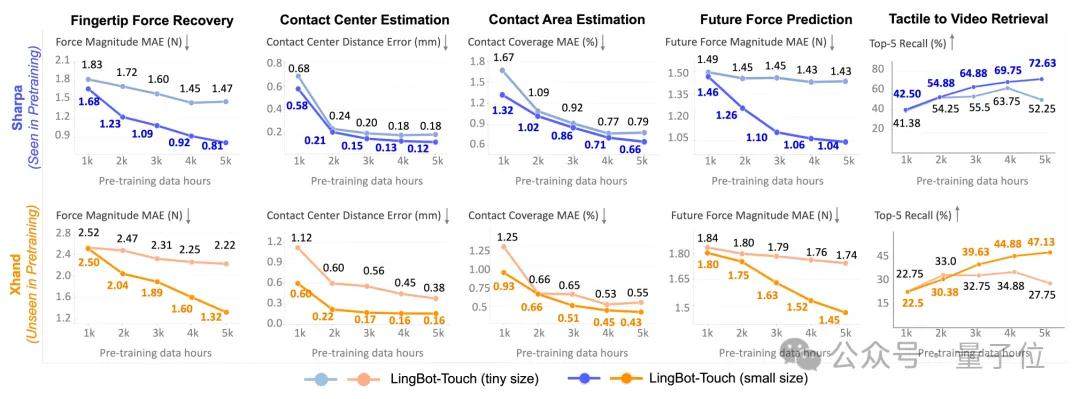 △预训练数据量与模型规模对效果的影响
补齐了触觉的拼图
看完技术细节,再把LingBot-Touch放回蚂蚁灵波的整条技术路线中,就能更清楚地看到它的位置。
此前,灵波的通用大脑已经铺开了三块能力:空间感知有LingBot-Vision和LingBot-Depth 2.0,环境交互有LingBot-Video和LingBot-World 2.0,灵巧操作则有LingBot-VLA 2.0和LingBot-VA 2.0。
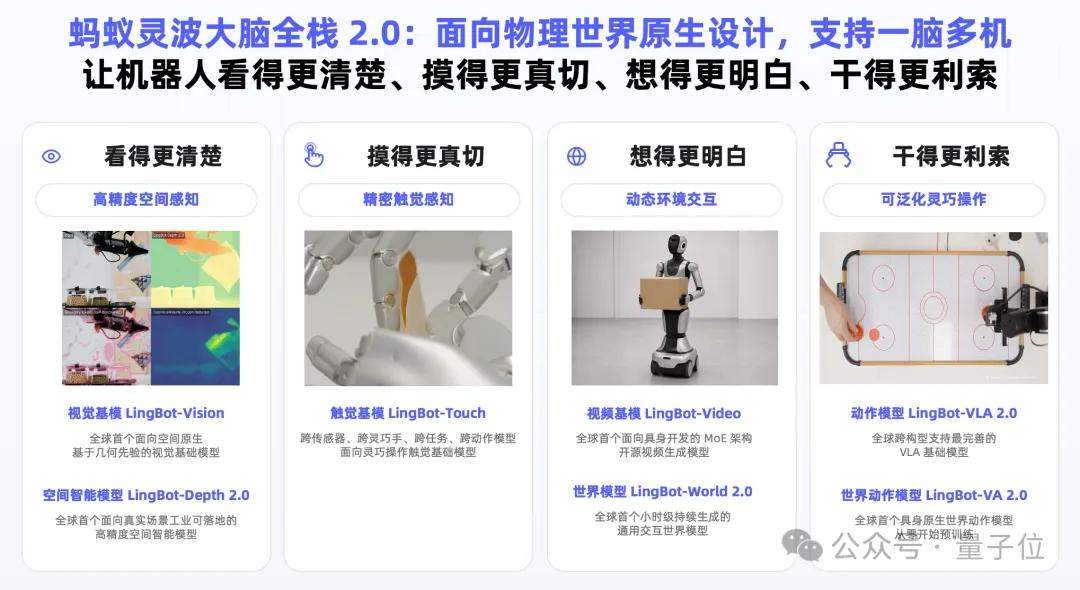
可以看到,这几块能力大多在解决碰到之前的问题,比如东西在哪儿、手该伸向哪里、下一步该做什么。
然而,一旦手指碰上物体,视觉能提供的信息就少了:指腹贴着瓶盖的地方会被手挡住,钥匙插进锁孔之后更是什么都看不见。
LingBot-Touch补上的,正是这一块。用一句话概括,就是视觉管接触之前,触觉管接触之后。
双手开锁就是一个典型的例子。
一只手握着挂锁,另一只手捏着钥匙对准锁孔,这一步主要靠眼睛;可钥匙往里一推,就可能把锁顶歪,推到一半卡住了,还得退回一点、换个角度再试。
等钥匙进了锁孔,摄像头基本就帮不上忙了,灵巧手只能靠钥匙传回指尖的阻力来判断。
视频地址:
https://mp.weixin.qq.com/s/b7PNN5A3W8e1bZDVNTd5tg
看到这里,或许有小伙伴要问:灵波为什么要把触觉单独做成一个基础模型?
原因在于,每只手的控制方式各不相同,但它们都得理解接触。
如果把“理解接触”单独拎出来,做成可复用的一层,那么一款硬件积累的经验,就能成为下一款机器人的起点。
这个思路,其实和灵波此前做LingBot-VLA一脉相承。
VLA研究的是同一个大脑如何驱动不同构型的机器人,也就是“一脑多机”;到了Touch这里,问题又往前推进了一步:不同的手、不同的传感器积累的接触经验,能不能放在一起学习,再用到新的机器人身上。
而前面XHand那组结果,算是给出了一个初步的答案。
LingBot-Touch的几个设计选择,也正是从这个目标倒推出来的。用手套采集数据,是因为手套不依赖机器人本体,数据规模才扩得上去;入口按传感原理设计、不按产品型号设计,是为了给将来的新传感器留出位置。
这也是灵波一直强调的具身原生:从机器人在物理世界中如何感知、如何动手出发,来决定模型怎么设计、用什么数据训练。
目前,LingBot-Touch已经与LingBot-VLA、LingBot-Depth完成融合,用来提升通用大脑的手眼协同和精细操作能力。
在落地方面,灵波也正与乐聚、钛虎等本体伙伴,以及国大药房、隆盛等场景伙伴,在零售分拣、物流分拣和工业场景中开展商业化测试。
大模型越强,具身原生越不能缺席
聊完LingBot-Touch本身,我们再把视角拉远一点。
今年9月GPT-6 Astra发布之后,RoboDojo团队让它在零样本条件下跑了42项仿真操作任务,结果它的综合得分在43个参评条目中排到了第一。
说实话,这一度让具身圈有点慌。
但在同一份报告里,还有另一组数字:GPT-6 Astra在精度维度的成功率只有4%,而表现最好的公开策略是20.42%;插管、搭塔这类需要精确接触的任务,它几乎全军覆没,真机测试也因安全问题被叫停。
报告把这一差距归结为缺乏物理常识,也就是对接触、力和碰撞的理解。
而就在今天,Anthropic又发布了Claude Fable 5.2,大模型控制机器人的进度条又往前推了一步。
据Anthropic官方博客公布的内部测试结果,Fable 5.2在RoboDojo仿真测试中的平均成功率达到64.9%,是同一套测试框架下GPT-6 Astra(29.8%)的两倍多,也超过了大多数专为控制机器人打造的AI系统。
官方放出的演示中,由Fable 5.2控制的机器人还能解魔方、拧瓶盖、画画。不过,RoboDojo考察的,是看着摄像头画面去控制一台仿真的双臂机器人。