
NaiveAI 有望登顶 Artificial Analysis 的速度排行榜。我们的实测表明,其代码编写质量可与 DeepSeek 相媲美。
11月10日 · 阅读时长 10 分钟
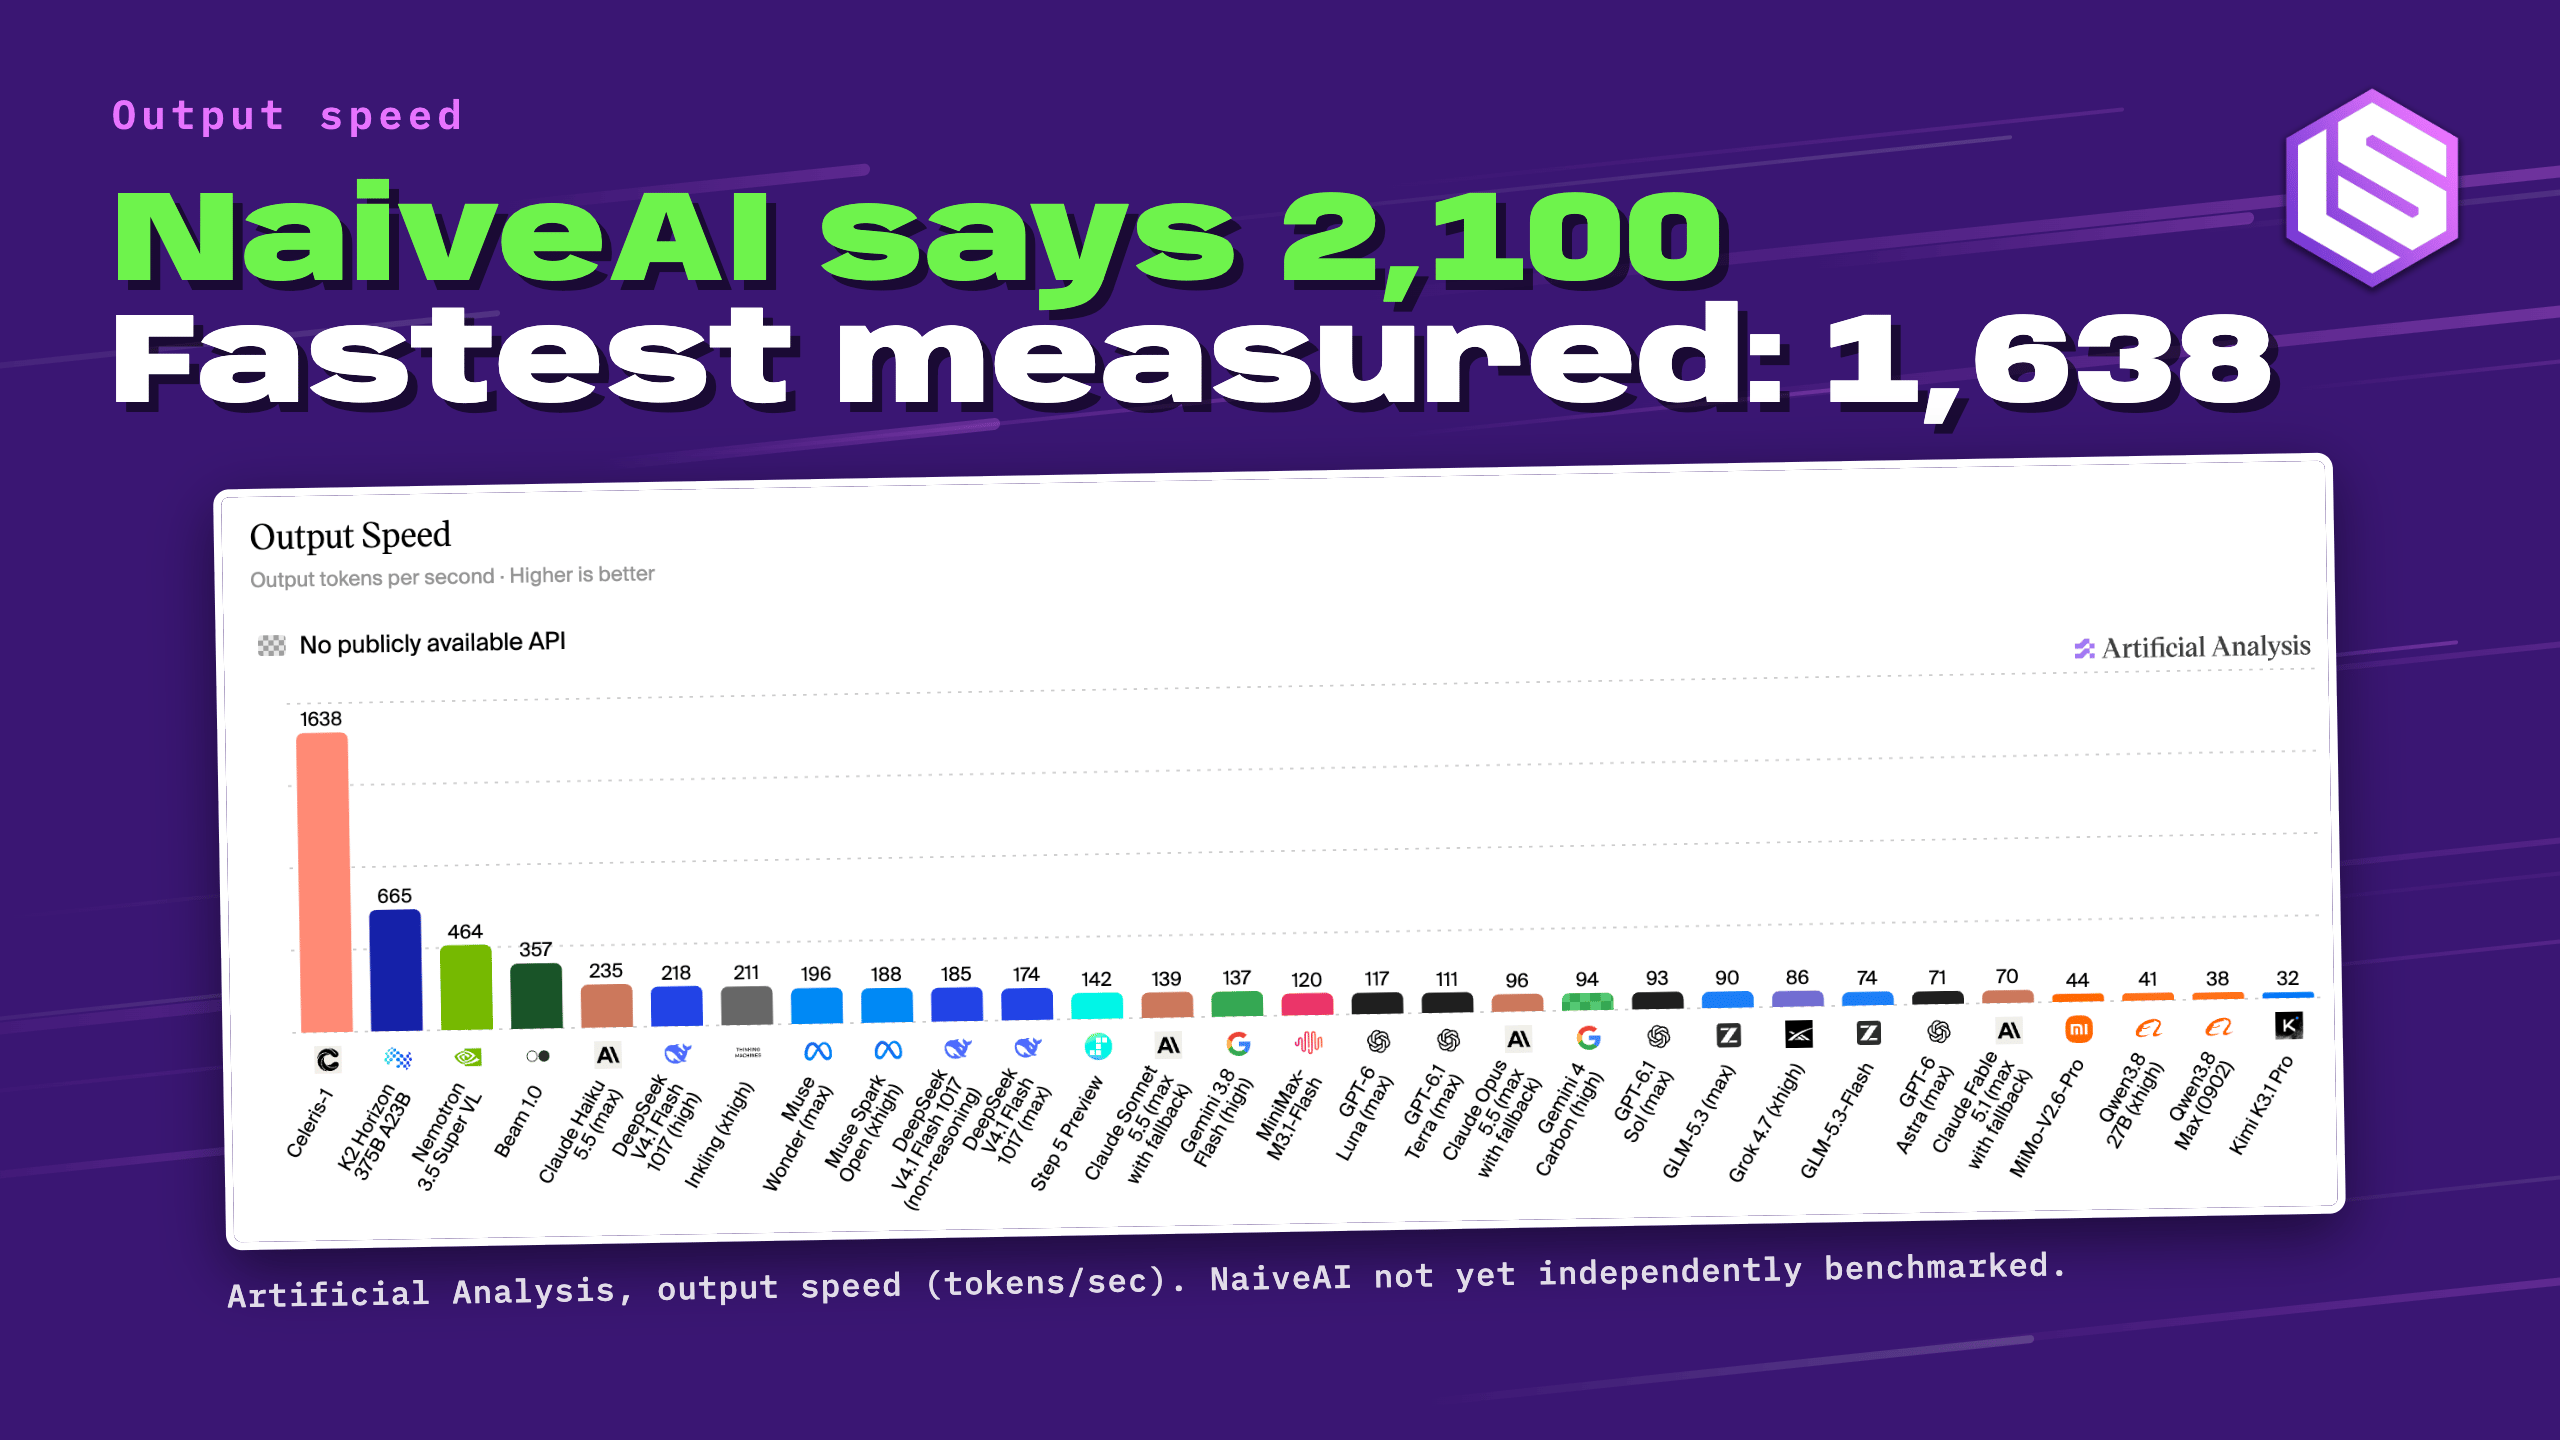
编者按:借由本文,我们正式推出一个全新的系列,专注于试用新模型和新产品并提供客观评测。欢迎将建议发送至 tips@latent.space。
Naive-N0.5-Flash 是一款全新的开放权重模型(open-weights model),专为 AI 编程任务打造,并针对每秒生成尽可能多的 Token 进行了调优。该模型由一家名为 NaiveAI 的中国公司开发,旨在加速工程和研究工作流,让团队能够更快地进行实验、迭代并解决复杂问题。
该模型由小米的 MiMo-V2.5 演进而来,NaiveAI 对其进行了进一步的长上下文推理训练,并配以自研的 NaiveRT 推理引擎。Naive-N0.5-Flash 提出了一个大胆的宣传理念:一个很大程度上由 AI 构建、并被训练用于亲自进行 AI 研究的模型,其长期目标是实现递归自我改进(recursive self-improvement)。
为了看清它有哪些改变,了解它的起点会很有帮助。MiMo-V2.5 是一个总参数量 310B、激活参数量 15B 的稀疏混合专家(MoE)模型,在 48T Token 上进行了训练。其语言主干网络继承了 MiMo-V2-Flash 的混合架构设计,将滑动窗口注意力(SWA)与全局自注意力机制相结合。
NaiveAI 的技术方案正是从这些权重起步的。通过持续的多阶段训练,该团队将模型检查点(checkpoint)适配到了 DeepSeek 稀疏注意力(DeepSeek Sparse Attention)层。根据 NaiveAI 技术博客的介绍,这在 MiMo 原本 48T 的基础上额外消耗了大约 3.25T 的 Token。 在这些新增的 Token 中,约有 3T 是在固定的 1M 上下文长度和恒定学习率下完成训练的。
基准测试:NaiveAI 对阵 DeepSeek 与 Z.ai
我们将 Naive-N0.5-Flash 的极速模式(ultrafast mode) 与 DeepSeek V4.1 Flash 1017 和 GLM 5.3 Flash 进行了基准测试对比,随后向这三个模型输入了相同的应用构建提示词(prompt)。
我们发现其中的权衡在于:在面对更难的问题时,Naive-N0.5-Flash 需要消耗更长的推理过程,但总体而言,它交付最终答案的速度仍然更快。 不过,这会导致单次提问的成本略高——尽管对于那些将速度放在首位的应用场景来说,这个代价可能是完全可以接受的。
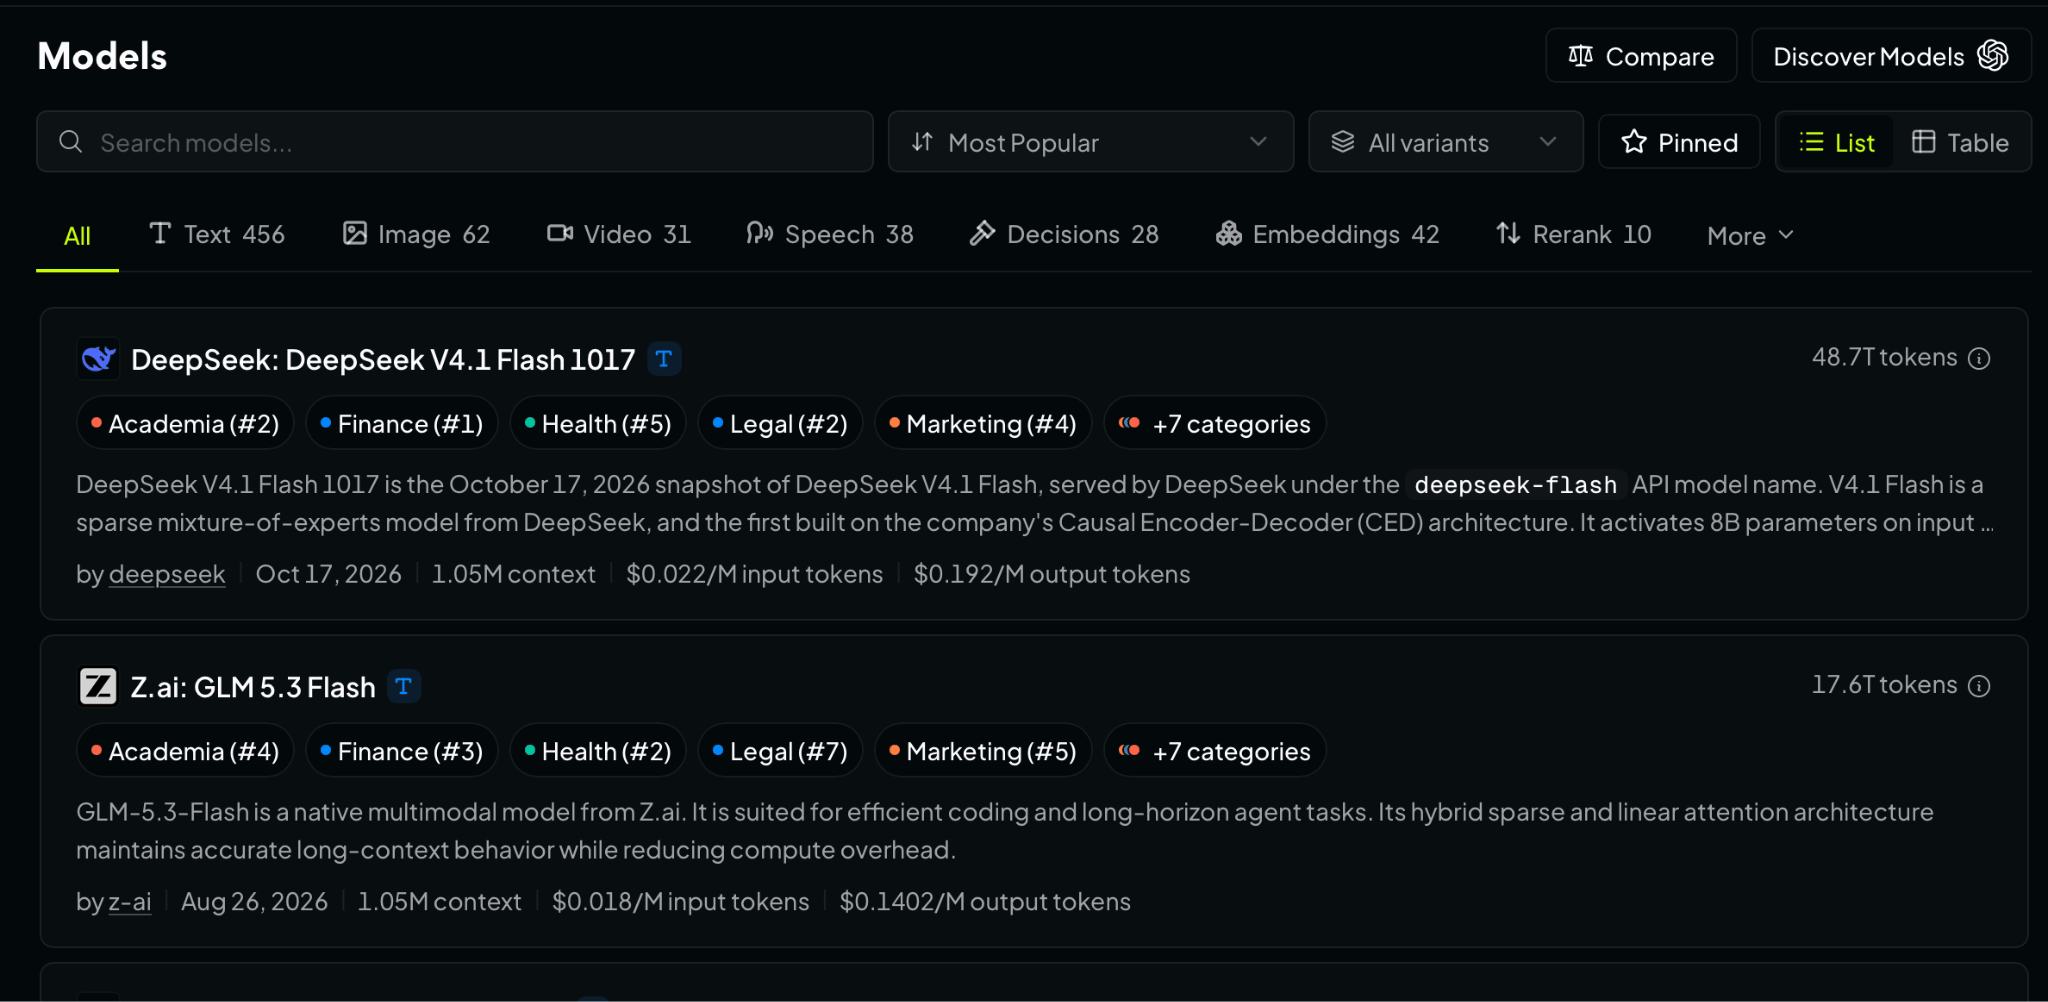
截至 2026 年 10 月底 OpenRouter 上最受欢迎的模型。
DeepSeek V4.1 Flash 1017 和 GLM 5.3 Flash 是 OpenRouter 上最受欢迎的两个模型。两者均属于 Flash 级别模型,并在 AI 辅助编程方面展现出了卓越的能力。
截至撰稿时,Artificial Analysis 上尚未提供 NaiveAI 模型的性能统计数据。因此,我们在此列出本次对比中所用模型的智能指数(Intelligence Index)得分: