
Worker不够了,主管Agent还能自己招!
文婷 发自 凹非寺
量子位 | 公众号 QbitAI
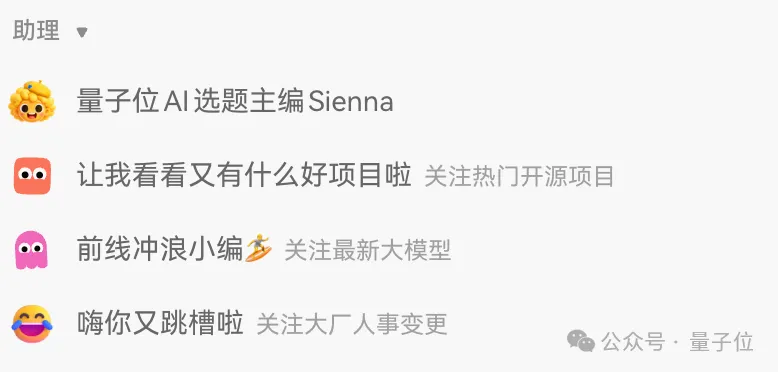
一位 AI 主编领着三位 AI 小编,分别紧盯前沿大模型、开源项目和大厂人事。
我把选题需求往主编 Agent Sienna 手里一塞,它转头便开始拆解任务,分发、催收、汇总一气呵成。
不到 8 分钟,它就端来了 6 条新鲜出炉的 AI 选题:
不是,我茶都还没泡开呢,一天的选题工作就这么搞定了?!
早在半年前,LobeHub 团队就开始用自家的 AI 协作平台搞研发,让 Agent 参与派发任务、编写代码,甚至排查 Bug。
如今,AI 已经成为 LobeHub 团队研发流程里的常驻成员。
在 FrontierHarness 的 30 道软件工程任务中,其优化后的 Agent Harness 配合 Kimi K3 完成了 21 道,通过率达 70%,单项成功任务的成本中位数为 1.68 美元(约合 11.21 元人民币),超越了 Codex 和 Claude Code。
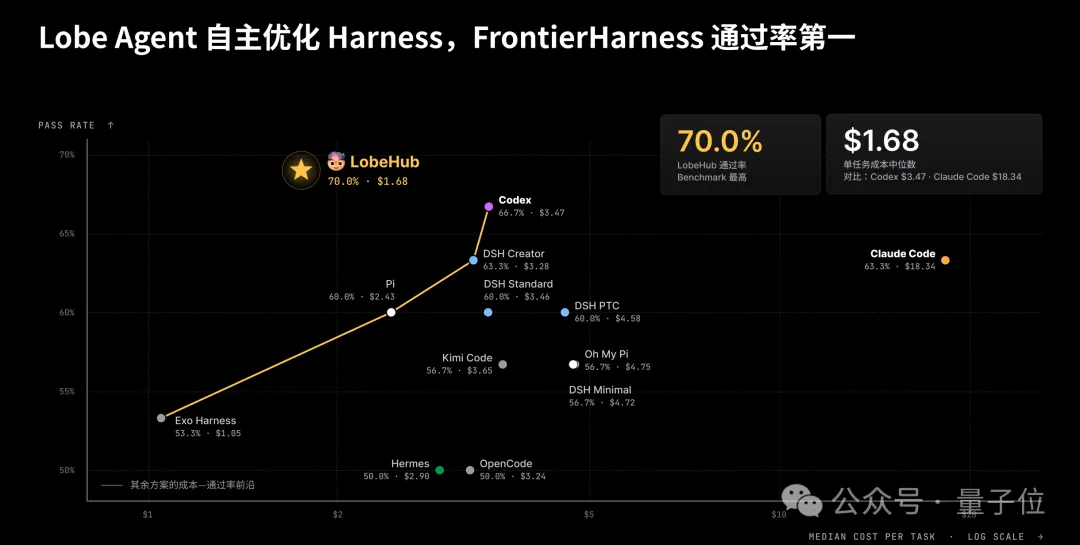
真没想到,DeepSeek 最近还在探索 Super-Agent 架构,而 LobeHub 早在 5 月份就已经把类似的人机协同思路做成了产品,甚至直接开源!
如今,LobeHub 团队已将这套协作方式融入日常研发,由 Agent 自主拆解任务、派活、编写代码,并协助审查与修改。
在 GitHub 上,LobeHub 目前已斩获 8.44 万 Star。
那么,LobeHub 究竟是如何让 Agent 从单打独斗走向团队协同的?默契度究竟怎样?它又能将实际工作推进到哪一步?
AI 开发 AI,LobeHub 开发自己
AI 给 AI 派活,AI 给 AI 审代码。
这样的协作场景,早已成为 LobeHub 研发团队的日常。
以 10 月 28 日提交的一项开发任务为例:
当时,团队希望为任务工具和命令行界面补上一项新功能,允许 Agent 在创建任务时直接指定所调用的模型。
于是,他们把这项任务交给了主管 Agent Nasa。
接到需求后,Nasa 迅速创建了编号为 T-1149 的任务,并指派给对应的 Coding Agent Dario。
Dario 接单后立刻投入编码。从功能实现、补充测试到验证运行结果,一气呵成,最终顺利提交了一份标准的 Pull Request(编号 #21852)。
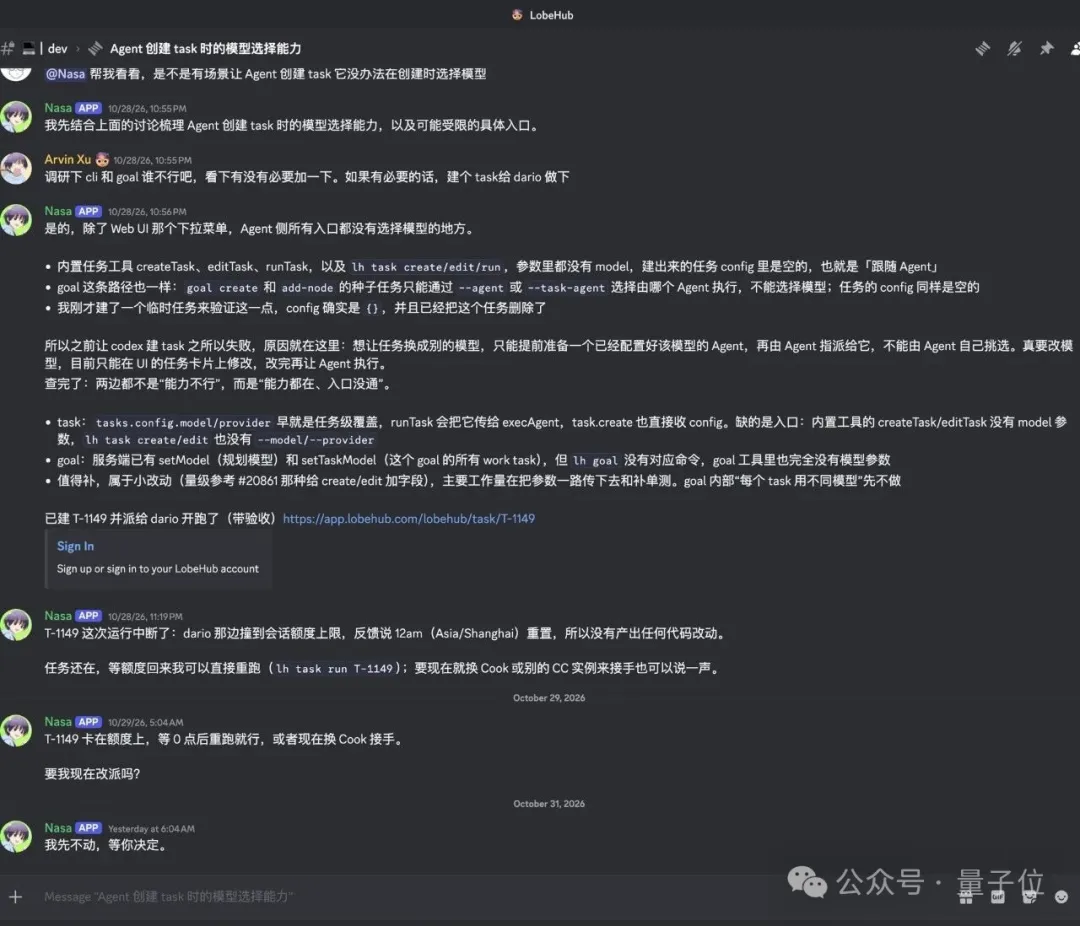
△ Nasa 派活记录、Dario 提交 PR
但流程并未就此结束。
代码刚提交,另一位 AI 同事便前来“把关”——这次出场的是 OpenAI 的 Codex 代码审查机器人。
Codex 对新提交的代码展开细致审查,很快指出了几处需要优化的缺陷。
Dario 旋即跟进,根据审查意见修改代码并补充测试用例,随后重新提交。
就这样,Codex 和 Dario 宛如现实中的软件工程师与 Code Reviewer,一个负责编写,一个负责挑刺,来回迭代打磨了数轮。
最终,这份 PR 顺利通过人工审阅并合并进 LobeHub 代码主干,一条完整的全自主 AI 研发协作链成功跑通。
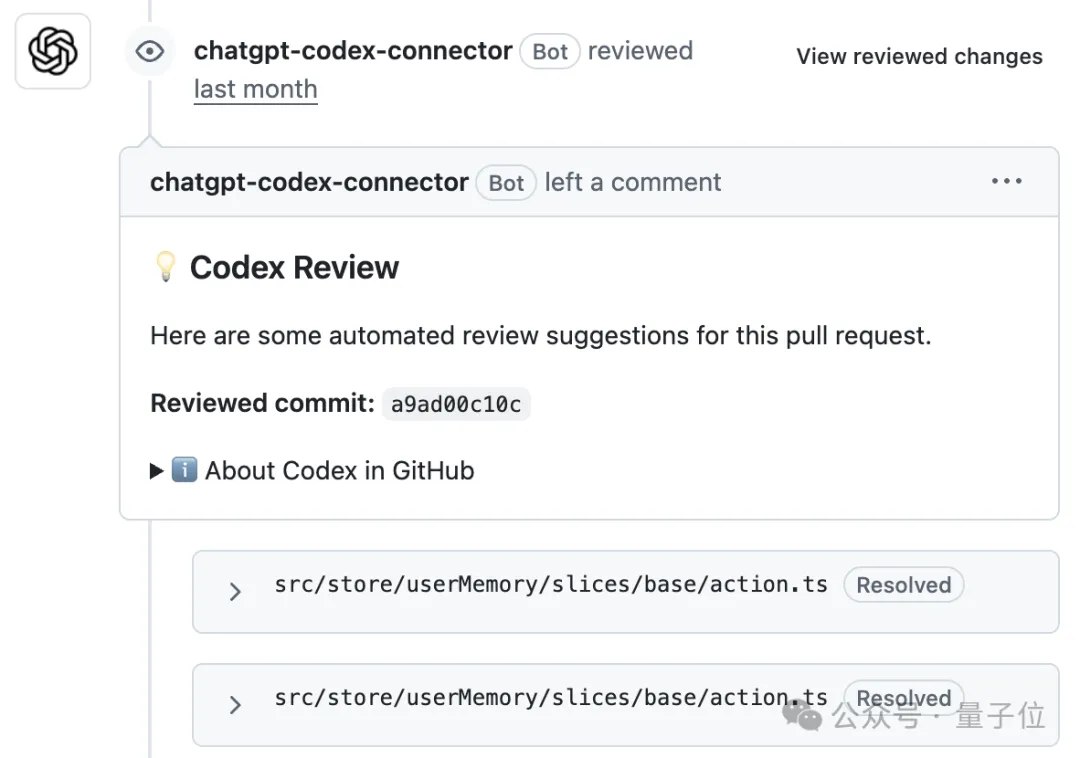
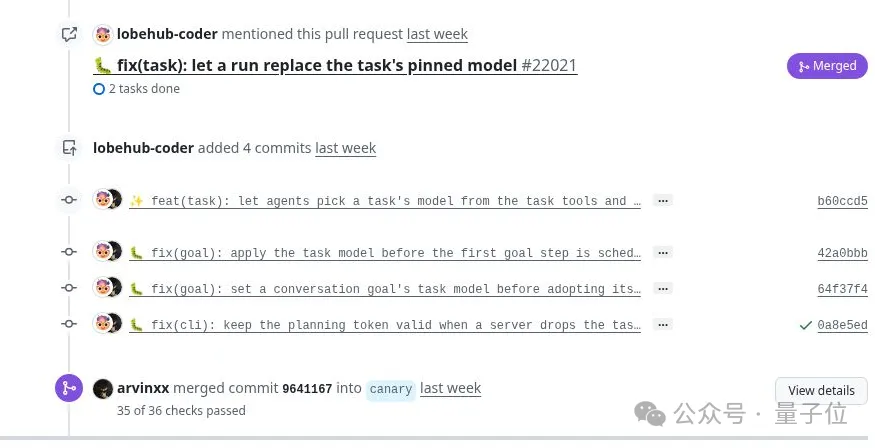
△ Codex 审查意见、Dario 修改记录及 PR 合并状态
更有意思的是,LobeHub 的 Agent 已经不再局限于单一项目内的单兵作战,开始主动跨项目联动其他 AI 协同解决问题。
例如,当 Agent-foundry 项目需要 lobe-ui 组件库增加自定义中性色支持时,若按传统流程,必须经过两端开发者繁琐的需求对齐、排期修改与版本通知。
而在这次实践中,两个项目的 Agent 直接自主完成了对接。
一方提出接口需求,另一方跟进代码修改。随着 lobe-ui 6.0.1 版本的发布,上游项目也同步收到了依赖更新通知,无缝集成了新功能。
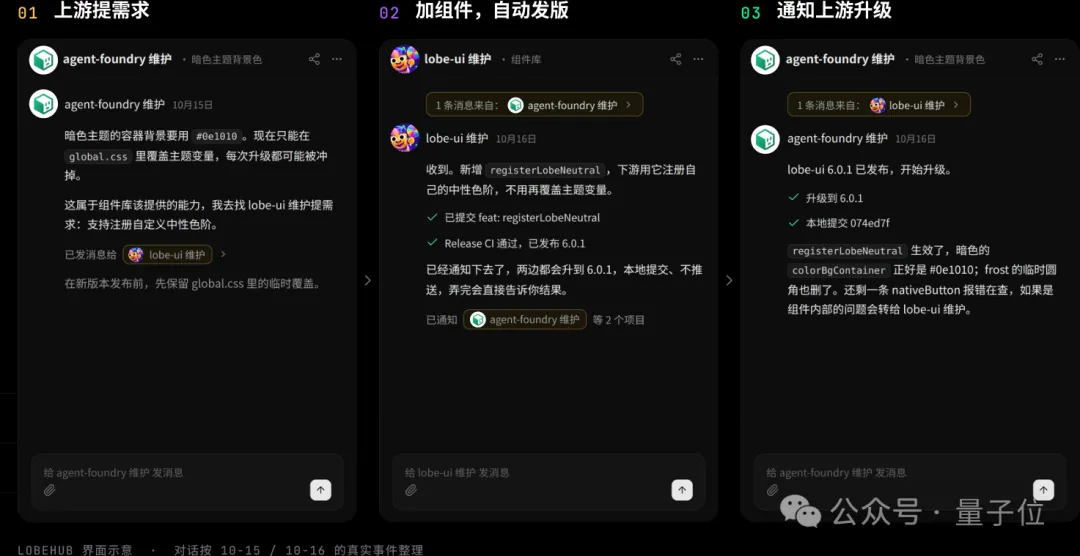
△ 跨项目 Agent 沟通记录与组件发布记录
过去需要人类在不同仓库间充当传声筒,现在 Agent 自行打通了上下游链路。
LobeHub 团队也切实享受到了效率红利。据团队一位研发成员透露,他已有整整三个月未在本地启动过开发服务器(Dev Server)。按照其实际体感,采用这套协作模式后,综合研发效率提升了约 3 至 5 倍。
自己打造的 AI,反哺自身的系统迭代,甚至还能跨项目调度协调其他智能体,有效消除了上下游协同中的沟通损耗。
那么问题来了:
如果把这套系统交到科技媒体编辑手中,又会碰撞出怎样的火花?
我决定用 LobeHub 亲自组建一个 AI 编辑部!
为了验证这套协同机制在软件工程之外的跨场景泛化能力,我基于熟悉的科技采编工作流,搭建了一支 AI 编辑小队,并给它们安排了两轮实战测试:
- 第一轮:由 AI 主编统筹小编挖掘选题,整理并交付一份完整的选题简报;
- 第二轮:将交付的简报成果作为输入,直接流转至下一环节,驱动 Agent 生成一个动态热点资讯网页。
实测正式开始。
实测一:让 AI 当一次量子位主编
首先,我在 LobeHub 中搭建了一支微型采编团队:
选题主编 Sienna 负责把控全局与任务编排,麾下配备三位各具特长的小编:
- Gemini 4 Argon:紧盯科技大厂人事异动与高管变迁;
- Claude:化身开源“星探”,深挖 GitHub 社区的高潜项目;
- DeepSeek:聚焦技术前沿,跟踪头部大模型的重磅发布与迭代。
就绪后,我向 Sienna 下达了需求提示词:
请从“人事变动”、“新模型发布”与“开源新项目”三个维度,各发掘 2 条具有报道价值的最新动态。
目标读者为常年关注大模型、具身智能等前沿科技的专业受众,习惯每日花费 5-10 分钟快速获取行业高价值信息。
选题须兼顾时效性与信息密度,拒绝泛泛而谈、基础科普与纯公关软文。
每个方向精选 2 条,共计 6 条。 每条须包含:候选标题、消息日期、核心事实、推荐理由及可验证的一手信源链接。
指令发出后,我便完全退出了流程干预。
Sienna 迅速将大目标解构为三组子任务,分派给对应的 AI 小编并并行推进。
令人惊喜的是,耗时不到 8 分钟,三位 AI 小编便带着结构化的选题与信源链接陆续回传给主编。
更为亮眼的是 Sienna 的质控把关能力。
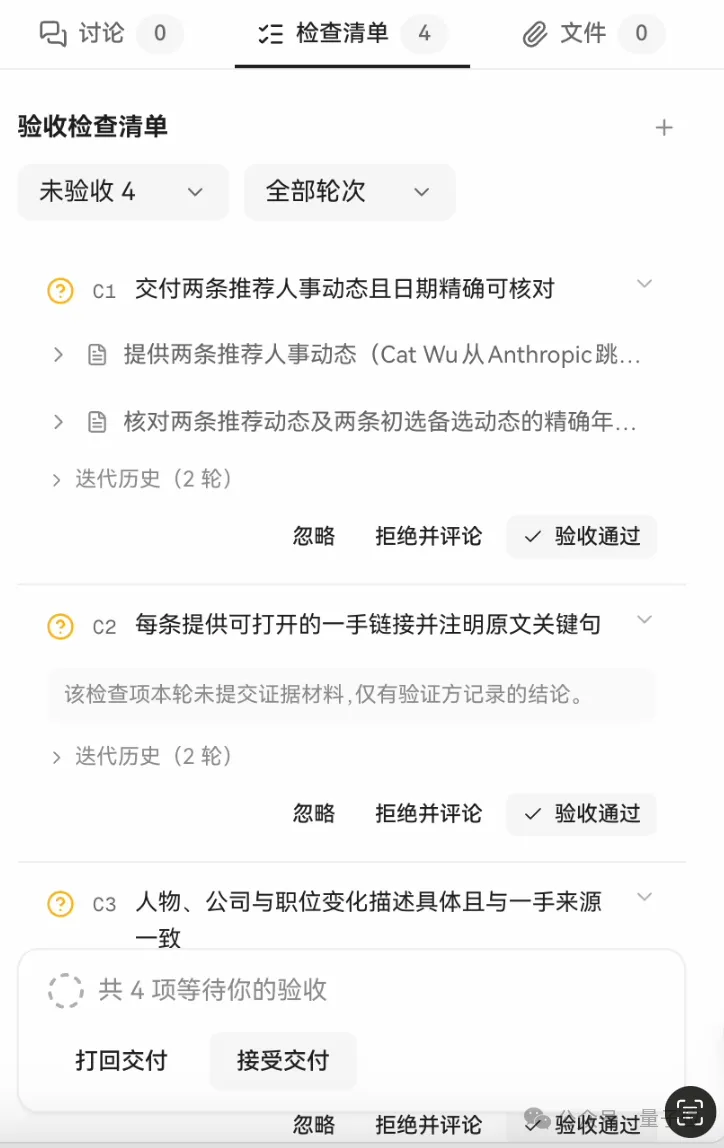
面对各方汇报,Sienna 并未机械整合,而是逐条进行了标准核验。对于信源层级模糊、缺乏一手链接的条目,它自动生成了验收缺陷清单,在获得我的确认后,直接向相关 Agent 下达返工指令:“信源标准不合规,重新检索!”
最终交付的任务看板令人眼前一亮:
一份包含 6 条最新前沿动态的选题简报 规范列出,候选标题、时间戳、核心事实、推荐逻辑与一手信源一应俱全。更附带了三位小编的任务执行回执,标明了建议人工二次核实的关键节点。
简报交付后,我临时追问了负责追踪人事动态的 Agent 一句:
“Tibo 最近到底去哪了?怎么还没发动态?”
该 Agent 并未出现“幻觉”或询问 Tibo 是谁,而是顺着上下文脉络快速检索,条理分明地列出了 Tibo 的调岗周期与公开轨迹。甚至主动提出了选题角度建议:
“建议将 Tibo 与近期加盟其团队的 Cat Wu 联合报道,传播效果会更佳。”
不仅能派活、审核、汇总,还能承接偶发追问,并依据行业属性主动提供策划分支建议——这批 AI 协同成员已具备相当程度的业务理解能力。
实测二:刚交完简报,下一棒网页已经接上了,甚至还能现场“招人”
收下选题简报后,我向 Sienna 提出了进阶需求:
将刚才产出的选题简报,直接开发为一个支持筛选、搜索且可跳转一手信源的动态热点资讯网页;同时严格限制:禁止重新联网抓取,必须完全继承上一阶段的采编成果。
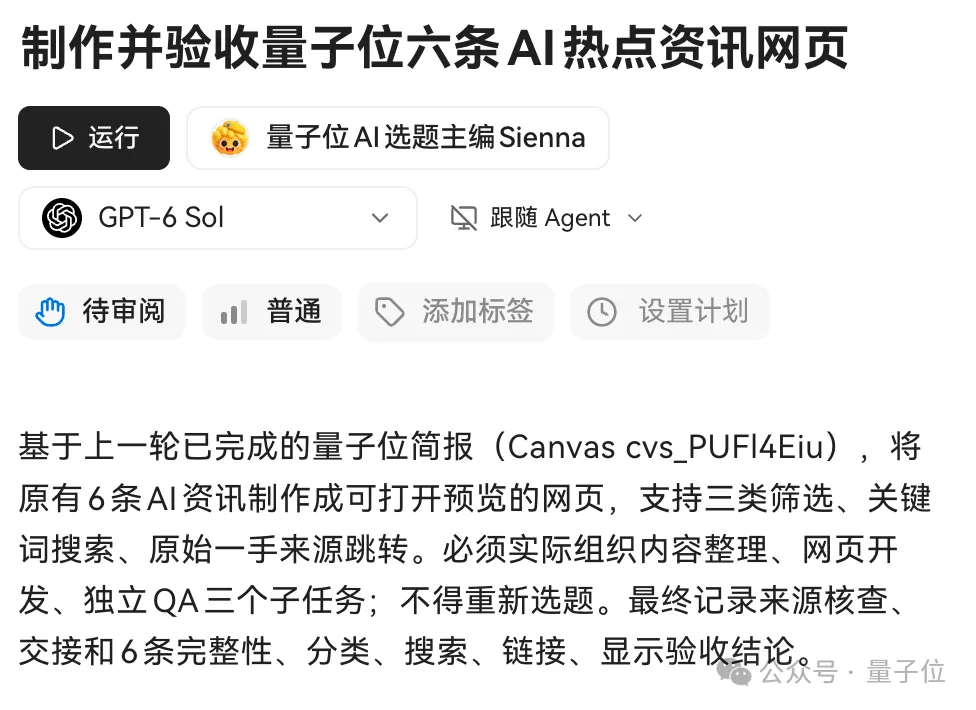
本以为 Sienna 会沿用现有的人事与技术采编 Agent 继续执行,但它的任务调度逻辑出乎意料:
经内部评估,它判定当前编辑类 Agent 的技能栈与前端工程并不匹配。
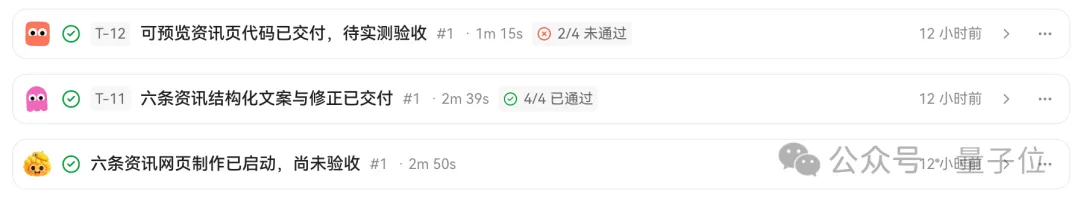
现有人员能力不匹配?那就现场动态生成对应角色!
在任务启动约 10 分钟内,Sienna 自行实例化了两位新 Worker:
- “量子位简报网页开发”:专职负责前端逻辑与页面实现;
- “量子位网页独立QA”:专职负责产出物的质量验证与验收。
新创建的 Worker 直接挂载了前一轮输出的 6 条结构化选题,分工推进文案对齐、网页构建与 QA 质检,无需人类用户重新输入上下文上下文。
很快,结构化前端配置先行落地并通过了 4 项预检;开发 Worker 随即产出页面代码,QA Agent 则同步指出两处渲染与响应式缺陷;开发 Worker 迅速根据反馈完成针对性修复。
最终,一个具备搜索筛选功能的资讯热点看板顺利生成,全流程耗时约 30 分钟。
Sienna 展现出了根据任务目标动态调配组织架构、自主判断技能缺口并完成上下文传承的能力;人类用户在整个过程中仅需承担关键节点的确认裁决。
电脑关了,这群 Agent 为什么还能接着干?
为什么动态创建的 Worker 能够无缝复用上一环节的上下文与数据?
核心在于 LobeHub 构建的统一共享工作空间(Shared Workspace)。
系统将顶层目标、任务进度、产出物文件以及验收日志统一纳入状态管理。主管 Agent 能够围绕已有资产编排后续链路,接替任务的 Worker 亦能精确获知当前工序的上下文输入与交付规范,从而避免了跨环节传递中的信息断层。
那么,具备派活、动态招募、跨项目流转能力的协同架构底层是如何运作的?
其底层核心机制主要包含三部分:
首先,将 Agent 的生命周期从单次会话窗口中解耦。
LobeHub 将负责持续任务推理的 Agent Loop、承载会话上下文的 Session,以及工具调用的执行沙箱进行了分层解耦。即使终端用户关闭了网页界面,Agent 任务也无需中断。只要处于可执行的持久化运行时中,系统便能在后台持续推进状态树并妥善归档成果。
在 LobeHub 团队进行的一项客户端数据迁移测试中,Agent 协同集群曾实现不间断运行 2 天 3 小时 47 分钟,期间自动拆分衍生出 60 个子任务,独立完成 56 次数据迁移操作。
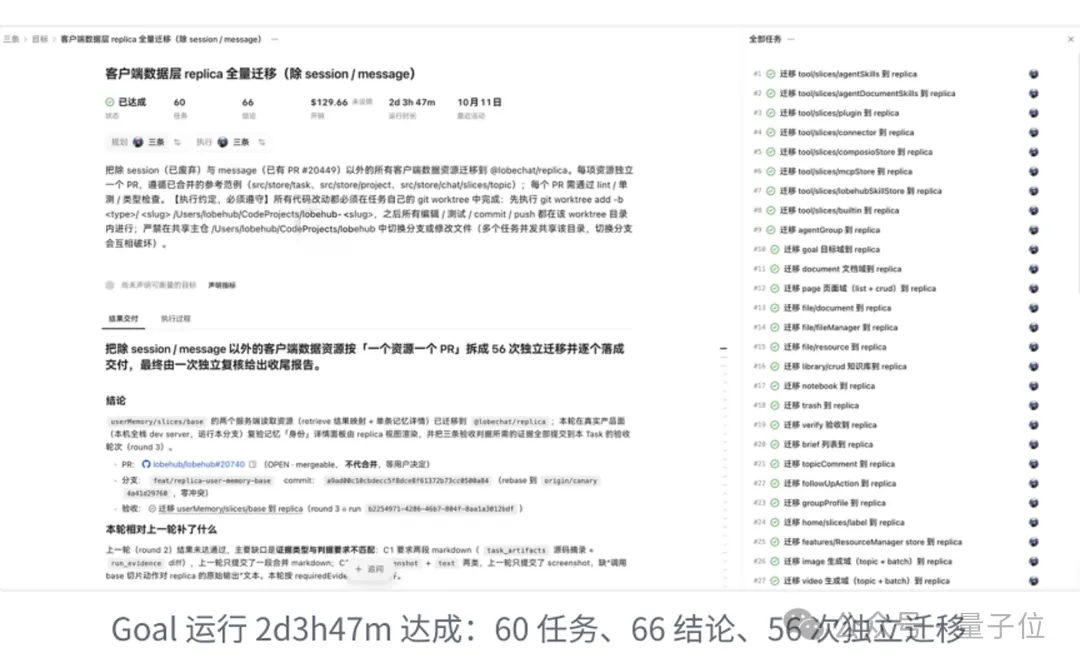
△ 长期 Goal 执行记录
其次,依托统一状态树保障多智能体接力协同。
通过将工作目标、执行进度和中间交付物结构化映射,使下游 Agent 能够无缝衔接上游输出,从而稳定支持从“采编选题简报”到“一键构建热点应用”的多阶段复合流水线。
最后,引入 Acceptance 多模态自动化验收体系。
在交付环节,Agent 除了输出代码或文本结果,还会自动附带端到端测试用例、界面截图、运行录屏等多模态验证物证。
人类监督者可在可视化界面直观评估实际效果,遇有缺陷可直接批注打回重构,达到质量指标后再行签发合流。在第二轮实测中,网页代码必须完全通过预置的各项校验项才被标记为交付,确保在 Agent 高频自主迭代的同时,人类始终掌控最终验收与决策的控制权(Human-in-the-loop)。
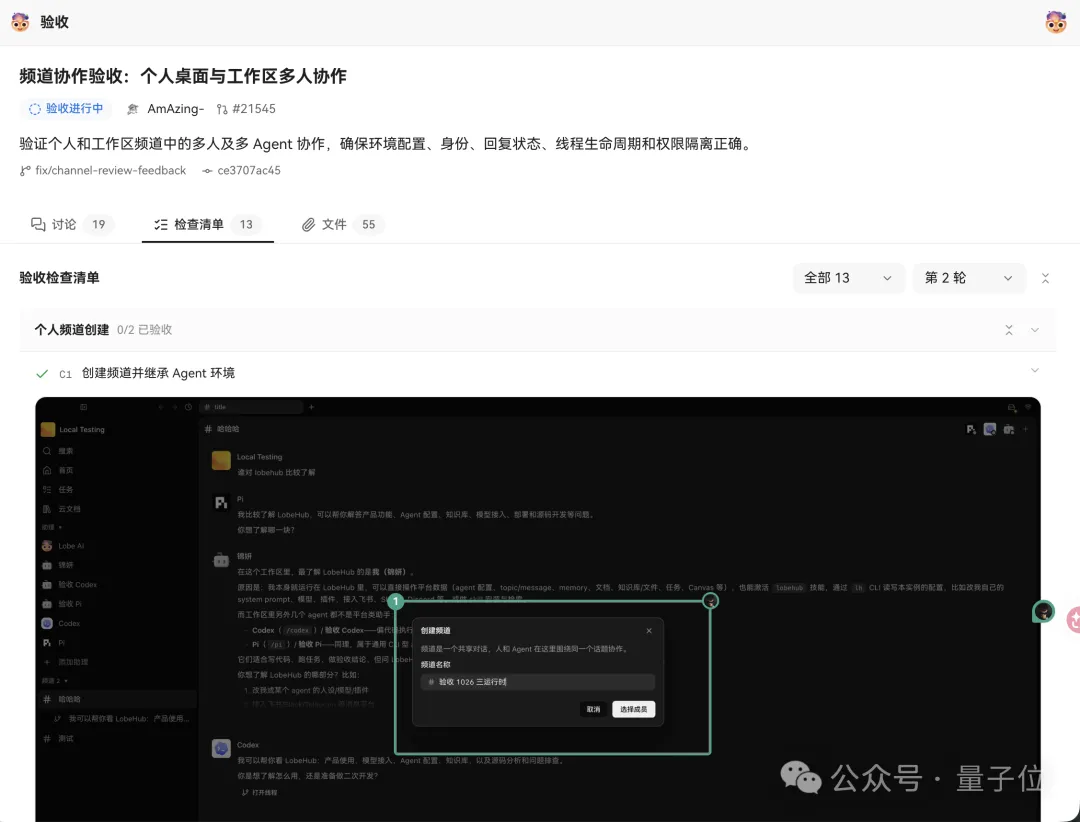
△ Acceptance 验收机制
至此,一套兼顾自主协同与严格质控的 Multi-Agent 工作流形成了闭环。
从 LobeChat 到 LobeHub,他们一步步把 AI 嵌进公司
LobeHub 的多智能体协作能力并非一蹴而就。
2023 年,团队开源了 AI 对话客户端 LobeChat;随后逐步接入工具调用(Tool Calling)、外部知识库检索与 Agent 工作流插件,驱动大模型走出单纯的聊天框。
2026 年 1 月,LobeHub 2.0 正式上线 Agent Group(多智能体集群)与长短期记忆机制(Memory),推动单体交互迈向群体协作;
同年 5 月,系统引入了 CAO(Chief Agent Officer,首席智能体运营官) 编排调度能力,将目标拆解、人员编排与跨实体协作交由 AI 主管自主决断。
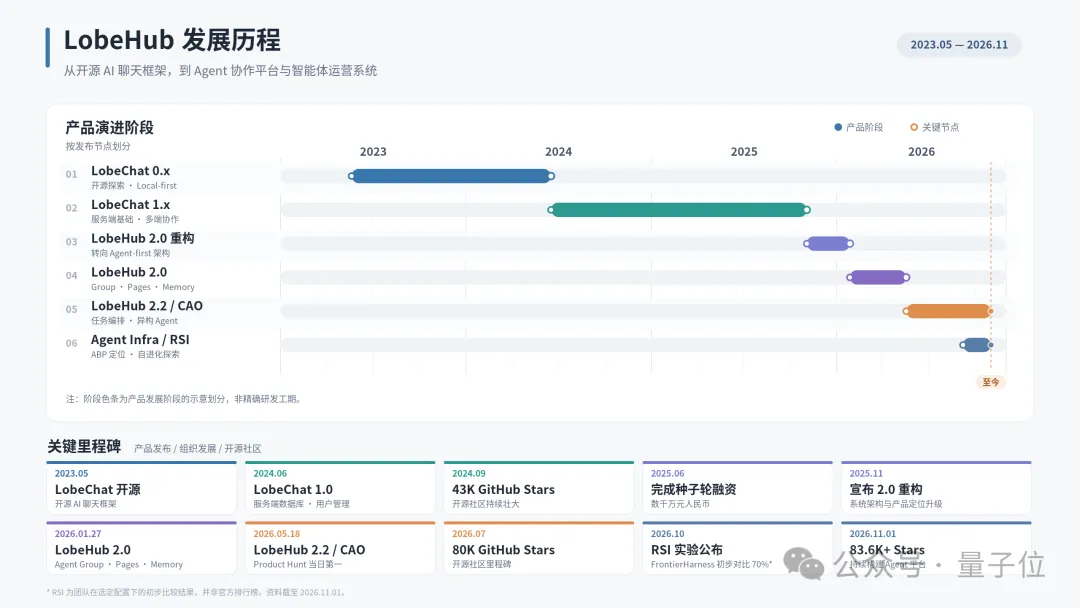
这种架构思路与近期行业探讨的 DeepSeek Super-Agent 体系 形成了趋势上的共振。而 LobeHub 在半年前便将人机协同原型落地为产品并全面开源,为开发者提供了可自部署的工程样板。
更具参考价值的是该团队在组织维度的自我迭代:构建自己的 Agent 系统,用其反向支撑自身工程演进,从编写测试、审阅 PR 到支撑跨仓库接力,真正融入生产环境。
面向未来,LobeHub 提出了 Self-Driving Organizations(自驱动组织) 的演进愿景。
按照其定义的 L1 至 L5 自动化梯度,其研发中枢目前已全面步入 L3 协作阶段,并正向具备自主派活、跨域接力、闭环验收特性的 L4 级自治业务形态稳步迈进。