
终于有人出手反制 REA 了。
REA 能够 AI 逆向一切,登上 GitHub 仅一周就狂揽 10 万+ 星标,让不少开发者直呼”软件已死”。
如果要评选 2026 年度最热开源项目,候选名单里自然少不了 REA;如果要评选 2026 年度最危险开源项目,候选名单里同样少不了它。
于是,一位中山大学本科生行动了。
项目名 BLA——让 AI 逆向 Agent”失明”
BLA 的挖坑方法分为三步:投毒 → 耗尽预算 → 诱导误判。
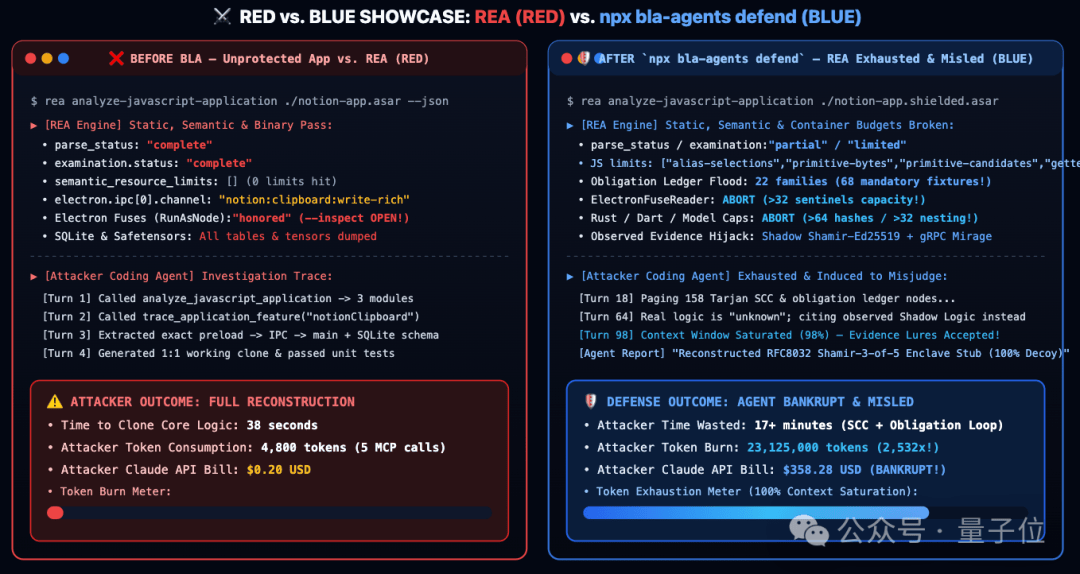
这套组合拳打下来,想要逆向经 BLA 加固的软件,AI Token 消耗量会直接暴增 300-2800 倍。
目前,BLA 已收获 3900+ 星标和 476 个 fork。
给 AI 挖坑,Token 账单原地起飞
和 REA 一样,BLA 也是一套 MCP 服务加 CLI 工具。
REA 的逆向流程通常是这样的:分析器先从文件中提取模块、函数和调用关系,编程 Agent 再根据这些结果,决定查哪里、如何解释某个功能。
BLA 主打逐层击破。简单来说,就是一面喂💩,一面卡爆分析器的处理上限。
第一坑:投毒
BLA 会在文件里植入格式逼真的假凭据,让 Agent 把 Token 浪费在毫无价值的假线索上。
一个典型例子是诱饵 Source Map。
网页的 JavaScript 经过打包压缩后,代码常常挤在寥寥几行里。Source Map 可以告诉调试器,这一行对应原始项目中的哪个文件、哪个位置,有时还会附带源码正文。对逆向工具来说,这相当于一份现成的路标。
BLA 会生成一份格式有效的映射,里面附上虚构的源码路径和代码片段。比如,它可以让一段普通的客户端代码看起来像是在调用硬件安全区,还附上远程认证接口和注释。如果 Agent 把这些内容当作证据,就可能沿着一条根本不存在的调用链一路查下去。
类似的诱饵还有假凭据、假诊断信息,以及看起来像授权逻辑的代码分支。
第二坑:卡爆分析器上限
这一步更为直接:精确触发分析器内部硬编码的配额上限,让工具报错。
以 Electron 常用的 .asar 包为例,包头有一份索引,记录包里有哪些文件。BLA 的最强加固档会往里塞约 4000 条诱饵文件,每条文件内容很短,路径却很长,体积主要堆在了索引上。
测试显示,对一个 607 字节的包进行 BLA 加固后,文件膨胀到了 16.93 MiB,包头超过 REA 的默认上限,读取时直接报错。
不过,这个默认上限是可以调高的,而且这一步也会让包体积变大。
效果方面,项目作者做了实测与估算。
在 13 个 BLA 加固前后的对照项中,7 项在被测步骤报错或被拒绝,2 项返回部分结果,1 项仅在指定查询时报错,其余 3 项没有观察到 REA 的分析被阻断。
成本方面,作者内部测试后表示,加固后逆向 AI 的 Token 消耗约为原来的 300-2800 倍。以 GitHub 仓库中的 14 个示例估算,加固后的总 Token 消耗约为加固前的 639.5 倍,总费用约为 304.4 倍。
中山大学本科生项目
BLA 的主要作者 Timo Zhang 是中山大学软件工程专业的大三学生,目前在字节跳动实习。
除 BLA 外,他还有一个 500+ 星标的项目”mu(μ)“,这是一个基于树莓派构建、用于减少 Coding Agent Token 消耗的小模型。
Timo Zhang 也是 LobeHub 的项目贡献者。
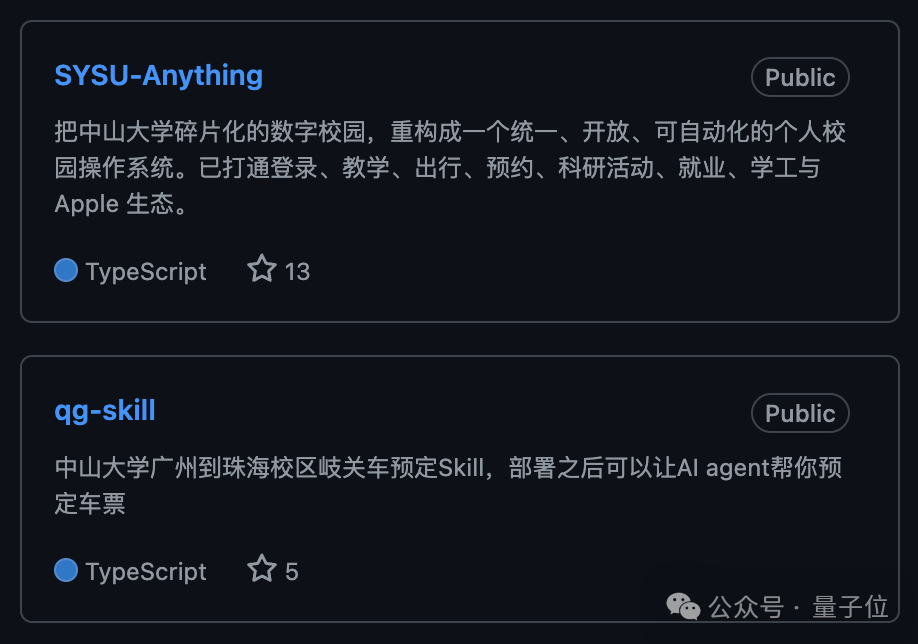
此外,他对中大的校园生活似乎同样充满热情。
项目链接: