
混合专家语言模型中的专家高阶剪枝
引言
混合专家(Mixture-of-Experts, MoE)模型使得最先进的大语言模型(LLM)得以扩展到数千亿参数,但它们也伴随着一个根本且代价高昂的问题:在推理时,每一个专家 MLP 都必须常驻显存,尽管对于任意给定的 token 而言,绝大多数专家都处于闲置状态。例如,Qwen3.5-122B 的 48 个 MoE 层中每一层都有 256 个专家,其约 250 GB 的参数显存占用中,有 95% 完全是由这些专家 MLP 单独占用的。然而,对于任意给定的 token,每层实际上仅使用了 8 个专家。
**专家剪枝(Expert pruning)**是解决这一显存瓶颈最直接的方法之一——即永久删除最不常用的专家。剪枝避免了使动态加载/卸载专家变得不切实际的延迟问题;它不需要任何训练;并且可以与量化技术结合使用。鉴于这些极具吸引力的优势以及该构想的简洁性,不难理解为什么专家剪枝已成为压缩 MoE 模型规模的首选方法。其难点在于决定移除哪些专家才是最安全的。
现有的剪枝方法是对每个专家进行独立评估,(基于校准数据集)为每个专家分配一个标量重要性分数,并剔除最不重要的专家(在每个层中独立进行)。这些属于**一阶(first-order)**方法,因为它们假设每个专家的贡献彼此独立。而在现实中,专家之间会形成协作群体。我们在自己的实验中观察到被共同激活的专家存在一致的聚类现象,独立研究也表明,专家协作是 MoE 的一种稳定特性,且对模型性能至关重要。忽略这些相互作用会导致次优的剪枝结果,尤其是在高剪枝率的情况下。
我们最新的论文推导出了 HOPE(Higher-Order Pruning of Experts,专家高阶剪枝),这是一种考虑专家成对相互作用的**二阶(second-order)**方法。在 50% 的剪枝率下,HOPE 在所有方法中取得了最佳的平均排名,在智能体编码(agentic coding)任务上相比次优的剪枝方法提升高达 +6.1%。
在本文中,我们将解释 HOPE 的工作原理,展示其在哪些方面优于现有方法,并演示如何在您自己的模型中使用它。对于不熟悉 MoE 架构的读者,请参阅 Transformers 中的混合专家(MoE)。
专家并非孤立工作
在标准 MoE 中,每一层包含 $E$ 个专家,每个输入 token $x$ 被独立路由到其中的 $K$ 个专家(通常选择 $K = 8$)。路由由单个网络层执行,该层为每个专家 $k$ 生成经 Softmax 归一化的门控权重 $g_{k}(x)$,其中门控权重最高的 $K$ 个专家被选出,构成激活专家集合 $T(x) \subset {1, \dots, E}$。该层的输出即为 $\sum_{k \in T(x)} g_{k}(x) f_{k}(x)$,其中 $f_{k}(x)$ 是专家 $k$ 对 token $x$ 的输出。
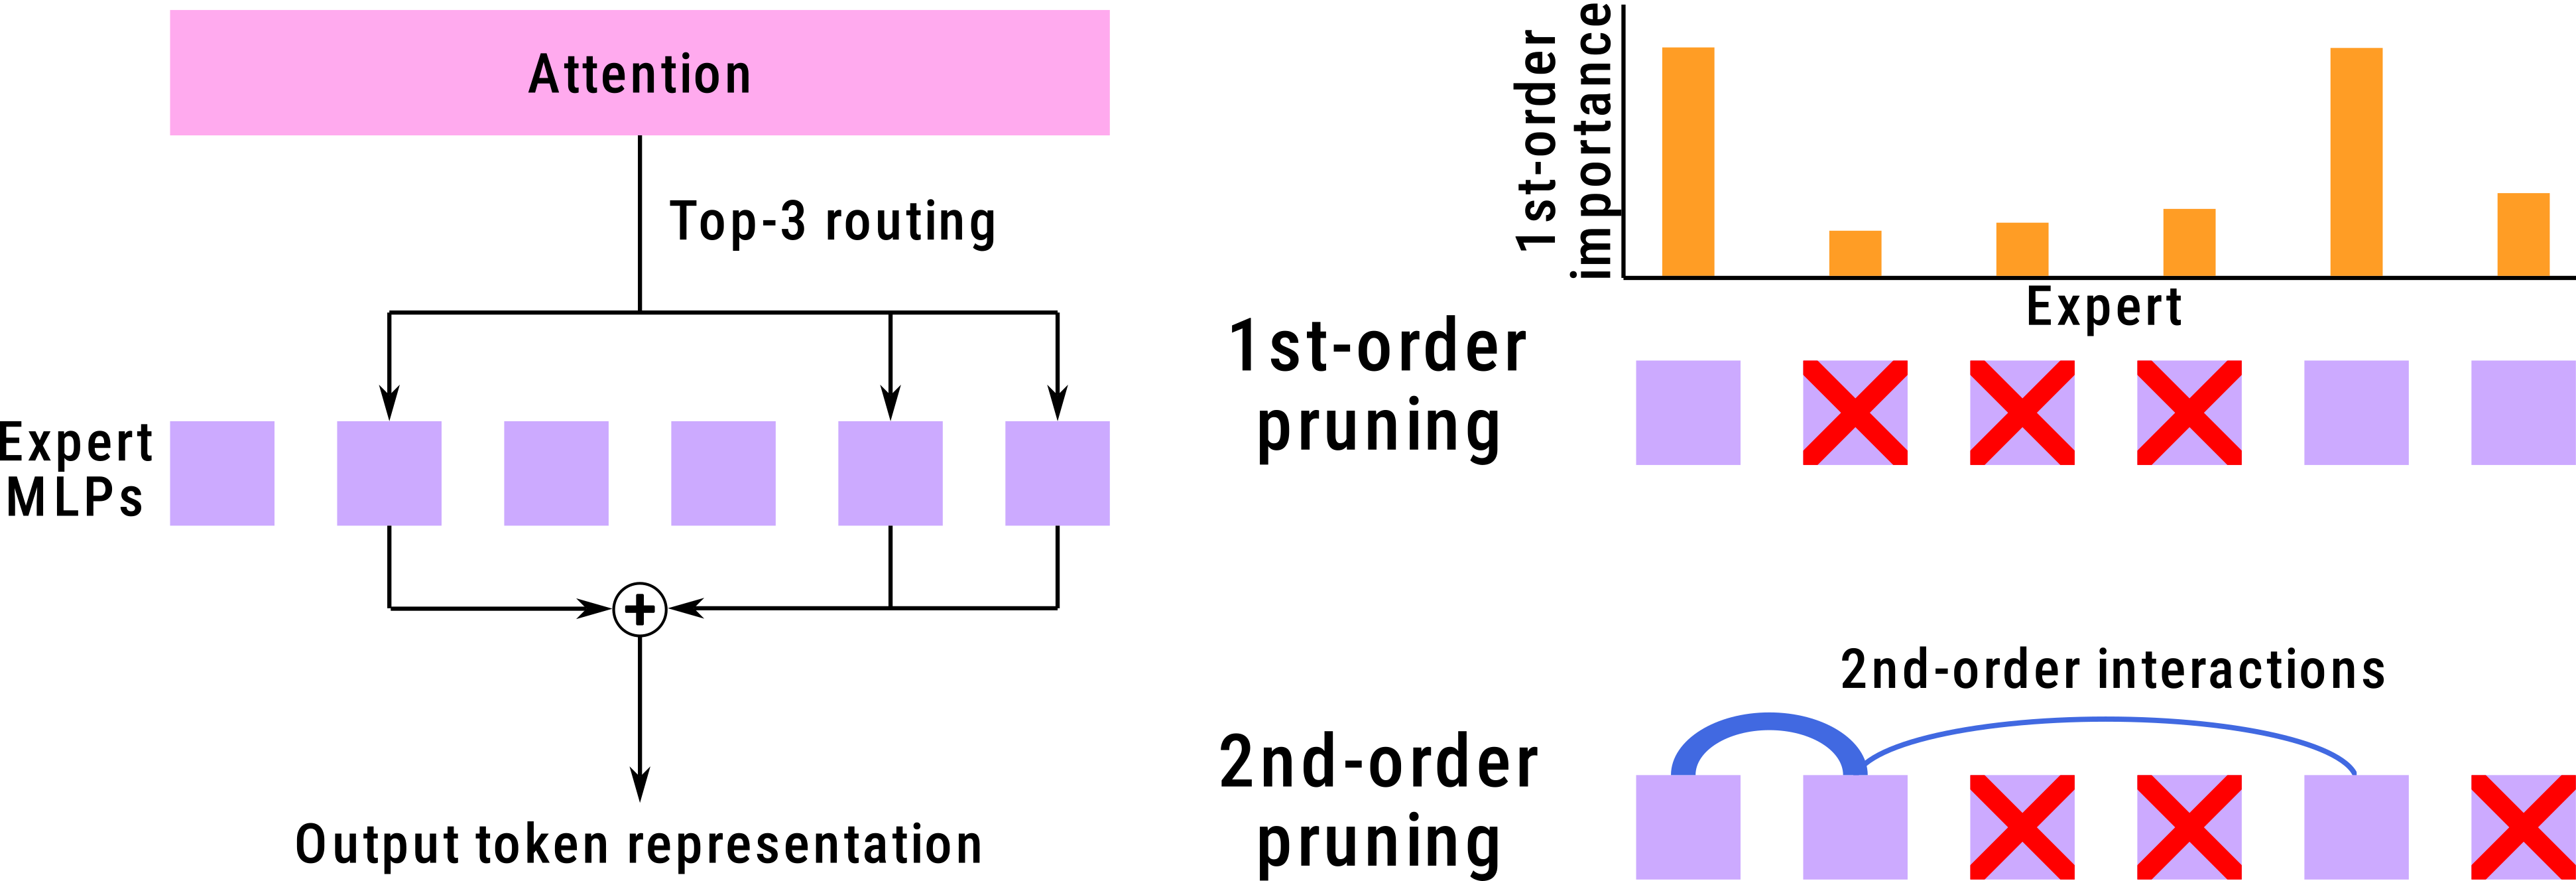
左图:典型的 MoE 层,其中每个 token 被路由到 Top-K 个专家。右图:一阶方法根据标量重要性分数对专家进行排序和删除,但最佳的剪枝决策还会考虑专家之间的相互作用强度。
重要的是,被选定集合 $T(x)$ 中的专家并非相互独立。专家会形成稳定的协作群体,并始终一起被共同激活。这在以往的文献中也已被观察到……