
RSI 不可能无限快
RSI(递归自我改进)概念当下极为火热,但它真的能让 AI 的进步速度达到无限快吗?
Jeff Dean 的判断是:并不现实。
他举了一个直观的例子:研究人员启动实验,凌晨 2 点实验结束,往往要等到早上 8 点回到工位才会去查看结果。
自动化系统确实可以消除这类空档等待,实时决定下一轮实验任务。但训练、计算、存储数据以及评估结果,这些核心步骤依然需要耗费物理时间。
要构建并持续提升基座模型,仍离不开海量的训练与实验,这些过程绝不可能以无限快的速度完成。
近期,在斯坦福 HAI(以人为本人工智能研究院)与李飞飞的对谈中,Jeff Dean 深入探讨了 RSI 的物理边界,并首次披露了他联合创立的新公司正在推进的核心业务。
整场演讲依然保持了极具 Jeff Dean 特色的极简 PPT 风格。
据他介绍,新公司 Discovery Loop 目前已有约 20 个自动改进循环在持续运行,并搭建了支持人类与 Agent 协同作业的框架体系。
他们的目标是让极少数专家协同大量 Agent 开展科学研究,从而将领域专家的生产力提升 20 到 50 倍。
为了快速组建这支核心团队,公司成立的前三周,他们便在咖啡馆等场地密集完成了 400 场面试。
谈及支撑这些演进的技术路线,Jeff Dean 也坦诚自己曾有过误判。
其中之一,便是代码生成与编程能力。
在 Gemini 项目中,编程原本只是团队重点关注的方向之一;但他此前未曾充分预料到,代码能力会如此深远地赋能并重塑模型解决各类通用复杂问题的综合能力。
此外,他曾一度预期神经网络会长出更多奇特、不规则的拓扑结构,而这一演进路线也并未完全按照他当年的构想铺展。
在探讨 AI 解决数学问题时,他高度认可机器生成形式化证明的价值,但更看重人类能否从这些机器推导的结论中,理解并提炼出可被人类复用与拓展的科学方法。
Jeff Dean 主题演讲:让 AI 自主运行实验,将专家生产力提升 20 至 50 倍
将实验循环全流程自动化
很高兴今天能在这里与大家交流。今天我想向各位介绍 Discovery Loop。
我们的使命是构建能够自主解决机器学习、科学与工程领域重大关键问题的 AI 系统。
我们坚信这能够催生更多前沿科学发现,这也是最令我们感到兴奋的愿景。
纵观众多科学学科,它们往往遵循着一个高度一致的核心研究范式——即科学与工程的通用循环:提出假设与实验设计,部署并执行实验,观测结果,评估各项指标,进而决策下一步方向;而下一步,通常就是开启新一轮迭代实验。
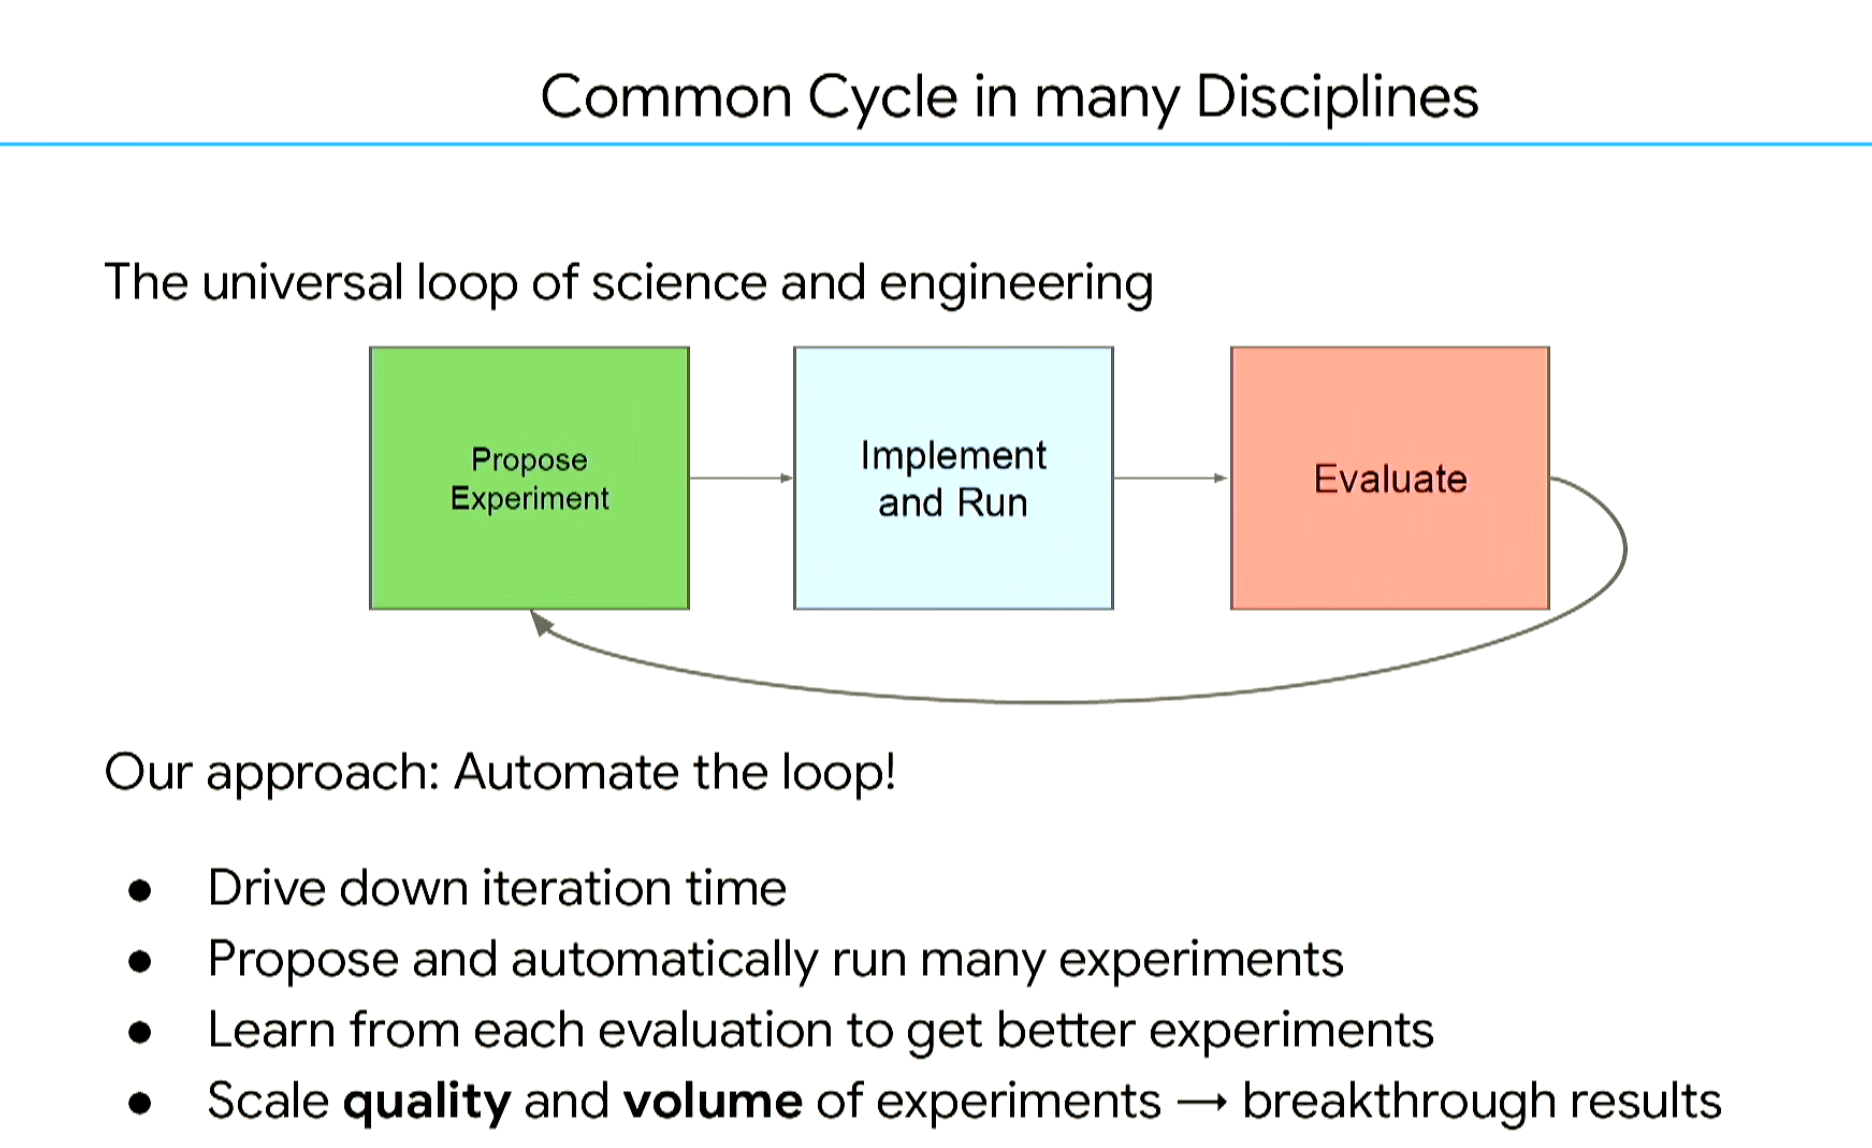
我们的核心思路正是将整套实验闭环全面自动化。 我们坚信,如果能大幅压缩单次迭代周期,全天候自主发起并推进成千上万场实验,并在每次评估反馈中持续强化学习,使后续实验能够有效沉淀先验知识,那么实验的广度与质量必将迎来跃升,并最终带来突破性成果。
这正是我们正在全力推进的方向。
参考美国国家工程院列出的重大工程挑战清单,这些都是 21 世纪亟待攻克的核心命题,而本世纪已悄然走过近四分之一。
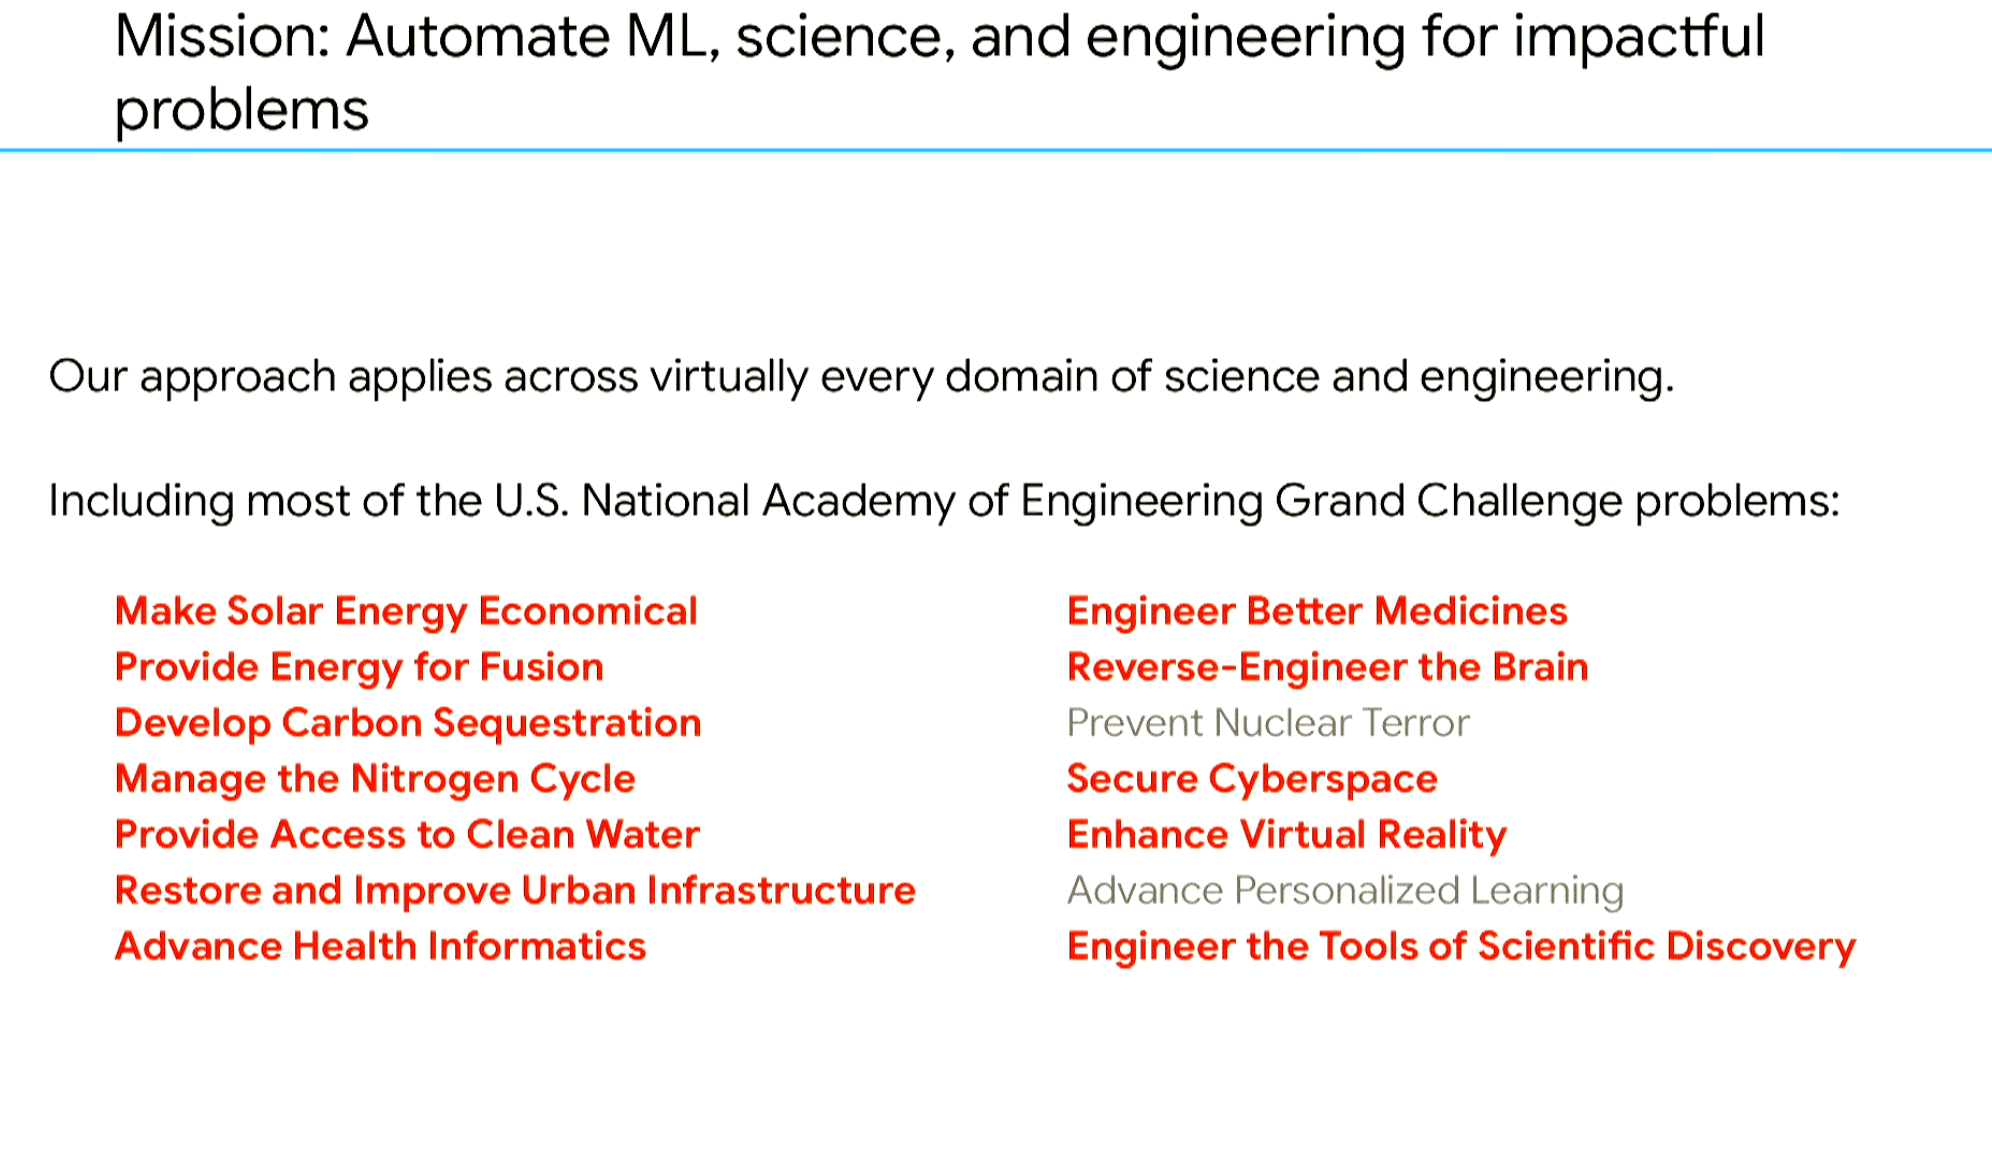
仔细审视拆解这些重大问题所需的关键技术子领域,尤其是图中标红的方向,我们深信自动化科学发现循环将成为极具变革性的助力。
为什么选择成立公益公司?
技术若使用得当,能够对世界产生极其深远的正面影响;但唯有建立合理的组织形态并凝聚各方努力,才能确保这种正面价值顺利落地。这也是我们创立独立公司的核心考量之一。
因此,我们将公司形式设立为公益公司(Public Benefit Corporation, PBC)。
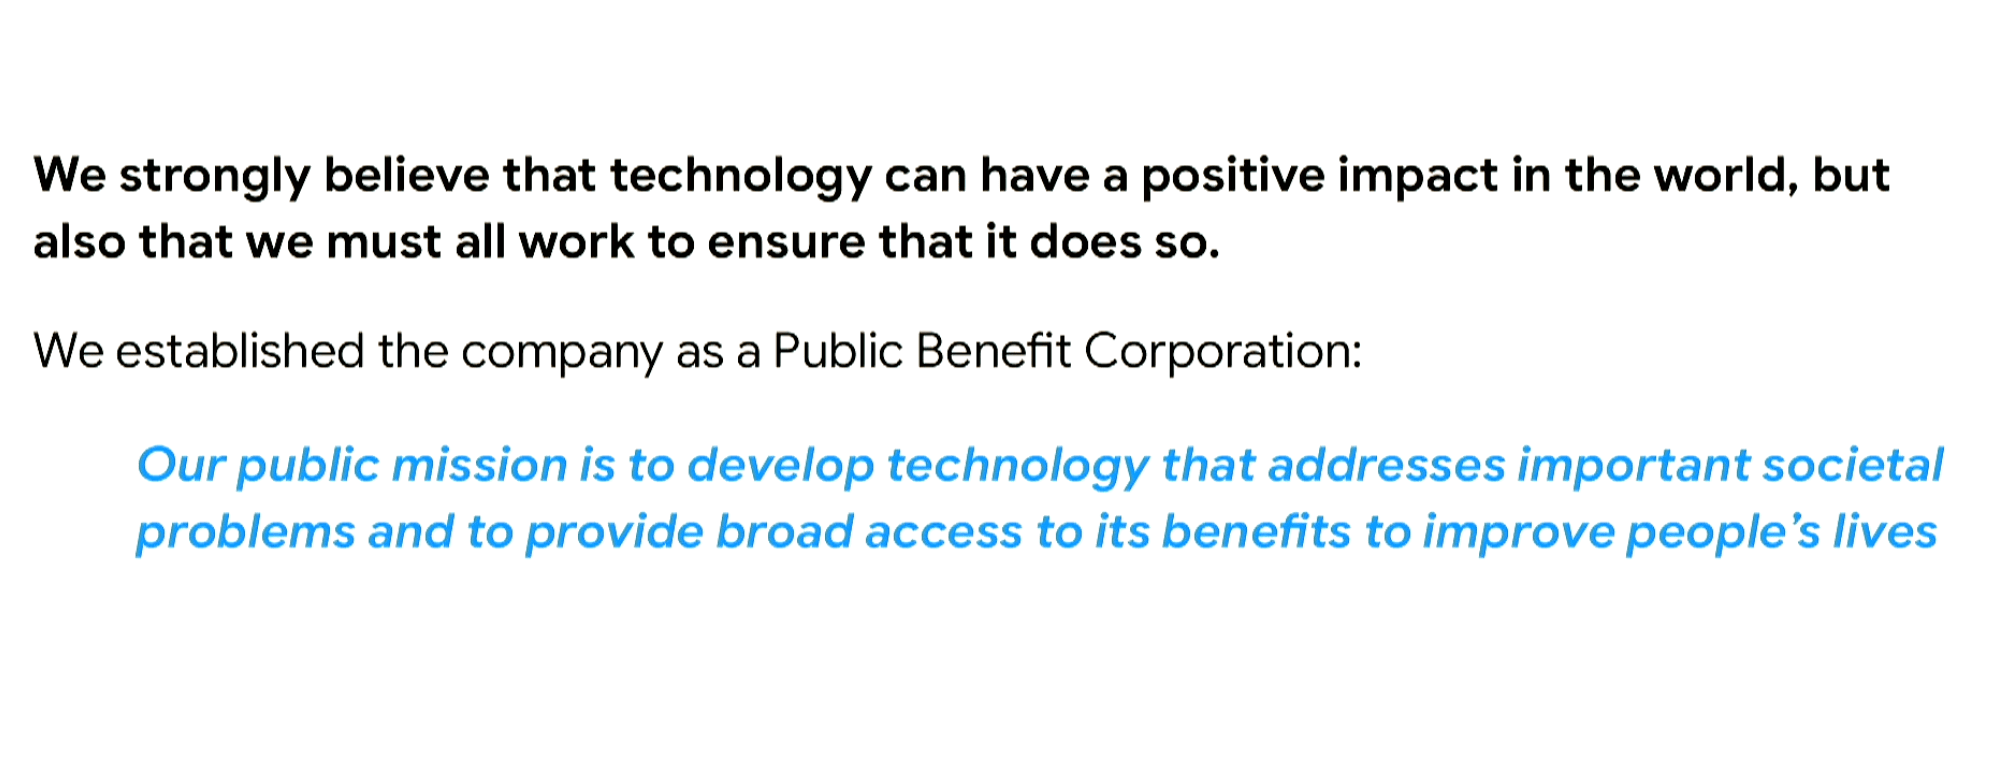
我们的公共使命明确指向:开发应对人类重大社会挑战的核心技术,推动技术红利的广泛普惠,切实改善全球人类的生活福祉。
四位创始人的技术沉淀
简单介绍一下创始团队。我的三位联合创始人分别是 Sanjay Ghemawat、Quoc Le 与 Oriol Vinyals。
若按两两协同研发的经历来算,我们彼此已并肩共事了 14 到 30 年不等。我们始终热爱攻坚最具挑战性的工程与研究难题,且在各自技术栈上形成了高度互补。
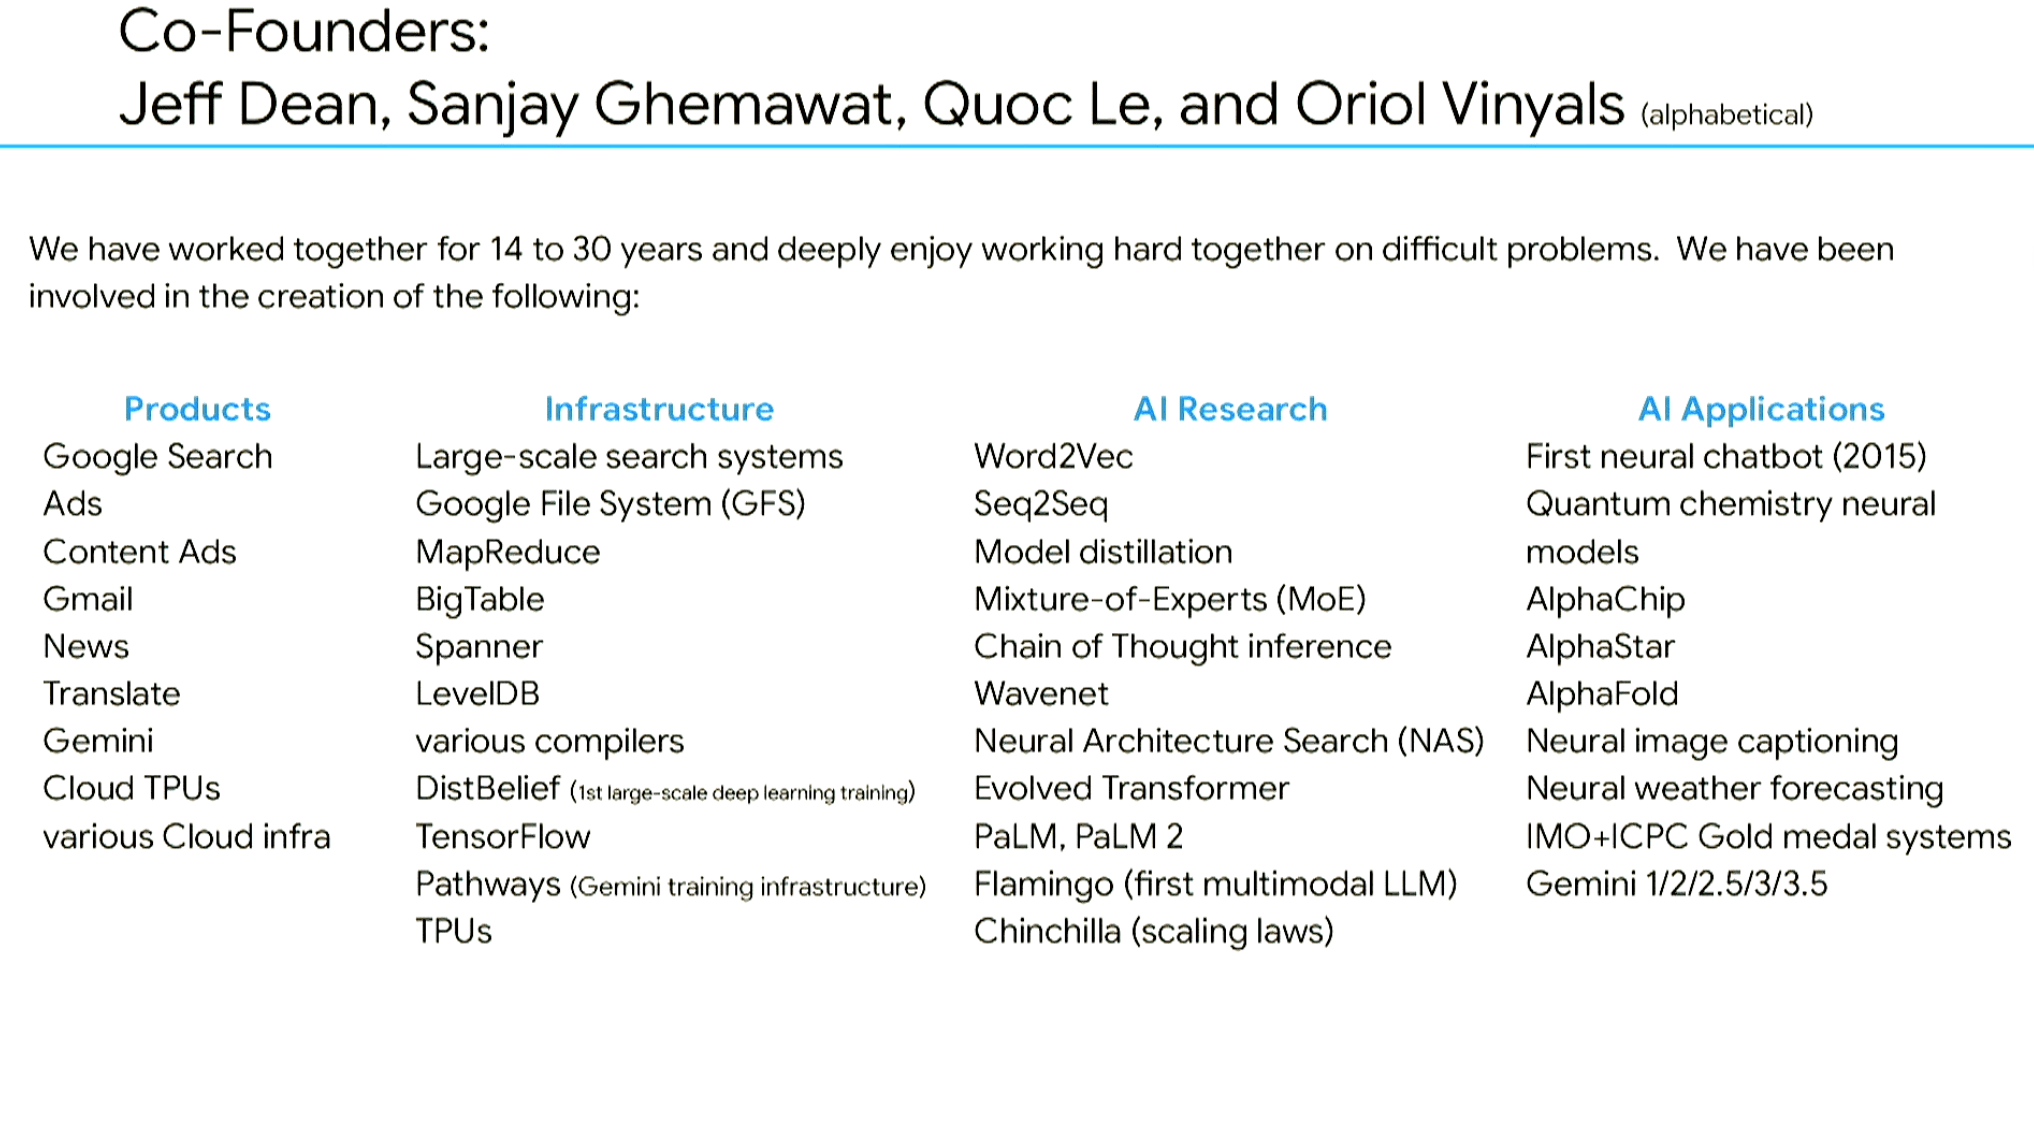
我们均来自 Google,图中梳理的成果均在此期间诞生:我们曾主导或参与过多代 Google 搜索架构、早期商业广告系统、内容匹配引擎,以及 Gmail、Google News、Google Translate 等核心产品体系。
图表第二列是系统基础设施:上半部分展示的是支撑海量数据组织、存储与大规模分布式计算的核心系统;下半部分四项则是历代超大规模机器学习基础设施,专为支撑能力不断进化的前沿模型训练而设计。此外,我们也深度参与了专为 AI 算力打造的 TPU 硬件研发。
在 AI 算法研究层面,当前许多前沿模型底层的关键技术,我们均有深度参与,其中包括知识蒸馏(Knowledge Distillation)、混合专家模型(Mixture of Experts, MoE)以及神经架构搜索(NAS)。
神经架构搜索实际上可视为自动化实验循环的早期雏形:通过算法自动探索适配特定任务场景的最佳神经网络拓扑。
我们还长期推进 AI 在交叉领域的应用落地,尤其是基础科学研究。例如我和 Quoc 参与的 AlphaChip,利用强化学习进行微芯片的宏单元布局与布线;Oriol 则参与了 AlphaFold 以及基于神经网络的气象预测系统研发。
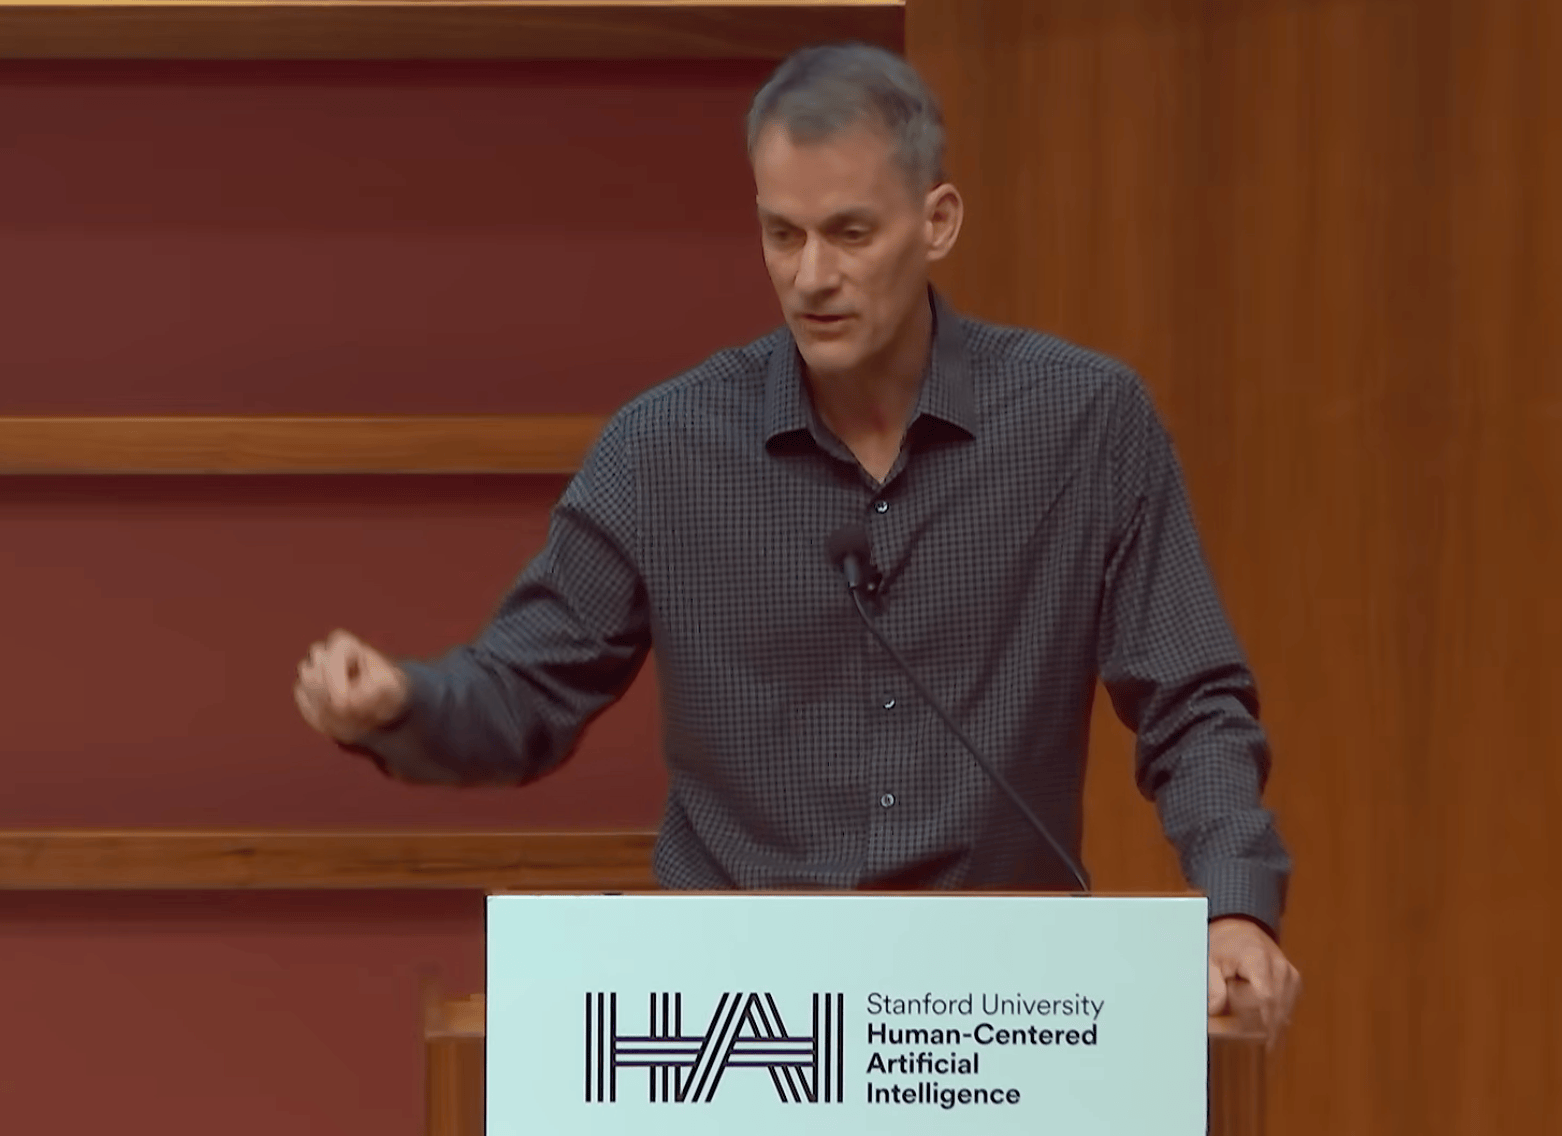
在大规模团队管理方面,我也积累了深厚经历。我曾掌舵 Google Brain 团队(规模至多 600 人),后续兼管 Google Research 和 AI 团队,总规模曾达到约 4400 人。
直到某天我意识到,自己在 Q2 运营预算会议等管理琐事上耗费了过量精力。于是我通过一封架构调整邮件,将直接向我汇报的人数从 4400 人的体系迅速收敛为仅有 4 位汇报对象。
紧接着一周后 Geoff Hinton 宣布退休,直接汇报对象便降到了 3 人。
随后,我和 Oriol 共同担纲 Gemini 项目的联合技术负责人,Quoc 统领后训练(Post-Training)业务线。
更令我们自豪的是,曾与我们在同一战壕并肩战斗的伙伴们,后来纷纷在业内取得了卓越成就,其中包括 Anthropic、OpenAI、Physical Intelligence 等顶尖公司的创始人。
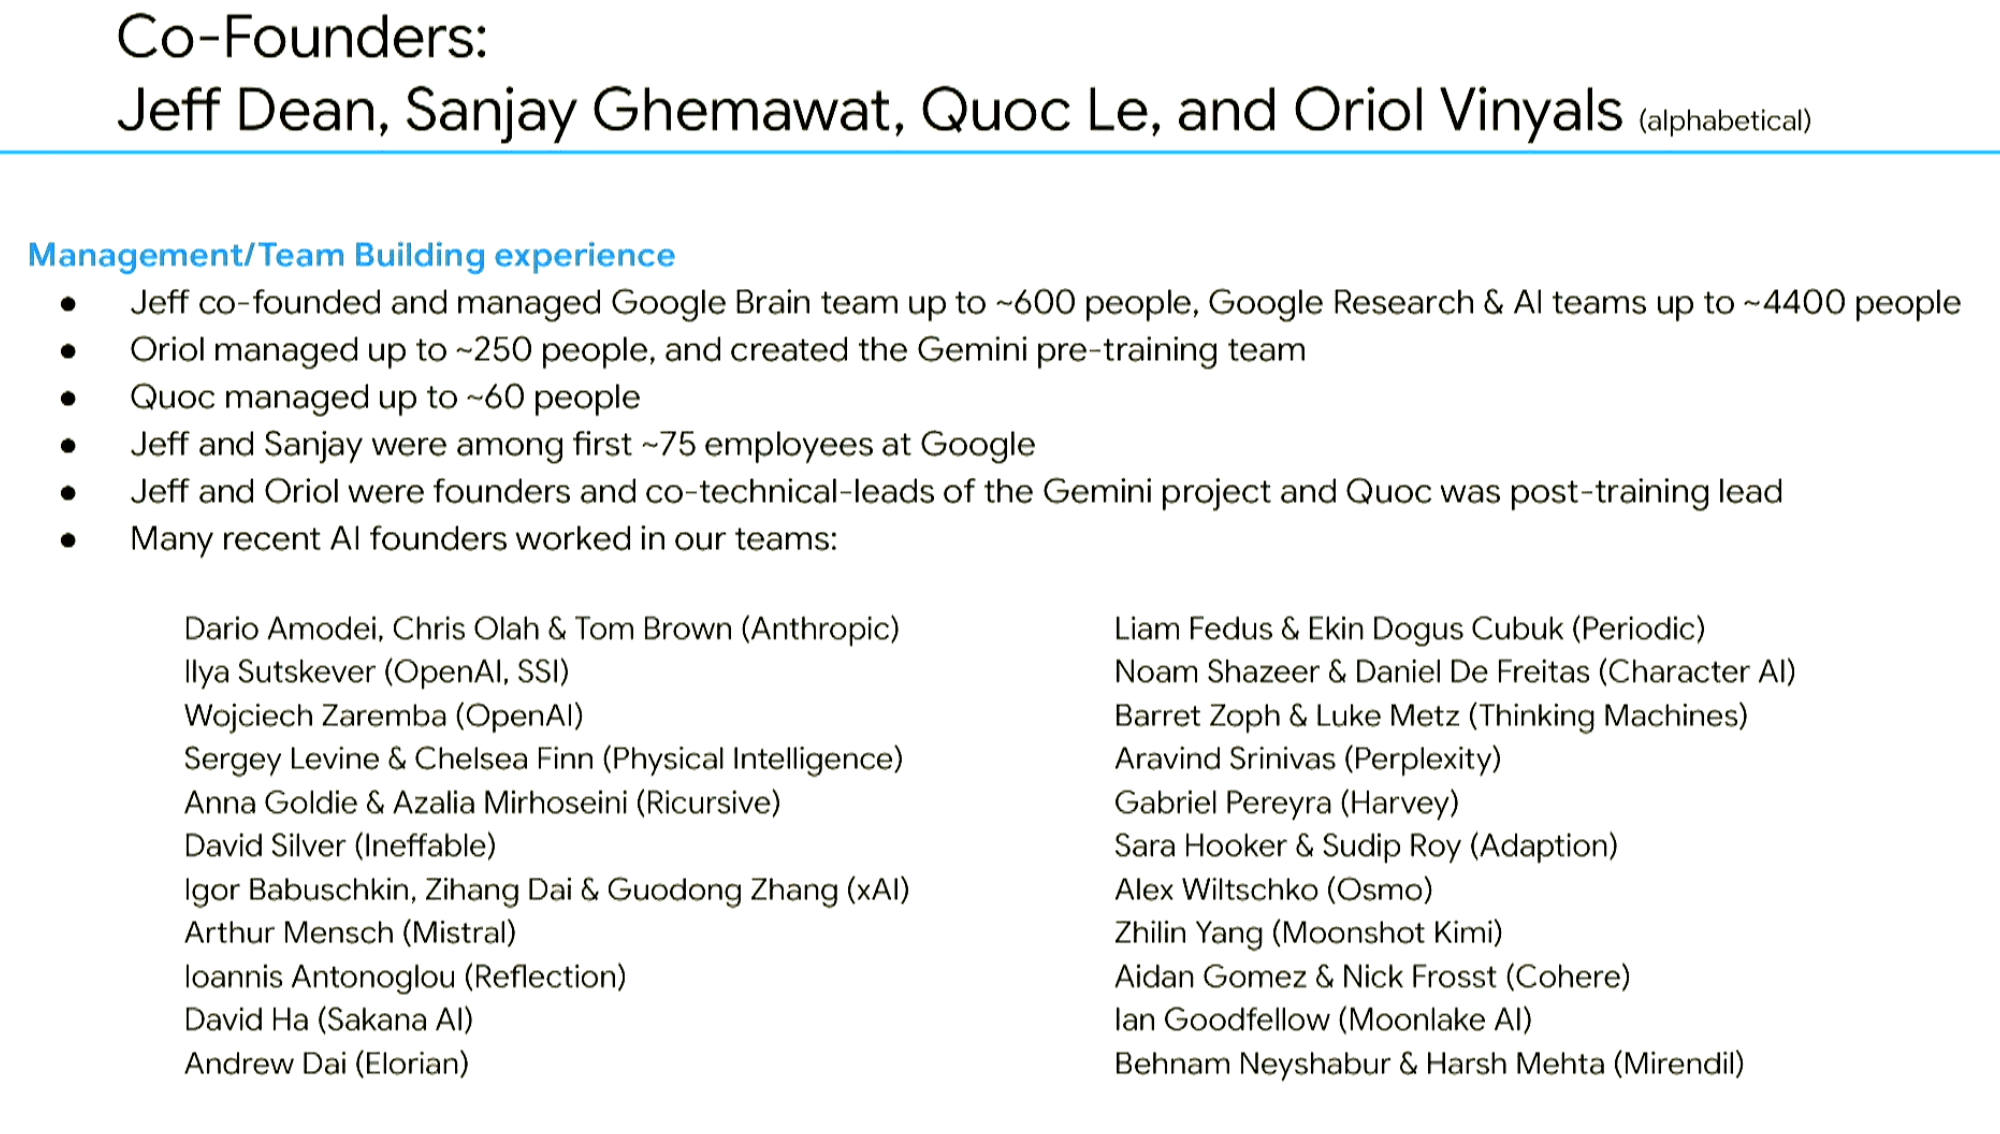
我们的技术根基深度融汇了 AI 算法前沿探索与大规模分布式系统架构。
这张根据 Google Scholar 引用量统计的图谱展示了 AI 与分布式计算领域的头部学者,红框内是我们四人,而标注星号的学者也均曾与我们在同一团队共同工作。
团队组建与早期招聘
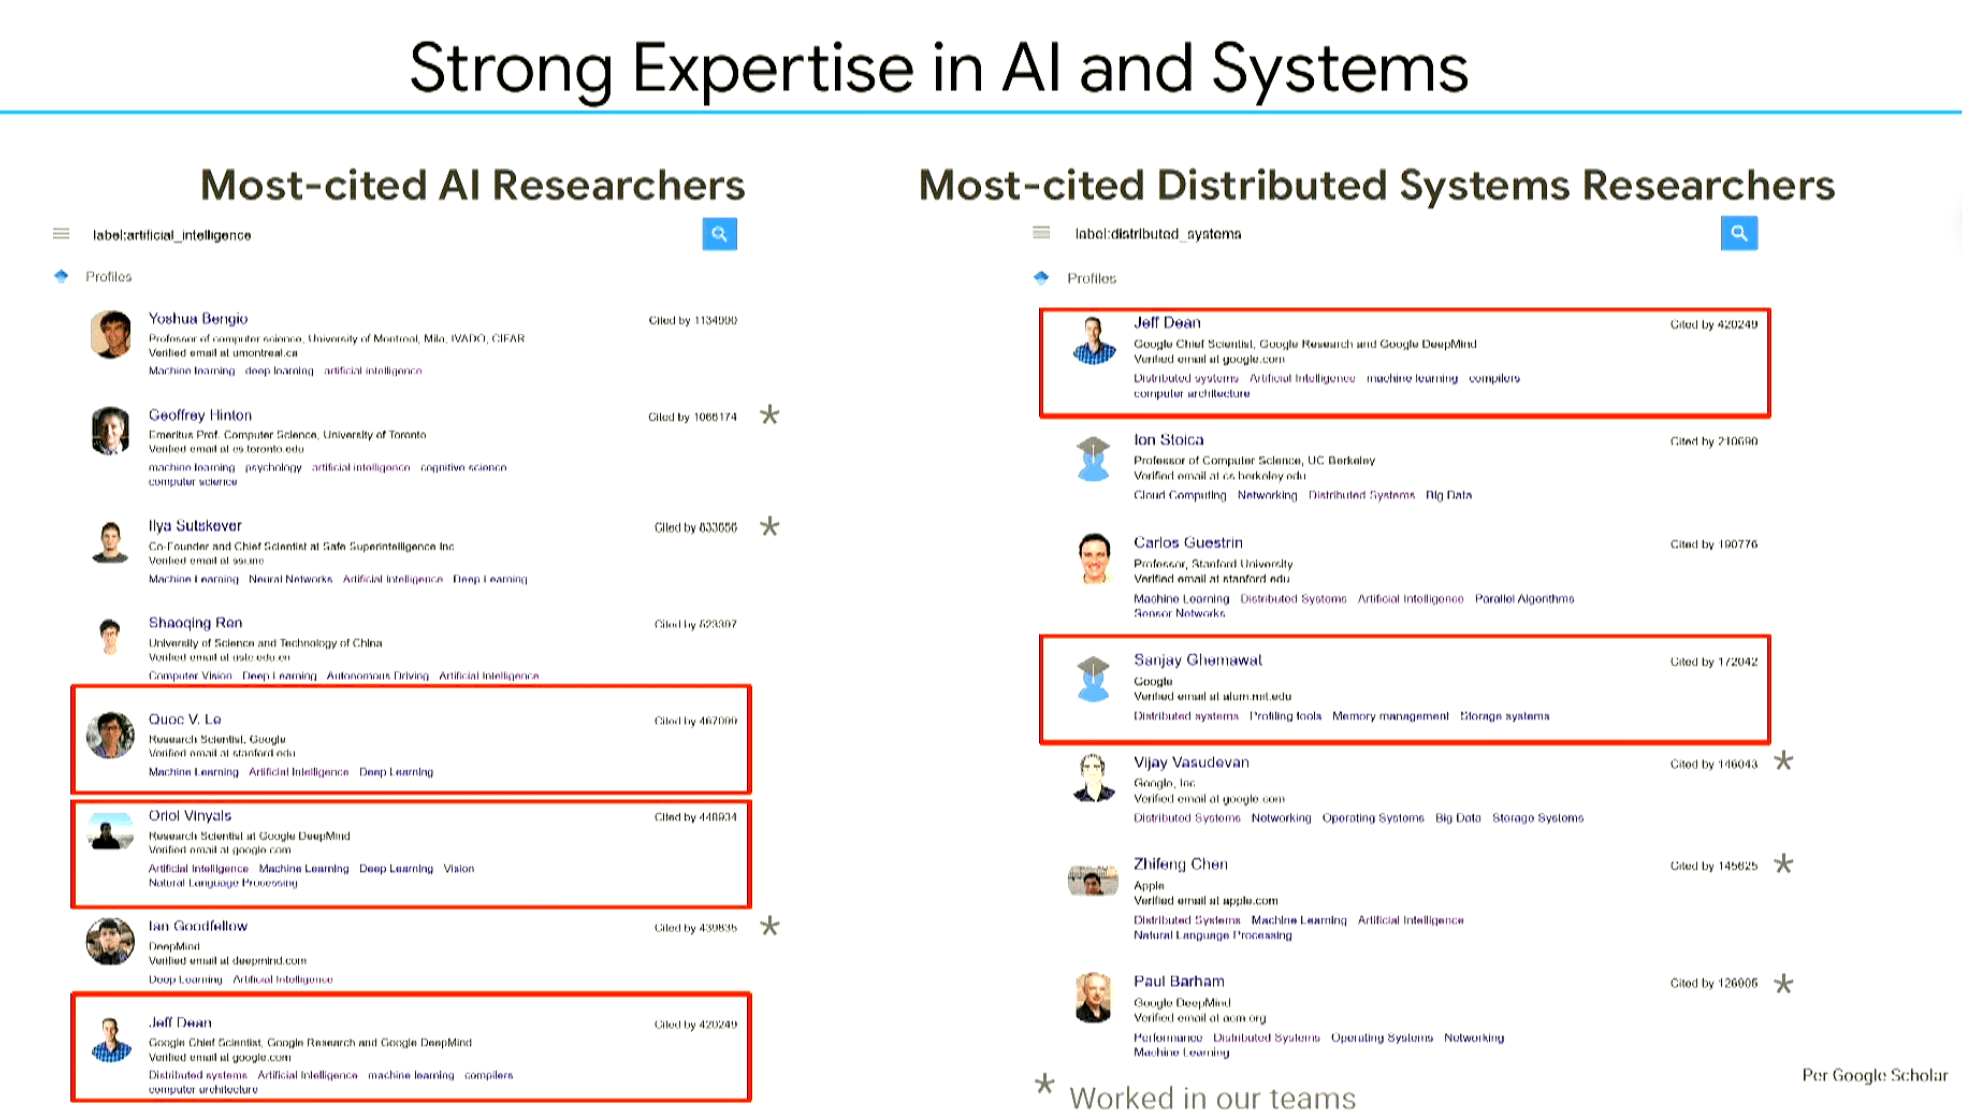
工作之余,我们一直是非常合拍的朋友,一同走过伦敦、巴塔哥尼亚、越南以及加利福尼亚等地。
记得有一次我和 Quoc 在越南吃完晚饭,一起叫了一辆当地类似 Uber 的摩托车合乘返回住处。
公司创立伊始的第一阶段,我们全力倾注于核心团队的招募。成员背景非常多元,许多人具备成功创业或主导标杆级开源/商业项目的丰富资历。
团队不仅涵盖了 Go 语言核心负责人级别的工程专家,还汇聚了来自 Gemini、DeepSeek、Kimi K3 等标杆模型的核心贡献者。例如 Kimi K3 论文合著者兼 Attention Residuals 研究作者,近期就正式加入了团队。
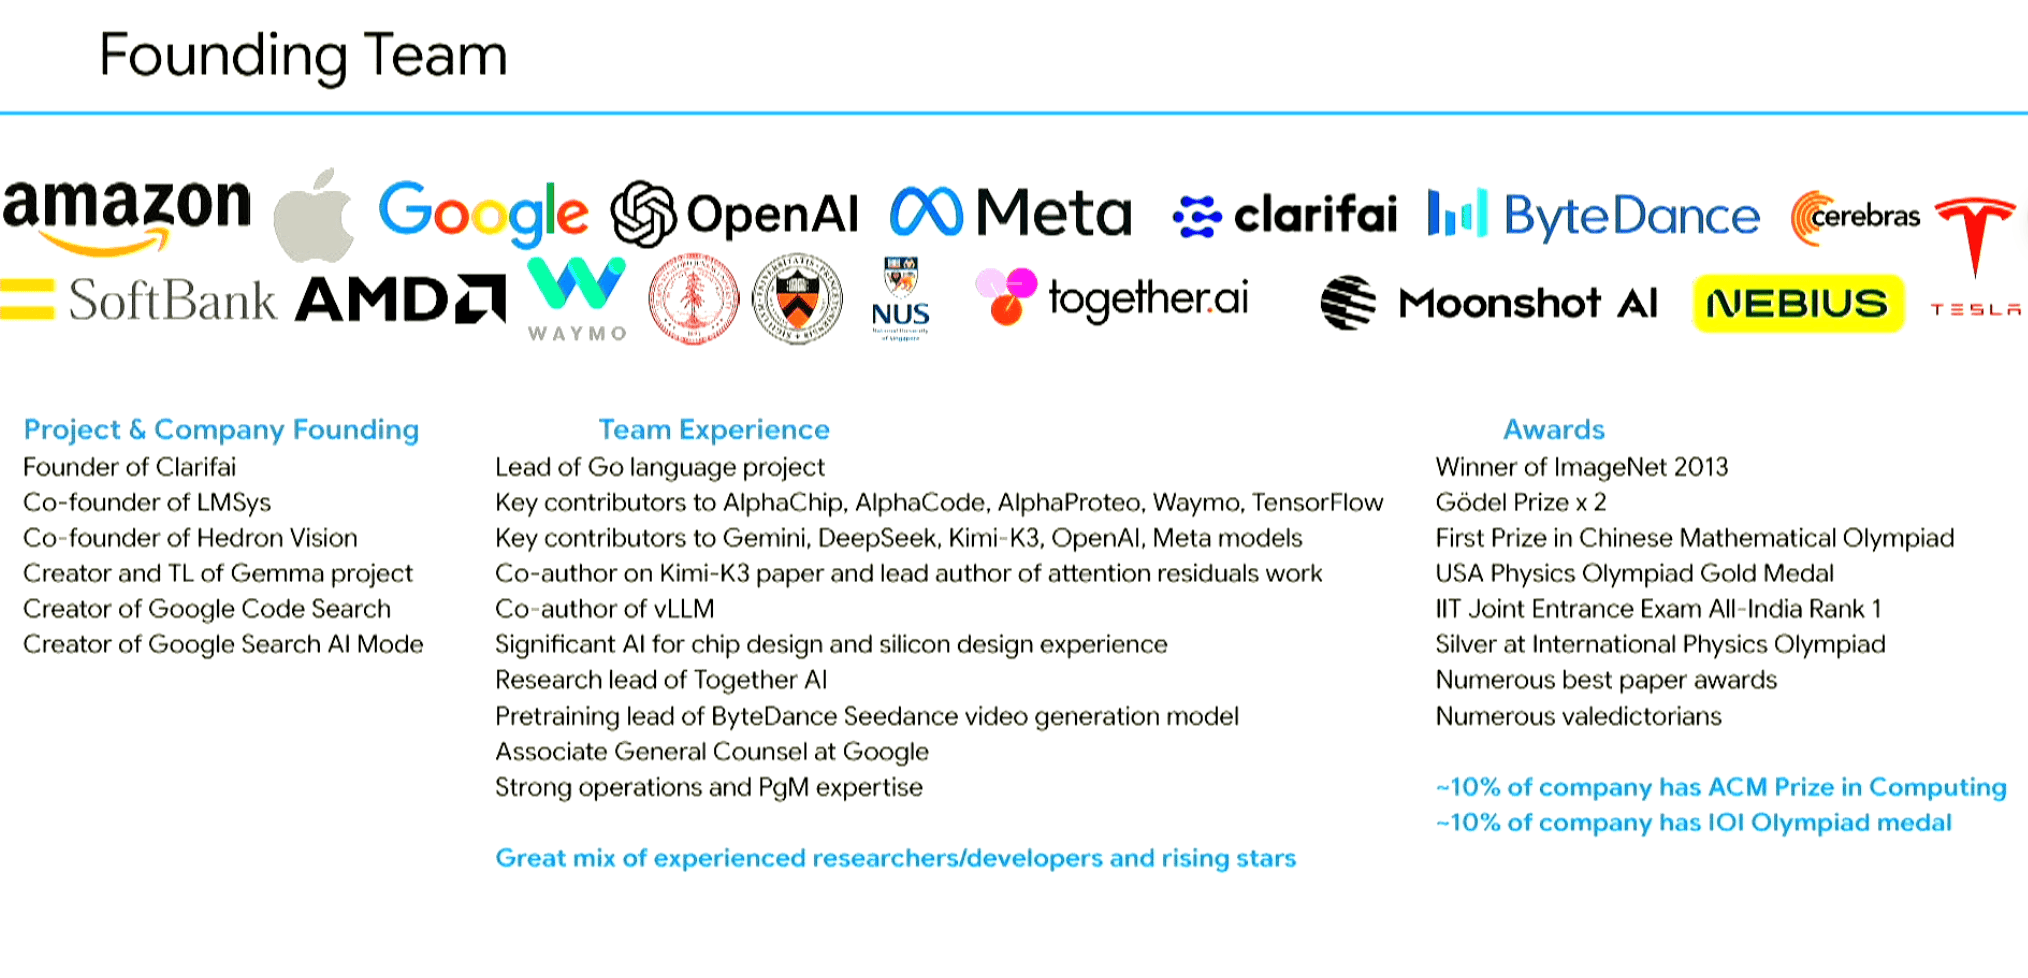
我们的研发阵容实现了资深顶尖专家与新生代领军人才的有机融合。公司目前约有 10% 的成员获得过 ACM 计算奖项,约 10% 的成员拥有 IOI(国际信息学奥林匹克竞赛)奖牌背景。
高密度的人才结构不仅令人振奋,团队之间高效共事的化学反应更是我们最看重的特质。
为什么在当下推进这件事?
答案在于:前沿基础模型的核心能力已经迈过了质变临界点。这得益于过去 10 至 15 年间 AI 全技术栈的深厚积淀。
首先是硬件层面的突破,包括 TPU、GPU 以及各类专用定制加速硬件;其次是软件抽象层的全面升级,开发者能以前所未有的便捷度实现前沿想法,并将计算图精准映射到底层硬件架构上。
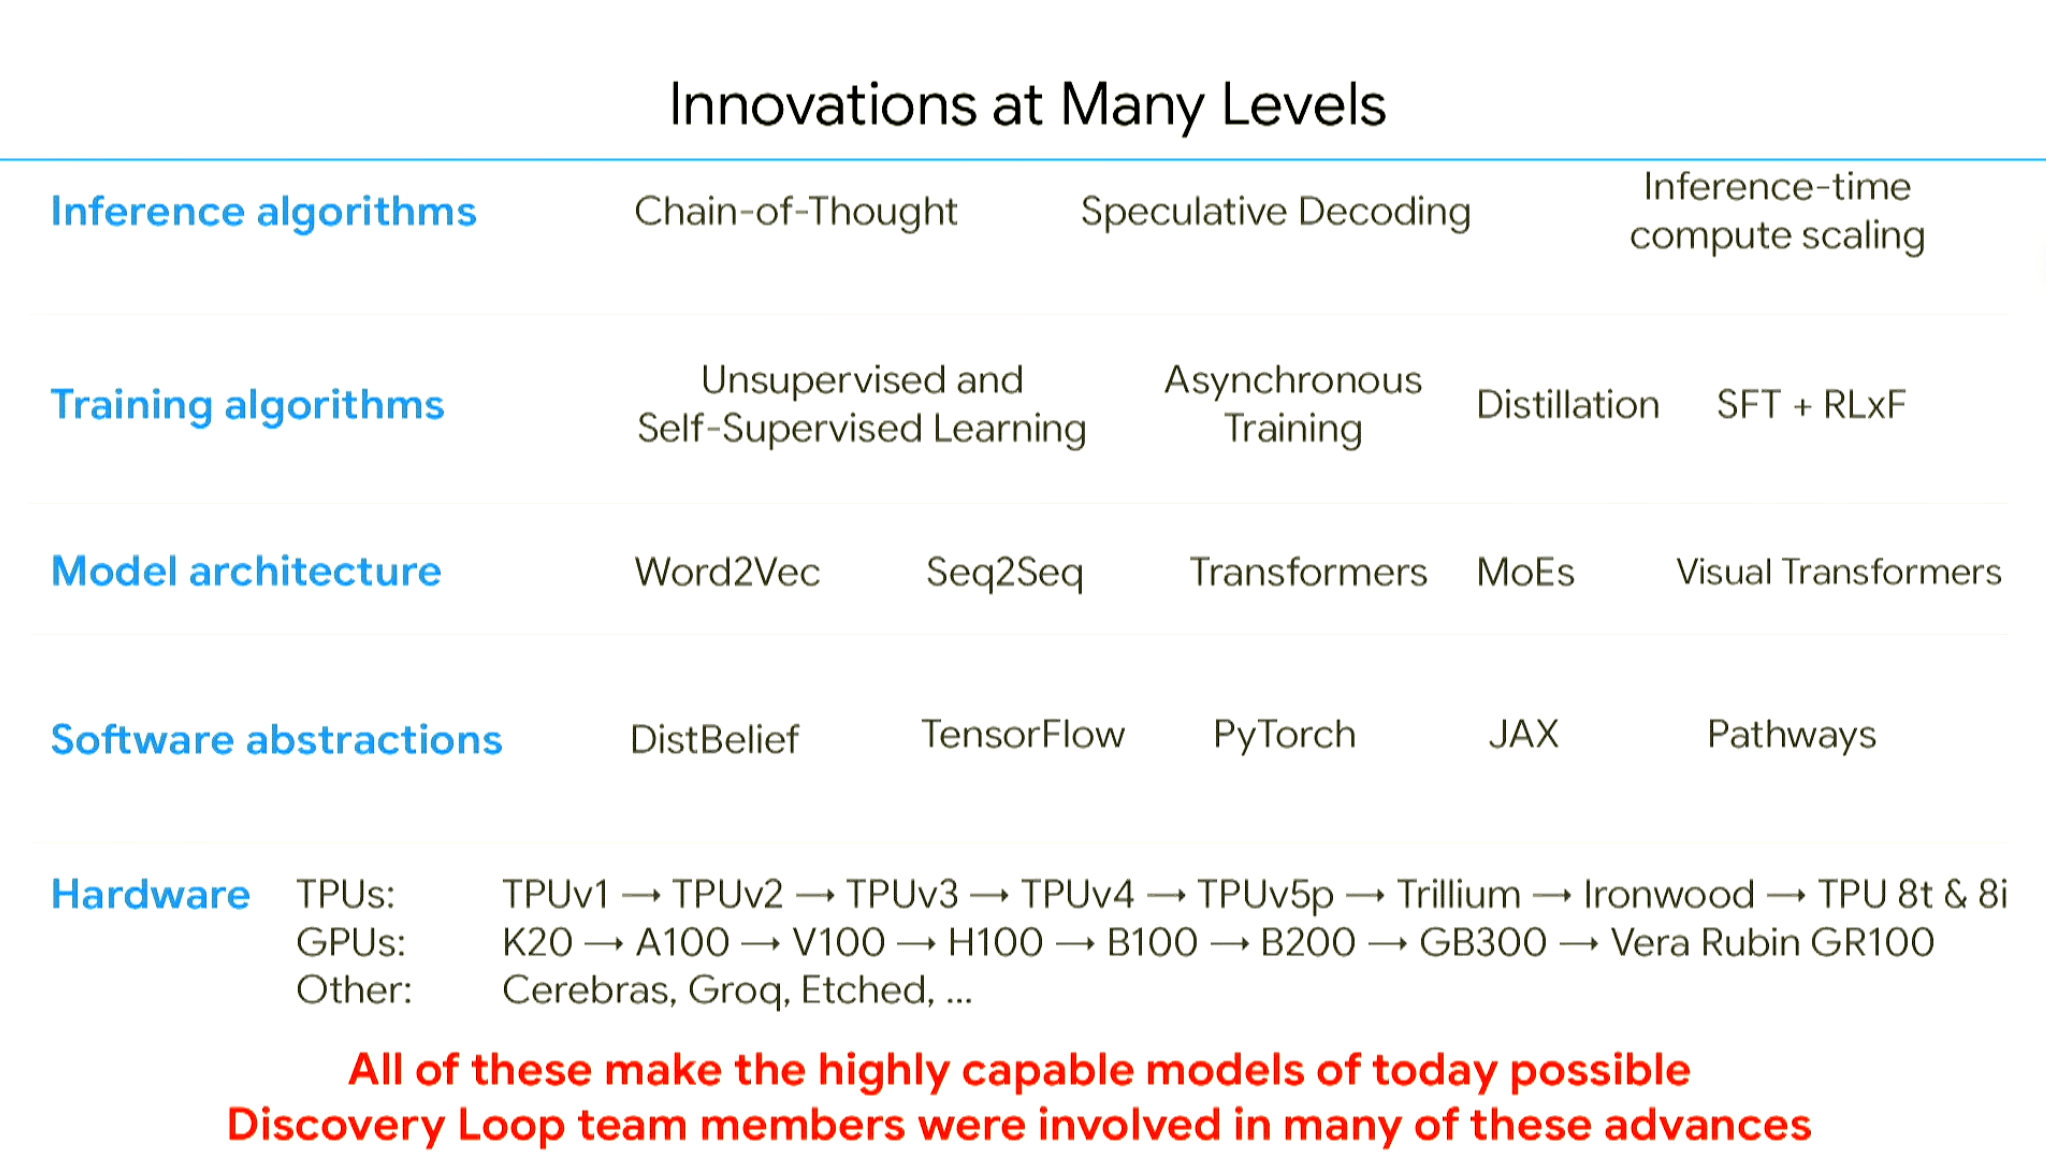
在模型架构层面,从早期 word2vec、Seq2Seq,到 Transformer 与 MoE 架构持续迭代;训练与蒸馏技术的大幅进步,让紧凑型模型同样能释放出惊艳的泛化表现。
推理范式更是经历了关键跃升。通过投入测试期算力(Inference-time Compute),利用思维链(CoT)推理、多路径探索验证等策略,模型推理质量获得了数量级的提升。
模型必须具备工具调用、创造力与经验沉淀
然而,仅凭孤立的基座模型,远不足以攻克真正的硬核科学问题。我们必须以顶尖的基座模型为底座,深度结合智能体架构,让系统学会熟练调用工具链,进而承载复杂的多步骤工程任务。
更关键的是,我们要求智能体系统展现出真正的科学“创造力”。科学与工程的质变,本质上要求模型能够将异构领域中的洞见跨模态组合,提出兼具原创性与可行性的全新方案,并自主推进实验验证。
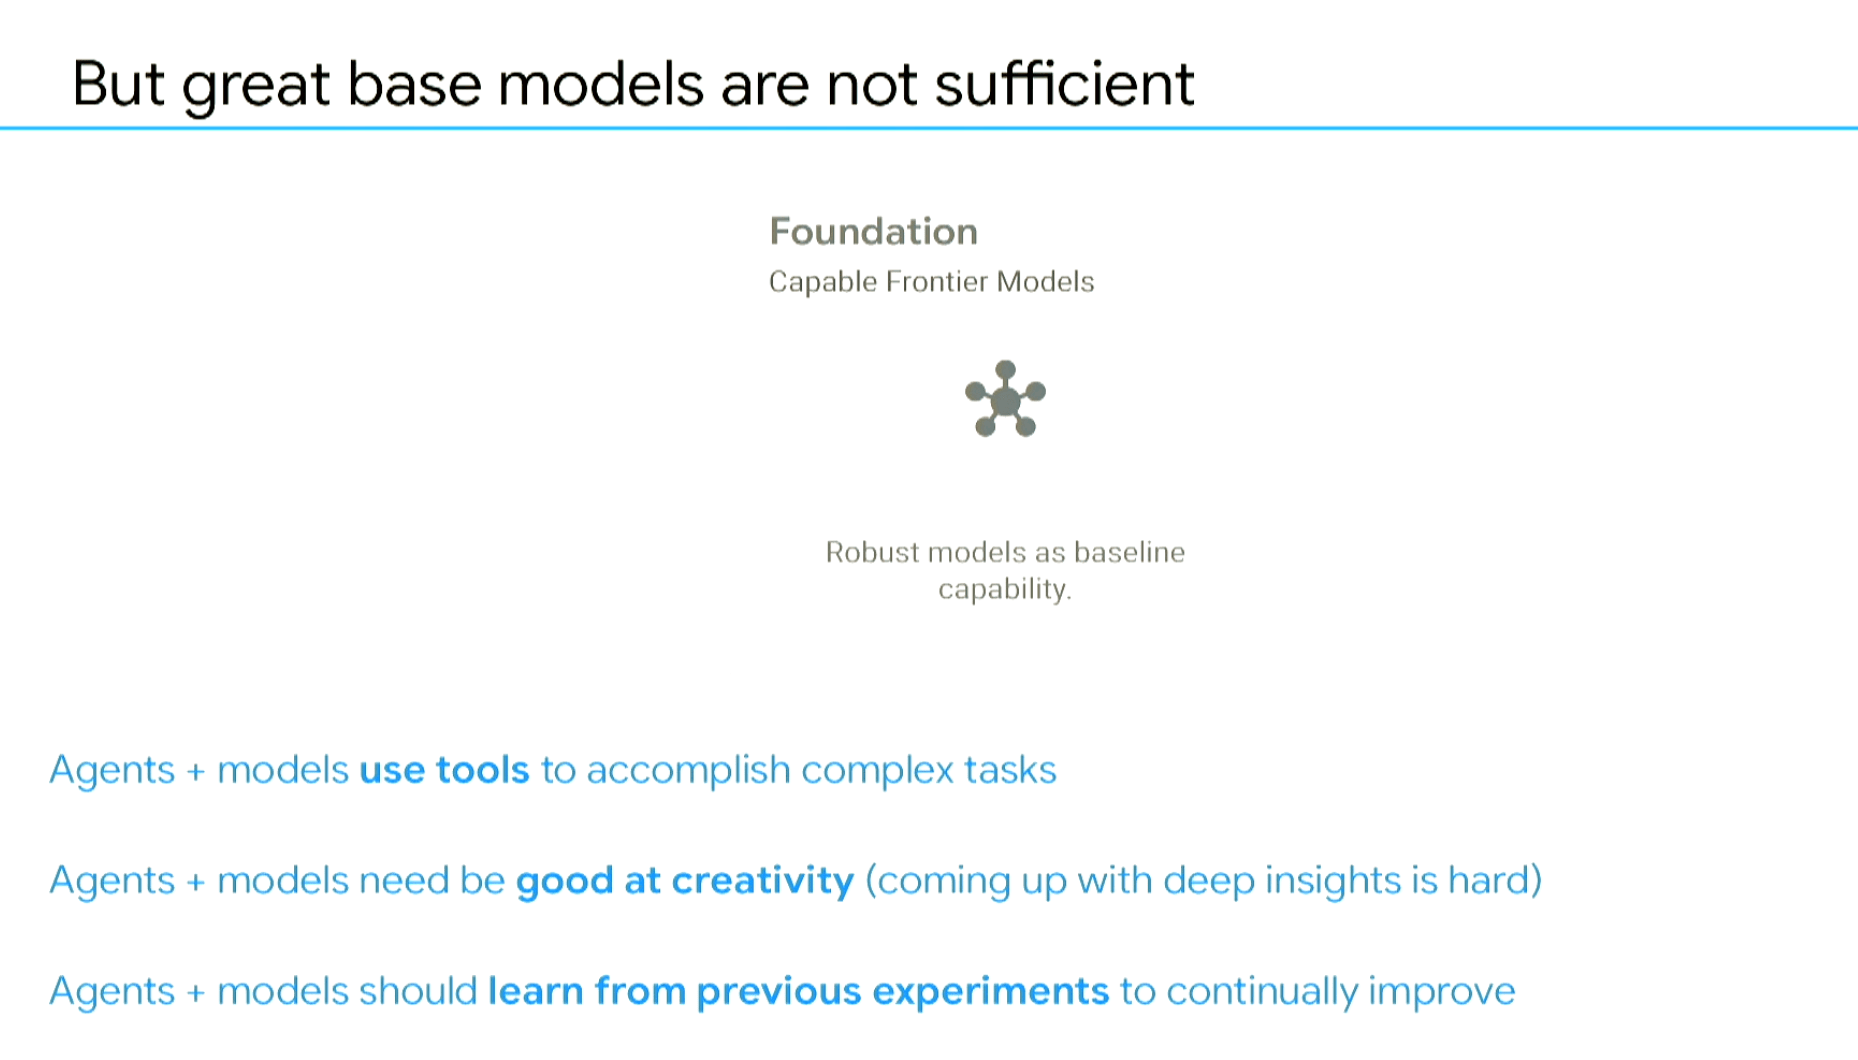
与此同时,系统还必须具备在多轮实验历程中形成长期记忆与经验沉淀的能力。
举例来说,当一套智能体系统已经连续攻关并解决了 5000 个复杂工程问题后,在面对第 5001 个全新任务时,它应当能够迅速迁移匹配最相关的历史解题经验与试错教训。
宏大工程的瓶颈在于分工与协同损耗
传统的科学研发闭环高度依赖重度的人力介入。
当问题体量极其庞大时,工程复杂度会呈指数级上升。因为你首先必须将其拆解为若干子问题或独立模块,而“如何科学合理地拆解”本身就是极具挑战的元问题。
在各个细分领域内,往往聚集了大量研究员分别验证局部方法的可行性。
这随即带来了巨大的组织协调摩擦、资源竞态以及跨系统集成损耗。将问题优雅地拆分极为困难,而把各子问题的碎片化成果再无缝集成回去,同样是世界级难题。
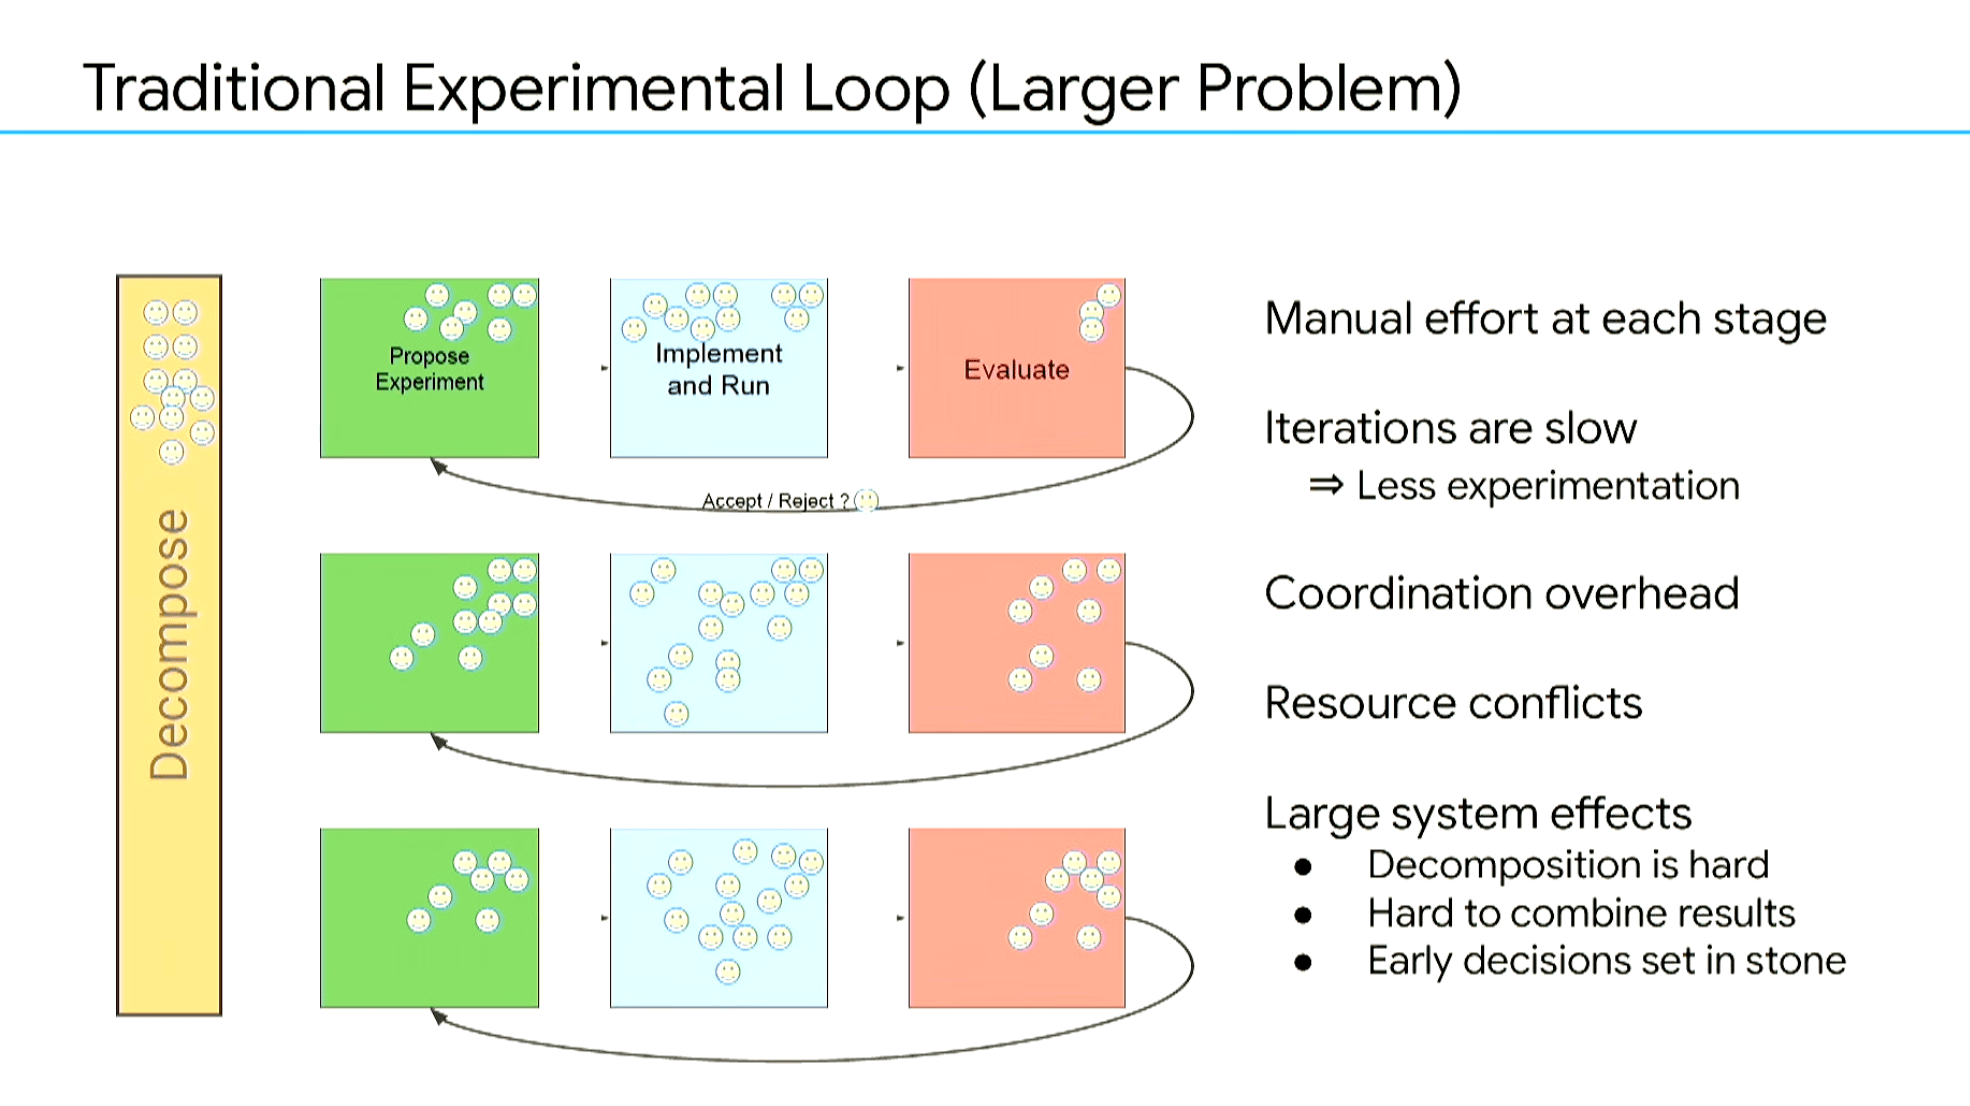
更致命的是,大型研发工程一旦全面铺开,早期的架构拆分逻辑便会严重固化。无论是整机研制,还是前瞻性基础大模型的研发,中途都很难对初期的结构性决策进行动态修正。
我们的解题思路是:依托自动化系统,赋能极少数顶尖领域专家主导整个研发大局。理想状态下,智能系统应能自主探索出最具科学价值的子问题,并端到端调度算力推进闭环求解。
当然在演进阶段,仍然需要资深专家提供高维度的引导,把控优先级路线。
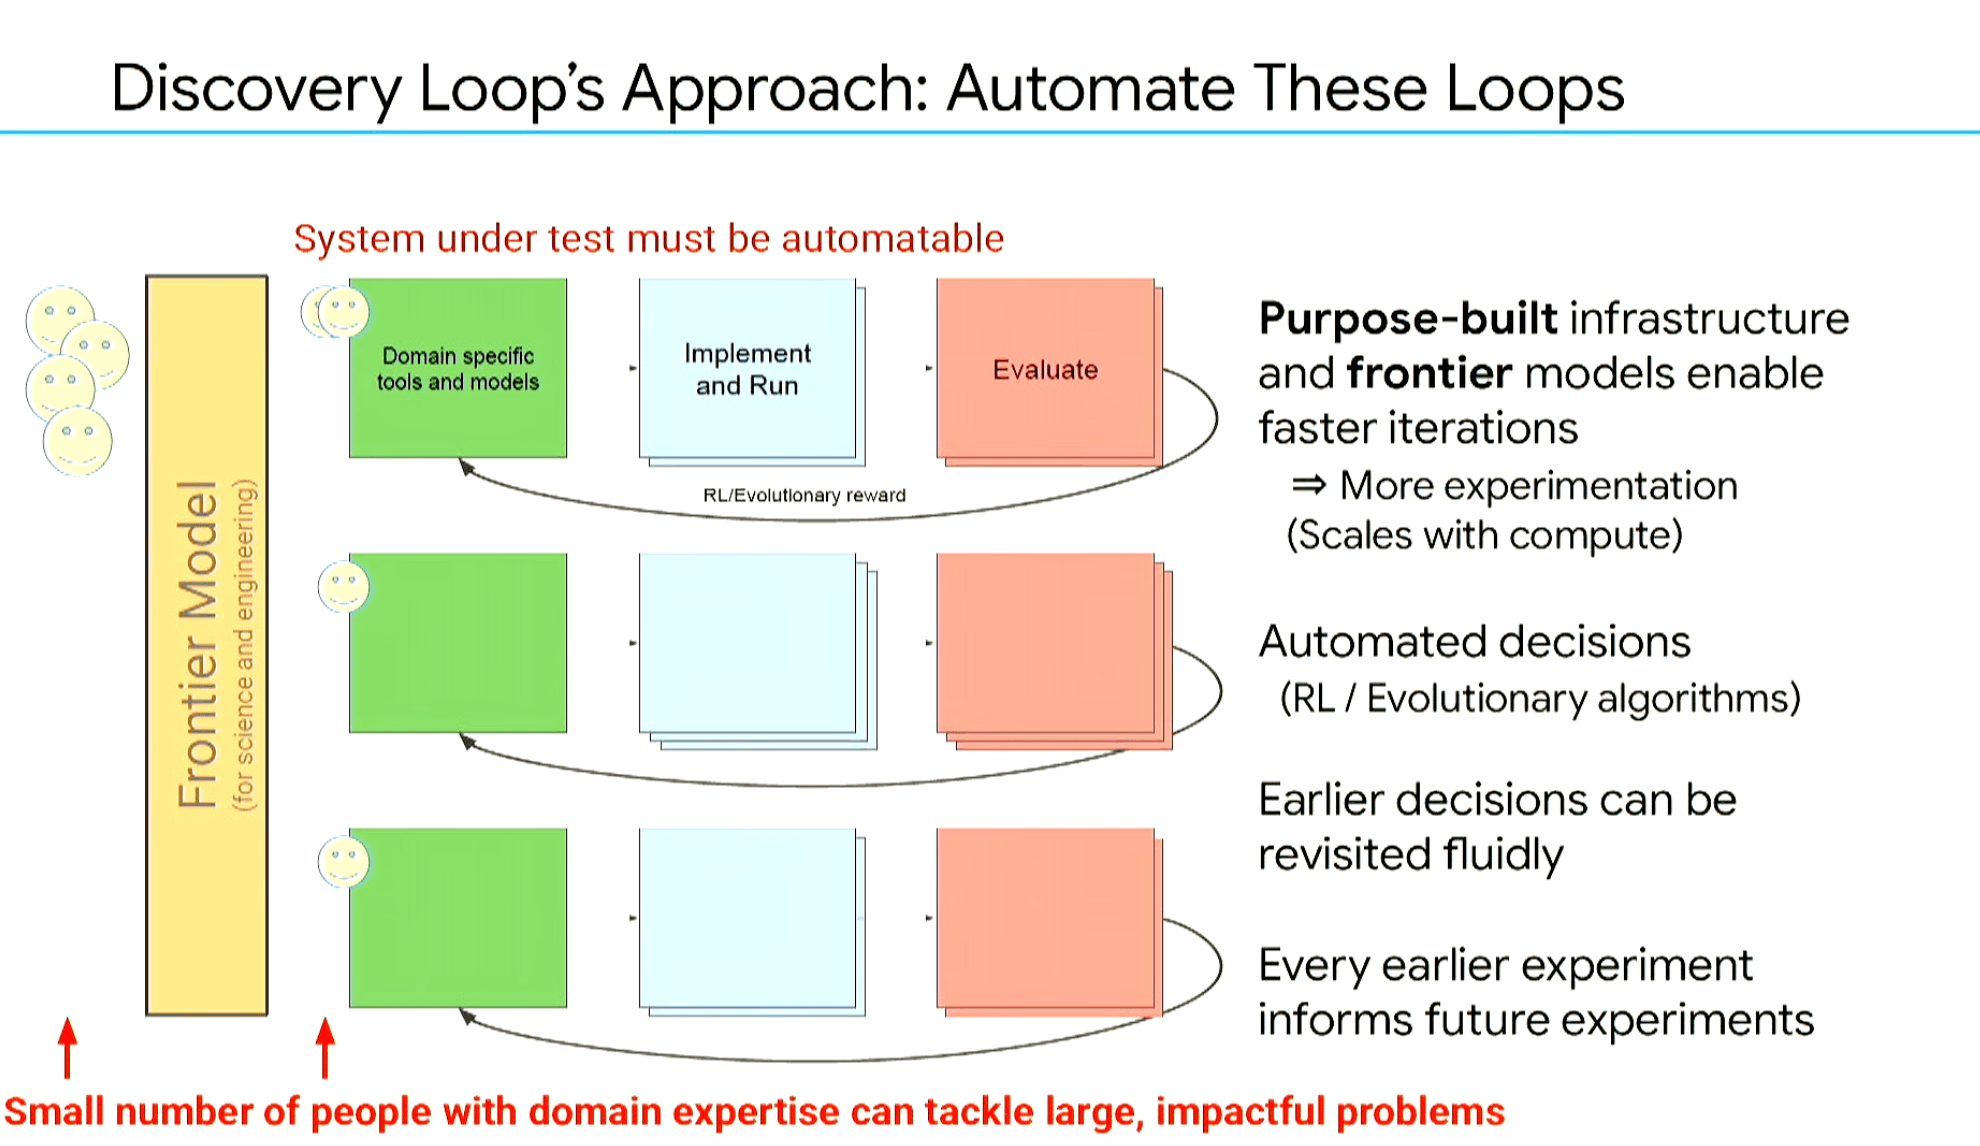
如此一来,极小规模的核心专家群即可掌控影响深远的重大战略任务。我们坚信,量身定制的基础设施底座是这一协同范式的核心基石。
底层不仅要承载数以万计并发运行的自动化实验流,系统还需深刻评估每个实验节点的边际收益,动态收敛出下一个最优动作。
强化学习与演化策略可在此过程中发挥核心作用,让早期的决策路径具备动态重估与自适应回溯的弹性;每一次前期探索,都应转化为后续实验的确定性先验。
已有约 20 个自动演进循环全天候运转
Discovery Loop 目前取得了哪些阶段性进展?
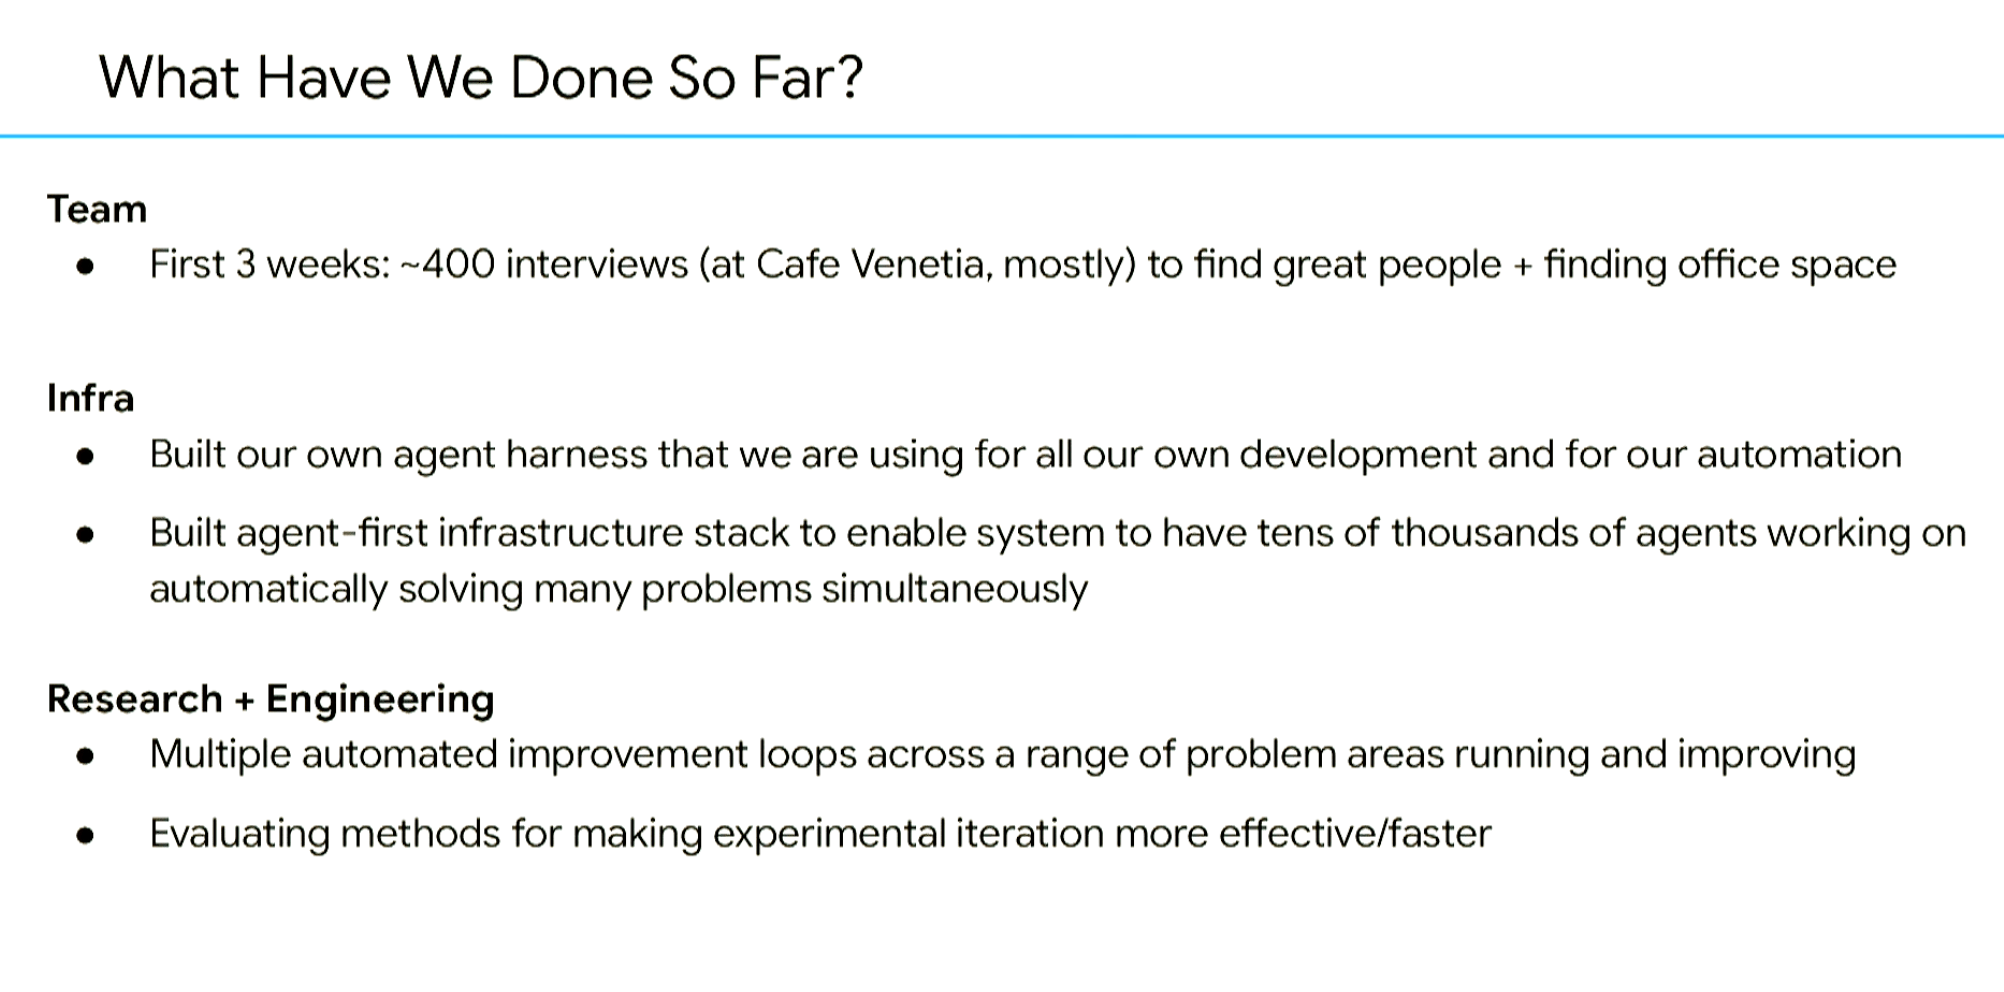
初创的前三周,我们团队在加州大学大道的 Cafe Venetia 密集完成了 400 场高强度面试,全力遴选最契合的顶尖极客。
目前公司已正式迁驻至原 Zibibbo 餐厅的旧址,打造了极具特色与极客氛围的研发大本营。
工程层面,我们自主研发了专有智能体运行沙盒(Agent Harness),全面支撑内部系统自举开发与自动化运转。
该框架具备出色的分布式协同特质:工程师不仅能单独与 Agent 交互排障,还能随时拉入团队成员,实现“多人协同指挥多个 Agent”的多智能体协作模式。
团队伙伴能够在方案落地执行前,直接在线审阅并标注修改意见,对实验方案进行先期把关。
与常规工具不同,我们的基础设施架构从第一天起就完全面向大规模 Agent 并发调度进行重构,原生支持调度成千上万个智能体集群并行作业,而非单纯局限于百人规模的协同协作。
截至目前,系统内部已有约 20 个自主优化迭代的改进循环正在全天候稳定运转。
我们正在持续评估如何进一步缩短实验周期的单位迭代开销,并最大化复用历史评估指标与遥测数据,以期加速系统的自举进化能力。
核心目标:将领域专家生产力释放 20 至 50 倍
这就是我们当前的主战场:以软件循环全面赋能并自动化机器学习任务闭环,以此为支点撬动更深度的全自主科学探索。
在切入点上,我们优先聚焦于通过自动化闭环攻克机器学习算法研发与大规模 ML 工程领域本身的硬核瓶颈。
我们的中期核心指标,是将领域专家的实际研究生产力提升 20 到 50 倍。
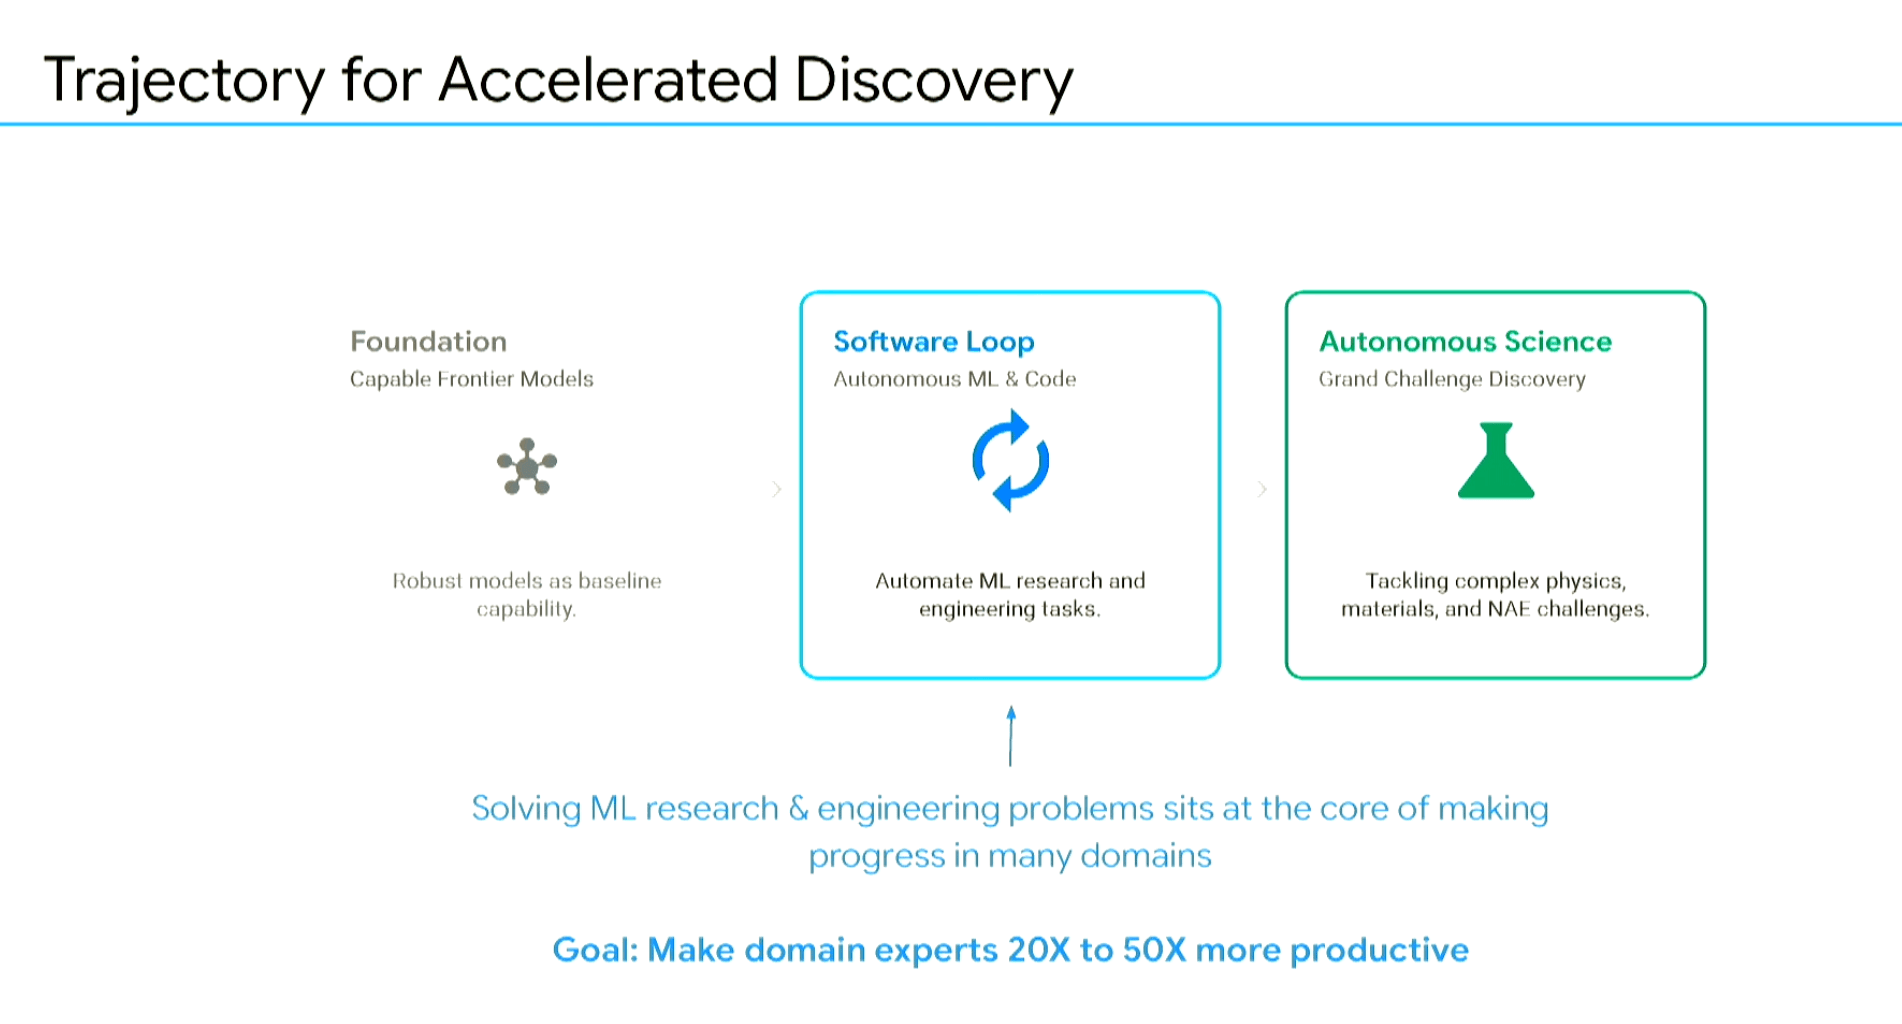
我们希望赋能每一位胸怀远大问题的科学家与工程师,以更少的基础心智损耗直击核心痛点。在此范式下,人类始终牢牢把握着战略航向的把舵权。
过去 15 年机器学习领域的技术爆发为当下铺设了坚固的模型底座,也为全面推进机器学习、自然科学与工程自动化的新纪元构筑了先决土壤。
Jeff Dean 对谈李飞飞:RSI 同样受制于物理现实,蒸馏技术早期曾遭冷遇
为何决定走出 Google 全力创业?
李飞飞: 谢谢 Jeff,非常精彩的分享。我想这是今天的收官环节,我们恰好横亘在全场观众与茶歇点心之间。
Jeff Dean: 哈哈,这个控场位置向来都颇具挑战。
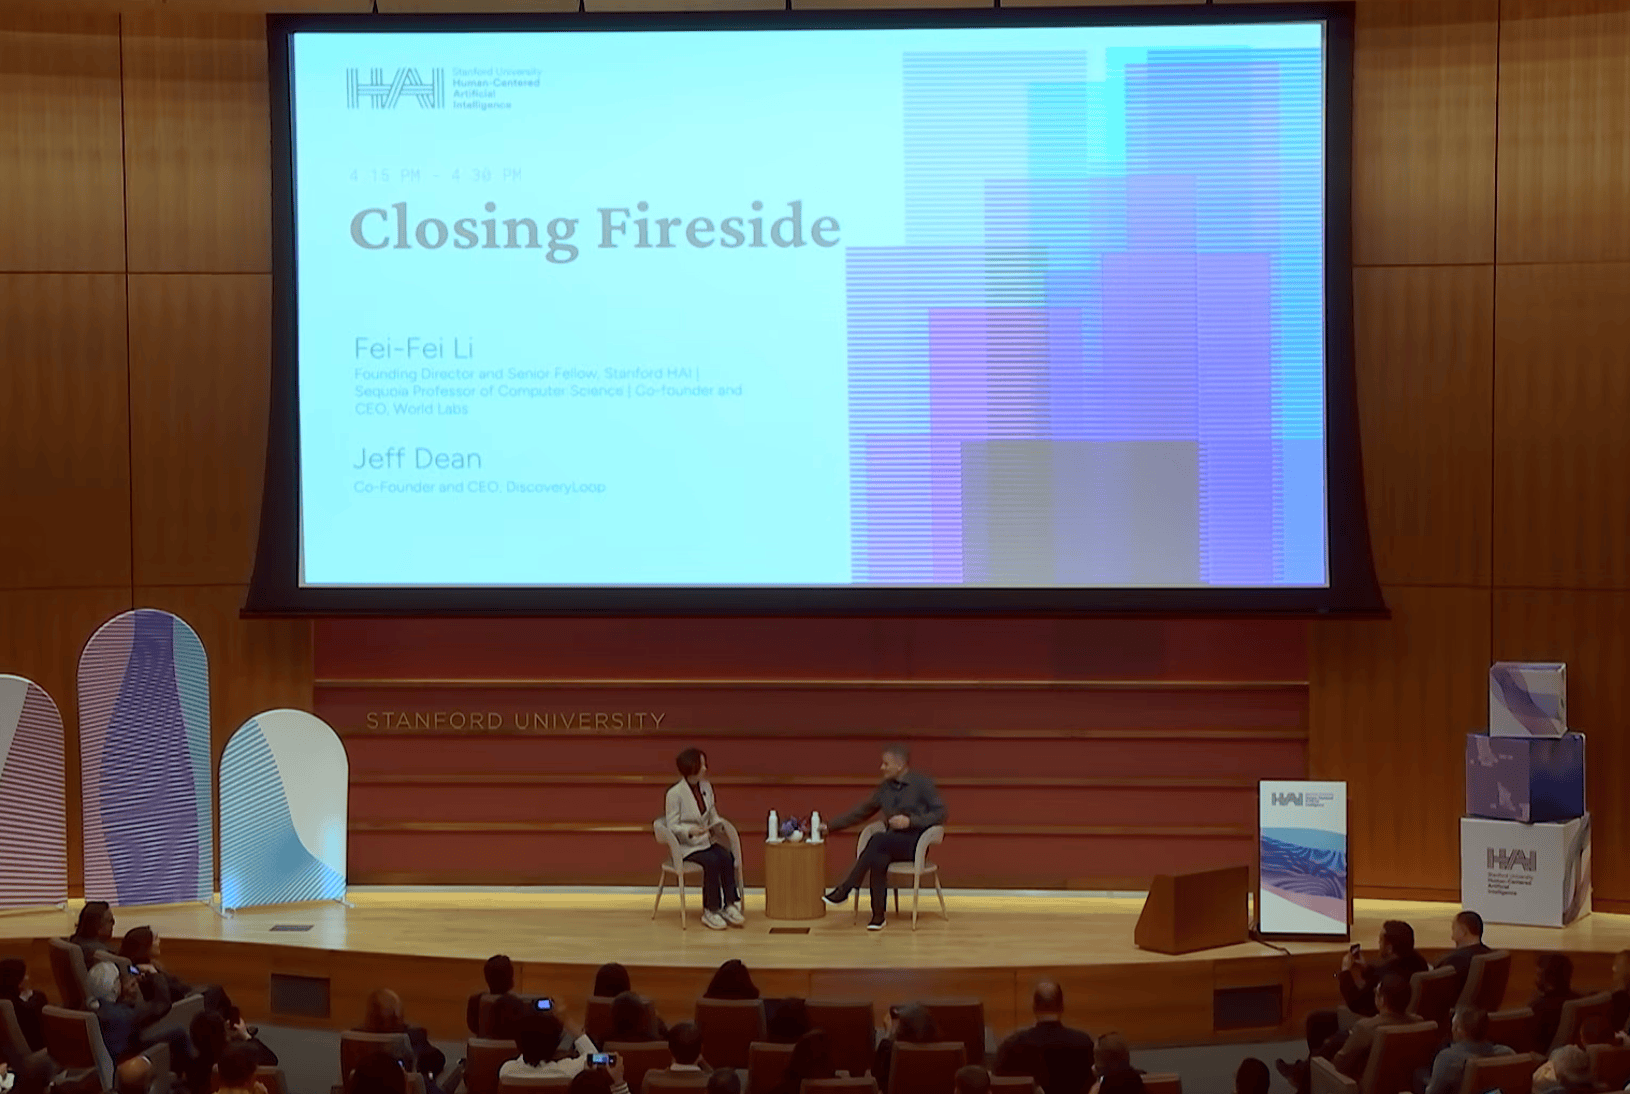
李飞飞: 我原本准备了非常极客的技术拷问。不过既然是对谈形式,我会兼顾提问者与探讨者的双重角色。
首先还是恭喜你们,我的第一个问题直击核心:为什么会在当下创办 Discovery Loop?
你们四位创始成员都在 Google 深耕多年,特别是你在 1999 年就已加入 Google。过去几年的行业技术飞跃世所公认,但我依然好奇,究竟是过去一两年间的哪个关键顿悟时刻,让你、Quoc、Sanjay 与 Oriol 共同认定:我们必须做一件截然不同的事,而且必须彻底脱离现有体系出来做?
Jeff Dean: 核心在于我们清晰看到了自动化系统在软件工程全生命周期中所展现出的惊人赋能潜力。
十年前 Quoc 率先主导了大量神经架构搜索(NAS)的先驱性研究,本质上这就是某种早期形态的递归自我改进系统:让算法自主寻优适配计算机视觉或自然语言任务的模型拓扑。
在那个年代我们就已验证了该路线的可行性。唯一的遗憾是,当时整个系统还依赖大量冗长、繁重且高度专有化的 Python 模板代码来硬编码搜索空间。
而今天,你完全可以使用高度自然的语义语言,直接向能力强大的基座模型与智能体集群提出宏观构想——比如“探索一套最契合特定核磁共振成像(MRI)特征解析的专用神经网络架构”,系统即可端到端完成后续的探索与验证。
这种交互维度的跃升,从根本上重塑了我们对计算系统边界与 AI 潜能的认知。如果能将这套系统的可靠性打磨至工业级水准,它所能撬动的工业价值将难以估量。我们一致确信,自然科学与重度工程领域,正是这套系统释放极致正向价值的最佳主战场。
李飞飞: 也就是说,真正催化你们走出体制创办公司的核心驱动力,正是这套兼具闭环运转与自我进化潜能的全新范式。