
AI写代码太快,基础设施跟不上了
GitHub,你怎么又出故障了……
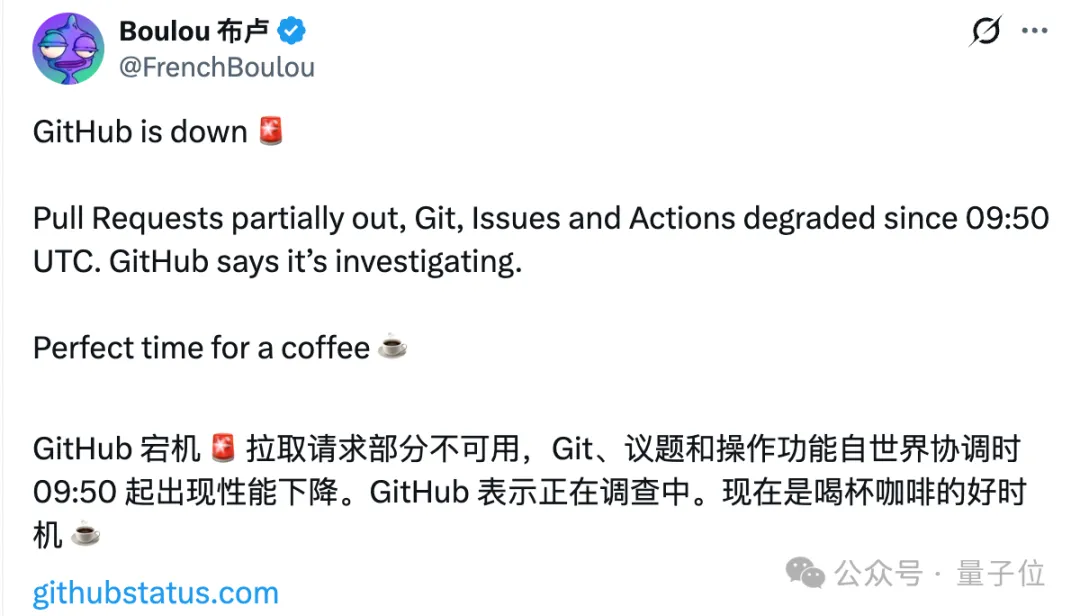
11月3日,GitHub官方状态页在一天之内记录了两起故障,其中一起直接影响了Git的核心操作。
到了4日,合并请求(Pull Request)等服务再次出现异常,导致部分请求失败或出现较长延迟。
代码改好了,正想让同事帮忙审查能否合入主分支,偏偏就卡在了这一步。
有网友对此调侃道:正好去喝杯咖啡。
就在GitHub忙着抢修时,Axios发布了一条独家消息:
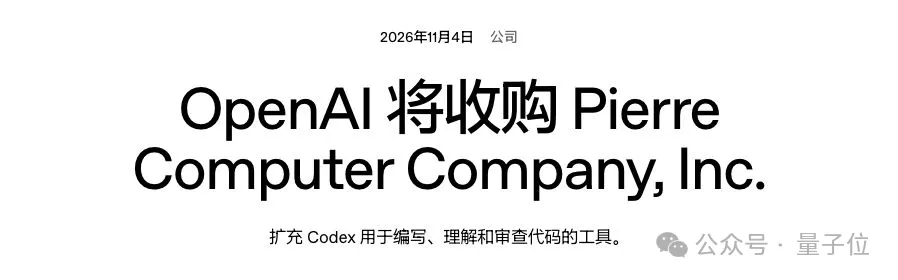
OpenAI拟收购代码托管工具开发商Pierre,目前交易仍待交割。
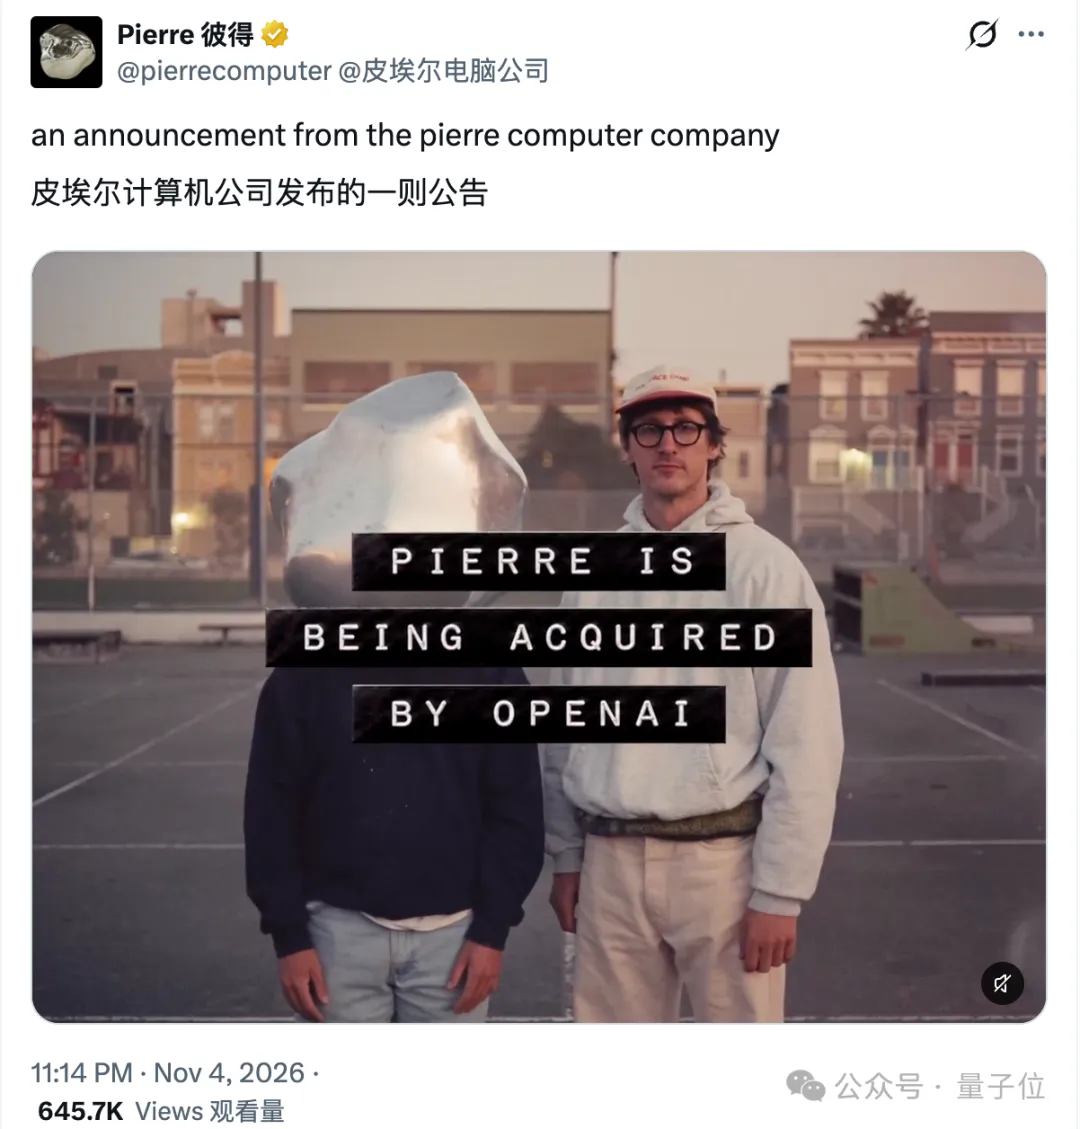
这两条消息凑在一起,时间节点显得尤为微妙。
不得不说,研发AI编程工具的各家公司中,确实已有好几家开始亲自接管代码管理了。
马斯克旗下的Cursor,已允许开发者将整个项目直接托管在Cursor内部。
Anthropic则更进一步,将自家工程师日常重度使用的主代码库,直接迁移进了自研系统。
这些头部公司为何纷纷盯上这一环节?
核心原因在于:AI写代码的速度越来越快,现有的代码托管基础设施已经逐渐跟不上了……
OpenAI自己造了一个,还准备再买一家
OpenAI自身就深切体会过代码底层基础设施跟不上的阵痛。
今年3月,The Information就曾报道,OpenAI工程师多次遭遇GitHub服务中断,公司内部正在开发一套替代工具。
到了11月2日——也就是前几天,OpenAI正式公开了自研的Git后端Pando,专门用于承接内部代码的存取与管理操作。
据工程团队介绍,过去一名工程师通常同时推进一份改动;而在引入Codex后,单人便能同时筹备数份改动。
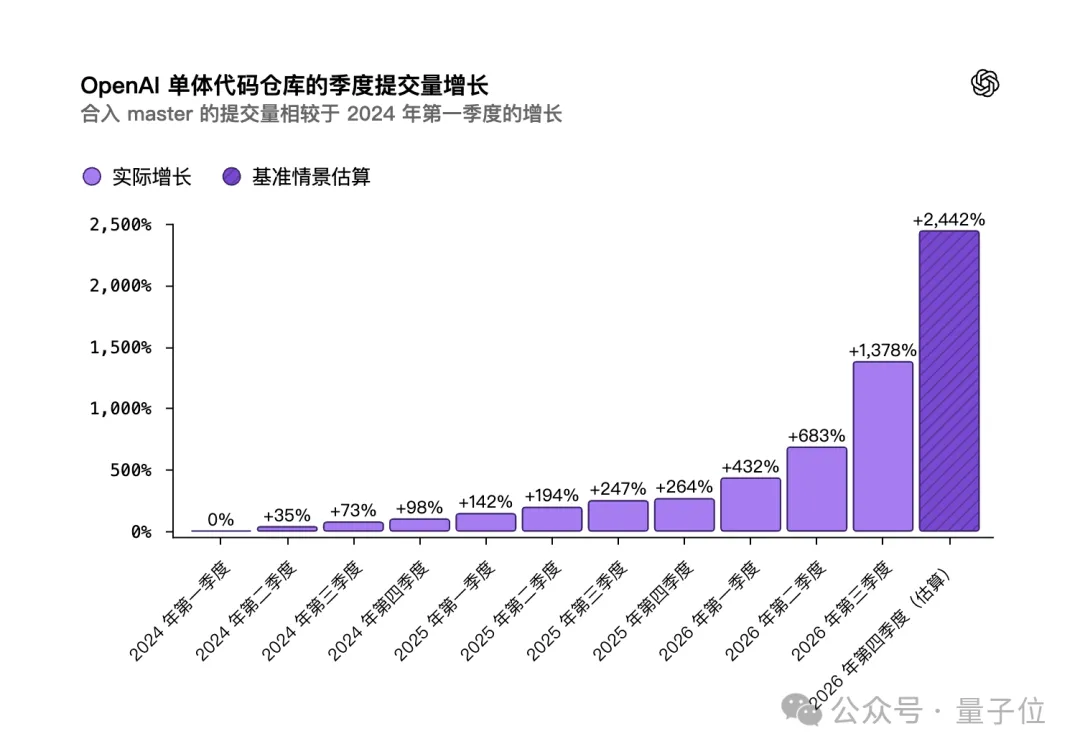
而每次推送代码,又会触发一系列自动化CI任务,执行代码拉取与静态检查。
写代码的工程师数量并未突然翻倍,但系统需要处理的吞吐量却成倍激增。
原有系统逐渐不堪重负,拉取、推送日渐迟缓,代码合并失败的频次也随之攀升。
Pando自4月起就已开始承接内部真实的研发流量。据OpenAI统计,系统切换后,单次推送的中位耗时下降了近八成。
在解决了自家内部工程瓶颈后,面向Codex用户,OpenAI还计划通过收购Pierre,把代码存储等核心能力直接融入产品当中。
说起来,Pierre的技术,不少开发者可能早就接触过了。
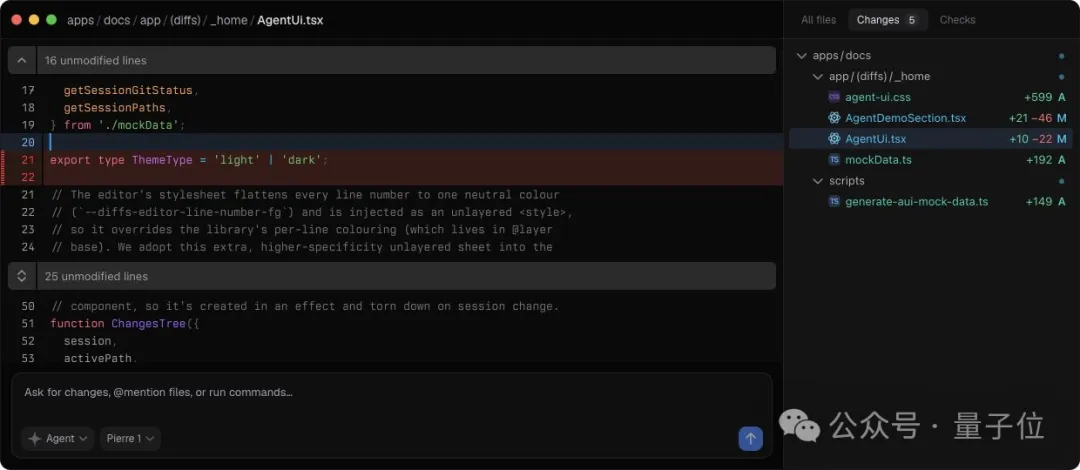
假设你让Codex修复一个Bug,它一口气修改了5个文件。
你点开文件列表,选中其中一个,再逐行核对新增与删除的代码——
前一个文件树交互,采用的正是Pierre开发的Trees组件;后一个代码差异对比,用的则是Pierre开发的Diffs。这两套工具此前就已接入Codex。
此外,Pierre旗下还有一项名为Code Storage的核心业务,其客户包括AI全栈应用开发平台Lovable。
用户在Lovable中输入几句自然语言,便能快速生成一个完整网站。在其底层,每个项目都需要依赖一个或多个Git仓库来保存代码与提交历史。
据Pierre今年8月披露的数据,Lovable当时每周新建仓库超过800万个,峰值达每秒250个。
OpenAI计划在收购交割完成后,将Code Storage的能力深度整合进Codex。
未来,开发者让AI生成代码、审查差异、保存版本并管理仓库,均有望在Codex平台内一站式完成。
目前,该笔交易仍需满足监管批准等交割条件。
Cursor开放代码托管那天,GitHub也挂了
大家可能还记得,8月14日,马斯克的SpaceX完成了对Cursor的收购。
仅三天后,Cursor自研的代码托管服务Origin便开启了早期测试。
戏剧性的是,偏偏就在8月17日,GitHub发生了一场持续长达7小时47分钟的大规模故障。
Cursor团队成员Matt Palmer当时发帖调侃道,他们本来想更早发布Origin,结果GitHub“又、又挂了”。
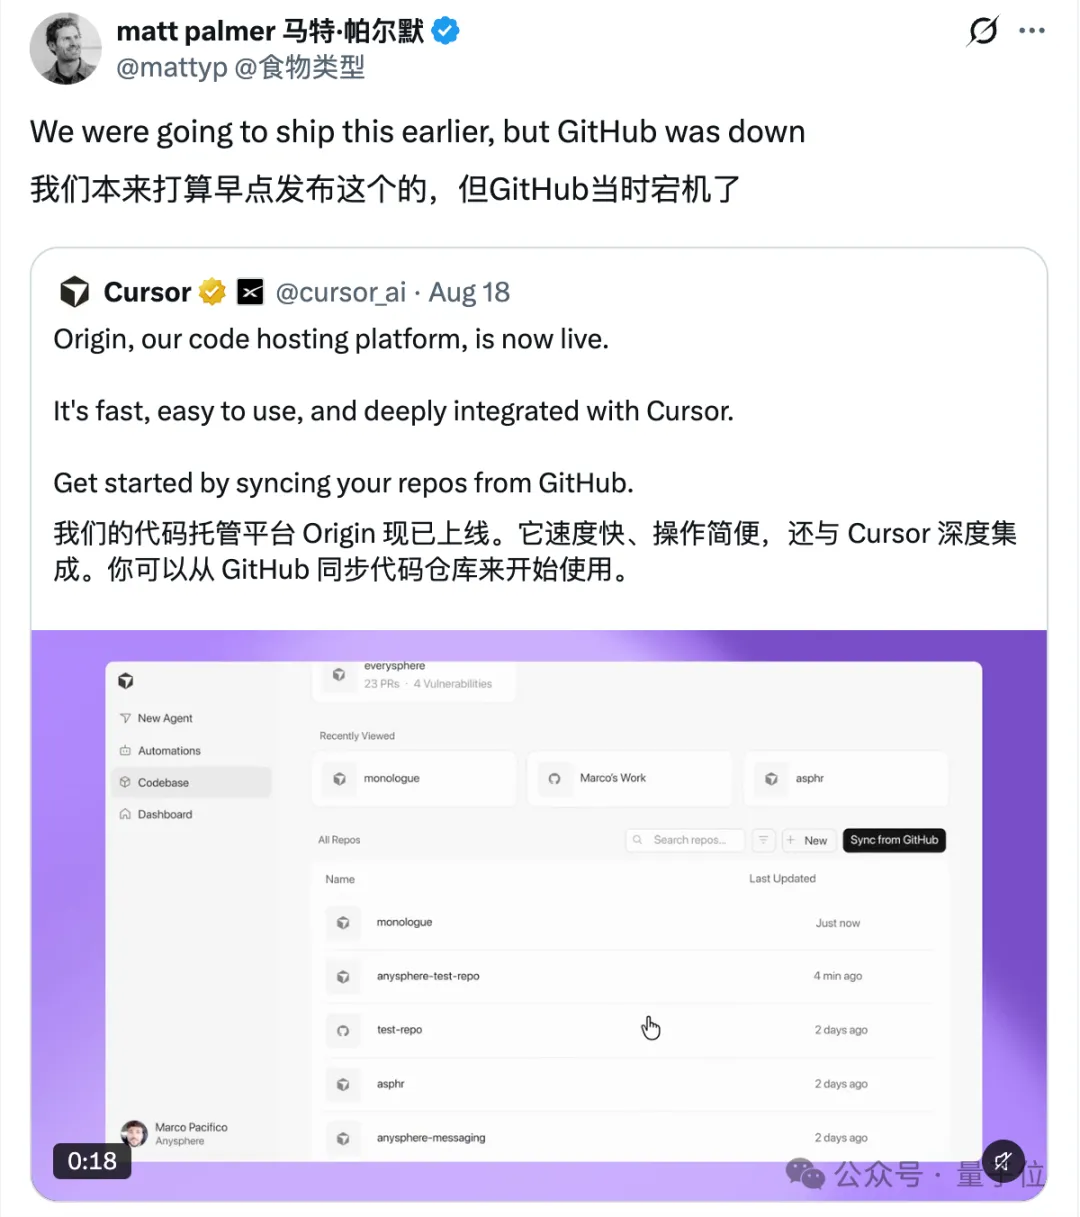
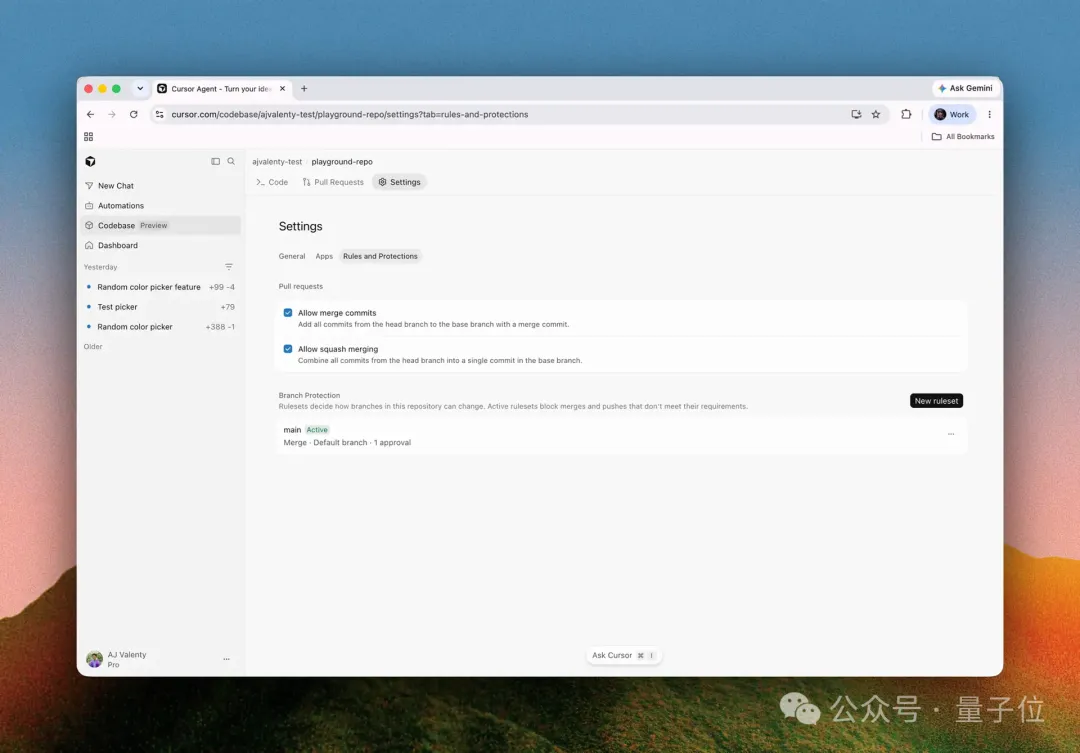
Origin为开发者提供了两种选择: 新建项目时,可以直接在Origin中创建仓库并将代码推送到Cursor,后续的代码评审(Code Review)、意见批注、分支合并等操作,均可完全脱离GitHub。
若是托管在GitHub上的老项目,也可以仅同步一份镜像至Cursor。
开发者在Cursor内发表的评论,协作者回到GitHub后依然可见,整体代码版本仍以GitHub为主源。
这就引出了一个现实问题:
从写代码、审查到代码合并,既然全流程都能在Cursor中顺畅解决,用户还有多少理由特意打开GitHub?
哪怕老项目的仓库根源还在GitHub,审查人员的工作重心也已经开始向编辑器内转移。
Claude写得太快,Anthropic自己造了一套
如果说OpenAI与Cursor主要是将开发链条集成进客户端与工具层,那么在Anthropic内部,研发吞吐量的激增已经倒逼其不得不重写底层代码管理系统。
究其根源,依然是Claude写代码的速度过于迅猛。
据Anthropic披露的数据,今年5月,公司平均每天合并的代码修改约为2500项;而到了9月,这一数字已暴增至每天超过3万项。
这意味着,团队日常维护的核心主干每天要接纳逾3万次代码合并。
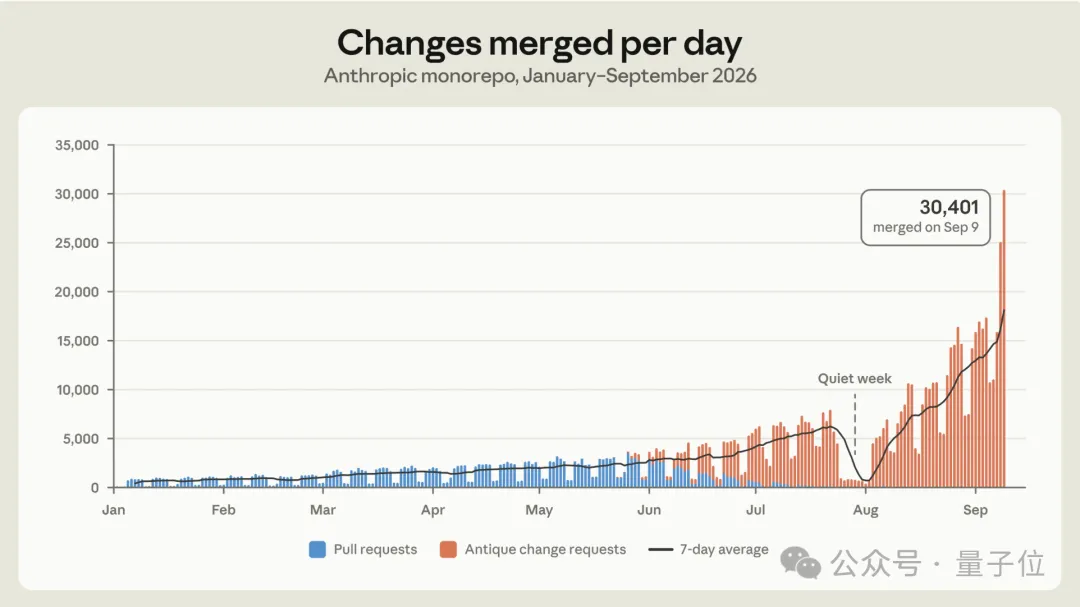
仅用于自动化测试等工作的持续集成任务,每天拉取代码的频次就高达约2500万次。
在业务高峰期,公司曾维护着数百个Git镜像副本来分摊并发负载。但随着主仓库演进速率的指数级攀升,各副本之间的数据同步与一致性维护变得愈发困难。
工程师深入分析后发现,高频拉取代码的调用方大部分是全天候运行的Agent和自动化任务。
很多任务仅需核验某个文件具体修改了哪几行,根本无需将整座仓库完整克隆到本地。只要让服务器算好差异并将结果返回即可。
基于这一思路,Anthropic自研了版本控制系统Scion。
该架构改为按需拉取:客户端仅获取当前变动所需的文件,而历史追溯、提交创建、分支合并等高开销计算全部交给服务端处理。
最终,7名工程师借助Claude的辅助,历时5个月打造出这套内部版本控制系统及其配套代码审查平台Antique,并将公司主代码库全量迁移至该系统。
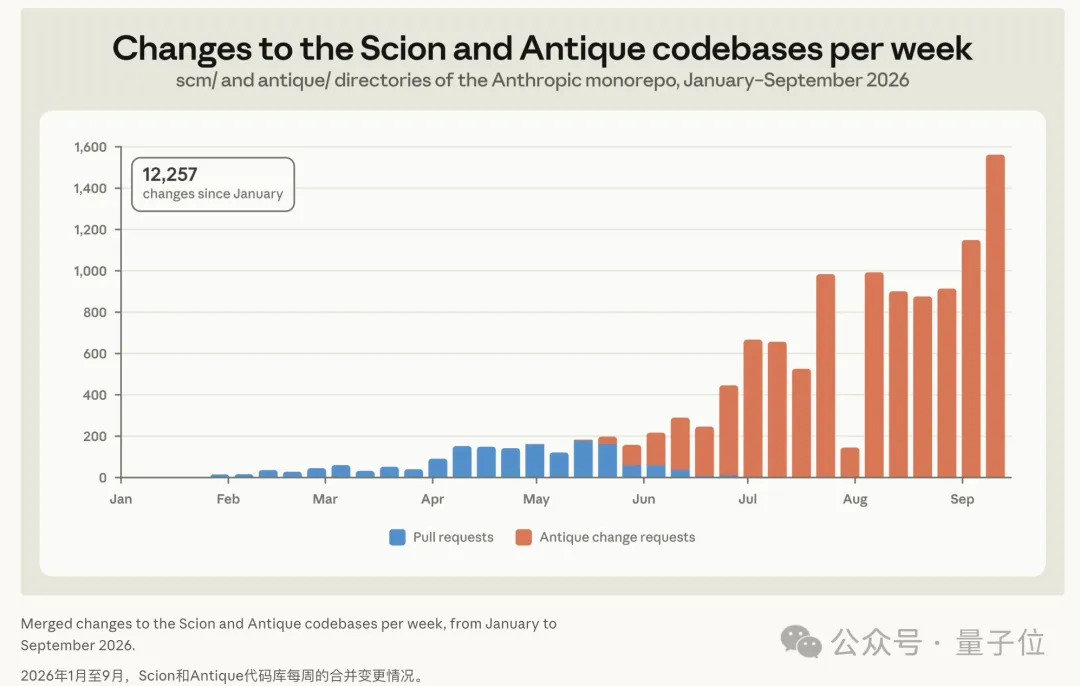
不过,Scion目前主要服务于Anthropic内部超大规模、高并发修改的核心仓库。
Claude Code的开源项目及对外社区资源,现阶段仍保留在GitHub上。
一天三万项改动,谁来检查?
当代码读取效率提升、存储通路打通后,一个更具挑战性的难题浮出水面:
每天产生如此庞大数量的修改,究竟该如何判定其质量与可用性?
在近期的一场对谈中,Anthropic的Addy Osmani分享了他们的工程实践:
第一道防线先交由Claude执行自动化初审,并为其提供必要环境,使其像真实用户一样去验证功能逻辑。
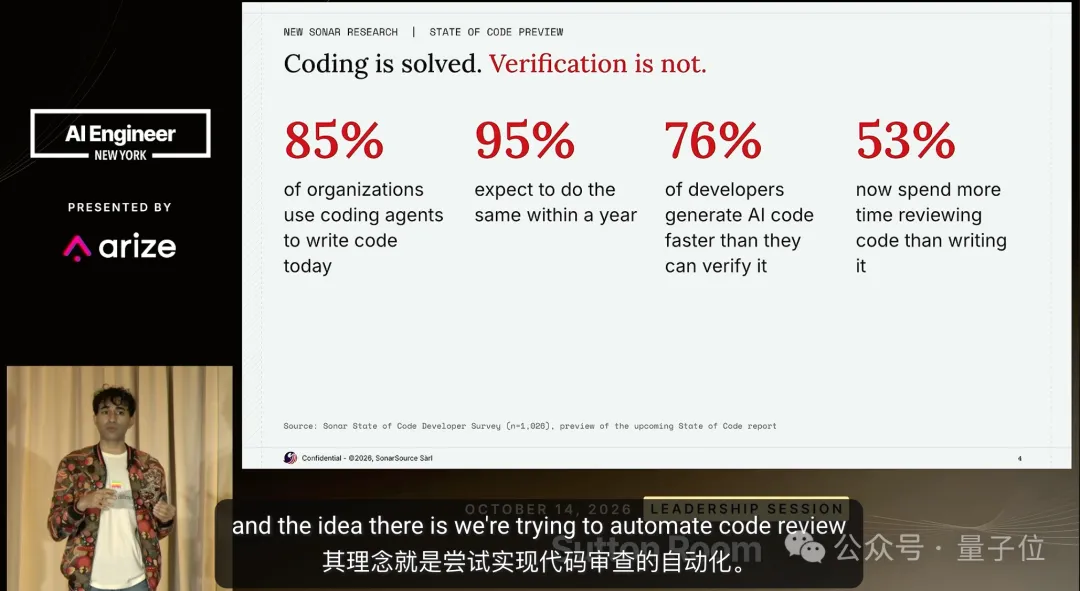
以网页修改为例,AI需自行调起浏览器,校验页面排版、交互功能,并触发对应测试套件。
随后,工程师只需审查AI整理生成的验证证据链,包括操作录屏、截图以及自动化测试结果。所有改动仍严格落实到具体责任人,一旦上线出现异常,由对应人员兜底处理。
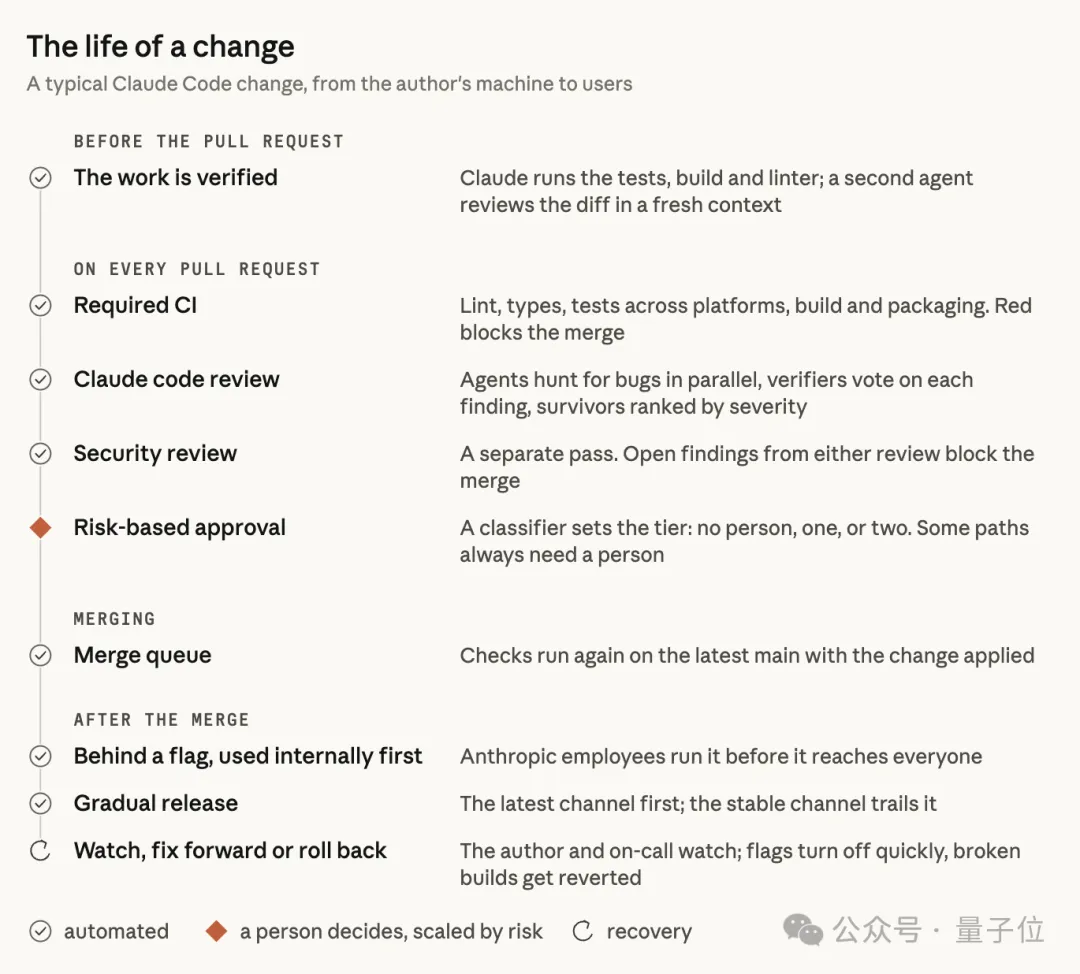 △Claude Code团队公布的代码改动检查与发布流程
Anthropic工程博客还提到了一个更棘手的并发场景:
单轮测试执行期间,主代码库中可能已并行并入了成百上千项全新改动。
面对如此庞大的吞吐量,传统的仓库全局锁排队合并机制几乎彻底失效。团队遂将重心转向合并后、上线前的高频自动化回归测试。
Anthropic亦坦言,高并发场景下的代码冲突在所难免。
他们表示,Claude在发现并解决代码冲突的响应速度上通常快于人类工程师,但官方目前尚未对外公布具体的量化评估指标。
One More Thing
看到这里大家或许会问:面对来势汹汹的AI浪潮,老牌代码托管巨头GitHub又在做什么?
实际上,GitHub并没有闲着,同样在全方位重构其底层架构。
10月28日,GitHub官方披露,今年已累计扩容400万个CPU核心及160PB高速存储,并持续推进向Azure云原生基础设施的迁移。
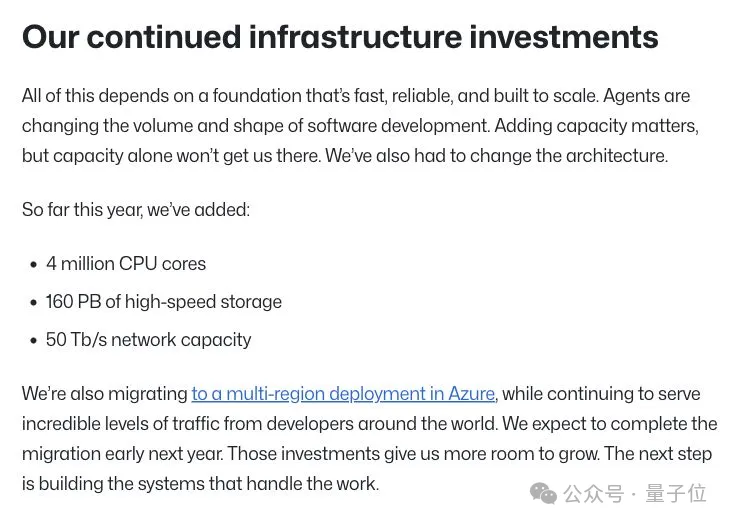
在硬件堆叠之外,并发调度机制也迎来了实质性优化。
过去,哪怕多个Agent分别向不同分支提交改动,在写入阶段仍可能因仓库粒度的限制而陷入串行排队。GitHub目前正推进分层并发优化,解耦不同分支等引用的更新逻辑,大幅减少等待延迟。
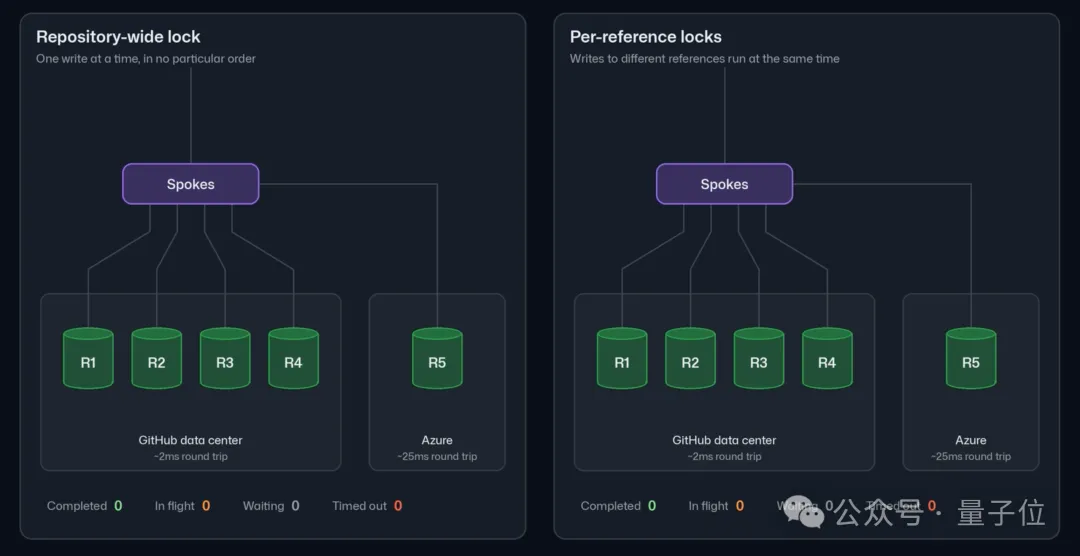 △左侧按整个仓库排队,右侧允许不同分支等引用的更新并行进行
此外,针对代码提交后涌入的大规模自动测试读取,GitHub正推行读写分离架构。当代码读取请求暴增时,单独针对只读集群动态扩容,彻底避免读写争抢资源引发的卡顿。
这些底层改造目前仍在分步灰度上线。
从OpenAI、Cursor亲自下场布局代码托管,到Anthropic重写底层版本控制系统,再到GitHub倾力重塑基建——
AI生产力带来的代码“洪峰”,正在全方位重塑软件工程的基础设施。
而对于身处一线的开发者而言,诉求其实非常朴素:
代码写好了,各项测试也跑通了,准备合入分支的时候,可别再挂了……
参考链接:
[1]https://x.com/FrenchBoulou/status/2117919227147640978
[2]https://x.com/pierrecomputer/status/2117999036175188183
[3]https://www.axios.com/2026/11/04/openai-pierre-computer-github
[4]https://www.anthropic.com/research/redesigning-source-control
[5]https://www.youtube.com/watch?v=AnsXWH2_EBU