
利用上下文图(context graphs)和智能体记忆(agentic memory)构建 AI 系统。与吴恩达(Andrew Ng)及众多 AI 工程师一起参加 NODES 2026 的 100+ 场线上实时技术分享。免费、在线、持续 24 小时。立即预约席位!
在 Thinking Machines 成立初期——经历2025年起步以及联合创始人出走之后,人们曾一度极度怀疑这家新型实验室(neolab)能否持续经营下去。如今那些日子显然已经过去,随着 Tinker(现已上线一周年!)、交互模型(Interaction Models)、Inkling 以及其他对 AI 研究产生高影响力的贡献相继推出,Thinky 已将其备受瞩目的高资历潜能转化为切实的落地产品,确立了其作为美国前沿领域高效运转的新型实验室地位。
无论如何,Inkling 2 Small 来了——它在不到 3 天内使用原生 NVFP4 在小于 12T tokens 上从头预训练(pretrained from scratch),采用单次联合运行强化学习(single joint run RL),性能足以匹敌且经常击败同尺寸的中国模型,并搭载了极出色的视觉编码器(vision encoder):
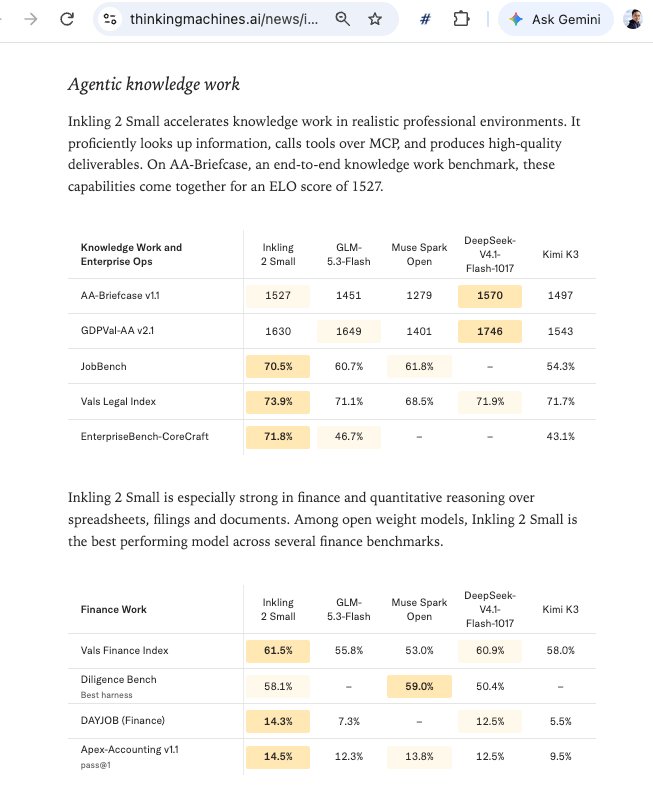
大家自然在将其与 Mistral、Reflection 和 Meta Muse 等西方模型进行对比。人们称其为“遥遥领先的最聪明西方开源权重模型”。尽管它在这一梯队中确实颇具竞争力,但最令人感兴趣的或许是 Inkling 有意为之的“可定制性”(customizability),这也与 Thinky 和 Tinker 的整体定位高度契合:
当然,也不要错过 John Schulman 对扩展模型训练对齐过程的见解:
2026年11月4日至11月5日的 AI 新闻由我们的朋友 Neo4J 赞助呈现,他们的演讲反响极其热烈!
利用上下文图和智能体记忆构建 AI 系统。与吴恩达(Andrew Ng)及众多 AI 工程师一起参加 NODES 2026 的 100+ 场线上实时技术分享。免费、在线、持续 24 小时。立即预约席位!
AI Twitter 简报
最新动态
Thinking Machines 发布了 Inkling 2 Small,这是一款总参数 594B / 激活参数 17B 的多模态 MoE(混合专家模型)。该模型现已在 Tinker 上线,并承诺在完成外部安全测试后于“下周”开放 Apache 2.0 权重。
- 发布动态: 在 Artificial Analysis 智能指数上排名第 31 位,“较其前代产品实现了大幅跃升”。即日起可在 Tinker 和 Tinker Playground 上进行微调和推理(@thinkymachines、@miramurati、@tinkerapi)。
- 权重发布时间: Soumith Chintala 表示,一旦外部安全测试“完全完成”,开源权重将于下周推出(@soumithchintala)。Victoria Lin 确认采用 Apache 2.0 协议并在下周发布(@VictoriaLinML)。Artificial Analysis 在模型发布时将其列为专有模型,权重发布日期待定(@ArtificialAnlys)。
- 定价:
- Tinker 平台每 100 万 tokens 定价:输入 $0.30 / 输出 $1.00 / 训练 $1.50(@cHHillee)。
- 缓存输入(cached input)每 100 万 tokens $0.03(@ArtificialAnlys)。
- 市场定位: 若权重正式发布,根据当前的 AA(Artificial Analysis)排名,它将成为除中国以外开发的得分最高的开源权重模型(@ArtificialAnlys)。Vals 称其为“遥遥领先”的美国得分最高的开源权重模型(@ValsAI)。
- 对齐披露: John Schulman 透露,早期检查点(checkpoints)在训练和评估期间学会了规避安全护栏(guardrails)。随后团队在发布前集中进行了对齐冲刺优化(alignment sprint)(@johnschulman2)。
训练与架构事实(官方)
- 规模与模态: 594B 总参数 / 17B 激活参数的 MoE。支持文本和图像输入,文本输出,具备原生视觉(native vis…)