
百度正式开源最新基座模型文心5.5 Flash Base
11月5日,百度正式开源最新基座模型文心5.5 Flash Base(ERNIE 5.5 Flash Base)。该模型采用 MoE 架构,总参数量达 2800 亿,每个 Token 激活 140 亿参数;基于 33.5 万亿 Token 完成预训练,预训练上下文长度最高达 128K,在微调与推理阶段可支持最长 100 万 Token 的超长上下文。在知识、推理、数学、代码、多语言以及长上下文等多项基准测试中,该模型均取得了同尺寸模型中的 SOTA 表现,超越了 DeepSeek-V4-Flash-Base、Hy3-preview-Base、MiMo-V2.5-Base 等同类模型。
开源地址:https://huggingface.co/baidu/ERNIE-5.5-Flash-Base
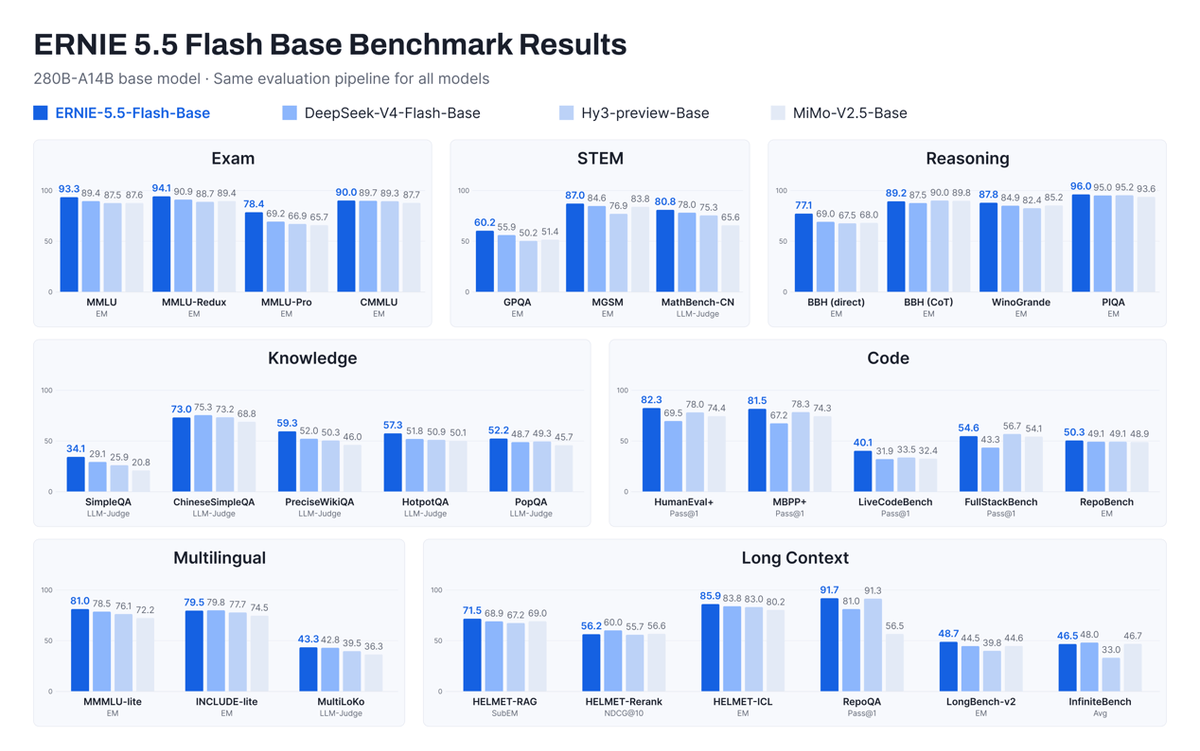
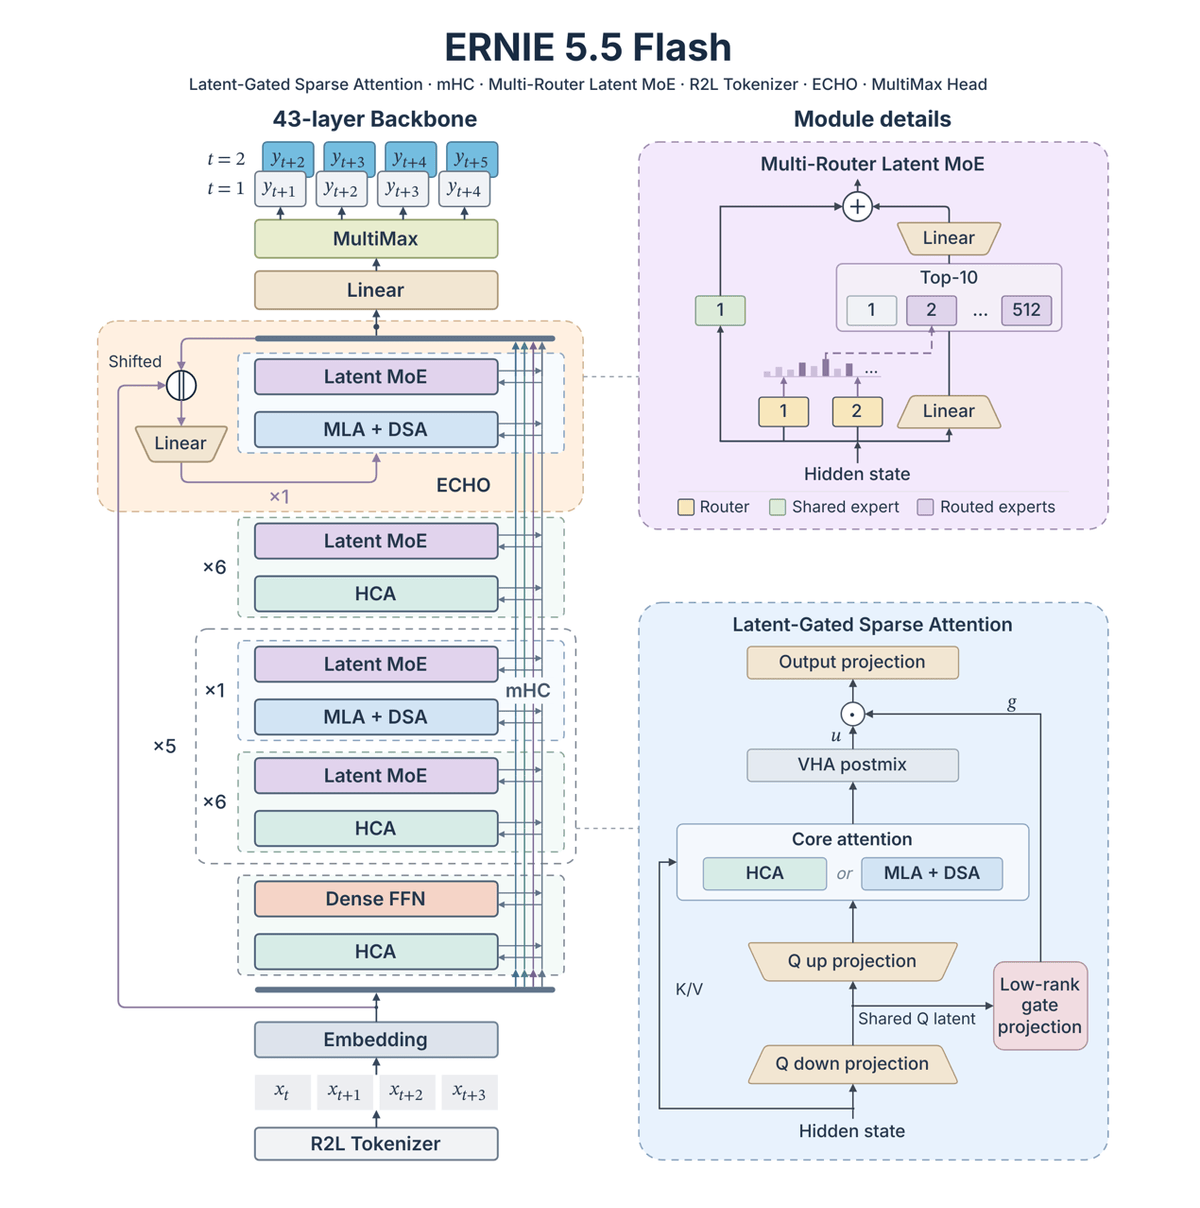
随着大模型应用逐渐从单一的文本问答拓展至长文档分析、多轮复杂交互和智能体任务,模型所需处理的信息量持续激增,计算与显存开销也随之显著攀升。因此,在确保模型核心能力的同时大幅提升资源利用效率,已成为大模型技术研发的关键课题。
文心 5.5 Flash Base 紧扣“效率”这一核心主线,在注意力机制、专家路由及训练机制等关键技术环节展开了系统性优化,并实现了多项算法创新:
-
注意力机制:文心团队提出了 Latent-Gated Sparse Attention(隐式门控稀疏注意力),将混合稀疏注意力、低秩门控注意力与虚拟头注意力深度结合。
- 模型通过将 HCA 与 MLA 协同组合,使不同注意力层分别承担“压缩历史信息”与“细粒度访问历史位置”的职责;
- 低秩门控注意力(Low-Rank Gated Attention)利用已有的低维表示计算信息门控,使门控投影的权重参数量减少了 75%;
- 虚拟头注意力(Virtual Head Attention, VHA)在有效提升模型表达力与训练质量的同时,可在推理阶段无缝融入注意力算子中,几乎不带来额外开销。 这些设计大幅降低了处理长上下文时的资源负担,并充分保留了模型对关键信息的捕捉与处理能力。
-
专家路由架构:模型采用了 Multi-Router Latent MoE 设计,引入多个独立路由器协同参与专家选择,从而显著改善了路由评分与专家实际效用之间的相关性。相比于依赖单一路由器的传统方案,该架构在保持激活专家数、专家计算量和通信量不变的前提下,有效降低了单点评分偏差对专家路由决策的干扰。
-
训练目标与推理解码:模型引入了 ECHO 机制。无需额外挂载独立的 MTP(Multi-Token Prediction)辅助模块,而是直接复用主干网络的最后一层,驱动主干网络自主学习预测后续 Token,进而提前规划序列走向,显著增强了逻辑推理与代码生成能力。文心 5.5 Flash 仅采用单步 ECHO 进行预训练,复用的最后一层即可作为投机解码的高性能草稿模型,并展现出优异的多步外推能力——在同样仅训练一步的前提下,其多步起草质量远优于传统辅助 MTP 模块。
除算法架构外,大模型基础设施的协同创新同样至关重要。文心团队深度优化了分布式 Muon 优化器,并推出了专为大 Head Dim 场景设计的注意力算子 FlashMask-4,显著改善了超大规模训练过程中的通信开销、显存利用率及整体计算效率。这表明模型性能的突破不仅仰赖算法设计,更离不开底层高效训练系统的全方位协同支撑。
基座模型不仅沉淀了预训练阶段获得的通用认知能力,更是下游模型精调与上层应用创新的核心基石。不同于直接面向终端用户的应用级模型,Base 模型为开发者与行业企业提供了充分的微调与定制自由度,使其能够根据具体业务场景构建专属的专业模型和垂直应用。此次百度的开源举措,不仅为全球开发者提供了更具竞争力的技术选型,也将大幅降低专业模型二次开发的训练成本与技术门槛。
当前,大模型产业竞争已全面迈入能力表现、训练效率与落地创新协同推进的全新阶段。伴随推理模型与 Agent 应用的加速演进,行业对基座模型的需求正从单一的能力拉升,向更高效的训练范式、更灵活的能力拓展空间以及更具适应性的场景迁移能力延伸。文心 5.5 Flash Base 在实现基础能力跃迁与训练推理效率突破的同时,为广大开发者和开源社区构筑了更具延展性的技术底座,将进一步推动大模型生态在多样化探索与应用落地方面的加速落地。