
一个拥有 20 亿参数(2B)的模型,能够从任意类型的文档中精准提取你所需的字段,在表现上击败了我们测试过的所有前沿大语言模型(frontier LLM),而成本仅为后者的几分之一。
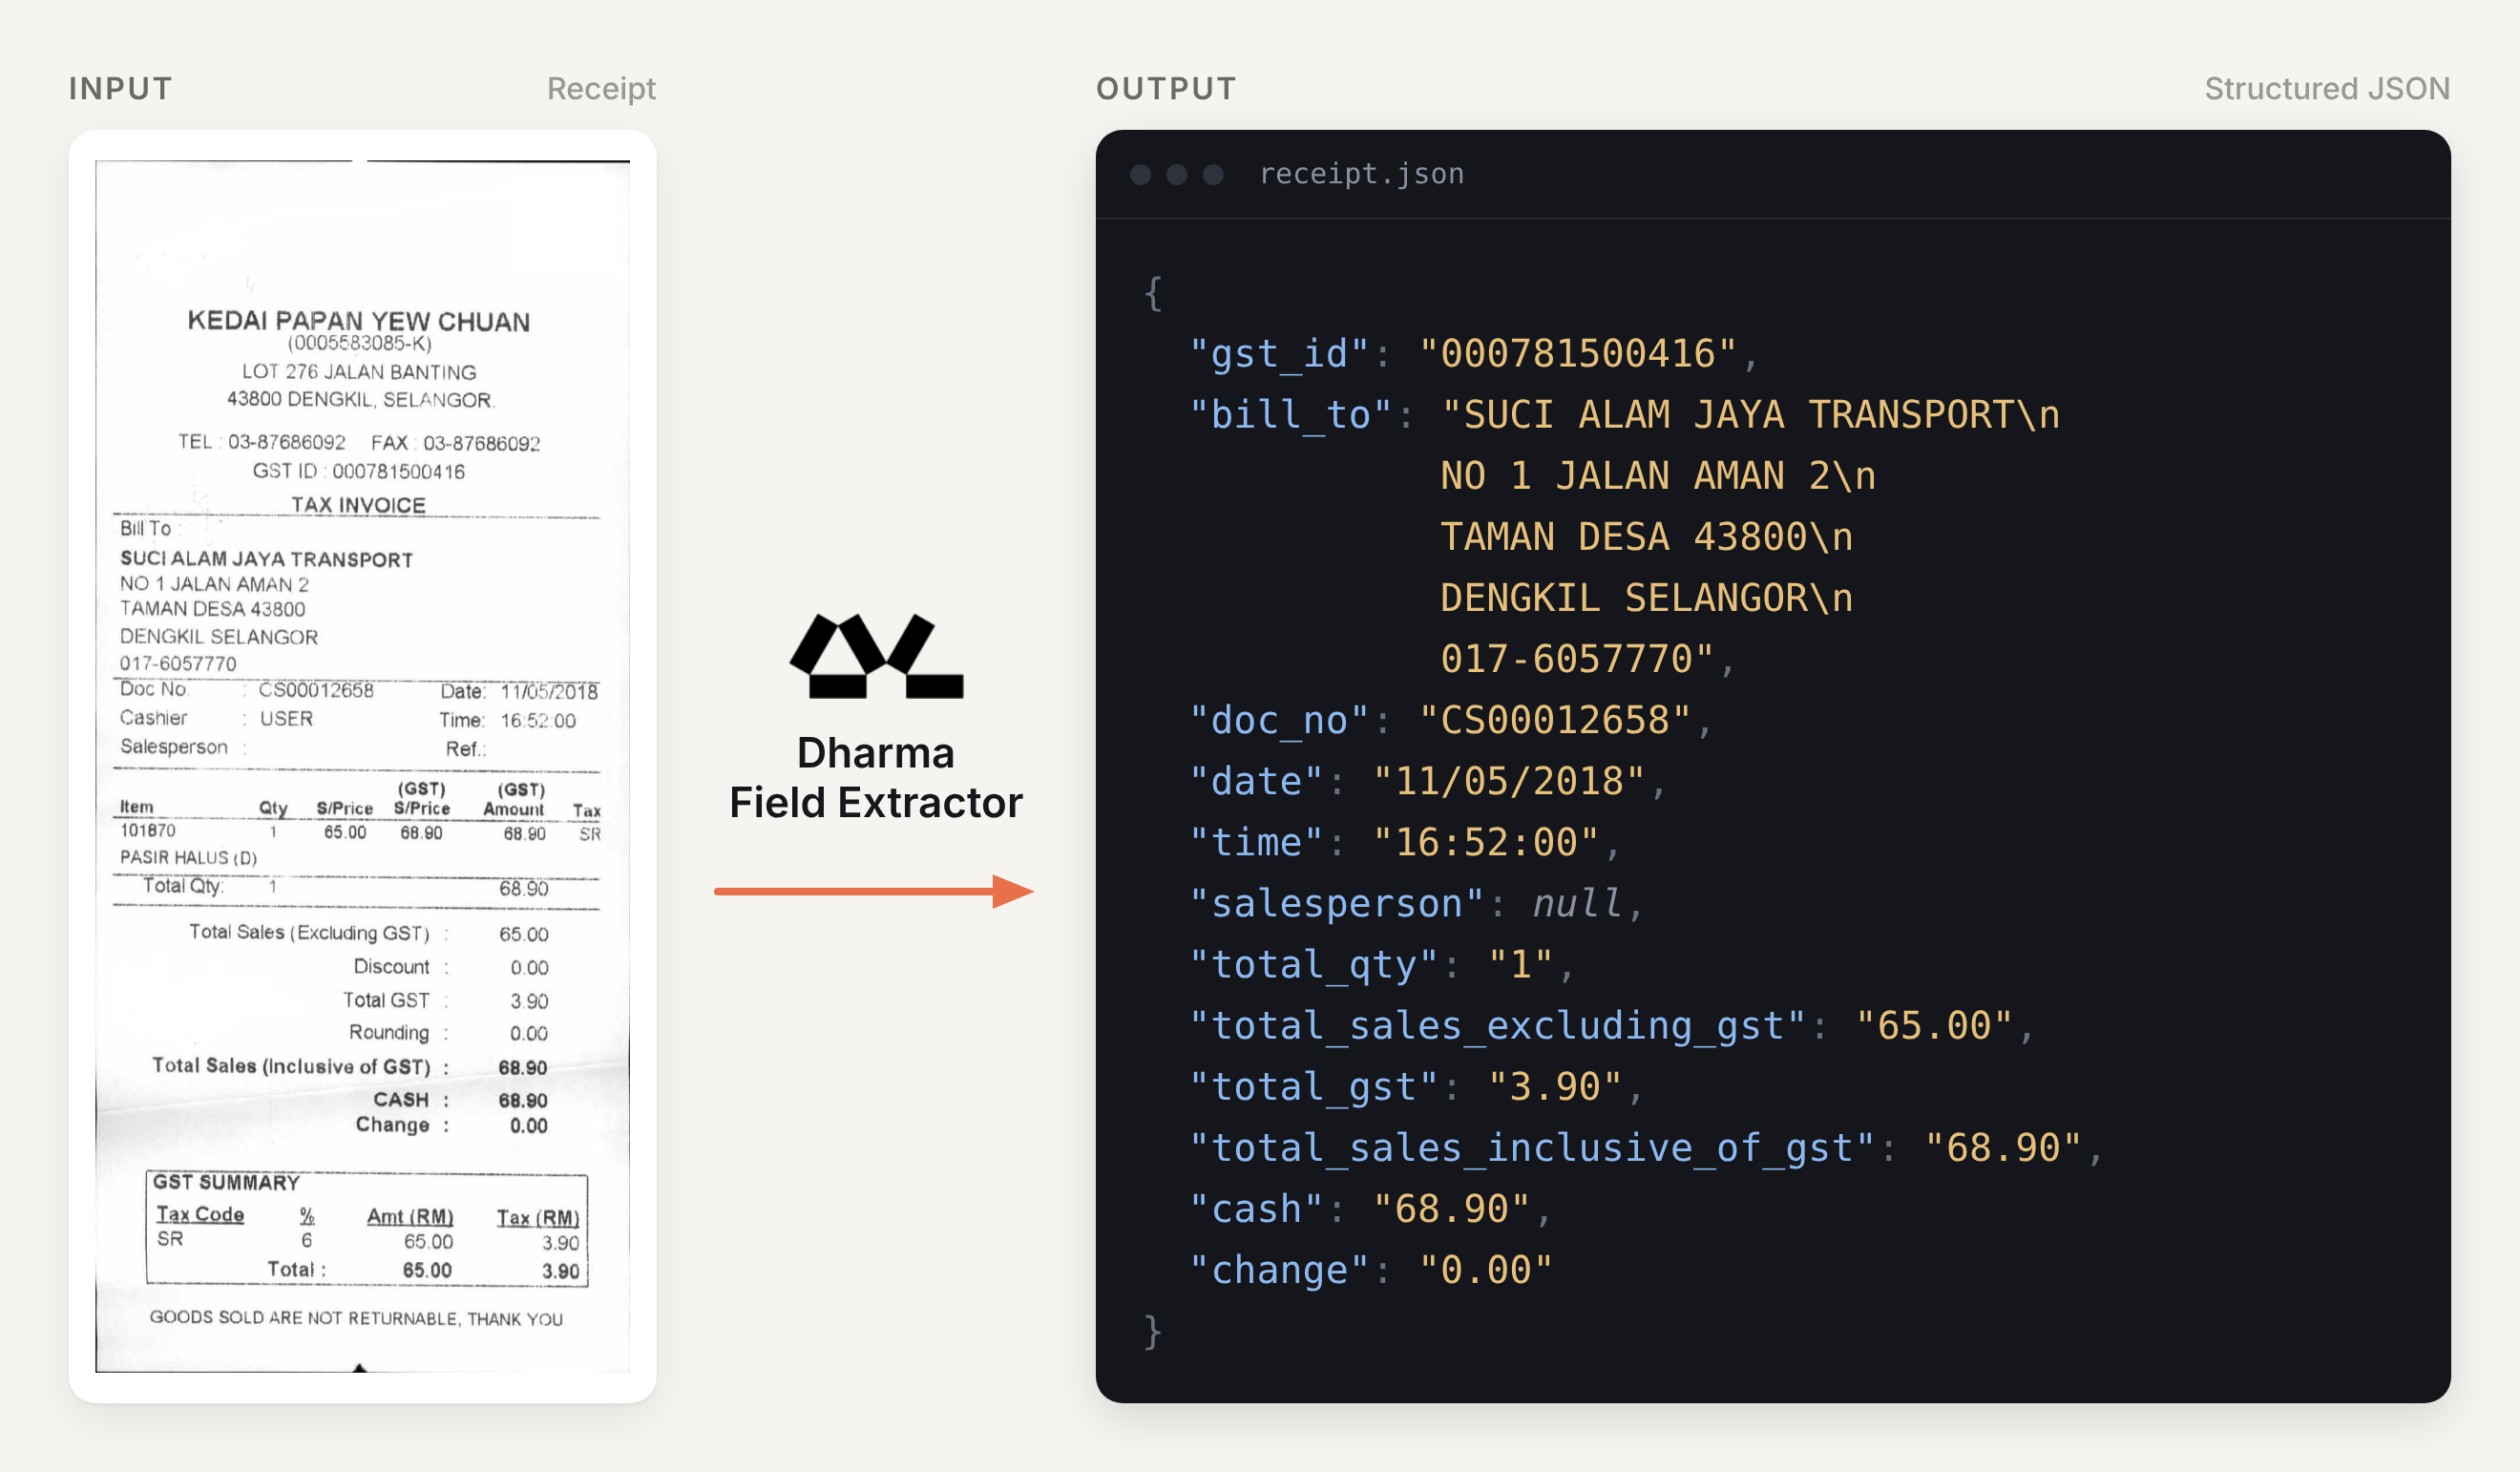 今年 4 月,我们发布了 DharmaOCR-LITE,这是一款专为广泛文档类型进行光学字符识别(OCR)优化的专业模型,支持从合同、法院卷宗到发票、身份证件和表单等多种内容。该模型背后的论文为领域专业化(domain specialization)提供了一个针对性强且经过精确验证的范例:一个与任务更贴近、经过专门训练的小型模型,能够在特定任务上击败通用的前沿模型 API。
OCR 能够输出页面上的文本,并忠实还原原始格式。如果你的目标是处理完整文档,比如从头到尾通读一份合同,或是将手稿进行数字化归档,这正是你所需要的。
然而,现实中存在另一种完全不同的业务需求:你不需要整页内容,而是需要从中提取特定的字段,并转化为下游系统可以直接使用的格式。例如,将发票上的每一项明细作为列表提取出来;从医疗检查申请单中提取患者姓名、检查项目和日期,以便直接推送到排程系统;或是从身份证件中提取字段,直接映射到员工档案数据库的对应列。
如果直接对这类文档运行 OCR,你只能得到按行打印的所有文本内容,无法得知哪个字符串是检查项目、哪个是日期,或者哪个数字代表总金额。在数据写入数据库之前,依然必须有人编写代码来将每个值映射到正确的字段上。
目前,通用的前沿大语言模型(LLM)通过精心设计的提示词(prompting)也能完成这项工作。但面对许多企业必须高频、大批量处理的业务场景,使用前沿 API 的定价和延迟来解决一个定义明确的问题,很快就会变成一种代价昂贵的方案。
因此,我们专门为此构建了一个专属模型。这款字段提取模型(Field Extractor)接收文档图像,并支持两种模式:要么提取其能识别到的所有内容,要么依据给定的严格数据结构规范(schema)进行填充。它最终会返回结构化的 JSON 数据:具备明确类型、按字段逐一归类,并在文档存在多层级时保持正确的嵌套结构。发票返回的结果会将每一项明细作为有序列表排列,包含各自的数量与金额,并附带总计金额。身份证件返回的结果则会直接对应到系统所需的存储字段及预设命名。同一个模型权重(checkpoint)即可统一处理所有场景,无需针对特定类型进行微调(fine-tuning)。
你可以在此处亲自试用。
模型的功能
假设每天早晨系统都会接收一批供应商发票,而你只需从每张发票中提取四项内容录入系统:供应商名称、发票编号、到期日和总金额。这与医疗检查单录入排程系统,或合同录入合规系统的逻辑如出一辙——在这些场景中,真正重要的是合同当事人、合同期限、违约责任条款和罚金数额。你不需要整页文档,你只需要特定的