
我们推出了 StateBench,这是一个针对长上下文状态追踪(long-context state tracking)的基准测试——旨在评估语言模型随着长文档内容的推进,对其中实体信息的演变保持追踪的能力。
状态追踪是众多任务的基础:从阅读代码中变量的赋值与重命名,到跟随故事中角色的走动与物品的易手。例如,如果一部推理小说在谋杀案发生前写道“约翰把刀交给了玛丽”,那么掌握每个角色的状态发生了改变便至关重要。然而,并非所有状态追踪问题的难度都相同:有些只需要找到最新一次的更新;而更难的问题则需要追踪一长串的变化链条,其中只要错过一步就会导致最终答案错误。例如,上述推理小说状态追踪的一个更难变体是:约翰把背包里的物品交给了玛丽,而此前已知爱德华曾把一把刀放进了约翰的背包。
在具有长依赖链的复杂状态追踪变体上,Transformer 架构存在已有明确理论证明的局限性,这也促成了诸如 Gated DeltaNet 等能够向前持续传递运行记忆的循环(recurrent)与混合(hybrid)架构的诞生。现有的状态追踪测试往往侧重于最极端的高难度情况,但随着这些新架构设计越来越普及,研究人员需要弄清楚每种架构究竟能处理哪些类型的状态追踪。我们不仅希望了解不同架构在最难的状态追踪任务上的差异,也希望了解它们在更简单、可能更常见的任务上的表现。
为此,我们开发了 StateBench 基准测试,以涵盖不同复杂度的状态追踪问题,并用它来评估不同架构语言模型之间的差异。我们发现,当直接在这些任务上进行训练时,循环与混合模型可以展现出远超 Transformer 的泛化能力;而包括 Gemini 3.8 Flash、Claude Opus 5.5 以及 GPT-6 Sol 和 Luna 在内的前沿模型,随着输入长度的增加,在更复杂形式的状态追踪上仍会出现崩溃。
状态追踪的四个层级
StateBench 包含四个难度层级,允许复杂度逐步提升的状态更新操作。对于程序员而言,这些状态追踪复杂度的层级可以理解为支持不同类型的变量赋值操作:
-
**R-平凡问题(R-trivial problems)**使用不可变赋值(immutable assignment)。变量的值永远不会改变,因此模型只需要找回它最初被赋予的值。在代码中,这类似于
let x = 4;;在日常生活中,这就像出生日期——它是固定不变的。 -
**非周期问题(Aperiodic problems)**允许按值重新赋值(reassignment by value)。模型需要找到最新的值,并且可以忽略早先的值。在代码中,这类似于先执行
x = 4,随后又执行x = 2;在日常生活中,这就像恒温器,最新的设定决定了当前的温度。 -
**可解问题(Soluble problems)**增加了自引用更新(self-referential updates)。每次更新都建立在当前值的基础之上,因此模型必须持续向前传递变更,而不能仅仅寻找最新的一次赋值。在代码中,这类似于
x = x + 5;在日常生活中,这就像比赛得分,每一分都会累加到现有总分中。 -
**一般有限问题(General finite problems)**增加了引用赋值(assignment by reference)。一个变量可以获取另一个变量的当前值,从而在不同的更新之间建立起依赖关系。在代码中,这类似于
x = y或交换两个变量。想象一下,魔术师把一个小球藏在五个杯子中的一个下面,然后反复调换它们的位置。要找到小球,就必须持续追踪这些交换操作如何改变了它的位置。这正是 $S_5$ 状态追踪问题的写照:追踪连续的交换如何重新排列五个物体。它属于我们四个层级中最难的一级,在以往关于状态追踪局限性的研究中也对此有过探讨。
这些层级不仅可以从变量赋值的角度直观理解,它们还代表了植根于克罗恩-罗兹理论(Krohn–Rhodes theory)的、具有理论支撑的状态追踪分类。代数学的这一分支描述了状态追踪问题——可被视作有限幺半群上的字问题(word problems over finite monoids)——如何被分解为原子原语(atomic primitives)。我们层级结构中的每一级都对应着一类可以由不同原语集构建出来的状态追踪问题。
为了公平地比较这四个层级,我们从一个包含变量赋值的一般有限序列出发,由此衍生出三个更简单的版本,从而生成四个具有可比性的 StateBench 问题——每个难度层级各一个。这四个问题使用相同数量的变量和不同的值,赋值在序列中出现的位置也相同;发生改变的仅仅是赋值的类型。
我们的发现
预训练模型
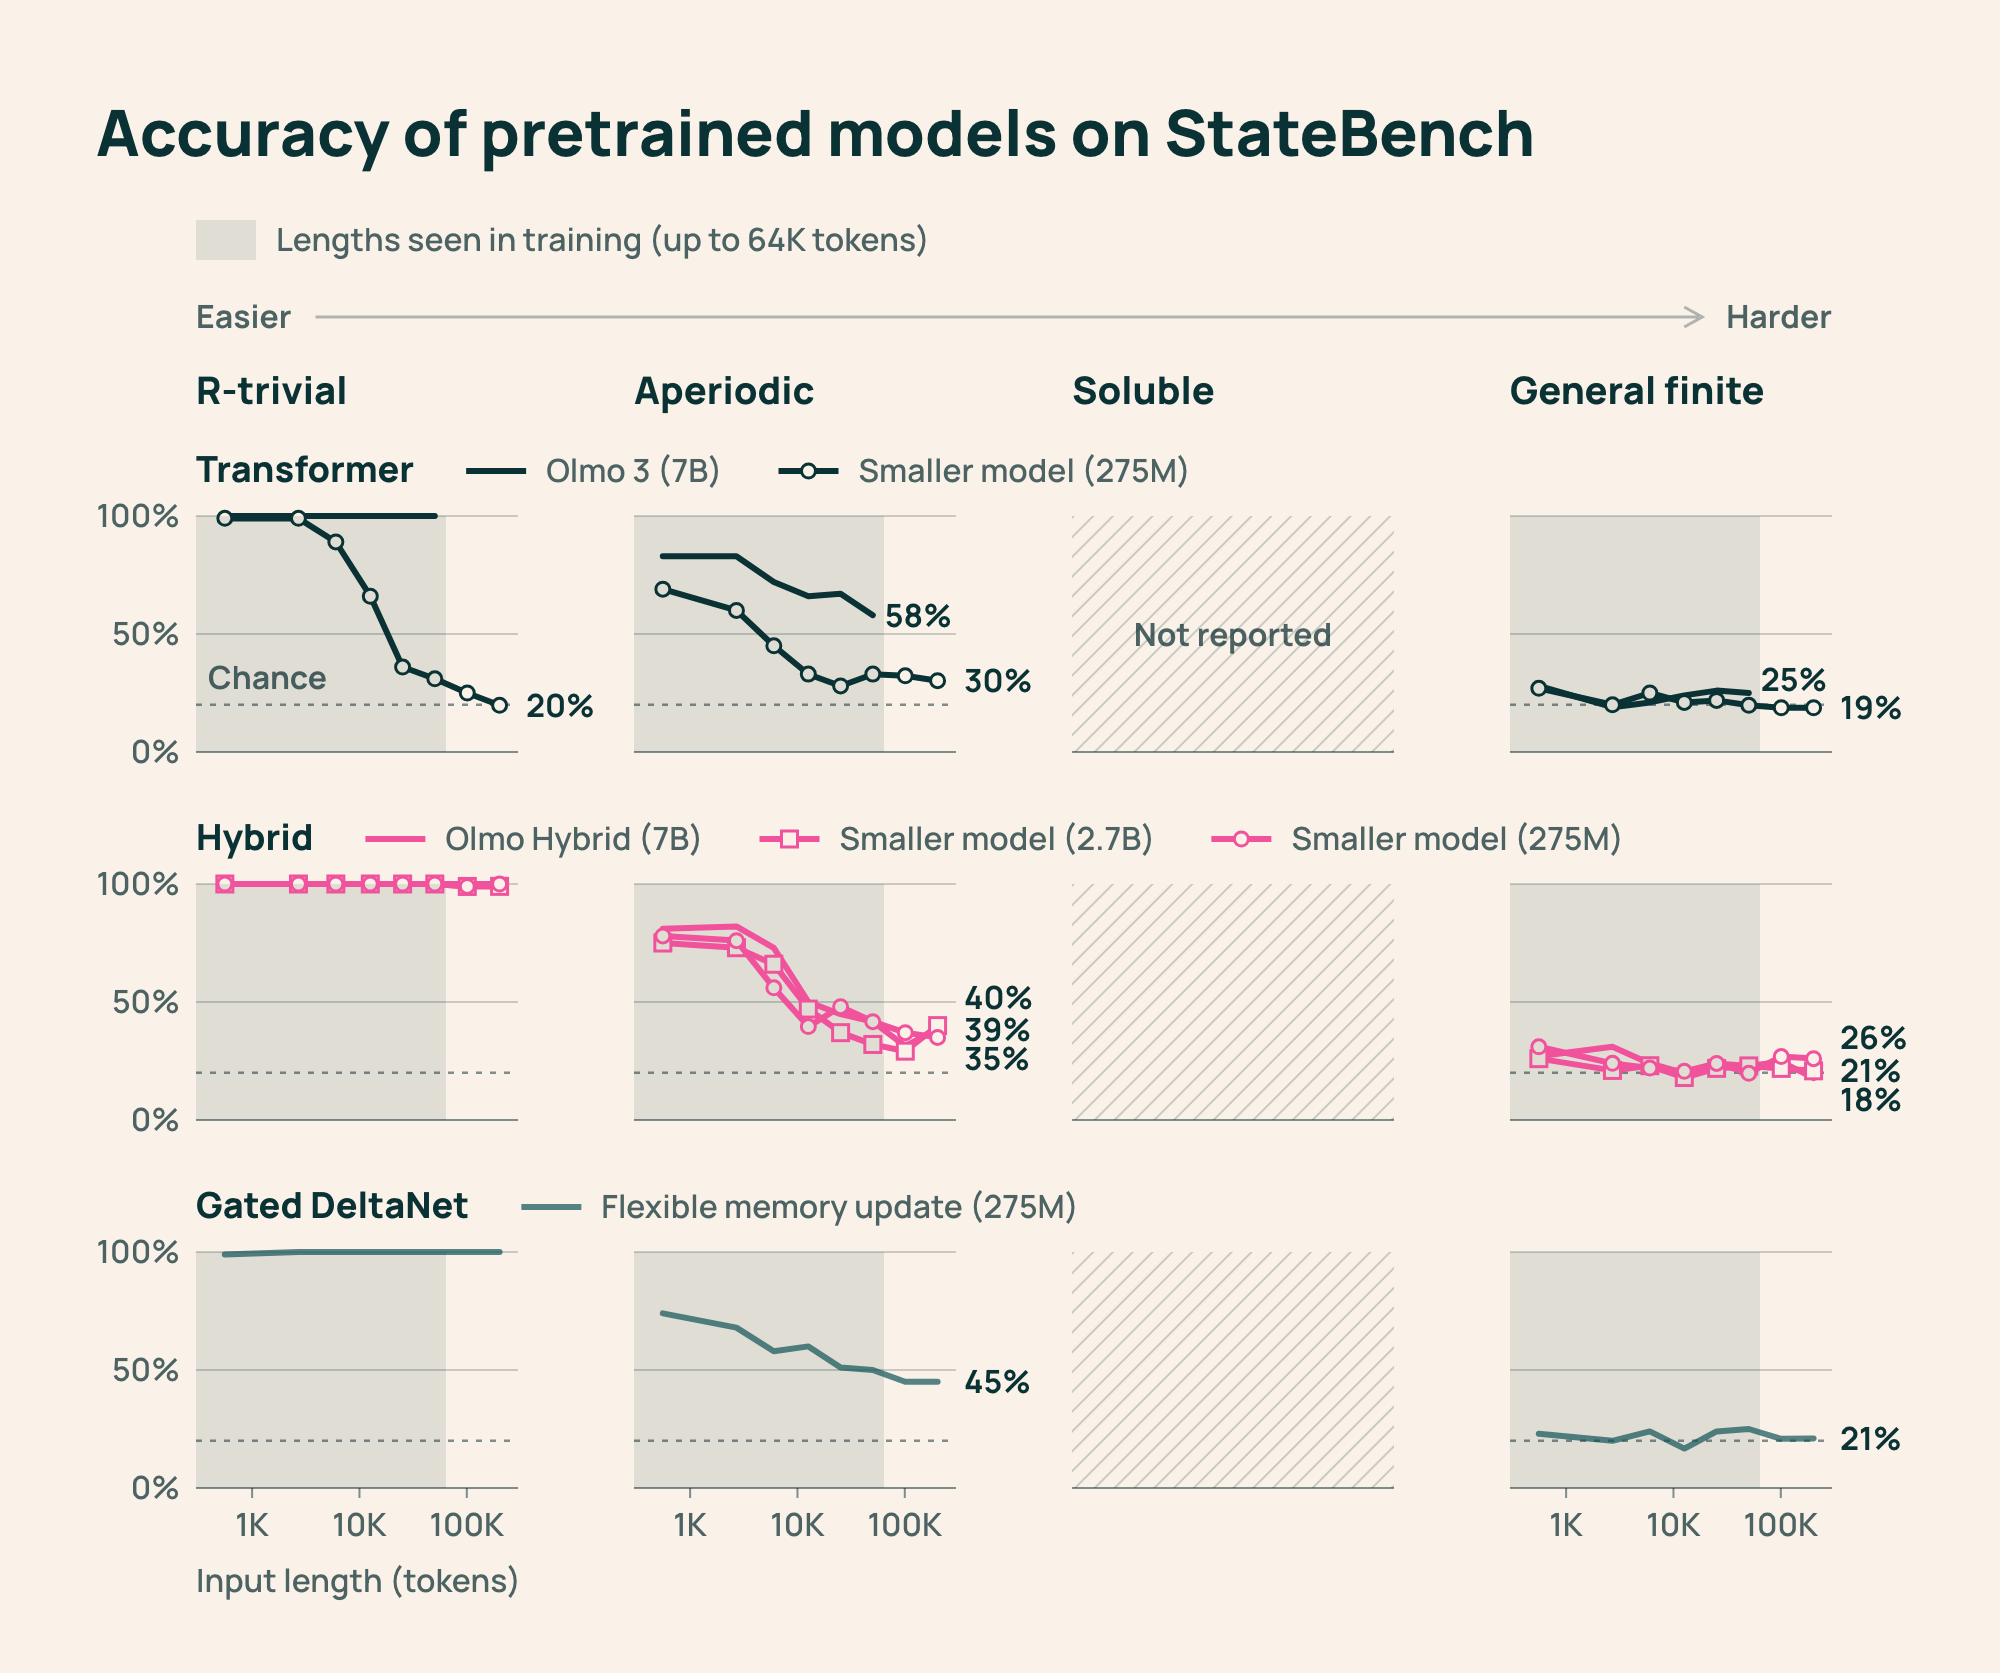
我们在 StateBench 的 R-平凡、非周期和一般有限层级上测试了一系列开源预训练模型,以观察它们的状态追踪在何处出现崩溃,以及不同架构是否会在理论预测的地方失效。在标准的理论假设下,Transformer 可以稳健地处理 R-平凡问题(以及在一定程度上处理可解问题和非周期问题),但预计在一般问题上会失效。相比之下,拥有更灵活记忆更新机制的 Gated DeltaNet 原则上可以处理所有四个层级。
我们首先测试了训练数据和上下文长度完全公开的开源预训练模型。其中包括两个 70 亿(7B)参数的模型:Olmo 3(基于 Transformer)和 Olmo Hybrid(加入了 Gated DeltaNet 层),以及 2.75 亿(275M)和 27 亿(2.7B)参数的较小模型。所有这些模型都在相同的数据上进行了预训练;在训练期间没有模型见过超过 64,000 个 token 的上下文,而我们在远超该长度的输入上对其中的大多数模型进行了测试。
评估每个模型的结果显示,几乎所有模型在 R-平凡问题上都表现良好,但随着输入变长,在非周期问题上的准确率逐渐下降,而在一般有限问题上则始终处于随机猜测的水平。问题的呈现格式在此起到了关键作用——2.75 亿参数的混合架构模型和 Gated DeltaNet 模型在 RULER 风格的 R-平凡问题上接近满分,但当相同的问题被表述为电子表格编辑时,表现却跌至接近随机水平。这种差距正是 StateBench 在多种格式下测试同一底层问题的原因之一。
前沿模型
随后,我们测试了四款前沿模型——Gemini 3.8 Flash、Claude Opus 5.5 以及 GPT-6 Sol 和 Luna——要求它们阅读每个变量赋值序列并生成每个变量的最终值。
所有四款模型在 R-平凡和非周期问题上都表现良好。但对于可解问题和一般有限问题,随着输入长度的增加,准确率急剧下降,在最长的一般有限问题上下降到了 13% 甚至更低。一个可能的原因是敏感度(sensitivity);在这些更高难度的层级中,会有多得多的步骤能够影响最终答案,这使得模型一旦漏掉某一步更新,几乎就没有任何容错空间来给出正确结果。