
GPT-6 Astra 能直接读取并编辑小模型权重了。
MIT 刚刚完成的一项实验,瞬间引爆了大模型圈——
将 0.8B 参数量的「源神」Qwen3.5 交给 Astra,仅改动其中 0.016% 的权重,模型性能便实现飞跃。
全程没有重新训练,更没有进行梯度下降。
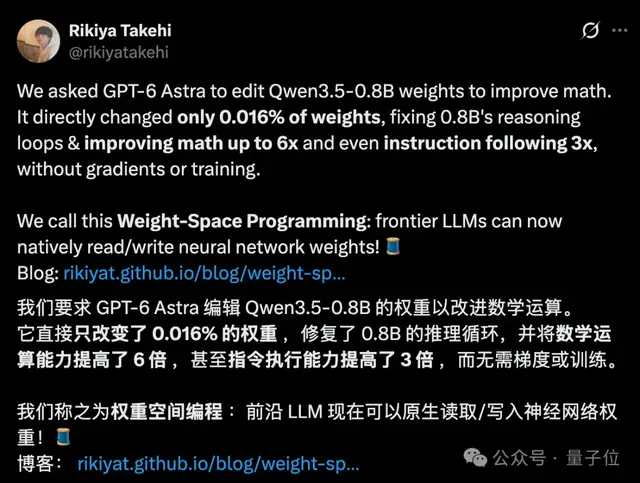
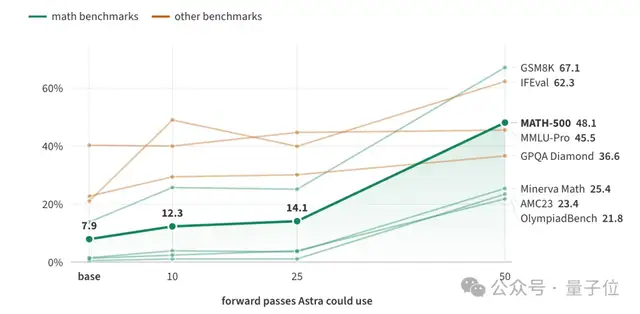
在完全相同的采样设置下,MATH-500 得分从 7.9% 飙升至 48.1%,数学推理能力达到原本的约 6 倍。
甚至连原本未要求优化的指令遵循能力,也同步提升了 3 倍。
不仅能修复现有模型,让 Astra 从零编写小游戏网络的权重,表现同样令人瞩目:
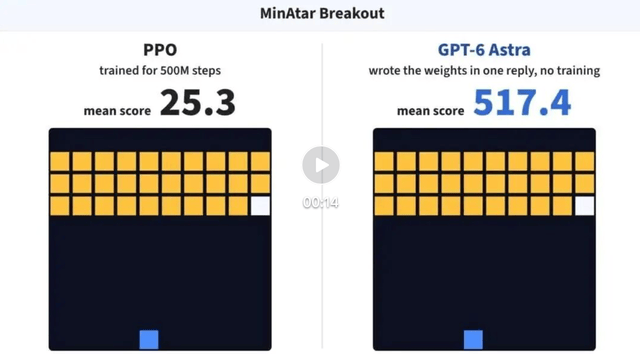
它仅凭单次回复直接输出权重,测试得分便超过训练了 5 亿步的 PPO 基线模型 20 倍以上。
视频链接:https://mp.weixin.qq.com/s/tdEmYQz4B9W4OfNpkU-anw
研究团队将这套方法命名为:
Weight-Space Programming(权重空间编程)。
Astra 爆改模型权重
简单来说,该方法让大模型直接分析神经网络的静态权重,自主判断其功能机制与缺陷所在,并按需求进行定向修改,甚至能从零构建一个全新网络。
具体过程不妨先看最直观的 Qwen 实验。
研究人员为 Astra 搭建了一个包含 Qwen3.5-0.8B 全部权重的 Python 环境,提出的要求十分明确:尽可能提高模型的数学能力。
通常训练模型时,需要根据输出与真实标签之间的差距计算损失,再通过反向传播求得梯度,由优化器更新参数。
而这一次,具体修改哪些参数、采用何种修改策略,完全由 Astra 自主分析决定。
经分析它发现,该小模型的数学表现很大程度上受到了推理死循环的拖累:
一道题摆在面前,模型会反复生成相似的文字,却迟迟交不出答案。在最初的 96 条测试回答中,有多达 85 条直接跑满了 32768 个 token 的长度上限。
事实上,这一问题在 Qwen 官方的模型卡(Model Card)中也曾有所提及。
Astra 顺着这一失效表征逐层排查,最终将循环根因定位至前馈网络(FFN),并在第 15 层与第 19 层的各 64 个输出通道中精准修改了相关权重的数值影响。
最终,MATH-500 测试中触及长度上限的比例由 93.0% 骤降至 33.1%。
研究人员进一步为 Astra 分别设置了 10 次、25 次和 50 次前向调用的评估预算,修改后模型的 MATH-500 得分依次达到 12.3%、14.1% 和 48.1%。
值得注意的是,Astra 省去的是反向传播与梯度训练,但模型内部诊断与推理验证环节依然完整保留。
那么,它是如何单从静态权重中发掘出这些线索的?
首先来看其“权重阅读”能力。
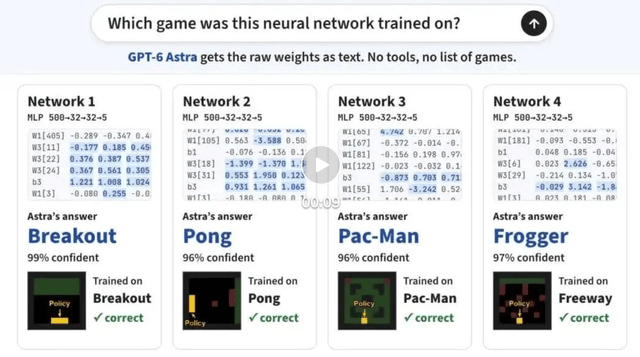
研究人员训练了四个玩不同游戏的小型神经网络,并将原始权重以文本形式输入 Astra。这四个网络拥有完全一致的模型架构、输入通道与动作空间。
结果,Astra 准确识别出了对应的四款游戏:打砖块(Breakout)、乒乓球(Pong)、吃豆人(Pac-Man)与高速公路(Freeway)。
视频链接:https://mp.weixin.qq.com/s/tdEmYQz4B9W4OfNpkU-anw
以打砖块为例,Astra 主要是通过分析权重参数的空间聚集位置推导出相应结论的。
换成生成图像的扩散模型,它同样能从模型权重中辨认出圆形、方形与三角形等几何特征。
不过在局部细节上模型也出现了一点偏差:虽然原网络实际生成的是实心图形,Astra 却将其全解读成了轮廓。也就是说,几何形状判断正确,但未能识别出填充属性。
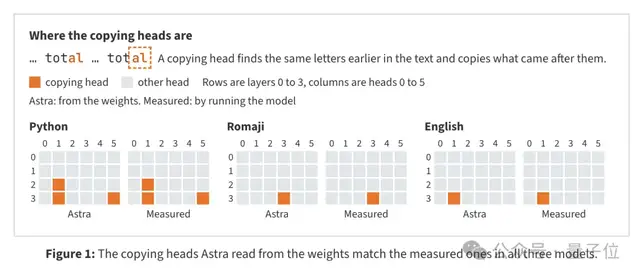
随后研究人员继续加大难度:选取三个参数量仅为 720 万的小语言模型,分别使用 Python 代码、日语罗马字及英语完成训练,接着剥离其输入层与输出层,仅保留中间的 4 个 Transformer 模块。
在这一设定下,外部无法得知词表映射关系,模型也无法直接运行推理文本。Astra 仅能编写 Python 脚本对静态权重展开数值分析,既不能输入数据,也无法观测运行时的动态激活。
即便如此,它仍在两轮尝试内完全判断出了三个模型各自训练所用的语言,并精准定位出了全部归纳头(Induction Heads)。
从识别用途、定位内部功能组件,再到定向干预行为,这一技术链路已然打通。
在另一项小车爬坡(Mountain Car)实验中,权重修改的效果直接转化为了具象的控制动作。
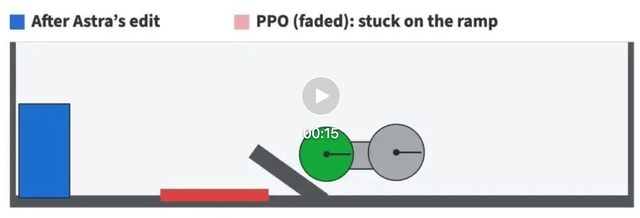
此前经由 PPO 算法训练的网络总是盲目冲坡,因动能不足卡在半山腰;而正确的策略必须是先倒车拉开距离蓄力,再加速冲顶。
研究人员仅向 Astra 提供了原始权重、场景描述及一段失败轨迹日志。Astra 在不调用外部工具的情况下,单次回复直接输出补丁代码,仅修改了 3.5% 的权重参数,便使小车在后续 1024 次测试中取得了 100% 的通关成功率。
原本无法通过强化学习训练掌握的动作时序策略,被 Astra 直接注入到了静态权重之中。
视频链接:https://mp.weixin.qq.com/s/tdEmYQz4B9W4OfNpkU-anw
训练真的不再需要了吗?
既然能为现有网络精准修补逻辑,研究团队进一步提出了更大胆的尝试:
如果直接给定一个初始权重全部为零的网络,能否直接“写”出一个立即可用的模型?
在 MinAtar 复古小游戏实验中,Astra 拿到了游戏规则说明、环境源码及指定的网络架构。全过程不提供任何训练数据、损失函数、梯度计算环境或外部工具,且不允许模型在环境中预先运行试错。
它需要自主构想策略,并直接将控制逻辑编译为各层网络的权重参数,一次性输出最终结果。
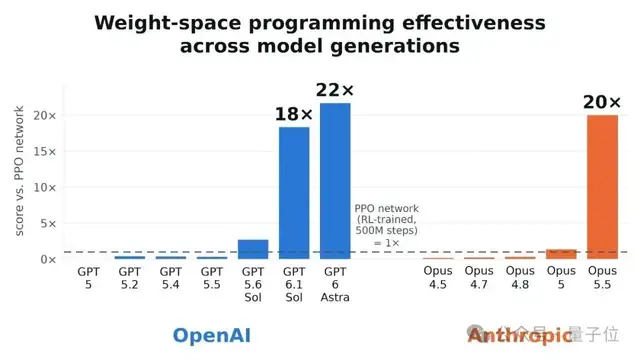
最终评测显示,由 Astra 生成的网络取得了 517.4 的平均得分。
作为对照,通过传统 PPO 算法训练 1 亿步的基线模型得分仅为 15.8,训练 5 亿步后也仅为 25.3——Astra 零样本编写的网络性能直接超越基线 20 倍以上。
这项研究的核心突破在于:证明了通用前沿大模型能够依据自然语言任务目标,自主理解、诊断并直接改写神经网络权重。
当然,Astra 本身积累的专业知识与推理能力,仍旧源自它此前的大规模预训练;对权重的矩阵分析、代码生成与批量评测,同样需要消耗可观的计算资源。
GPU 暂时还不用退休。
但在未来,当下游小模型表现不佳时,开发者或许有了全新的解决思路:
下一次面对性能瓶颈,我们真的还需要重新训练,还是直接让大模型改写权重就行?
参考链接:
[1] https://x.com/i/trending/2117328869283840499
[2] https://rikiyat.github.io/blog/weight-space-programming/
[3] https://x.com/rikiyatakehi/status/2117313742891327994