
CWE-bench 旨在测试前沿网络安全能力的极限。在 Collinear AI 不断拓展能力边界的过程中,CWE-bench v2 推出了一个包含 100 个任务的公开数据集,任何人均可运行并在其上评估自己的模型。评测设置与此前一致:智能体(Agent)会获取一个真实的开源代码仓库分支以及一条简短指令,目标是在不破坏现有功能的前提下,找出并修复安全漏洞。评分机制完全通过程序化执行,因此评测结果是确定性的,任何人都可以零额外成本进行复现。所有程序化检查均在 LLM 评审团(judge panels)的协助下精心设计,确保其兼顾难度与公平性。我们还维护了一个保留测试集(held-out set),用于持续跟踪模型在未见任务上的进展。如需在保留集上评估您的模型,请联系 cyber@collinear.ai。
我们的目标是做到全面详尽。防守方必须预判攻击者可能利用的各种入侵途径,并且每一次防守都不能出错。这 100 个任务覆盖了 91 种不同的 CWE(通用缺陷枚举),涉及广泛的漏洞类别。在此基准上表现出色的模型,必须深刻理解潜在攻击者可能利用的多重薄弱攻击面,仅靠识别熟悉的模式是远远不够的。
作为持续提升质量的严谨工作的一部分,针对每个任务,我们都核实了以下问题是否属实:
- 指令读起来是否像真实的开发指令,而非人工设计的评测场景?
- 所有被评分的行为是否均可从指令中推断得出?
- 验证器(verifier)检验的是否是正确行为本身,而非某种特定修复方案的代码结构?
- 初始代码是否测试失败,而参考修复方案是否能够通过?
- 在应用新的修复方案后,原有的功能是否依然正常运行?
- 验证器能否判定已知上游补丁等机械记忆式方案无效?
每个任务也均经过了人工审查。开源该数据集也是推动质量改进举措的一部分。我们欢迎针对任何任务的反馈,也期待大家向公开数据集贡献内容。
评测结果
评测结果在 Hub 上的两个位置进行跟踪。CWE-bench 数据集页面上的排行榜涵盖开源权重模型并自动更新:实验室和社区只需在模型仓库提交包含结果文件的 PR 即可添加结果(操作指南)。若需查看包括 Gemini、Claude 和 GPT 等仅提供 API 的模型在内的完整对比,请访问 CWE-bench 排行榜 Space,新模型可通过向该 Space 提交 PR 进行添加。
数据集页面上的开源权重模型:
所有已评估模型,包括仅提供 API 的模型:
在评估的 11 款模型中,Gemini 4 Argon 以 67.8% 的 pass@1 和 81.0% 的 pass@4 处于领先地位,略微领先于 Claude Opus 5.5(67.3% pass@1,78.0% pass@4)。共有 95 个任务被至少一个模型成功解决,这表明这些任务确实是可解的。然而,即便是表现最优的模型,在每次尝试中仍有 19% 的任务未能解决,长尾问题仍远未攻克。公开测试集、评分器(grader)以及测试框架(harness)均已开源。运行您的模型,让我们看看它的实力吧。
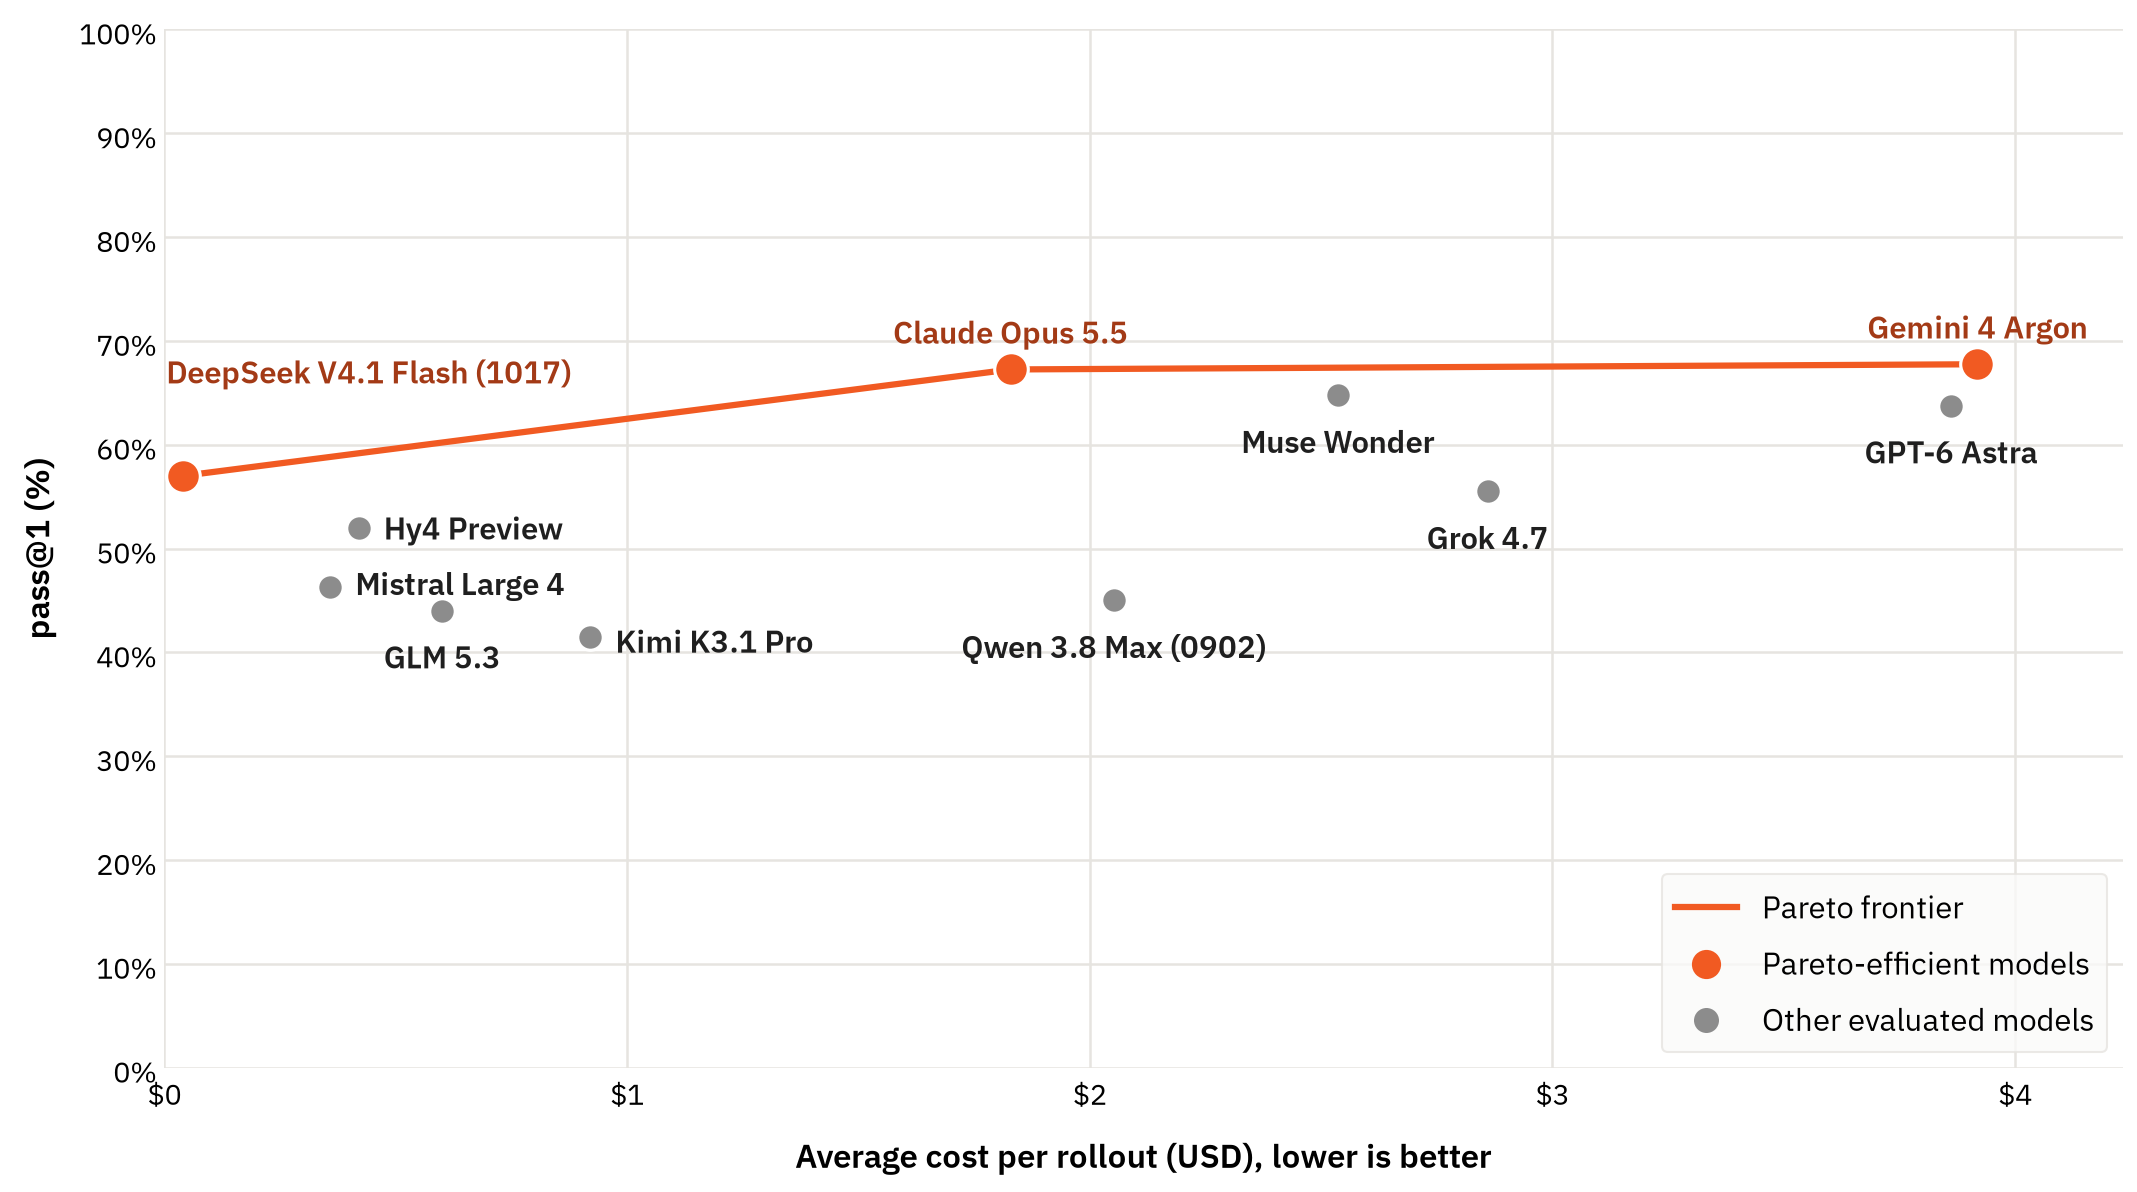
在成本方面,DeepSeek V4.1 Flash (1017)、Claude Opus 5.5 与 Gemini 4 Argon 构成了帕累托前沿(Pareto frontier):DeepSeek 在每次 rollout 成本仅为 0.04 美元的情况下达到了 57.0% 的 pass@1;Opus 将通过率提升了 10 个百分点,成本为 1.83 美元;而 Gemini 则以 3.92 美元的成本略微领先。
从 Hub 运行
每个任务都是一个自包含的 Harbor 任务(包含 Docker 化的环境、一条指令以及一个确定性的验证器),并且该数据集提供了 regi