
编辑 Qwen 的权重以减少推理循环、DeepSeek 的超级智能体(super-agent)原型,以及 GDPx 基准测试。
11 月 3 日 · 30 分钟阅读
在 AI/科技行业不断加深的熊市阴影下(甚至引发了不少黑色幽默)——Anthropic 债券被评为“垃圾级”,且围绕 OpenAI 融资的各种新闻频出——我们依然在该社区中不断见证令人惊叹的能力突破,就比如今天。
要理解今天这篇重磅论文的背景,最好的切入点是回顾仅仅 8 个月前 Karpathy 提出的 autoresearch,它曾预示了一整个夏天人们对递归自我改进(recursive self improvement, RSI)的担忧:
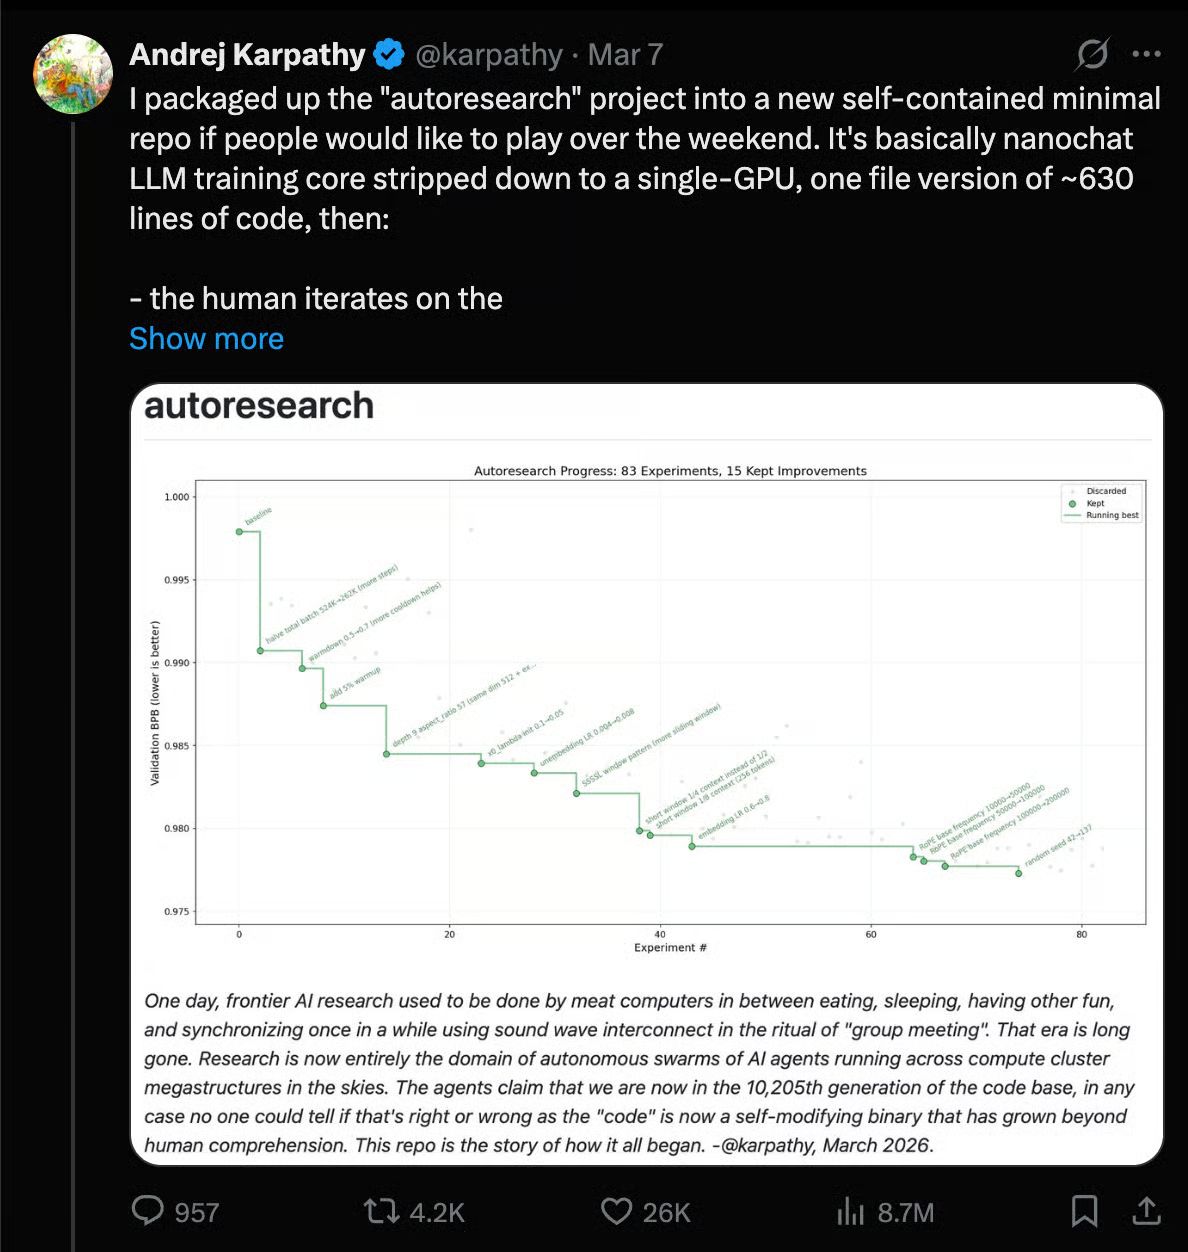
从抽象层面来看,该演示表明:你可以选用一个足够聪明的模型,通过在计算集群上运行一系列实验,在无需人类专业知识或干预的情况下自主训练模型。然而,这一过程通常相当繁琐复杂——需要编写 PyTorch/Jax 代码、运行算力、观察损失曲线(loss curves)、解读评估结果、优化算子(kernel)与数据等等……
那么,上个月的播客嘉宾 Alex Zhang 参与合著带来了一项重量级突破发现:如果直接让一个聪明的模型去读取并编辑一个较笨模型的权重,会怎样?
在机器学习领域,这相当于不去看源代码,而是直接审视(极小的)编译后可执行文件中的二进制 0 和 1,并且能够:1)判断它们的功能;2)根据失败的追踪记录(traces)单次尝试修复 Bug(oneshot-fix),或者通过 50 步迭代朝着既定方向提升(此处可能有所夸大);3)从零开始单次生成(one-shot)整个网络的权重,甚至击败了一些独立训练的模型。
如果你坚信只要参数量足够,大语言模型(LLM)就能够拟合并模拟任何事物(事实上,随着规模的扩大,LLM 在计算方面的表现越来越出色),那么理论上这种能力的出现是必然的;但当这一能力突然显现时,依然令人震惊,正如[一项独立复现](https://x.co