
让AI像牛顿一样思考
「让AI像牛顿一样思考」,这件事终于迎来了突破。
清华大学姚期智与袁洋团队推出了一项重磅研究成果——「代数世界模型」(Algebraic World Model,简称 AWM)。
业界长期探讨过这样一个问题:
如果只给AI喂入牛顿发现万有引力之前的所有人类知识,它能否自主推导出万有引力定律?
现实中,这种假设往往受制于训练数据污染,极难在无先验的世界中验证AI从零开始观察与实验的能力。
如今,代数世界模型提供了一种全新的解法:让AI从纯粹的观察与实验出发去理解客观世界,正变得切实可行。
AI玩游戏,像不像第谷观星?
ARC-AGI-3 是当下各大前沿模型展示逻辑推理能力的权威基准之一。它的最大特色是:不预设规则,不给明目标。
一切全凭模型自主摸索。
例如,GPT Astra 配合 Provider Adapter 框架,在此基准上曾斩获 99.9% 的惊人高分。
在试玩过程中,该模型能自主将游戏机制归纳为一系列符号化的规则。
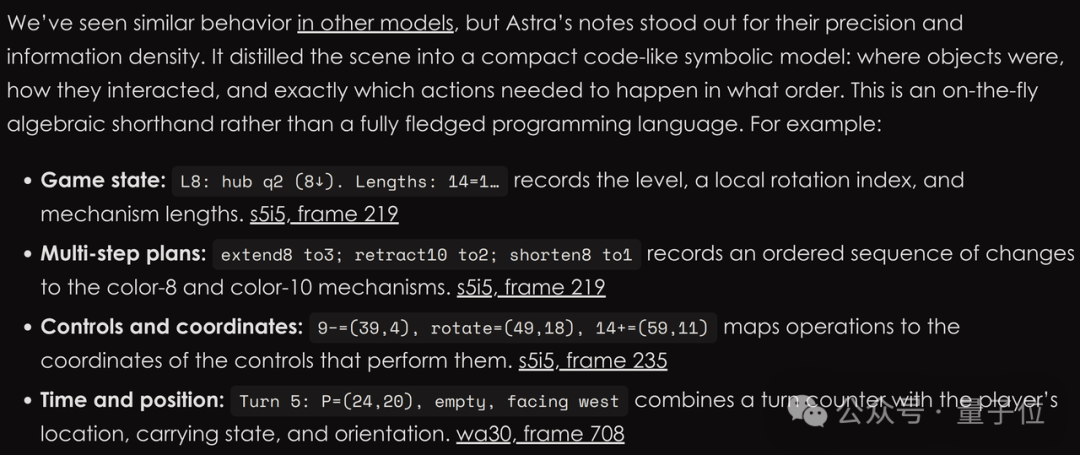
这些规则密密麻麻、信息密度极高,精确度远超传统方案。
然而在本质上,这种记录更像第谷的星象观测笔记。
作为开普勒的恩师,天文学家第谷耗费数十年积累了极其庞大而精准的行星轨道数据。但他的工作始终停留在现象记录阶段。
真正从海量数据中破译行星运动三大定律、触及物理本质的,是开普勒。
Astra 归纳的这些规则,本质上只是第谷的手稿,尚未跃迁为开普勒定律——它详尽描摹了表象,却未能抽象出该迷你系统底层的运行规律。
仍未摆脱的「幻觉」
停留在记录表象层面,会带来怎样的隐患?
研究人员修改了其中名为 sc25 的任务,将初始步数强制设置为理论上绝不可能通关的数值。
例如在第四关中,理论最优解至少需要19步,测试时却仅限制为18步。
面对这一死局,Astra 在尝试8轮后宣告失败,并断言:18步不可能通关,估计至少需要22步才能取胜。
它不仅未推演出正确的19步下界,还给出了偏离极大的错误判断(22步)。
这绝非孤例。在12次对照实验中,顶尖模型(如 GPT-6 Astra 与 Claude Opus 5.5)仅有5次正确识别出「无解」,其中4次给出的最小可行步数依然存在错误。
在虚拟游戏中,这类幻觉或许只是影响通关;但若部署到现实环境中的AI智能体(Agent),这种「判定任务不可行却附带错误归因」的缺陷,极易引发严重决策失误。
真正理想的智能体,理应在面临不可行任务时,明确指出「为何不可行」,并给出精确的临界条件(如「只要步数上限增加1步,即可达成目标」)。
事实证明,仅靠直觉式的试错与归纳是不够的。
代数的力量
破局之道何在?
清华团队给出的方案,正是借助数学代数的结构化力量——代数世界模型(AWM)。
该模型将游戏内所有对象、关联与规则抽象为一个形式化的「代数世界」,随后调用大模型顶级的数学抽象能力,自底向上构建对该世界的系统认知。
其核心推演路径主要分为三步:
- 探索:通过自主试探性操作,将观察到的表象编写为可执行的 Python 代码,形成初步的「经验假设」。
- 凝炼:依托持续的动态观察反哺、验证并修正假设,将其泛化抽象为更具普适性的实体与规则。
- 证明:运用 Lean 4 交互式定理证明语言对规则进行形式化表达,转化为严谨且支持机器自动验证的数学命题。
简而言之,这一机制推动AI从单纯的直觉试错,升维至形式化建模与数学验证。
实测性能表现如何?
面对上述无解关卡,集成 AWM 的 Opus 5.5 仅尝试两次便形式化证明了该关卡在当前限制下无解,并准确判定只需增加1步即可通关。
除了能严密判定「不可能」场景外,AWM 的整体通关表现同样出色:在 ARC-AGI-3 全量测试集中,基于 Opus 5 的 AWM 实现了 183 关全通关(得分率 99.9%),且平均动作步数仅为人类基准的 43%,刷新了该任务当前的能效纪录。
AWM 的底层原理是什么?
在现代数学中,代数几何借助代数方程揭示几何形态,代数拓扑则运用代数工具剖析空间的连通性与孔洞结构。
将连续空间与几何形态「代数化」,往往能攻克仅凭直觉观察难以回答的深层命题。数学家构筑了代数几何与代数拓扑,因为那是属于纯粹数学的世界。
而今在AI赋能下,AWM 将这一路径拓宽至未知的游戏环境、交互式场景乃至现实世界:在探索中捕捉规律,在规律中凝炼结构,并运用严格的代数工具理解结构本身。
像牛顿一样思考
这一框架契合了科学史的发展脉络。
从万有引力到麦克斯韦方程组,再到广义相对论,现代科学的核心演进逻辑始终如一:从纷繁复杂的自然现象中提炼出公理体系,以数学作为通用语言刻画世界的底层规律。
AWM 所探索的,正是赋予AI这种范式级抽象能力。
为了达成形式化推演,模型借鉴了被誉为「数学的数学」的抽象数学分支——范畴论。范畴论关注的不是单一具体分支,而是不同数学体系之间的共有结构与映射关系。
AWM 核心调用了范畴论中的两大工具:投射极限(Projective Limit)与归纳极限(Inductive Limit),分别对应认知过程中的两种互补机制:
- 建立定义(投射极限):将若干既有概念及其映射关系予以复合,协同界定出全新概念,本质属于概念的分解与重构。
- 抽象共性(归纳极限):跨越不同实体识别不变结构,将其归纳进更高维度的抽象框架,本质属于概念的泛化与特化。
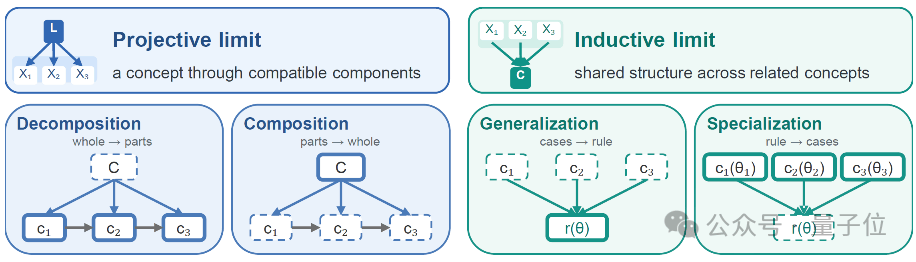
借助双向交替迭代,AWM 得以将最初离散、粗糙的 Python 代码假设,逐步精炼为紧凑、完备且自洽的形式系统,最终形成可闭环推演与机器证明的世界模型。
这恰如牛顿面对海量天文观测与实验数据时的思考路径:真正的科学飞跃,在于从繁复的现象中淬炼出「力」、「质量」等核心变量,并构建出能够自我演绎和可证伪的严密理论框架。
AWM 赋予AI的,正是这种结构化的科学抽象能力。
值得强调的是,该系统同样存在边界:任何证明均锚定在当前「已观测样本空间」的基础之上。若早期探索缺乏充分性、遗漏了关键状态,系统产出的结论亦仅构成局部有效模型。
因此,构建真正通用的认知闭环依然需要遵循经典科学方法论:
观察 → 假设 → 实验 → 抽象 → 证明 → 再观察
论文作者
该成果背后的研究团队配置同样备受瞩目。
本篇论文由两位本科生担任共同第一作者:
一位是来自浙江大学的潘冠成(目前在清华大学开展科研工作);
另一位是清华姚班学生谭淇心。
指导团队由两位著名学者领衔:
袁洋,清华大学交叉信息研究院、人工智能学院副教授,同时担任上海期智研究院具身智能与智能制造中心主任。
姚期智,图灵奖得主(2000年)、中国科学院院士,现任清华大学交叉信息研究院院长、人工智能学院院长;同时身兼京都奖得主(2021年)、美国国家科学院外籍院士、美国艺术与科学院外籍院士。