
英伟达与麻省理工学院团队在 Hugging Face 发布视频增强项目 Open-H3-Regenerate-2K 模型权重
近日,由英伟达与麻省理工学院研究人员组成的 Efficient-Large-Model 团队,在 Hugging Face 上发布了视频增强项目 Open-H3-Regenerate-2K 的模型权重,配套推理代码也已在 NVlabs/Sana 仓库开源。该方案基于 MiniMax H3,可将低分辨率视频草稿重新生成为高分辨率视频,支持 2560×1440 的 2K 输出,最高可实现 3840×2160 的原生 4K 重建生成。
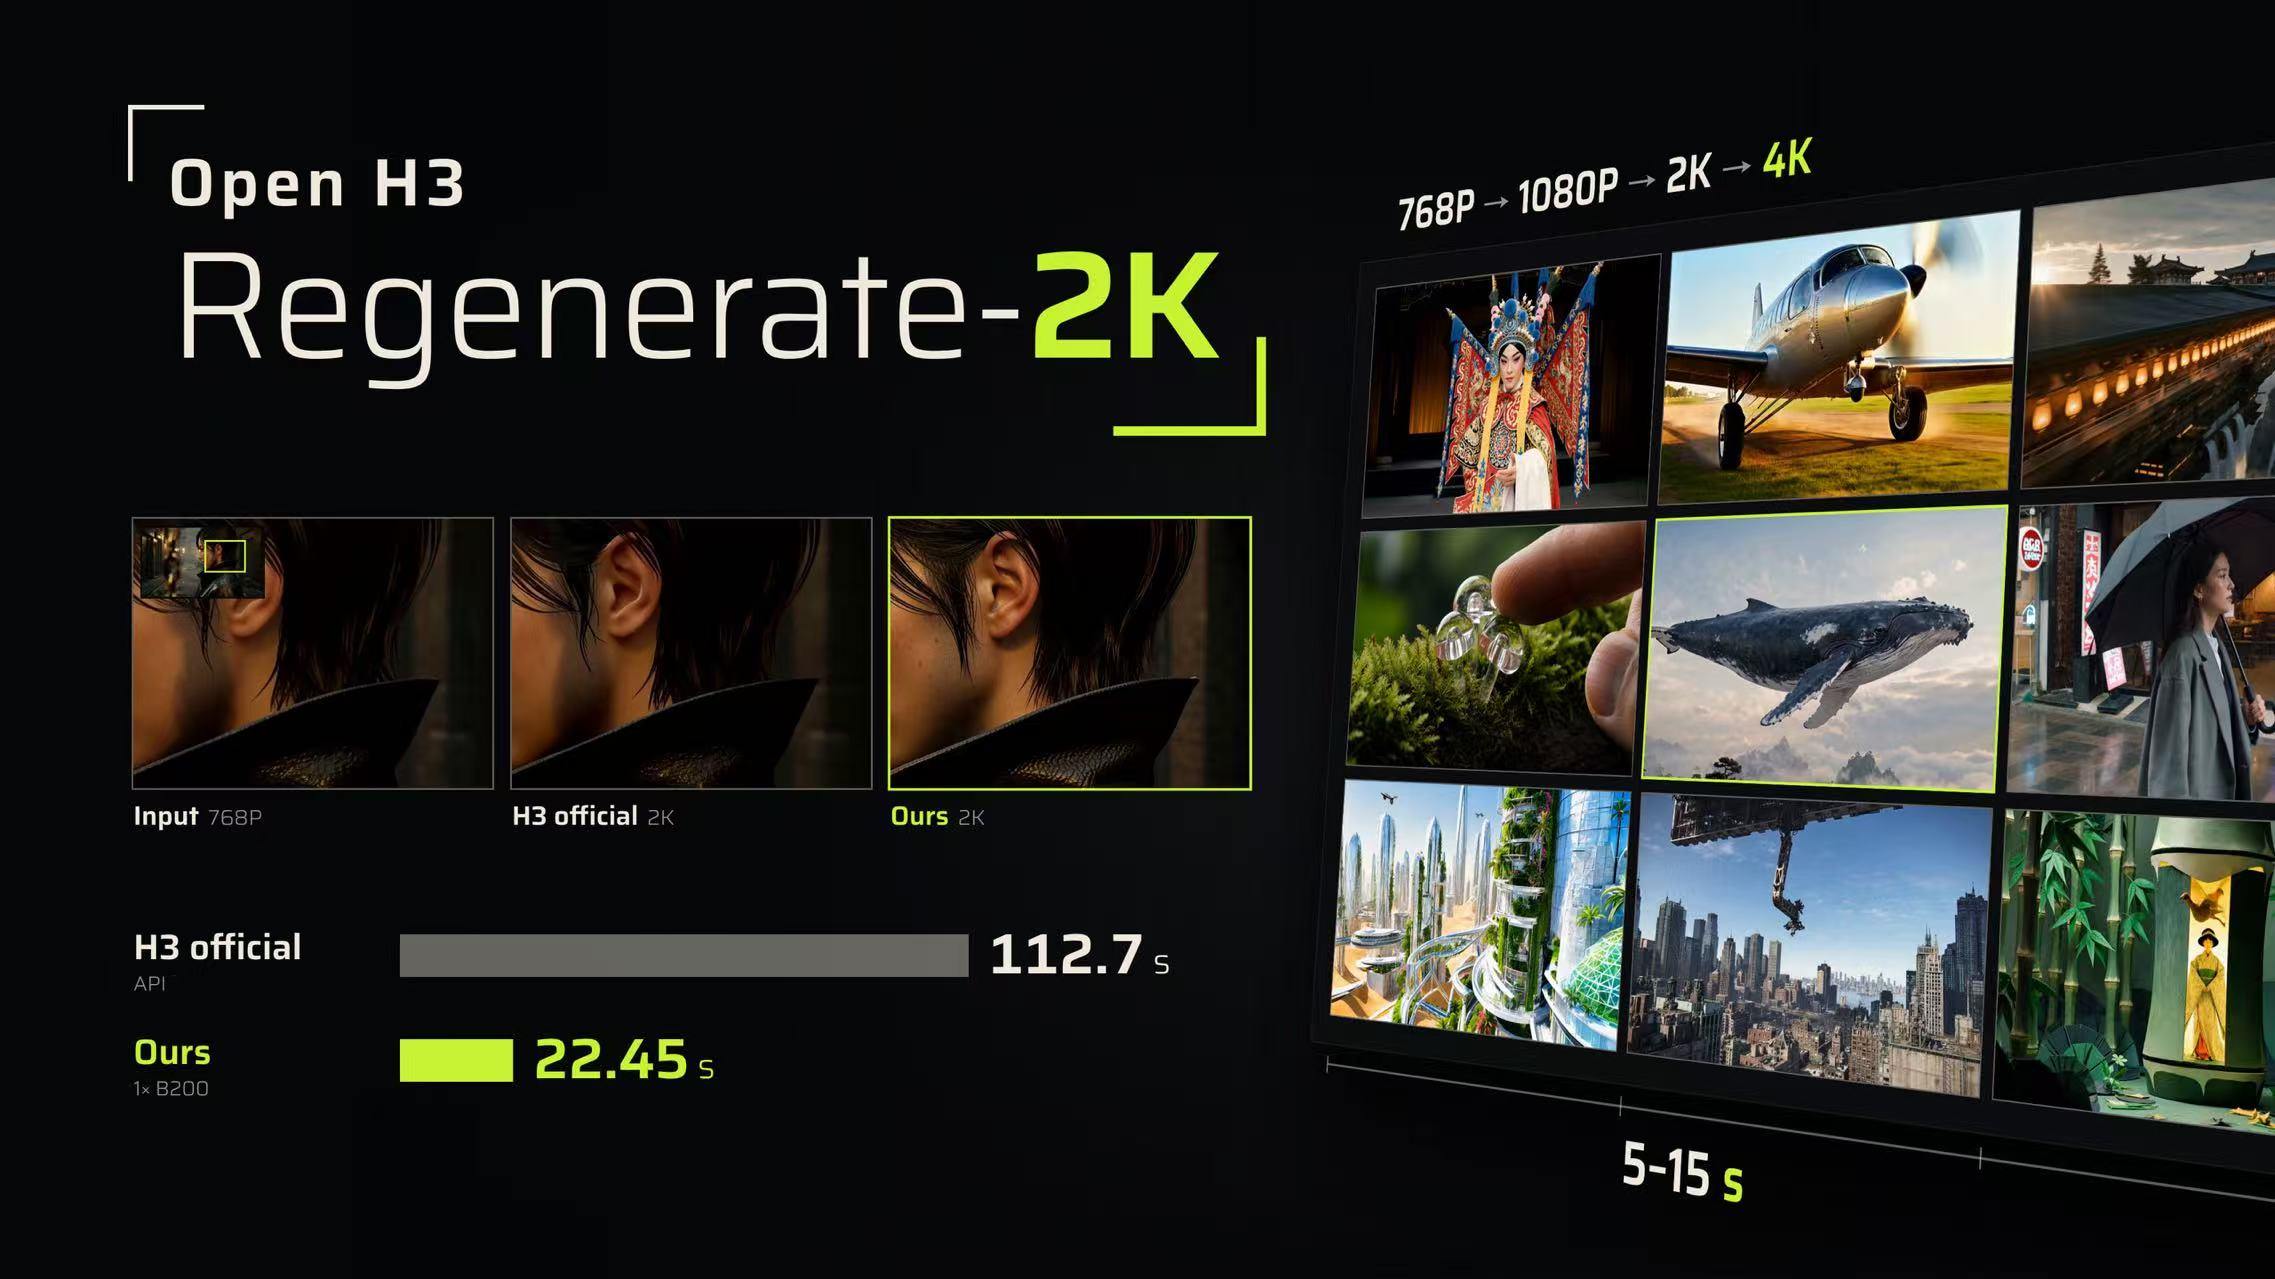
MiniMax H3 的完整系统涵盖多模态上下文处理、基础音视频生成以及高分辨率重生成等环节。其中,已开放权重的 H3-Base 负责生成 768P 音视频,官方 H3-Regenerate-2K 模块则通过 API 提供服务。此次发布的项目复用了 H3 基础模型的生成能力,为高分辨率重生成环节提供了一套支持本地部署的开放实现方案。
在细化模型的训练阶段,研究团队保持了 H3 Transformer 主干网络与视频 VAE 的原有参数不变,仅训练新增的细化 LoRA。推理阶段,细化 LoRA 与 LightX2V FL2VA Turbo、LMS Sharp 等社区适配器合并使用,通过三步去噪在目标分辨率下重新生成画面细节;视频草稿中的场景、布局与运动信息,则为该过程提供先验参考。
为提升推理效率,项目采用了社区开发的潜空间放大器,直接放大视频的潜在表示,避免了高分辨率下重复编解码的开销。同时,方案结合 SoL-Engine 的稀疏注意力机制、低精度计算以及快速 VAE 解码器,对细化与解码环节进行了全面加速。
项目团队公布的基准测试显示,在单张 NVIDIA B200 GPU、系统预热后的测试条件下,一段约 5 秒视频完成潜空间放大、三步细化和 2K 解码的合计耗时,由未优化版本的 87.26 秒降至 22.45 秒,处理速度提升至约原来的 3.9 倍。其中,快速解码器将原本约 15 秒的视频解码耗时压缩至约 1.6 秒。
画质方面,项目团队在 RefinerBench-150 基准上进行了对比评测。在相同输入、相同 2K 输出的测试条件下,Open-H3-Regenerate-2K 在感知质量评测 UniPercept 上的平均分为 60.0,高于官方 H3-Regenerate-2K API 的 53.4 分。在 VBench 评测中,该方案在美学质量、成像质量和主体一致性上的得分更优;官方 API 则在运动平滑度与动态幅度上仍保持微弱优势。
MiniMax H3 于今年 8 月开放权重后,围绕其展开的微调、蒸馏和工具适配迅速增加,吸引了海内外众多研究团队与社区开发者参与。其首月下载量突破 2400 万次,催生了 300 多个公开衍生模型,成为 2026 年全球下载量最高的模型之一。
其中,英伟达与 MIT 联合围绕 H3 展开的研发覆盖了多个应用方向。除本次的视频增强方案外,该团队此前还发布了基于 H3 Ref2VA 构建的流式视频渲染模型 StreamRender-H3,以及从 H3 视频 VAE 蒸馏得到的快速解码器 Sol-H3-VAE,分别针对交互式视频渲染和解码效率优化提供支持。
此前,LightX2V 推出的 MiniMax-H3 Turbo 已提供四步、八步等蒸馏版本,社区微调模型 Singularity 则侧重于优化动作表现、面部细节与视觉风格。海外团队 FastVideo 与 Pika 也分别发布了 FastH3 四步预览版本和采用六步采样的 Pika H3 Flex;ComfyUI 与 Unsloth 亦通过权重适配与量化版本支持,将 H3 深度接入到更多本地创作工作流中。