
我如何打造了世界上最深度融入 AI 的公司。别被这个吸睛的标题劝退,Jacob Sansbury 在这篇文章中介绍了他们如何构建 Spawn,深刻探讨了基于前沿模型进行智能体工程(agentic engineering)的前沿可能性。
Spawn 是一个大型多人游戏环境,玩家可以通过提示词(输入给游戏内智能体 Savi)来修改游戏世界。
我在手机上试玩了几分钟,仅凭提示词就生成了一座城堡,接着又生成了一条龙,然后骑上龙绕着城堡飞行。
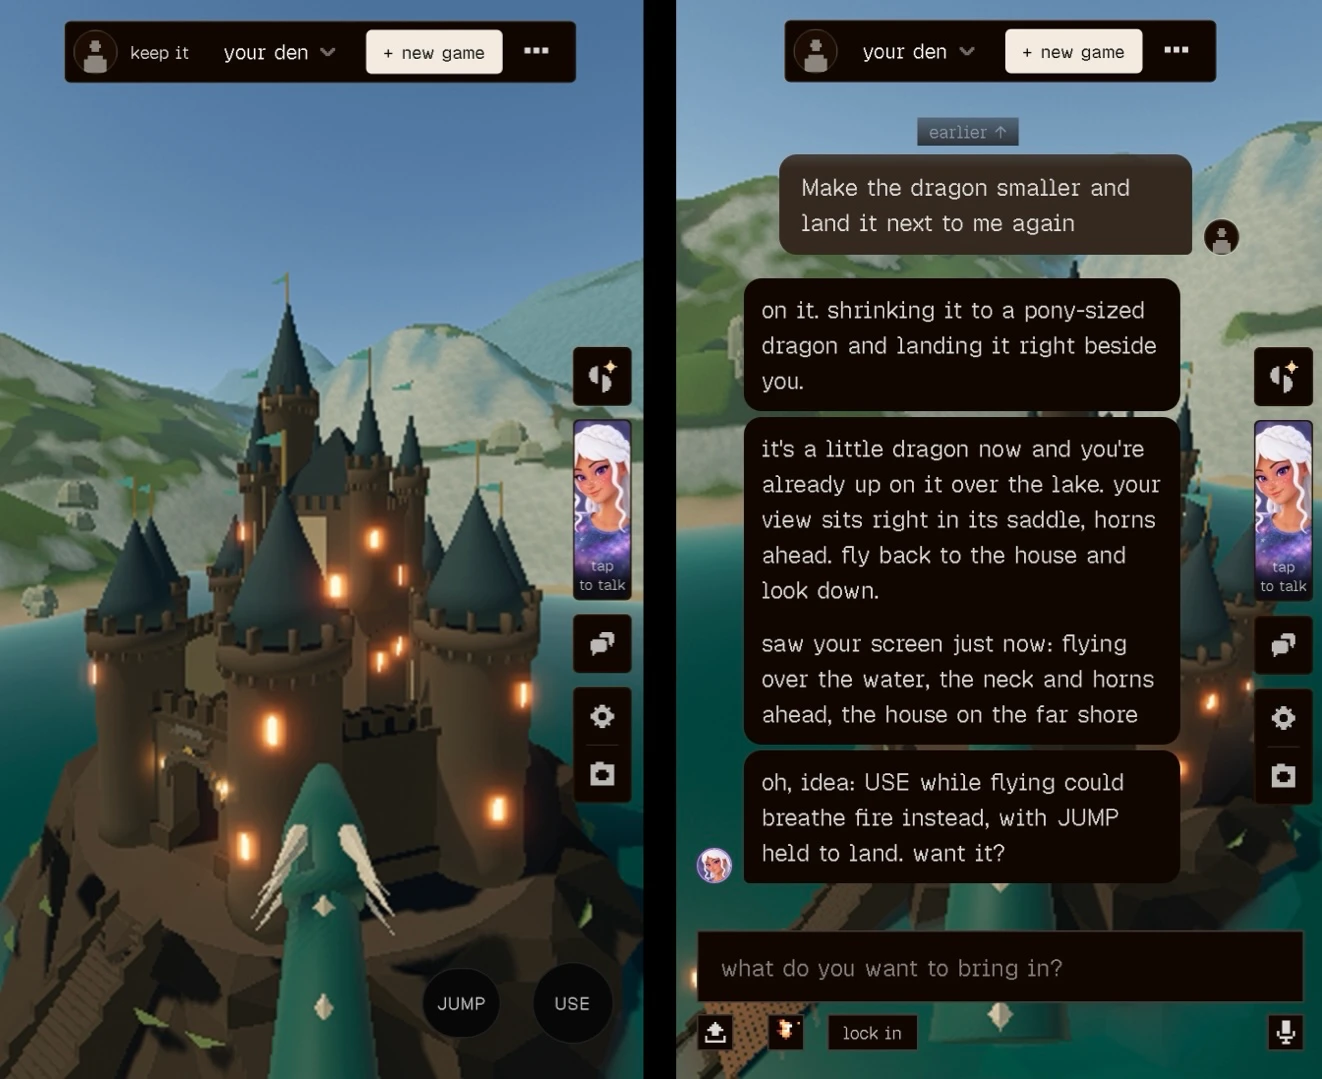
据 Jacob 透露,Spawn 目前正由一组由 Fable 驱动的智能体集群(agent swarm)进行自主开发,_每月_仅 token 成本就超过 300 万美元:
我们的智能体直接修改线上生产代码,并按小时交付至生产环境,因此它们会自行读取每一个错误、缺陷报告(bug report)和运行指标。我们约 60% 的工作始于生产环境报错、Savi 提交的缺陷报告(Savi 是你在 Spawn 中用来构建游戏的 AI)、日志中的异常记录,或是功能需求。
Savi 会自己提交缺陷。当用户遇到 bug,或者 Savi 在产品中遇到 bug 时,她就会记录并提交。它会直接进入一个智能体,由该智能体来判断这是需要修复的真实缺陷、我们不打算修的问题,还是需要做决策的刻意设计。通常这会转变成一次代码改动,在一小时内交付给该用户,并在同一个聊天界面中发送消息通知。
这是拉满到极致的持续部署(continuous deployment):
如此紧凑的循环只有在永不停歇的情况下才能运转,因此如果一个小时内没有代码上线,我们就会将其视为 SEV-0 级事件——即我们最严重的故障级别。未发布的代码改动会堆积,生产环境中已有的每个问题也会持续更久,反馈回路同样会变慢。一个智能体的上下文中只能维持几个小时的工作记忆,因此以更快的速度发布反而有助于它保持连贯性。[…]
我们可以在 30 秒内回滚一次出错的改动,精准回滚出问题的地方,而不影响其他任何部分。当监控或日志警报触发时,它会启动或唤醒负责该事故的智能体,我们还会故意搞坏一些东西,以测试这些恢复路径是否能够正常工作。
读这篇文章时,我惊讶得挑了不下十几次眉毛。我很难想象这种开发模式能用在那些容错率极低、一旦出事代价极高的软件上,但对于游戏而言,它似乎出奇地有效。
Jacob 表示,正是 Fable 5(以及随后的 5.1)模型让这种程度的自主性成为可能。Opus 5.5 对他们来说不太够用;而当他们尝试使用 GPT-6 Astra 根据安全审查结果实施修复时,所有功能直接瘫痪了:
所有功能都被禁用了,并被标记为在安全修复完成后再重新开启。Astra 审查了我们的整个产品,并通过把所有不安全的功能直接关掉的方式来“确保安全”。
正是这类极致的实验,让我对游戏开发感到兴奋——它堪称探索当今代码智能体能力边界的绝佳试验田。