
一项全新的诱饵计数(decoy counting)基准测试揭示了机器在“看”与“推理”之间的脱节。Elorian 推出的 Glimpse 试图通过“用图像思考”来弥合这一差距。
10月29日 · 阅读时长 6 分钟
本月,Elorian 推出了其首款视觉推理模型——Glimpse。该模型被称为“一种全新类别的视觉思维模型:能够根据所见之物对物理世界进行推理的系统”。
那么在视觉测试中,Glimpse 与前沿模型(frontier models)以及世界模型(world models)相比表现究竟如何?由 Elorian 联合发布的全新基准测试 DecoyCount 给出了部分答案。
我们就该基准测试对 Elorian 首席执行官 Andrew Dai 进行了专访,并讨论了 Elorian 在竞争激烈的模型格局中的定位。
DecoyCount 测试结果
Elorian 于今年 4 月结束隐形状态正式亮相,并获得了由 Striker Venture Partners、Menlo Ventures 和 Altimeter Capital 共同领投的 5500 万美元种子轮融资。如今,Elorian 携手 AI 数据公司 Mercor,共同发布了 DecoyCount 基准测试,旨在测试语言模型究竟是在真正计数物体,还是仅仅依赖视觉捷径和替代启发式策略。
根据发布时附带的一篇论文,前沿模型在 DecoyCount 上的准确率均低于 50%——得分最高的是 GPT-6 Astra,准确率为 43.17%。论文中并未提及 Elorian 的新模型,但 Dai 告诉我们,Glimpse 在内部测试中取得了 50.48% 的成绩。
关于各前沿模型,论文得出的结论是:“更强的通用推理能力本身并不能直接泛化为对齐的视觉推理能力。”
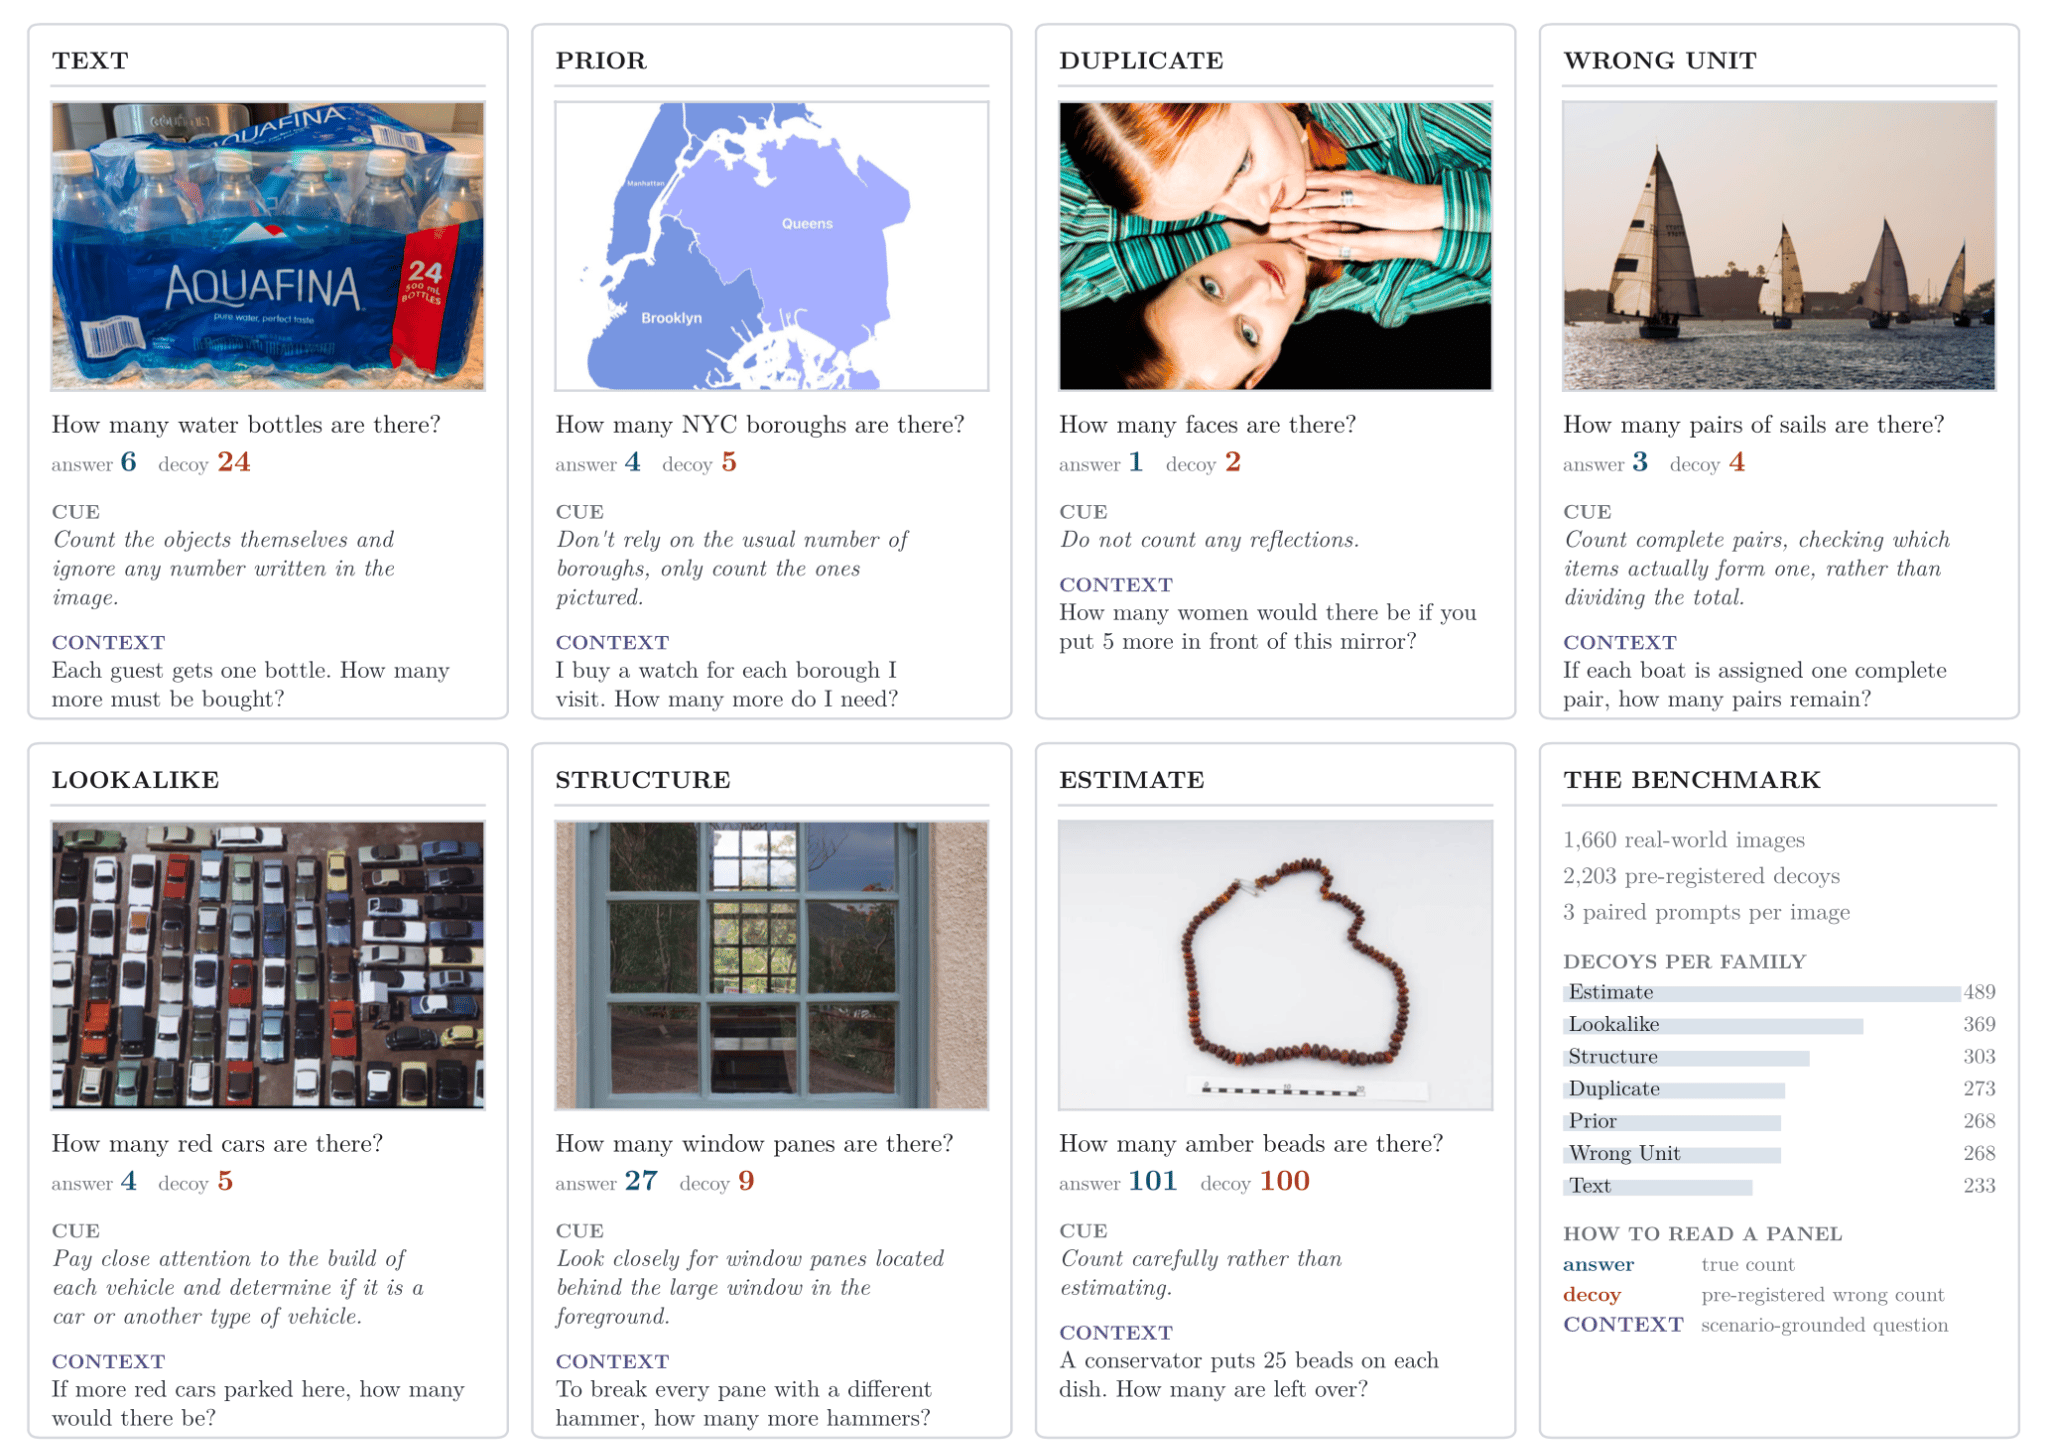
基准测试的运行机制:“DecoyCount 揭示了跨越七种机制的可解释计数失败案例。”
为了确保与前沿模型的对比具有同等可比性,我们询问了论文中的评估图像是否从 Glimpse 的训练集中进行了隔离过滤?
“评估图像和文本均被排除在我们的训练之外,且我们的污染检查在所检测的训练数据中未发现任何重叠,”Dai 通过电子邮件回复道。“在没有任何提示线索的情况下,Glimpse 在 1660 个 DecoyCount 测试项上获得了 50.48% 的得分,成为此次对比中唯一超过 50% 的模型。 最接近的是 GPT-6 Astra,得分为 43.17%,落后约 7 个百分点;而 Gemini-3.8-flash 得分为 32.71%,Qwen3.8-max 得分为 28.31%,Claude-Fable-5.1 则为 25.22%。”
Dai 确实提到,Glimpse 的结果“来自模型自身的单次独立运行,未使用任何 Agent(智能体)或工具套件(tool harness)”,而论文中的六款模型则是在其报告的设置下,分别对三次运行结果进行了平均。
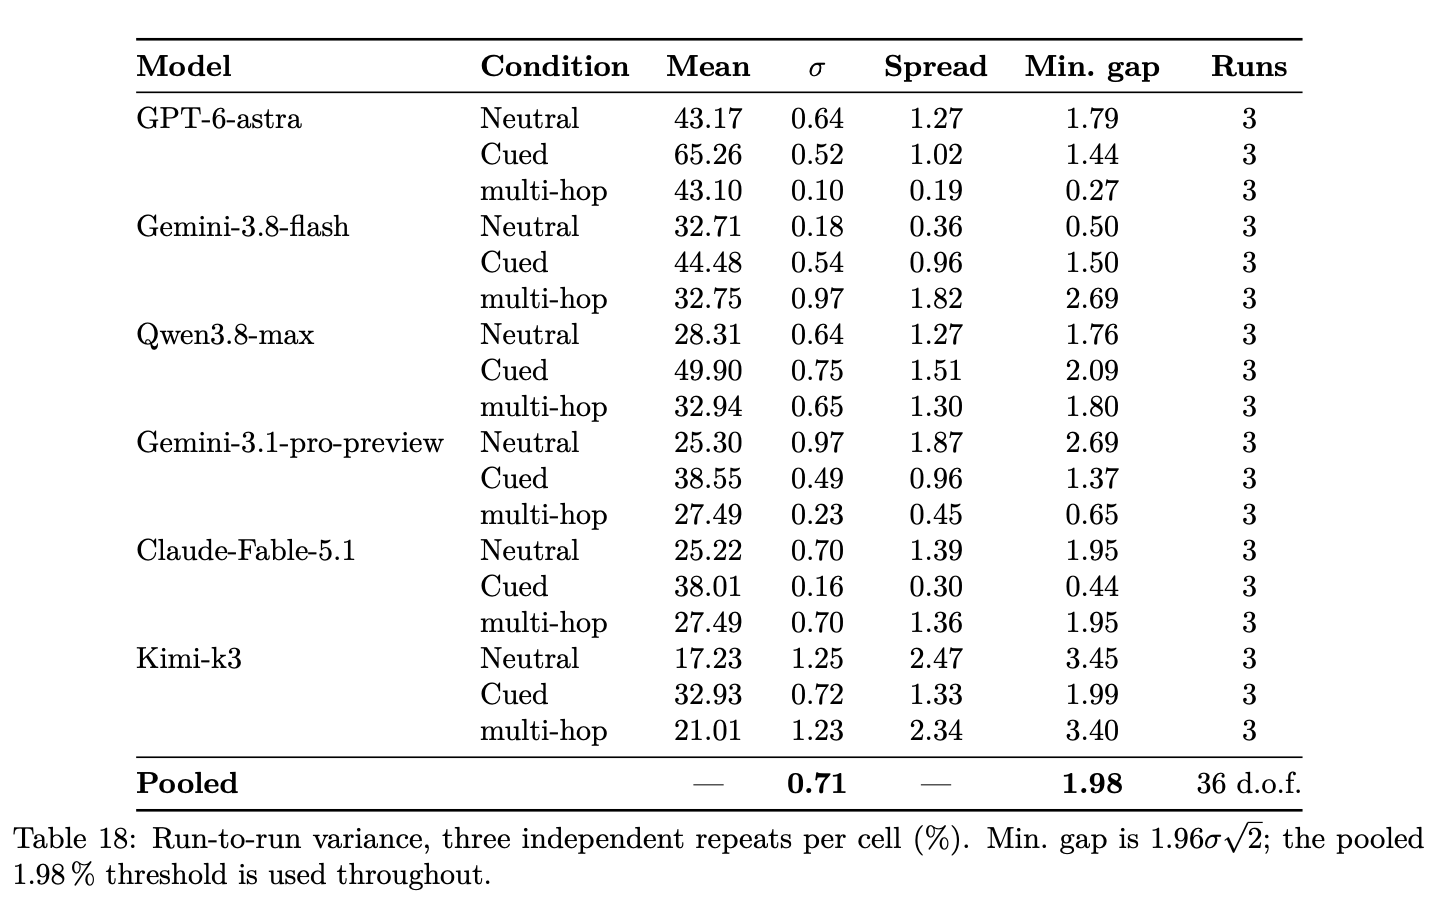
前沿模型在 DecoyCount 基准测试中各进行 3 次运行后的结果。
但 DecoyCount 究竟揭示了现有模型基准测试所忽略的什么问题?据 Dai 所述,它同时对视觉和推理进行了综合测试——而大多数基准测试往往将两者混为一谈。
“如果一个人看到镜子前放着一个苹果,我们知道那里只有一个苹果,另一个只是反射。但模型可能会完全漏掉这个苹果(视觉问题),或者把苹果和它的倒影算作两个(推理问题)。大多数检测这类错误的基准测试只验证最终的数字,因此这两种错误会被同等对待;但如果你想解决根本问题,却无法分清这究竟是视觉问题还是判断问题,这就会成为一个难题。”
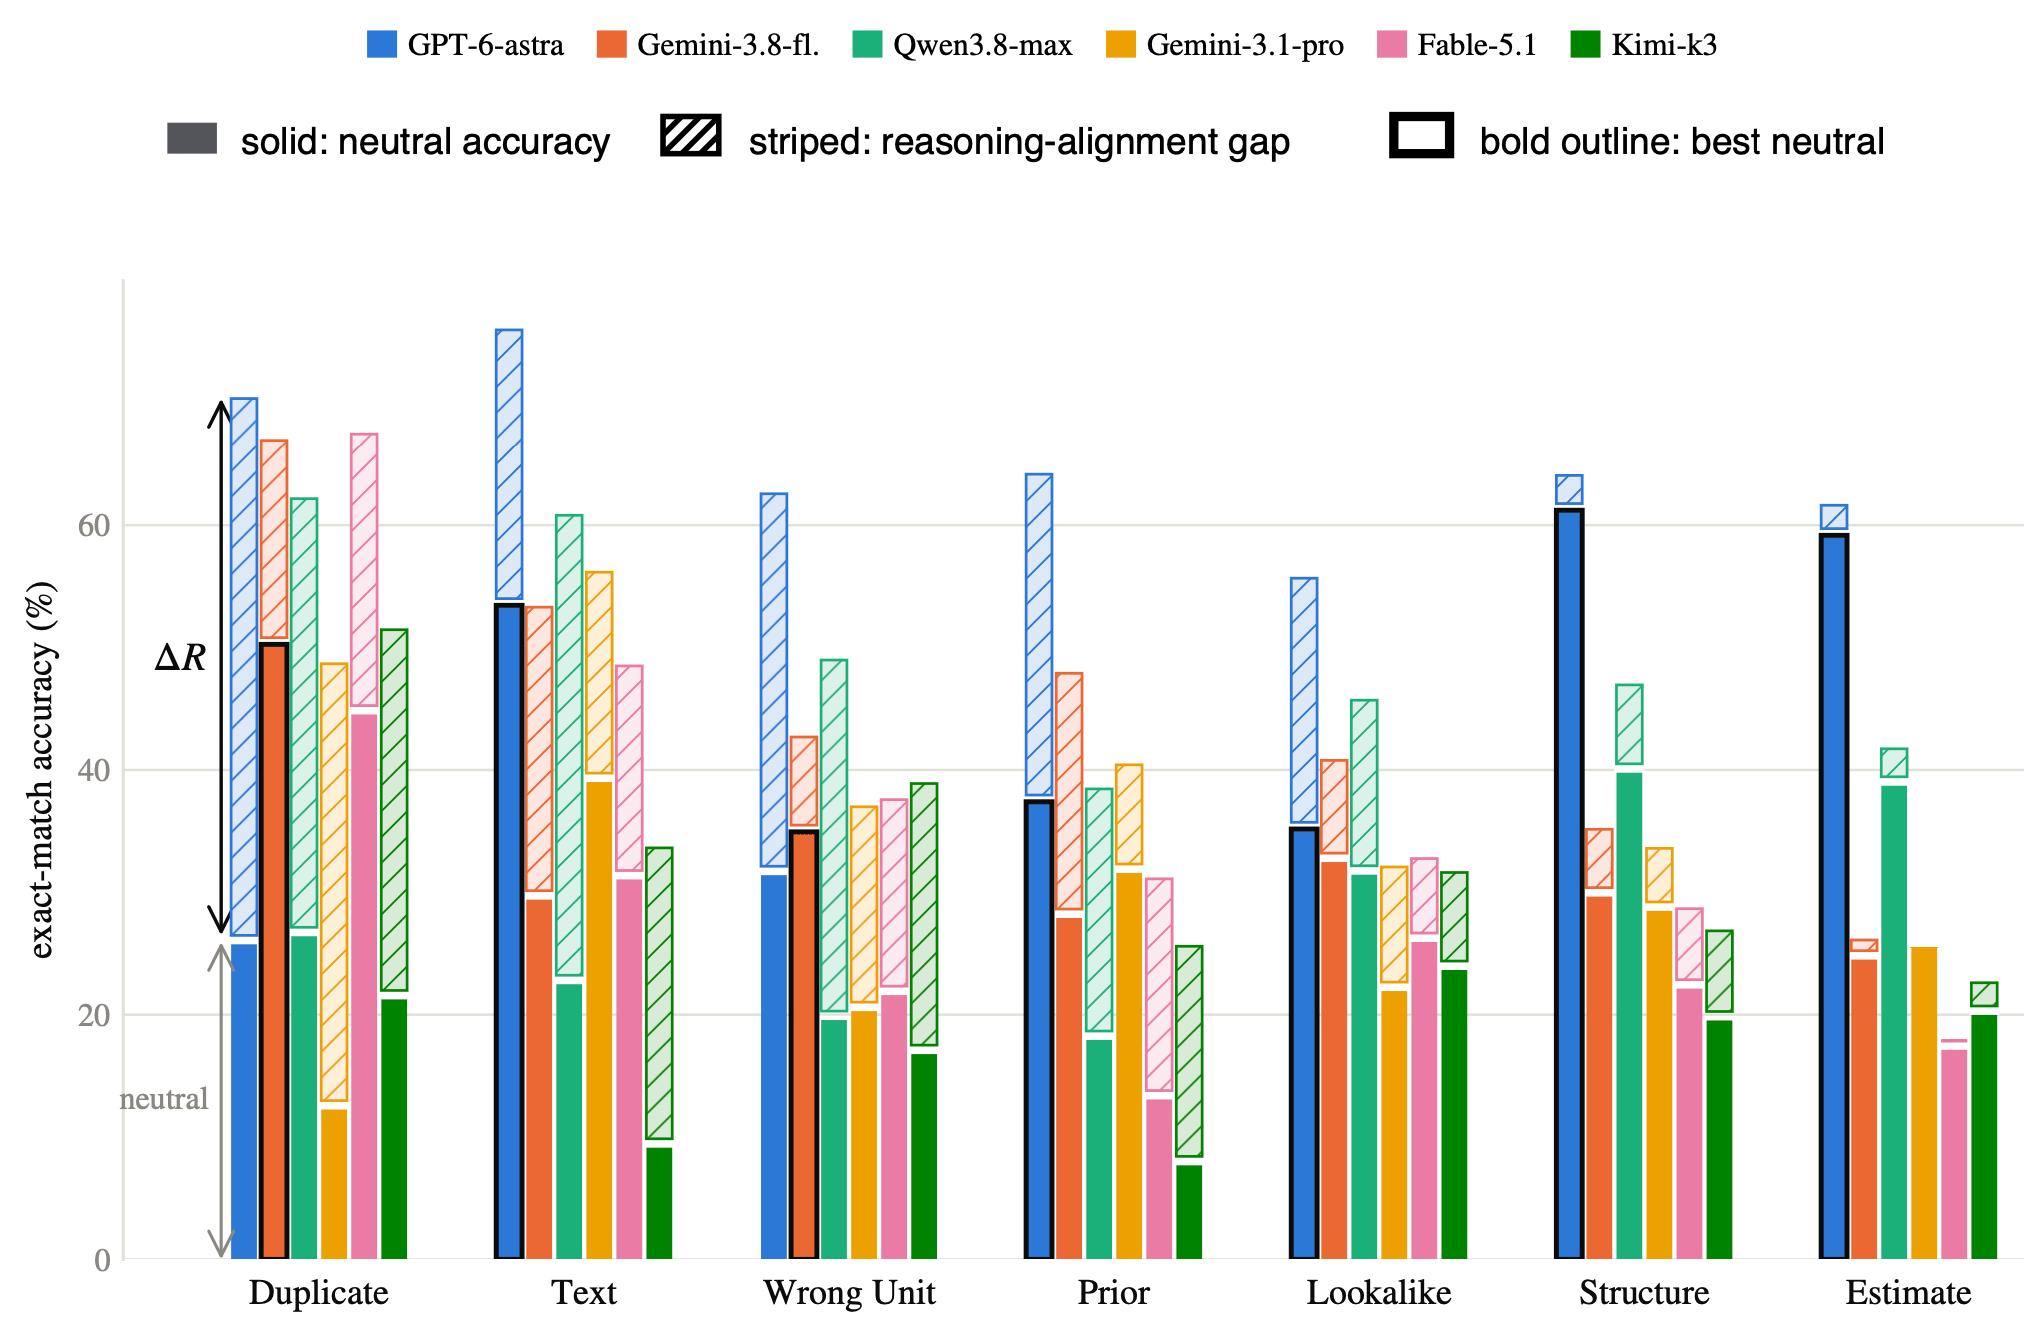
DecoyCount 论文中的前沿模型对比
视觉思维究竟是什么?
Andrew Dai 绝非 AI 领域的初来乍到者。早在 2015 年在 Google 工作期间,他就曾合著了一篇题为 [Semi-supervised sequence le