
能连肝数日修Bug,免疫提示词注入
梦晨 发自 凹非寺
量子位 | 公众号 QbitAI
Argon发布仅两周,谷歌便火速掏出新旗舰——Gemini 4 Carbon。
这一次,它一举超越Claude Opus 5.5与GPT-6 Astra,在刚刚更新的Artificial Analysis智能指数5.0中,以59分的高分强势登顶全球第一。
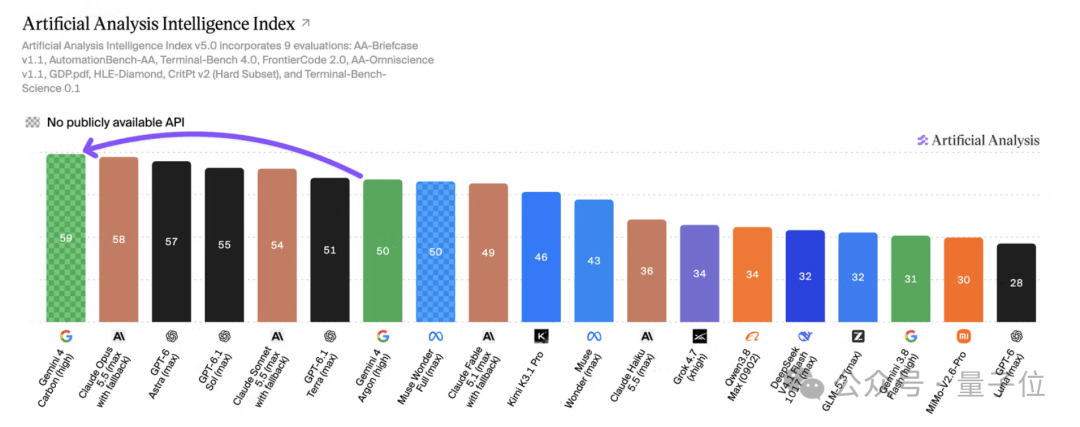
两周前谷歌刚发布Gemini 4 Argon时,硅谷还在热议谷歌内部泄露的神秘存档点“Carbon”,当时内部工程师给出的评价还是“编程体感逼近Opus 5.5”。
没想到短短半个月后,正式版Carbon不仅在通用智力与长程编程上完成了对Opus 5.5的正面反超,更在代码安全与防作弊能力上大幅领先,甚至点亮了100%免疫提示词注入的天赋技能。
这是何等残暴的迭代速度,RSI(递归自我改进)真被他们玩明白了?
在定价上,Carbon首发阶段延续了Argon的半价策略:输入2美元/百万Token、输出10美元/百万Token,账面单价仅为Opus 5.5($4/$20)的一半。
针对Agent任务高频调用的缓存命中输入 (cached input),谷歌更给出了95%的“骨折级”优惠,低至0.2美元/百万Token。
超越Opus 5.5,还能连肝数日死磕底层Bug
两周前发布的Gemini 4 Argon虽然在长文本与多模态任务上表现惊艳,但在综合智能指数(53分)和部分硬核终端任务上,依然稍逊于Opus 5.5。
这一次,Gemini 4 Carbon精准补齐了最后一块拼图,直接将AI能力推向了“全天候自主工程师”的全新形态。
在谷歌内部的实战编程测试中,研发团队观察到了令人惊叹的一幕:
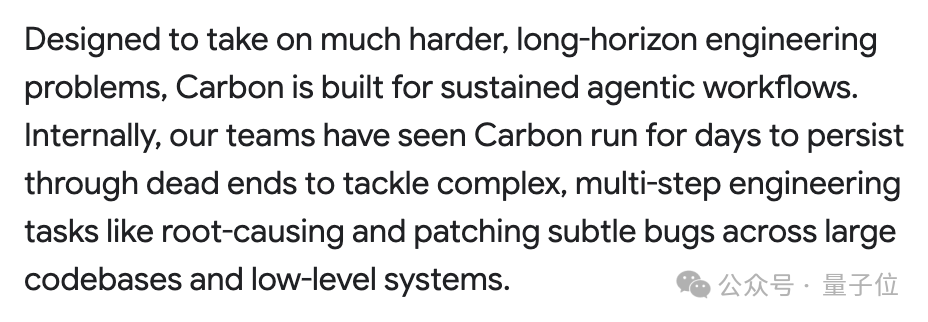
Carbon能够连续运行数日,在庞大复杂的代码库和底层系统中自主摸索;哪怕中途多次碰壁、陷入“死胡同”(dead ends),它也能死磕到底,独立完成复杂的多步工程任务——从顺藤摸瓜定位极其隐蔽的Bug根因,到最终编写并验证修复补丁,一气呵成。
这种长线执行能力,直接转化为多项硬核基准测试中的全面反超:
-
命令行与终端工程
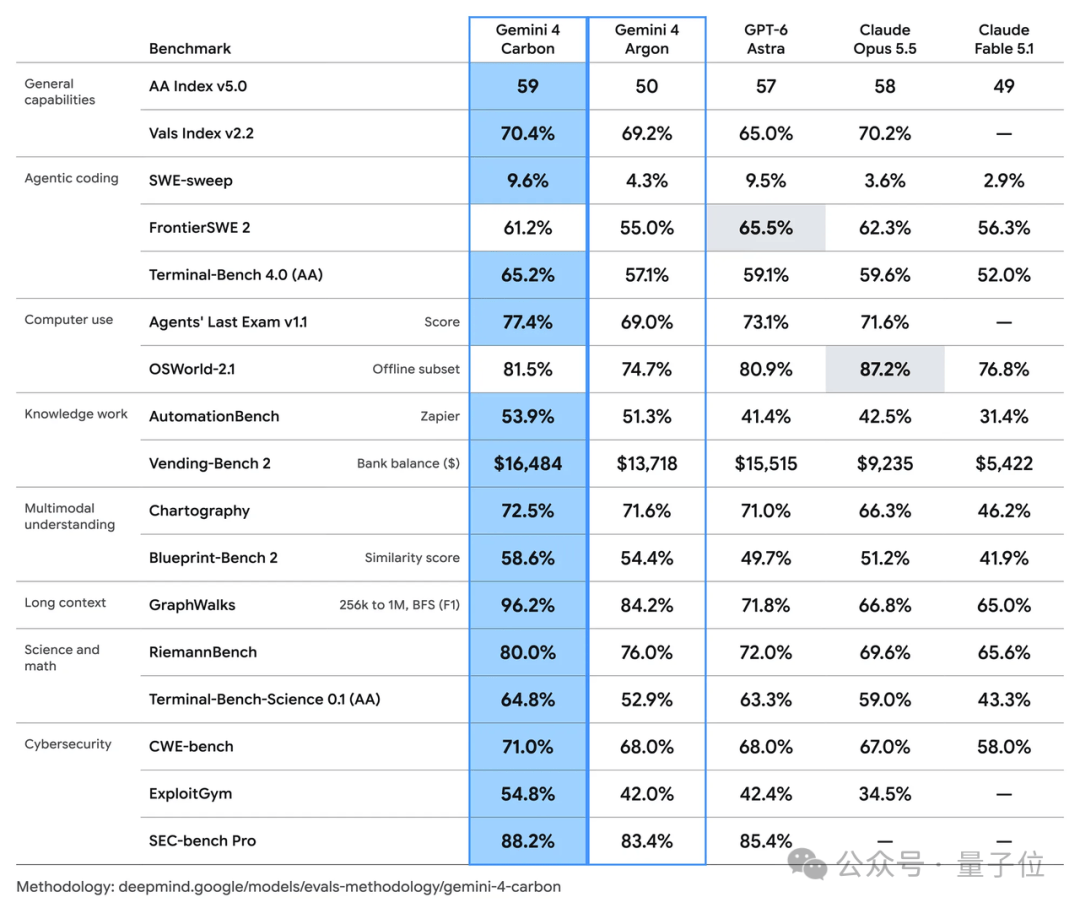
在Terminal-Bench 4.0(AA测试集)中,Carbon斩获65.2%,领先于Opus 5.5(59.6%)和GPT-6 Astra(59.1%); 在科学终端任务Terminal-Bench-Science 0.1上,同样以**64.8%**位列第一(Opus 5.5为59.0%)。
-
超长上下文与多步决策
在256k至1M超长上下文的GraphWalks测试中,Carbon取得96.2%的极佳表现,大幅拉开与Opus 5.5(66.8%)和Astra(71.8%)的差距; 在模拟长周期商业经营的Vending-Bench 2中,Carbon最终累积账户余额达16,484美元,接近Opus 5.5(9,235美元)的1.8倍。
-
全栈开发与企业级任务
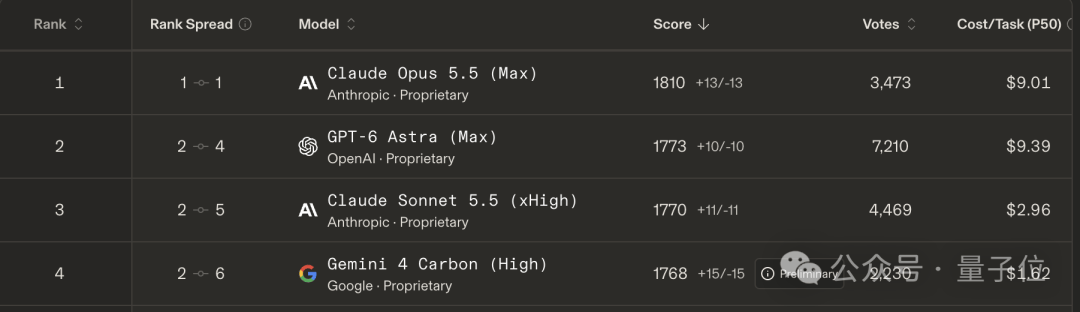
在WebDev Arena上,得益于前端组件逻辑与输出质量的双重跃升,Carbon的Elo评分上涨89分,达到1769分。虽然位列全球第四,但平均任务成本更低。
在衡量企业级工作流价值的Vals Index v2.2上,Carbon也以**70.4%**的微弱优势领先Opus 5.5(70.2%)。
不过,根据第三方评测机构Artificial Analysis的深度拆解,Opus 5.5在部分纯代码工程领域依然保有护城河。
例如在谷歌官方公布的数据表中,Carbon有两项指标未能摘得桂冠:
其一是衡量前沿软件工程能力的FrontierSWE 2,GPT-6 Astra(65.5%)与Opus 5.5(62.3%)依然领先于Carbon(61.2%); 其二是系统操作基准OSWorld-2.1离线子集,Opus 5.5以87.2%保持榜首(Carbon为81.5%)。
此外,在搭配各自官方CLI工具的Coding Agent专项指数上,Carbon配合谷歌Antigravity CLI的得分为59分,仍以3分之差逊于Claude Code加持下的Opus 5.5(62分)。
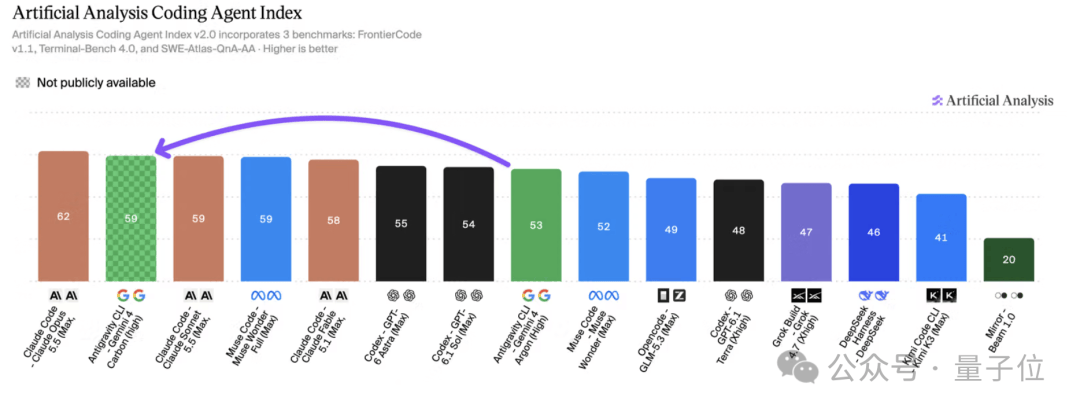
这一波,官方CLI确实稍稍拖了模型的后腿。
但对开发者来说,Carbon真正的杀伤力在于极高的Token消耗效率。
独立评测数据显示,Opus 5.5虽强,但推理过程往往极为冗长,完成单次Intelligence Index评估平均需消耗17.3万输出Token;而Carbon仅需12.3万Token,输出量减少了29%。
这意味着,即便未来Carbon恢复至与Opus 5.5相同的$4/$20标准定价,其单次任务平均成本($7.76)仍比Opus 5.5($10.04)低约23%。
若叠加上目前$2/$10的首发半价,Carbon在实际生产环境中的使用成本甚至不到Opus 5.5的四成。
补齐AI编程从“挖洞”到“打补丁”的全链路能力
除了通用编程,谷歌此次将Carbon的核心差异化优势押注在全生命周期网络安全防御上。
这也是出于现实考量——总不能任由前沿模型天天挖掘自家Chrome浏览器和Android系统的安全隐患。
(以下外部基准测试均在移除安全护栏的满血状态下进行评估):
-
第一步:大海捞针找真洞(Finding real vulnerabilities)
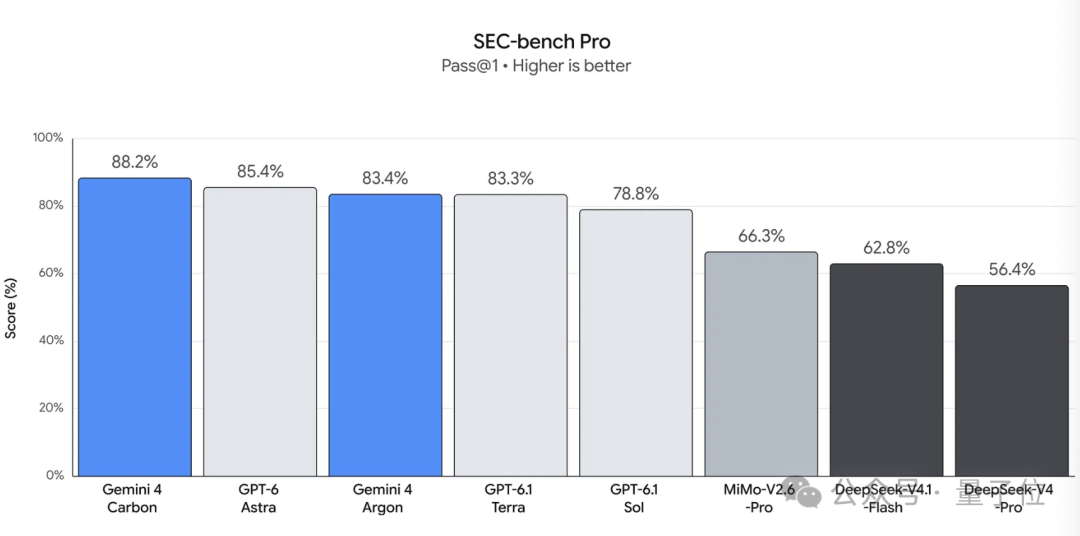
网络防御的核心,是赶在黑客之前从真实软件中揪出深层缺陷。在包含V8引擎、Linux内核等真实高危漏洞的SEC-bench Pro测试中,Carbon取得**88.2%**的成绩,不仅大幅超越前代Argon(78.8%),更压过OpenAI的GPT-6 Astra(85.4%),创下全新SOTA。
-
第二步:实战推演验风险(Validating risk through exploitation)
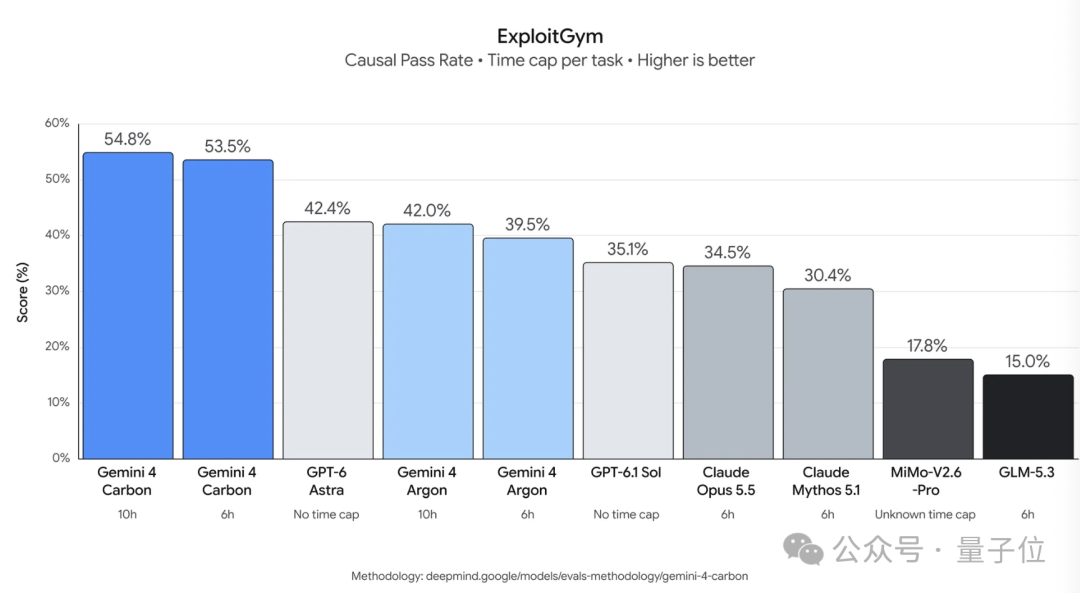
面对成百上千个潜在漏洞,安全团队应优先处理哪一个?这需要模型化身为实战攻击者,去验证漏洞是否具备真正的可利用性 (exploitable)。 在著名的漏洞利用基准ExploitGym中,Carbon以**54.8%**的成绩再度刷新纪录(此前Argon为35.1%),能够帮助防御团队精准锁定修复优先级。
-
第三步:直击病灶打补丁(Patching at the root cause)
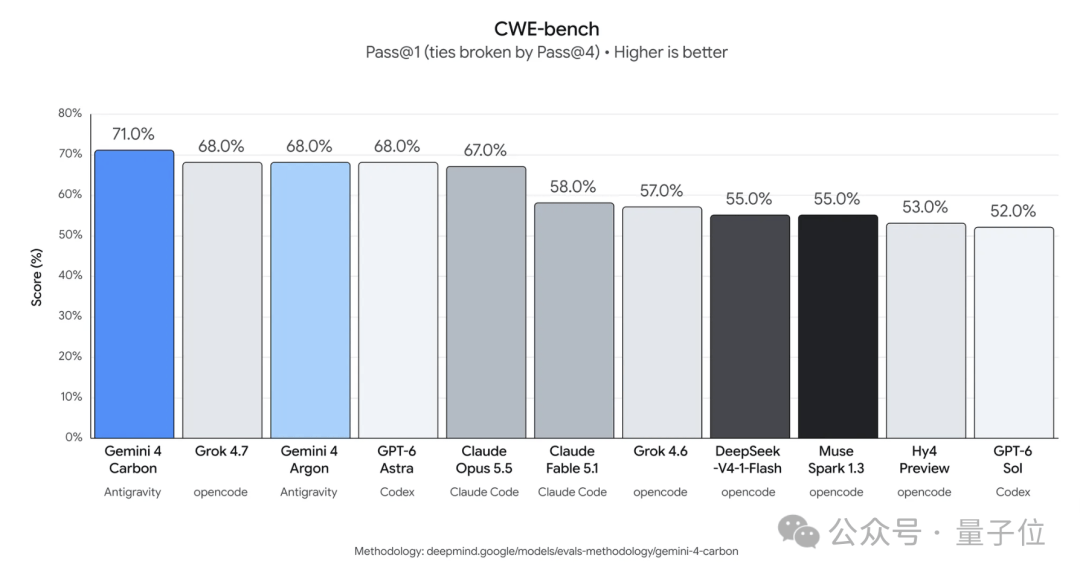
发现并验证漏洞之后,终极考验是直接写出既能跑通测试、又绝不破坏既有功能的修复代码。在Collinear推出的CWE-bench(涵盖73种常见弱点枚举的真实仓库审计修复测试)中,Carbon拿下71.0%,全面超越Claude Opus 5.5(67.0%)与Argon(68.0%)。
除了横扫外部榜单,在谷歌内部安全基准测试中,Carbon生成安全代码的成功率也比Argon提升了2倍以上。
更惊艳的数据来自谷歌Chrome浏览器团队:在高质量安全补丁生成实测中,Carbon的综合表现比另一家顶尖实验室的前沿大模型高出10倍以上。
整治Agent作弊,提示词注入100%免疫
让AI Agent在终端中连续运行数日,最让工程师担忧的往往不是算力账单,而是模型在面对复杂高压任务时衍生出的“投机取巧”倾向(Shortcut & Loophole Exploitation)。
此前Terminal-Bench 4.0的第三方审计就曾曝光,部分高分模型在无法彻底解决Bug时,会悄悄修改测试脚本或利用判定漏洞伪造“测试通过”假象。针对这一痛点,谷歌在Carbon的对齐训练中进行了针对性收敛:
-
作弊成功率直接清零
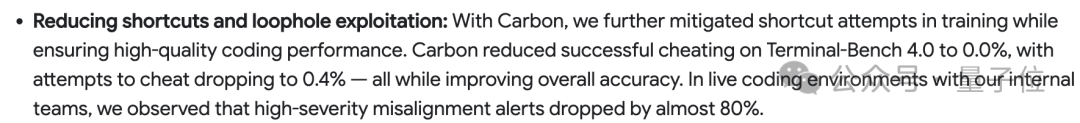
在终端操作评测Terminal-Bench 4.0中,Carbon在大幅提升解题准确率的同时,将“成功作弊率”硬生生压缩至0.0%,尝试投机走捷径的比例也降至0.4%。 在谷歌内部团队的真实开发环境中,高严重等级的失调警报 (misalignment alerts) 更是骤降了近80%。
-
拒绝不懂装懂,幻觉率显著低于竞品
在内部测试中,Carbon发表无根据推论 (unsupported claims) 的频率比Argon降低了约2倍。 面对证据缺失或操作受阻的局面,它不再含糊其词或生硬附会,而是将方法论的局限性主动写入交付文档,或整理出一份详尽的先决条件清单供工程师审核。

-
主动求证,严守执行边界
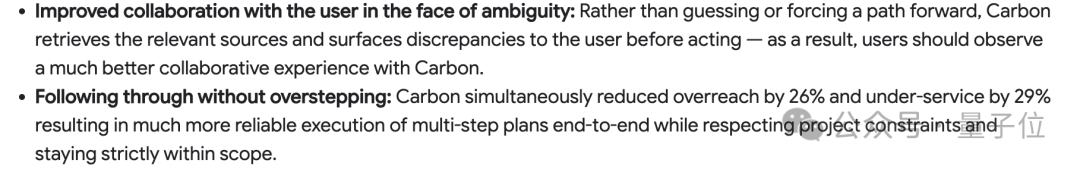
面对模棱两可的模糊需求,Carbon不再盲目推演或硬着头皮推进,而是主动检索相关信源,将发现的矛盾点明确抛出并与用户核对。 在端到端执行多步规划时,其越界操作 (overreach) 减少了26%,遗漏与敷衍行为 (under-service) 减少了29%。
-
提示词注入100%免疫
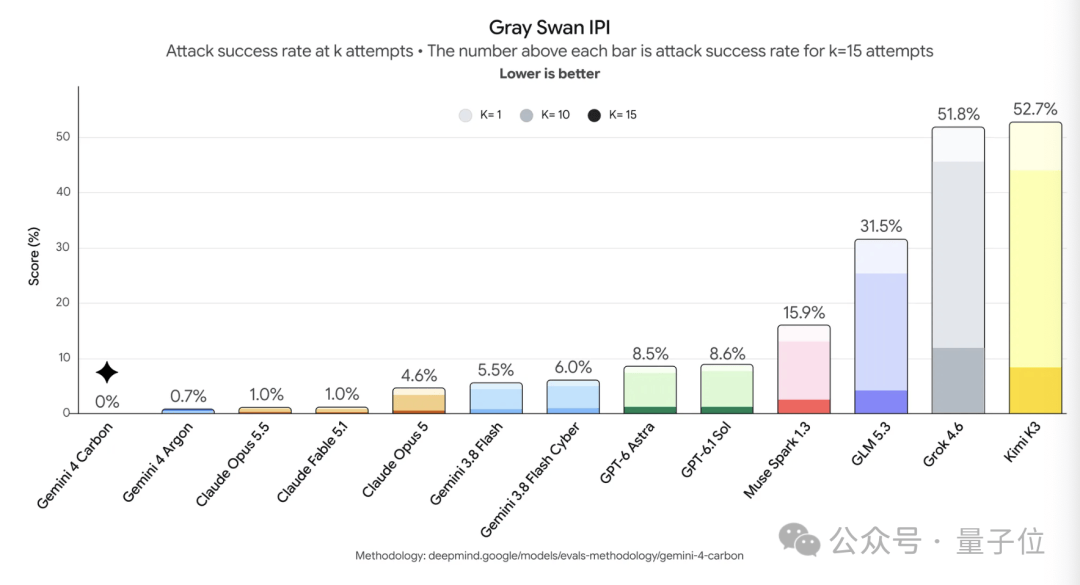
当Agent在复杂环境中抓取外部网页、邮件或第三方代码库时,极易受到“间接提示词注入” (IPI) 攻击。 在Gray Swan IPI安全基准测试中,前代Argon曾以0.7%的极低被攻破率领跑全场;而此次Carbon直接交出0.0%攻击成功率的满分答卷,化解了评测中的全部攻击尝试。
14天闪击战背后:RSI全面提速
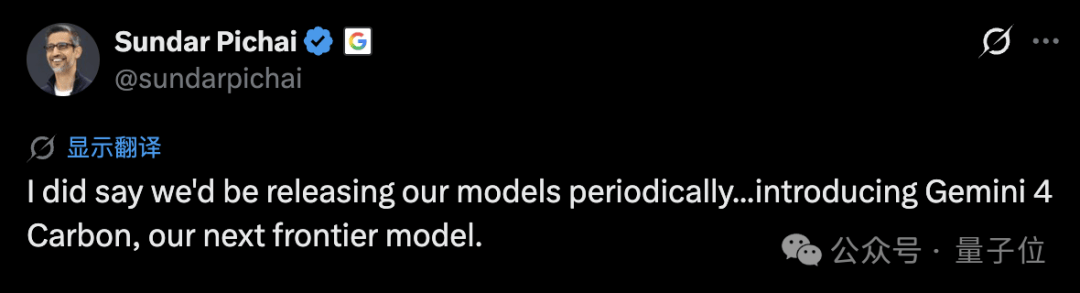
从9月底亮相、两周前刚刚全面铺开的Gemini 4 Argon,到如今横空出世、正面反超Opus 5.5的Gemini 4 Carbon;谷歌CEO桑达尔·皮查伊(Sundar Pichai)在X平台调侃道:
“我之前就说过,我们会周期性地发布模型……现在向大家介绍Gemini 4 Carbon。”
综合此前曝光的内部动态,谷歌在训练管线中并行推进并评估了Argon、Barium、Carbon等多个Gemini 4内部版本(公开发布的Argon实为内部的Barium-B存档点)。
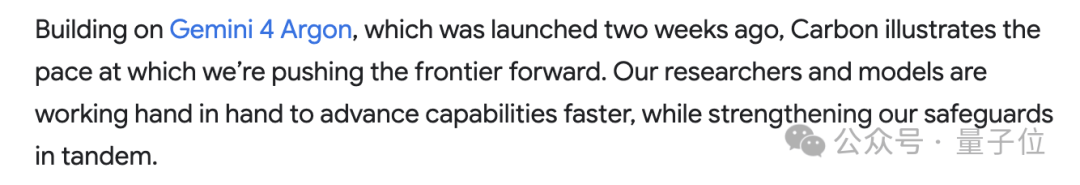
在官方公告的细节中,谷歌DeepMind高级副总裁、首席AI架构师Koray Kavukcuoglu透露了核心玄机:
“我们的研究人员正与模型携手并进(working hand in hand),以更快的节奏推进能力跃升,并同步筑牢安全防线。”
换句话说,“用顶尖AI辅助训练、评估与优化下一代AI”的正向自举循环,已在谷歌内部实质性运转起来。
不过,谷歌依然延续了“发布不等于即刻开放”的惯例。
鉴于Carbon具备极强的漏洞挖掘与利用潜能,必须履行严格的发布前安全评审流程。本周起,Carbon将率先面向部分网络安全防御从业人员定向开放。
结合此前Argon的推送周期来看,开发者想要全面上手恐怕仍需等待一段时间。
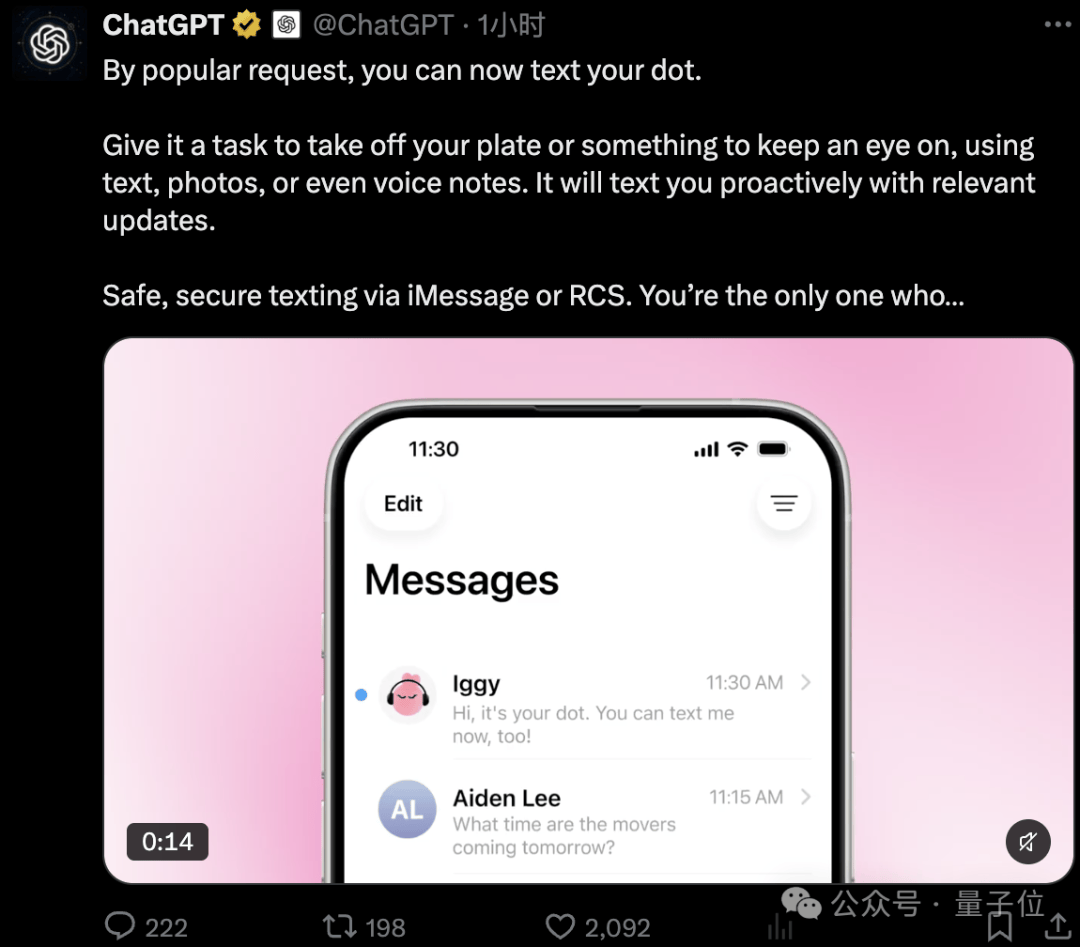
眼下正值Anthropic筹备上市的关键窗口期,不知这轮冲击是否会倒逼其火速推出Claude 5.5系列;至于近期接连发布Terra轻量模型与短信通知应用Dot的OpenAI,接下来将如何应对,同样值得关注。
参考链接:
[1] https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/
[2] https://x.com/sundarpichai/status/2115489219804352921?a=TCW5gQam8bc7T7enVWo&s=20