
跟 H200 和 Thor T5000 硬碰硬
金磊 发自 上海
我愿称之为国产芯片界的“真勇士”。
事情是这样的。
一家国产芯片公司,直接在活动现场把自家的 GPU 与英伟达 H200 进行了一场真刀真枪的实测对决。
更硬核的是,测试题目并非提前预设,而是随机挑选现场观众当场出题。
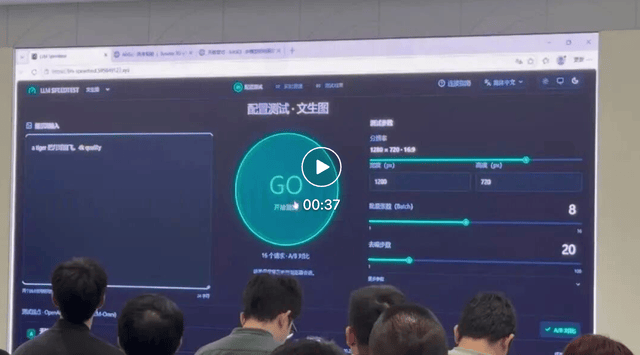
例如在文生图测试中,现场观众给出的提示词是“一只老虎把月亮踢飞”:
视频地址:
https://mp.weixin.qq.com/s/Non20tfUB860KjNQkW3LZQ
结果显示,这颗国产 GPU 成功胜出:其生成耗时仅为 95.6 秒,而英伟达 H200 耗时为 112 秒。
这还没完。
上述测试是在云端环境进行的,随后这家公司又拿出一台巴掌大小的银色设备,在端侧完全断网的状态下,与英伟达的机器人计算平台 Jetson Thor T5000 展开正面对决。
测试同样由现场观众随机出题,这次的题目是:“狮子和老虎单挑,谁会赢?”
视频地址:
https://mp.weixin.qq.com/s/Non20tfUB860KjNQkW3LZQ
肉眼可见,这台国产设备的推理响应速度明显快于 Thor T5000。
这家国产芯片企业,正是天数智芯。
在云端跑赢 H200 的是其主力产品天垓 300;在端侧跑赢 Thor 的,则是边缘计算产品彤央 TY1200。
此外,天数智芯还在同场活动中发布了主打“以 AI 开发 AI”的天数智算软件栈。
关注天数智芯的行业人士或许还记得:今年 1 月,在其上市敲钟半个月之际,公司便一口气推出了四款彤央边缘端产品,当时 TY1000 实测性能已超越英伟达 AGX Orin。
同日,天数智芯还公布了一份跨越四代的产品架构路线图:第一站直指超越 Hopper 的天枢架构,后续还将进一步对标 Blackwell 和 Rubin 架构。
9 个多月后,天数智芯如期交卷。
天垓 300 正是基于天枢架构打造,此次对标的是 Hopper 家族的旗舰 H200;端侧的对标产品,也从 Orin 升级为了性能更强的 Thor。
谈及为何云端、软件栈与边缘端“三线齐发”,天数智芯的核心逻辑如下:
云端负责生产智能,软件栈负责加速适配与性能优化,端侧则负责将智能落地到工厂、实验室、医院等真实物理场景。
在天数智芯看来,三者紧密咬合,才构成了其所定义的高质量算力——即具备高效率、可预期与可持续性。
以下为本次实测的详细解析。
天垓 300:对标 H200,交出实测答卷
首先来看云端旗舰天垓 300。
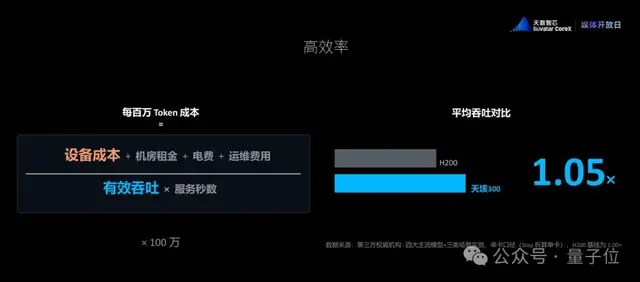
该芯片并非首次公开亮相。早在今年 7 月,第三方权威评测机构就曾针对四大主流大模型和三类典型应用场景,对天垓 300 进行了全面测试。
在大模型经典的 Prefill-Decoding(PD)分离部署架构下,天垓 300 折算单卡端到端吞吐量达到了 H200 的 1.05 倍。
值得注意的是,这项测试并非对比理论峰值算力,而是衡量整条推理链从输入到输出实打实吐出的 Token 速率。
天数智芯表示,天垓 300 由此成为国内首款在实测性能上达到 H200 水平的通用 GPU。
作为一款通用 GPU,天垓 300 在训练与推理两侧均具备强劲实力。
先看推理表现。
对于当前的大语言模型而言,长上下文处理是必须跨越的关卡。天数智芯 AI 与加速计算负责人单天逸在现场打了个生动的比方:
谈恋爱十周年,女生问男生这十年最难忘的时刻是什么,男生不可能把 3650 天从头到尾回忆一遍,脑海中浮现的往往只有几个关键瞬间。
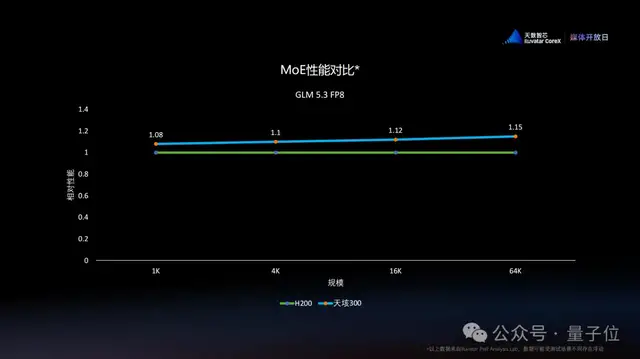
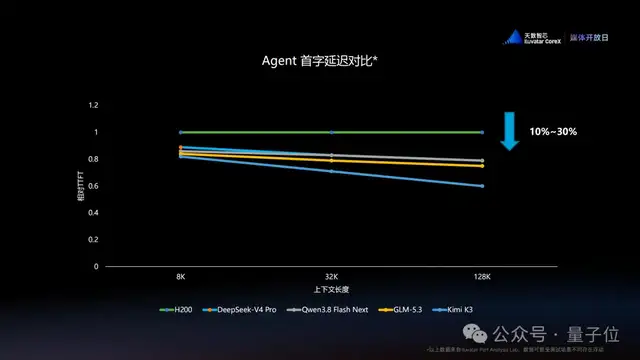
这正是 Attention(注意力机制)的核心作用,天垓 300 也专门对此进行了针对性优化。实测数据显示:在 64K 上下文规模下,运行 GLM-5.3 时其 MoE 吞吐达到 H200 的 1.15 倍;在 8K 至 128K 长上下文场景中,Agent 首字延迟相比 H200 降低了 10% 至 30%。
再看训练表现。
在基于 Qwen3-32B 的 8 卡 FP8 训练任务中,天垓 300 单卡有效吞吐达到 H100 的 1.33 倍。现场展示的 100 倍速训练命令行录屏显示,天垓 300 率先完成既定步数,而 H100 仍在执行中。
视频地址:
https://mp.weixin.qq.com/s/Non20tfUB860KjNQkW3LZQ
除了常规预训练,天垓 300 还能良好承载强化学习任务,而这正是当前主流大模型核心采用的后训练技术路线。
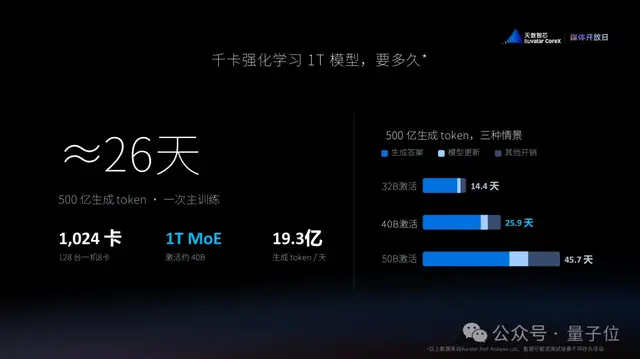
根据天数智芯的工程测算,部署 1024 张天垓 300,约 26 天即可对一个 1T 总参数、40B 激活参数的 MoE 模型完成一轮完整的强化学习训练,能够精准契合大模型厂商约一个月迭代一次的工程节奏。
在推理与训练之外,针对当前备受关注的 Token 工厂 建设,天垓 300 同样给出了解决方案。
建设一座 Token 工厂,硬件设备支出约占总投资的 75% 至 80%。在硬件固定投入难以削减的前提下,单卡产出越高、运行越平稳,单个 Token 的边际成本才越低。
在产出效率上,前述 1.05 倍的吞吐优势已经给出了印证;在运行稳定性方面,关键则在于步时波动率:
满负荷运行时,天垓 300 的步时波动率仅为 0.43%,而对照组 Hopper 方案为 0.76%。这意味着即使面临长时间超高负载,天垓 300 也能保持高度稳定的性能输出。
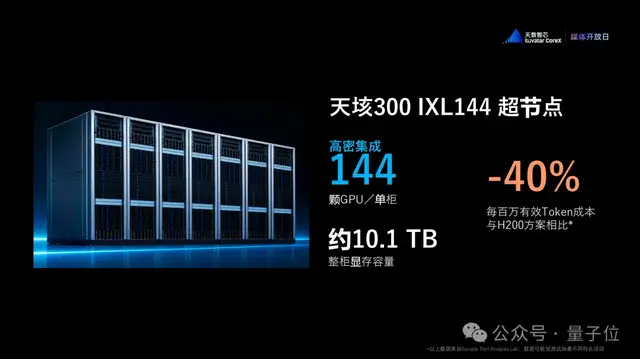
面向超大规模集群部署,天数智芯推出了 IXL144 超节点。
该方案在单个标准机柜内集成了 144 颗 GPU,聚合显存达到 10.1TB 左右,是目前业界计算密度最高的单机柜 GPU 超节点。据官方测算,相较于同等规模的 H200 方案,该方案可将每百万有效 Token 成本降低约 40%。
除了单卡性能外,天垓 300 的生态开放性也值得关注。
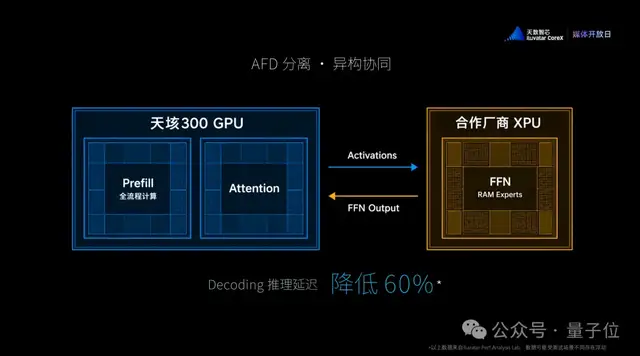
天垓 300 不仅支持与英伟达 H100、H200 进行混合异构训练,还能与其他芯片厂商的产品协同作业。
现场演示中,天数智芯跑通了国内首个 GPU + XPU 异构 AFD 分离部署方案:由天垓 300 负责 Prefill 与 Attention 计算,合作厂商的 XPU 负责 FFN 计算,实测将 Decoding 阶段推理延迟降低了 60%。
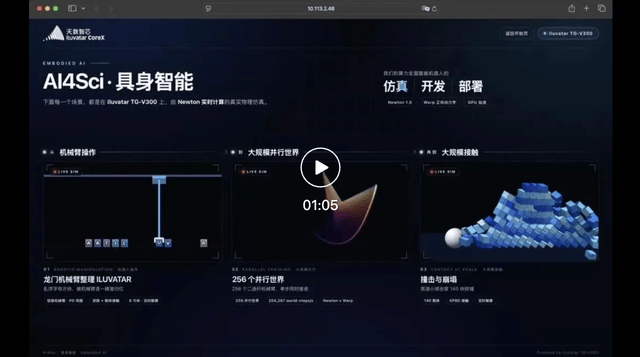
除大模型基准测试外,现场还展示了更为硬核的物理仿真能力。在单天逸看来,AI 技术远不止 Transformer,算力芯片更不应制约底层算法的探索。为此,现场展示了三组仿真案例:
首先是用单张天垓 300 实时模拟龙门吊运行,滑块摩擦力、起吊速度与受力动态均由芯片实时解算;
其次是将 256 组二连杆机构接入同一模型开展强化学习,相当于构建了 256 个并行虚拟环境同步试错,对 GPU 并行计算能力提出了极高要求;
最后是高密度的滑块碰撞实验:140 个滑块相互撞击,相互产生受力传递,每发生一次碰撞,芯片必须同步完成全量滑块的动力学解算。
视频地址:
https://mp.weixin.qq.com/s/Non20tfUB860KjNQkW3LZQ
这些看似基础的物理动画仿真,实际上是具身机器人进入物理真实世界前必须经历的模拟训练基石。
彤央 TY1200:300T 稠密算力,反超 Thor T5000
视线转向端侧。
正如前文所述,彤央 TY1200 本次的直接对标对象是英伟达 Jetson Thor T5000。
天数智芯彤央产品市场负责人宋远盈表示,Thor T5000 是英伟达在端侧极具竞争力的旗舰产品,官方标称算力为 2070 TFLOPS(FP4 稀疏)。相比之下,TY1200 的标称算力为 300 TOPS,且为稠密算力。
仅从纸面参数对比,TY1200 并不占优,宋远盈也直言折算后 TY1200 标称参数确实低于 Thor。
但在实际负载测试中,结果呈现出反转:在运行大语言模型 Qwen3.8-27B 时,TY1200 的性能达到 Thor T5000 的 138%;在 MoE 架构的 Qwen3.6-35B-A3B 测试中,亦达到其 110%。
更受关注的是英伟达开源的世界模型 Cosmos:在 Cosmos-R2-2B 上,TY1200 的运行表现为 Thor 的 158%;在 Cosmos-R2-8B 上,这一优势进一步扩大至 180%。
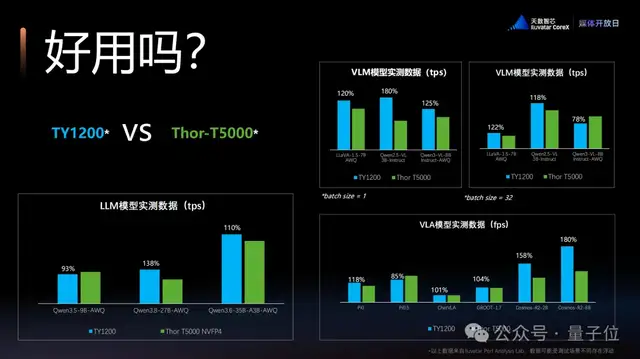
这意味着 TY1200 在英伟达主推的端侧世界模型赛道上实现了领先。
除基准跑分外,现场还展示了基于 TY1200 单机运行的三项实际任务:
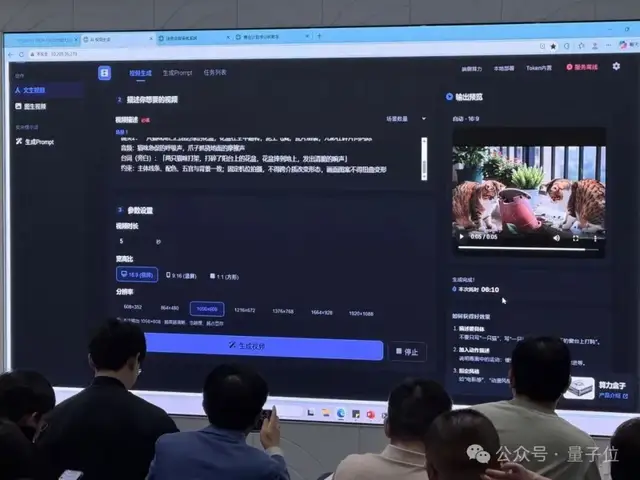
第一项任务是本地端侧视频生成:通过现场观众随机出题,基于开源的 MiniMax H3 视频生成模型,在完全离线不联网的环境下由 TY1200 本地生成。
历时约 6 分钟,设备便输出了一段分辨率为 1056×608、时长 5 秒的高清视频片段。
尽管 6 分钟耗时略逊于云端集群,但端侧部署避免了云端排队延时与不可控的 API 调用成本,完全实现了离线免费推演。
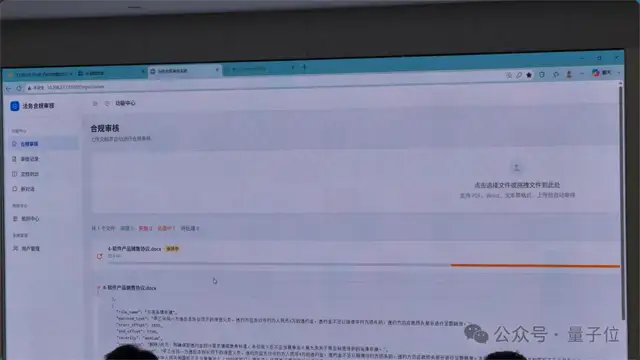
第二项任务是合同智能审查。
将一份长达 1 万字的软件采购合同载入后,TY1200 在两分钟内便精准标识出高、中、低各类法律及合规风险点,并附上了详尽的法律法规与企业内控条款依据。
第三项任务则是针对具身智能的机器实体——MicroDuck(微型双足机器鸭)。
据宋远盈介绍,此前同类演示通常需要借助云端超算完成前序训练;而天数智芯本次则将仿真训练、虚拟验证到实体控制部署的全链路,完整收敛至单台 TY1200 设备中运行。
为此,TY1200 首次在国产端侧计算硬件上跑通了基于 MuJoCo-Warp 的 GPU 加速物理仿真环境。
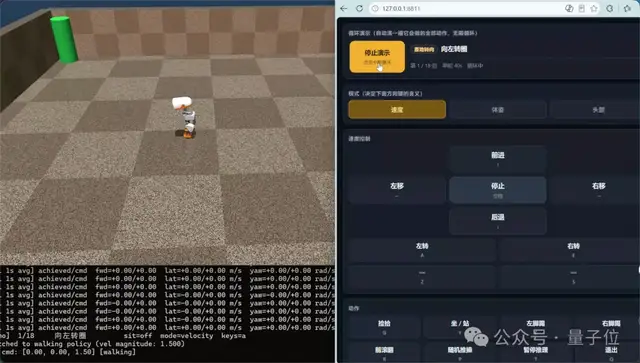
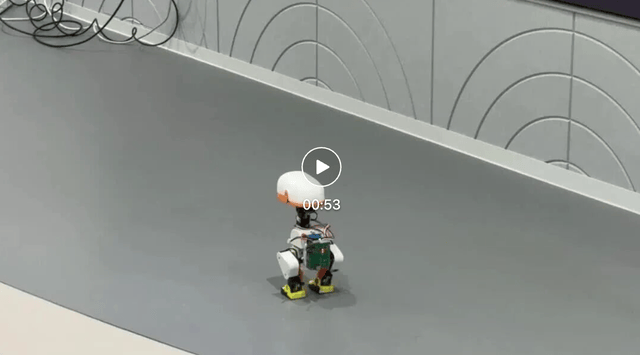
宋远盈透露,团队从拿到硬件实体到完成模型适配仅耗时三四天,此前内部验证甚至未曾完全跑通。
但现场演示中,这只双足机械鸭在短暂摇晃与一次摔倒后,成功自主起立并完成稳定行走,交出了超出预期的实测答卷。
视频地址:
https://mp.weixin.qq.com/s/Non20tfUB860KjNQkW3LZQ
除 MicroDuck 外,彤央系列在具身智能领域已有诸多落地实践:
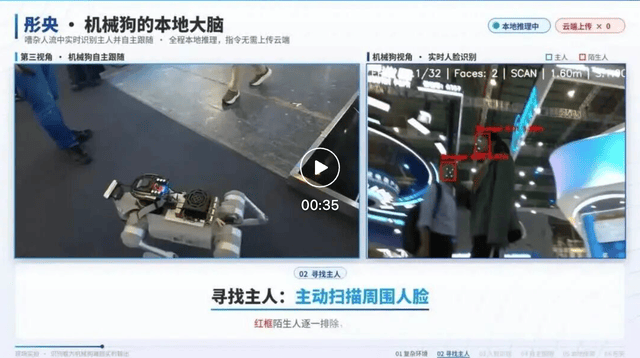
在两周前的工博会上,搭载 TY1000 算力模组的四足机器狗已公开展示:其无需人工遥控,完全基于端侧算力进行实时人脸识别与跟随,全流程无需任何数据回传云端。
视频地址:
https://mp.weixin.qq.com/s/Non20tfUB860KjNQkW3LZQ
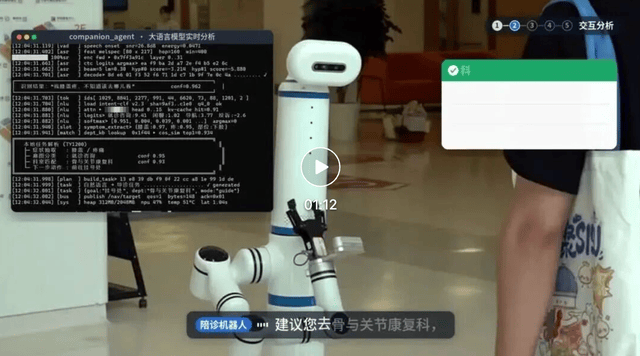
搭载 TY1200 的医疗陪诊机器人则已在上海市养志康复医院(上海市阳光康复中心)实地投入使用。视障患者只需语音提出挂号诉求,机器人即可自主导引并实时感知规避障碍物。
视频地址:
https://mp.weixin.qq.com/s/Non20tfUB860KjNQkW3LZQ
活动最后,宋远盈还披露了下一代端侧旗舰产品 TY2000 的研发规划,其标称算力将进一步提升至 600 TOPS。正如其所总结的那样:
云端 GPU 厂商涉足边缘端,本质不是把芯片做小,而是把算力能力全面下沉。
让资深工程师的经验,赋能全体开发者
尽管硬件规格持续突破,但对于生态开发者而言,开发体验与易用性才是核心瓶颈。
天数智芯副总裁兼软件开发负责人石加圣在现场分享了一个形象的对比:
早年在 DOS 系统下运行《仙剑奇侠传》或《大富翁 3》,用户必须反复调试复杂的硬件中断与内存配置,游戏才能艰难启动。
在他看来,当下的 AI 云端系统在一定程度上重现了昔日 DOS 的困境:异构 CPU、多样化互联拓扑以及繁杂的操作系统环境,往往给开发者带来重重阻碍。
为此,天数智芯选择全面将 AI 引入软件基础设施栈。
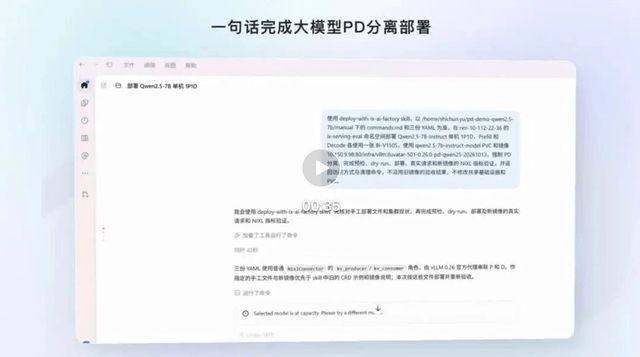
新一代天数智算软件栈深度拥抱 Agentic AI(智能体化架构),将过去服务数百家企业客户所沉淀的工程调优方案,抽象构建为一系列模块化“Skills”。开发者只需明确业务目标并设定约束条件,后续配置全权由 Agent 执行,开发者仅在核心节点负责最终确认。
视频地址:
https://mp.weixin.qq.com/s/Non20tfUB860KjNQkW3LZQ
以环境部署与拉起 PD 分离集群为例:传统人工配置通常耗时 1 小时以上,而在 Agent 协同下,全流程可在 10 分钟内自动完成,人工交互从几十步精简至单步确认。
算力性能调优同样实现了智能化托管。
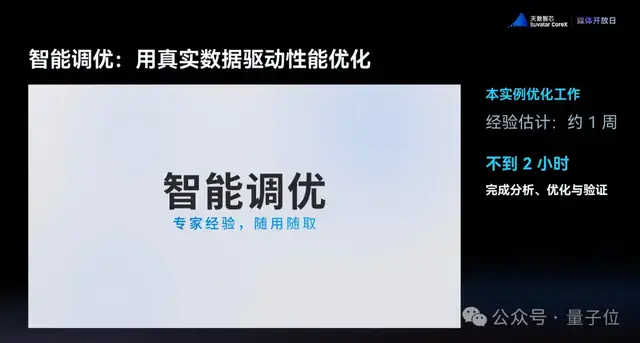
Agent 会自主调用天数智芯内置的性能分析工具,自动定位算力瓶颈、生成优化策略并启动闭环验证。在某大模型调优实践中,原本通常需耗费一周的工程任务,现可在 2 小时内完成“分析-优化-验证”全流程,模型运行性能实现接近翻倍。
在算子开发领域,天数智芯亦成为国内首家深度整合 FlyDSL 编译框架的 GPGPU 厂商,实现了借助 AI 模型自主生成、编译、验证并调优底层算子代码。
在针对某主流深度学习模型的适配调优中,原本预估需要 10 人天的工作量,在 Agent 辅助下不到 2 小时即完成开发,计算精度与吞吐性能均达到交付标准,编译等待周期大幅缩短 90% 以上。
