
让基建成为常驻 Buff
衡宇 发自 凹非寺
量子位 报道
什么时候才是具身智能的“ChatGPT时刻”?
大概是大家看到 GPT-6 Astra 仅凭一行 API 就能跨界向机器人下达指令的那一刻。
OpenAI 依然实力强劲,抢先一步向全世界证明:AI 的通用能力不仅足够惊艳,而且远未见顶。
好消息是:算法“发动机”的性能超乎所有人想象,AI 模型依然坐在疾驰的超跑上;
坏消息是:负责将指令转化为物理动作的工程底座(Infra),却还是一条坑洼不平的泥泞土路……
模型能力越强,就越需要一套好用、完善的具身 Infra,稳稳接住前沿算法的每一次跃迁。
近期,逐际动力更新了其开源工程底座 FluxVLA Engine 的第二版技术报告。
相较于 9 月发布的首版,V2 进一步加入了在线强化学习(Online RL)后训练实验,并显著扩展了仿真评测与真机部署的覆盖范围。
报告显示:
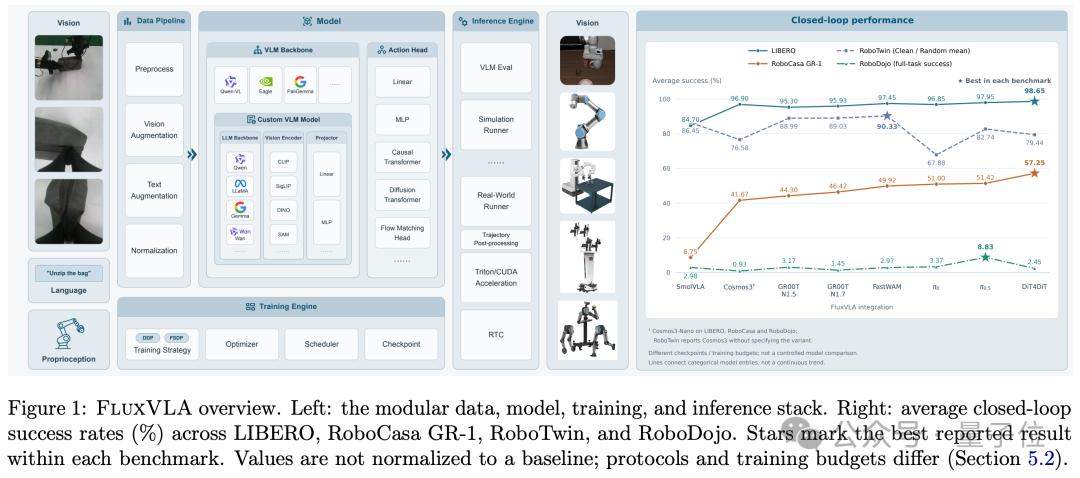
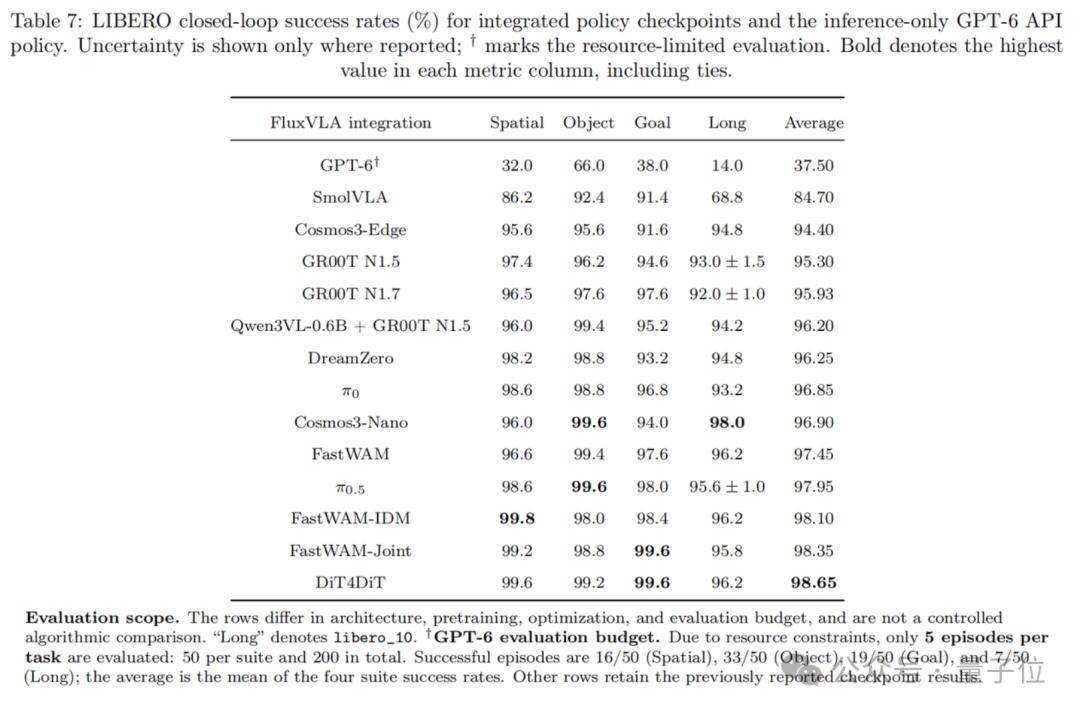
- 在仿真侧,14 种策略接入同一套 LIBERO 闭环评测;在 RoboCasa GR-1、RoboTwin 与 RoboDojo 上,也各有 8 种策略的接入与评测结果。
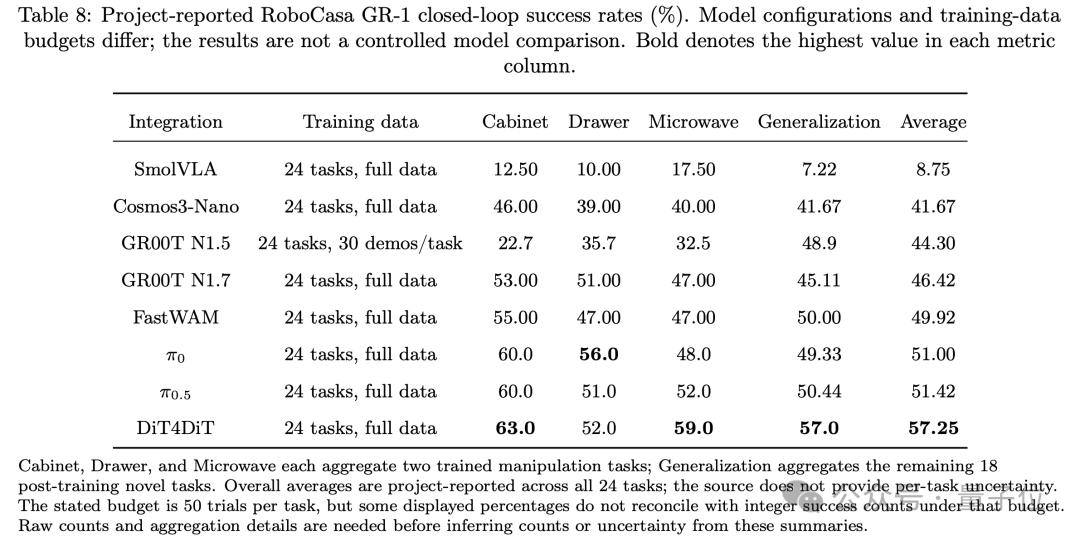
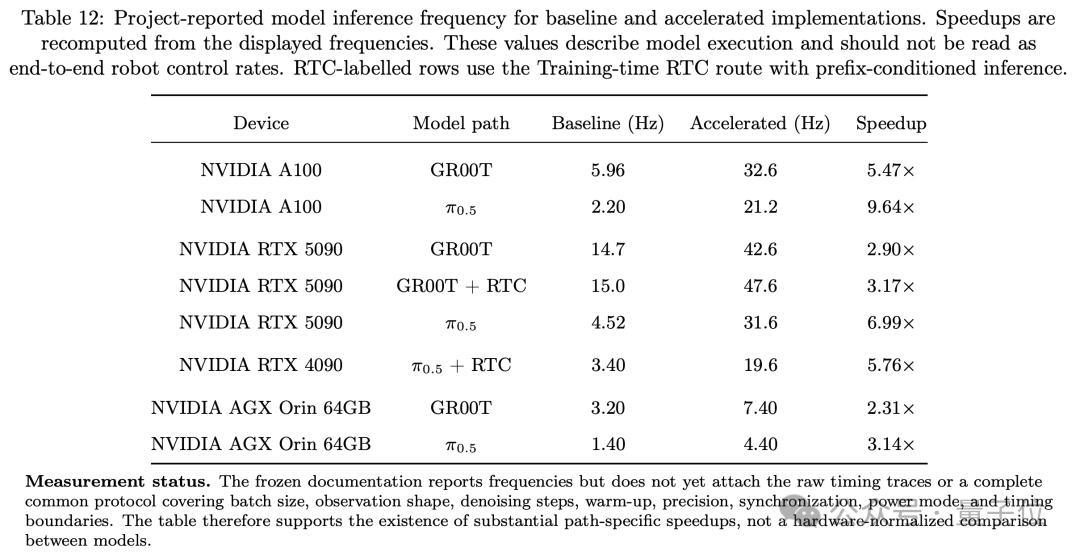
- 在推理端,针对 8 组模型与设备组合的实测表明,优化后的模型推理频率提升至 2.31~9.64 倍。
- 在硬件适配侧,涵盖 ALOHA、Rebot、双臂 Franka 以及逐际动力自研全尺寸人形机器人 LimX Oli 等多款真实硬件平台,报告完整验证了从模型 Checkpoint 直达真机闭环执行的部署全链路。
在线强化学习也是本次更新的重中之重。
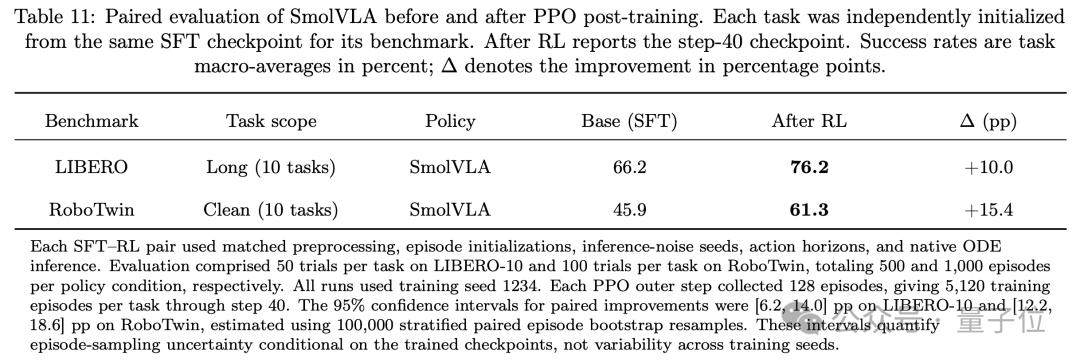
以 SmolVLA 为例,在两组配对实验中,经过在线强化学习后,其在 LIBERO-10 和 RoboTwin Clean 十项任务上的成功率分别提升了 10.0 和 15.4 个百分点。
自今年 4 月 8 日开源以来,FluxVLA Engine 持续拓展模型支持、评测配方和真机部署能力。
用逐际动力自己的话来说,FluxVLA Engine 的核心价值在于:让底层工程能力真正可复用,把宝贵的研发人力从无休止的“配环境、改接口”中解放出来,让先进的模型真正有路可走、有地可落。
告别“作坊式”重复造轮子,为具身研发建一条“标准产线”
为什么具身智能研发如此既烧钱又费人力?
关键原因之一是行业严重缺少统一的标准件。对大多数研发团队而言,几乎每一个新实验都像是一次性的“烟囱工程”。
FluxVLA Engine 的首要目标,就是将这种小作坊式的重复搭建升级为标准化的工业流水线——逐际动力创始人兼 CEO 张巍便将 FluxVLA Engine 比作具身模型的生产线。
为了确保这条生产线足够坚固、实用,团队围绕四大核心工程原则进行了底层架构设计:
- 统一配置(All-in-one):告别杂乱冗余的启动脚本,采用统一配置清单统管数据、模型、训练、评测与部署的关键参数。
- 模块解耦:通过注册表机制与标准化接口,将视觉语言骨干、动作头、数据集与训练策略模块化为标准积木,既支持灵活组合,也能保留原生策略实现。
- 面向部署的系统级优化:跳出实验室的理想环境,自系统设计伊始就将推理加速、RTC(实时动作分块协调)和轨迹后处理无缝集成至运行全流程。
- 全流程实验可复现:完整封存每一次实验的配置、模型状态与执行轨迹,做到成功有迹可循、失败有据可查。
尤为难得的是,自今年 4 月开源以来,FluxVLA Engine 始终保持着高频演进与持续运营。
回顾过去半年快节奏的迭代历程,足见其工程生命力:
- 4 月 8 日:FluxVLA Engine 正式开源
- 6 月 22 日:打通 LimX Oli 人形机器人全身移动操作的最小推理链路
- 6 月 30 日:支持单双臂 Franka 真机推理
- 9 月 9 日:接入 GR00T N1.7
- 9 月 16 日:首版技术报告上线 arXiv
- 10 月 15 日:扩展 RoboDojo 评测支持
- 10 月 22 日:发布 V2 技术报告,补充在线 RL 后训练、仿真与真机评测扩展
技术报告:
https://arxiv.org/abs/2609.17210
GitHub 主页:
https://github.com/FluxVLA/FluxVLA
Hugging Face:
https://huggingface.co/limxdynamics/FluxVLAEngine
依托这一连串扎实的迭代脚印,该底座的能力边界从最初的“能训练、能评测”,一路扎实扩展到如今的“能上真机、能实现数据回流”。
对研发团队而言,引入 FluxVLA Engine 就像身后站了一支持续迭代基建、不断拓宽边界的工程攻坚铁军。
如何用一个底座打通训、评、部署全链路
当前,具身智能的技术路线正处于快速收敛前的剧烈震荡期。
今天主流的是扩散策略,明天可能转向流匹配或世界动作模型。倘若每切换一条技术路线,既有的工程积淀都要推倒重来,即便是行业巨头也难免元气大伤。
想要避免“换模型就重头再来”的困境,唯一的路径便是将底层工程基建与上层算法彻底解耦。
换言之,行业亟需一个能够“以不变应万变”的工程底座。
FluxVLA Engine 正是这样的开源底座:它打通了“训练、评测、部署”的全链路,确保团队已有的工程沉淀不会清零。
具体实现方案可以从三个核心维度进行剖析:
1. 数据与模型层面的标准化
要让特性与架构各异的模型运转在同一条流水线上,首要任务就是规范底层的数据格式与接口协议。
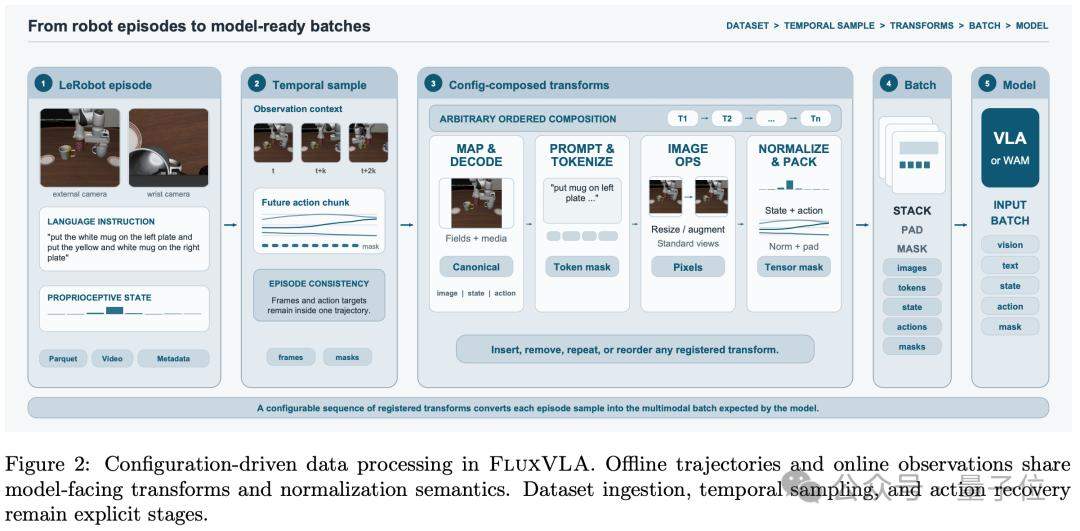
在数据层面,来自不同本体与不同仿真环境的原始轨迹,会经过显式转换与标准化清洗,整理为兼容 LeRobot 规范的统一结构(涵盖 Parquet 文件、视频序列及对应元数据)。
与此同时,诸如相机视角顺序、动作表达形式、归一化统计标准等技术约定,均会进行严格对齐。
这批数据处理完成后,既能在同一流水线中混合训练,也可按分组保留独立的预处理与归一化规则。无论训练还是推理,系统均通过独立的数据入口遵循统一的模型输入与动作语义。
在具身智能研发中,数据是成本最高昂的核心资产;降低数据贬值风险、提升复用效率,本身就是极具价值的行业级降本方案。
同样的思路也贯穿于模型层面。
平台目前已深度集成 Qwen-VL、GR00T、π 系列以及 DreamZero 等主流 VLM、VLA 和 WAM 架构。
各类模型不仅可以保留原生的网络骨架,还能通过统一接口无缝接入训练、评测与真机部署环节。
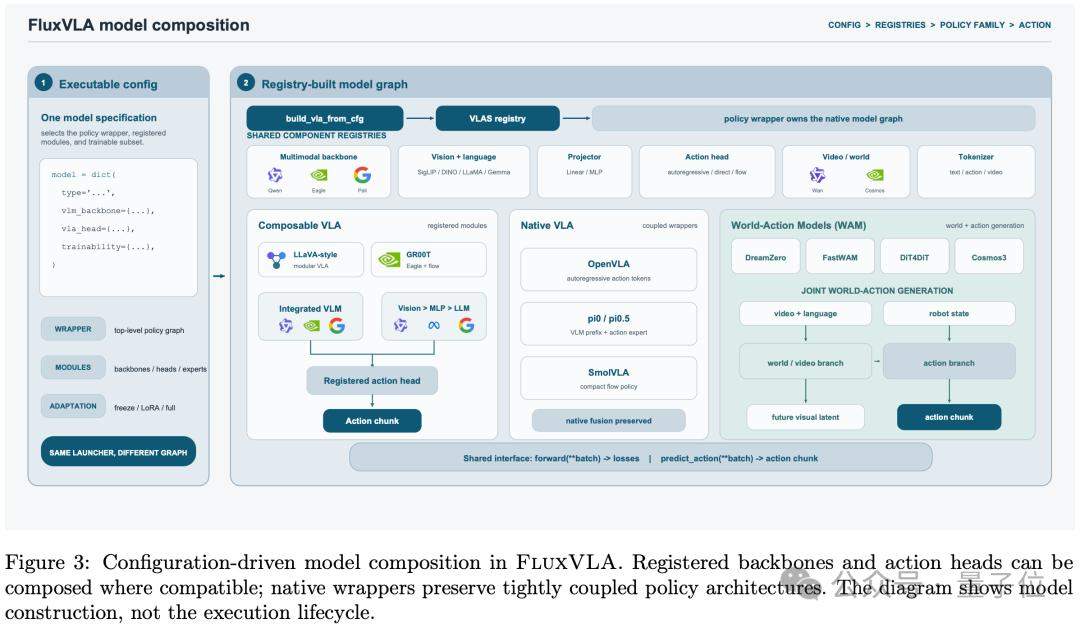
报告中展示的 14 种策略同台竞技,正是这种通用解耦能力的最直观证明。
这 14 种策略几乎覆盖了当下的所有主流范式:包括紧凑型 VLA、流匹配策略、模块化 VLM+动作头、世界动作模型,甚至囊括了无需本地权重、直接通过云端 API 调用的 GPT-6 Astra,以及近期新增支持的 MiniMax-M3.1-Flash。
在报告给出的基准配置下,13 个本地 Checkpoint 策略中有 11 个在 LIBERO 上的平均成功率超过 95%(例如 DiT4DiT 达到 98.65%,π0.5 达到 97.95%)。
这意味着,当行业发布新模型时,其他团队还在通宵调环境、转换数据格式,而使用标准底座的团队已能快速开展下一步研发。
2. 在线强化学习(Online RL)赋能
仅靠监督微调(SFT)通过模仿学习训练出的模型,类似于只会死记题库的学生,一旦遭遇未见过的极端扰动与突发状况就极易失效。
要让模型具备真正的鲁棒性与泛化能力,必须让其深入环境展开闭环试错,即引入在线强化学习。
然而,在线 RL 需要将环境交互采样、策略参数更新与分布式集群训练紧密协同,工程复杂度呈指数级上升,成为许多团队难以逾越的门槛。
对此,FluxVLA Engine 提供了高效的工程解法:通过深度集成 RLinf,FluxVLA Engine 允许兼容的流匹配策略直接“拎包入住”,接入在线交互训练流程,省去了反复适配模型与数据流水线的庞大开销。
在仿真配对实验中,每个基准的各项任务均从同一个 SmolVLA SFT Checkpoint 出发,分别开展任务专用的 PPO 后训练。
经过 40 个外层迭代后,LIBERO-10 的任务平均成功率由 66.2% 跃升至 76.2%;RoboTwin Clean 十项任务从 45.9% 提升至 61.3%,分别实现了 10.0 和 15.4 个百分点的显著涨幅。
这表明平台成功跑通了一条从“模仿学习起点”通向“在线交互提分”的工程捷径——即便是轻量级的小参数模型,也能通过高质量闭环试错挖掘出惊人的行动潜力。
3. 显微镜级细粒度评测
以往的评测机制通常不够透明:研发人员无法观测到模型在执行中的具体瓶颈,系统最终往往只反馈一个冷冰冰的成功率数值。
V2 报告大幅拓宽了仿真评测的广度与深度:
- RoboTwin 新增了 8 种策略支持,同时提供 Clean(纯净)与 Random(随机扰动)两种环境下的评测数据;
- RoboDojo 则针对 8 种策略展开了涵盖 42 个任务、单模型多达 2100 次试验的“全身体检”。
前者通过对比两种场景的表现,清晰展现模型应对环境变化的适应能力;后者不仅记录任务终态成败,还会全程追踪阶段进度条,并从泛化、记忆、精度、长程规划与开放指令五个维度绘制出多维能力雷达图。
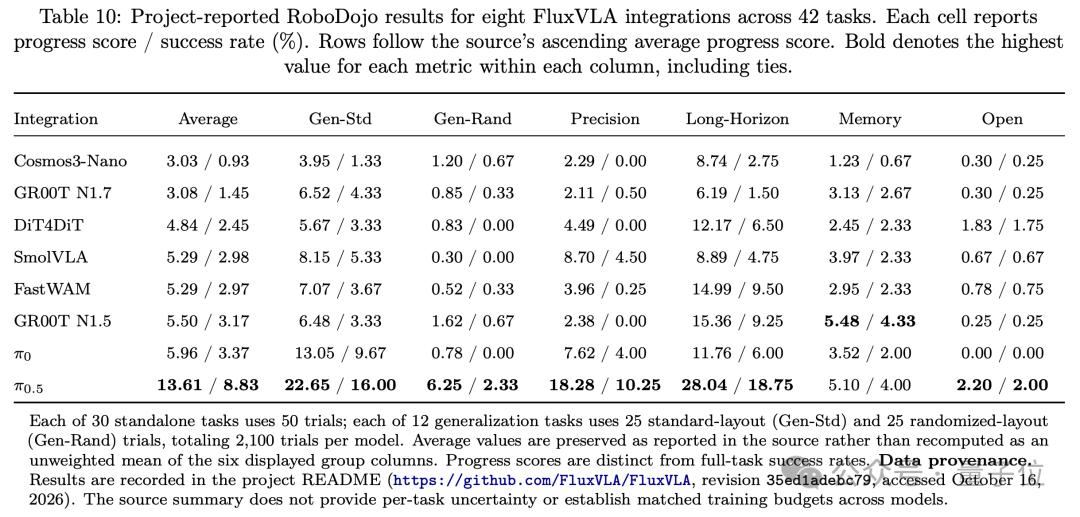
这类细粒度评测极大提升了定位问题的效率。
例如在叠衣服或抓取积木的任务中,如果任务失败,模型可能已经完美完成了前三个阶段,仅仅在最终“放置入盒”的环节发生了动作抖动。
此时,将“阶段进度”与“最终成功率”结合分析,便能快速定位症结所在:究竟是感知层视觉识别有误、规划层长程推理受阻,还是执行层精细控制不足。
没有因果归因的评测无异于“盲盒炼丹”。这套可追溯、可定位的评测机制,帮助研发团队精准下药,有效规避了盲目堆砌数据和空耗算力的无效返工。
跨越从“仿真高分”到“真机干活”的生死线
仿真环境与物理世界的鸿沟一直是具身落地的核心痛点。
具身模型通常采用分块预测机制(一次预测一段时序动作),再交由机器人逐步执行。在此过程中,模型神经网络推理往往存在耗时,而底层机器人的硬件控制循环却必须实时保持高频运行。
若上一段动作尚未执行完毕、下一段预测动作已然生成,两段动作序列之间便容易出现相位错位与断续;即便模型输出的动作在数值空间完全合理,也必须严格满足硬件本体对于关节速度、加速度及轨迹平滑度的物理约束。
为根治真机部署中的“卡顿”与“抖动”,FluxVLA Engine 打造了一套高可靠的系统工程方案:
第一招:深度内核加速,推理吞吐最高跃升 9.64 倍
在完全不改动模型权重的前提下,FluxVLA Engine 针对 GR00T、π0.5 等模型展开了深度的底层推理链路重构,将冗余显存搬运与算子调度开销压制至极限。
测试涉及的 8 组模型与硬件组合中,系统优化后的推理频率普遍提升了 2.31 至 9.64 倍:
- 在 NVIDIA A100 上:π0.5 的推理频率从 2.20Hz 提升至 21.2Hz,提速达 9.64 倍;
- 在边缘计算平台 AGX Orin(64GB)上:GR00T 从 3.20Hz 提升至 7.40Hz,π0.5 则由 1.40Hz 提高至 4.40Hz。
更重要的是,加速过程做到了高度保真:
针对 GR00T 动作头的数值对齐验证表明,加速后的动作输出与原版浮点结果相比,余弦相似度超过 0.99999,最大绝对误差仅约 0.02。
通过纯粹的系统工程优化压榨算力潜能,在不额外采购硬件的前提下无损保留了模型精度。
第二招:动作缓冲区“减震”,保障指令柔顺咬合
除了算力层面的推理效率,执行层面的时序连续性同样至关重要。
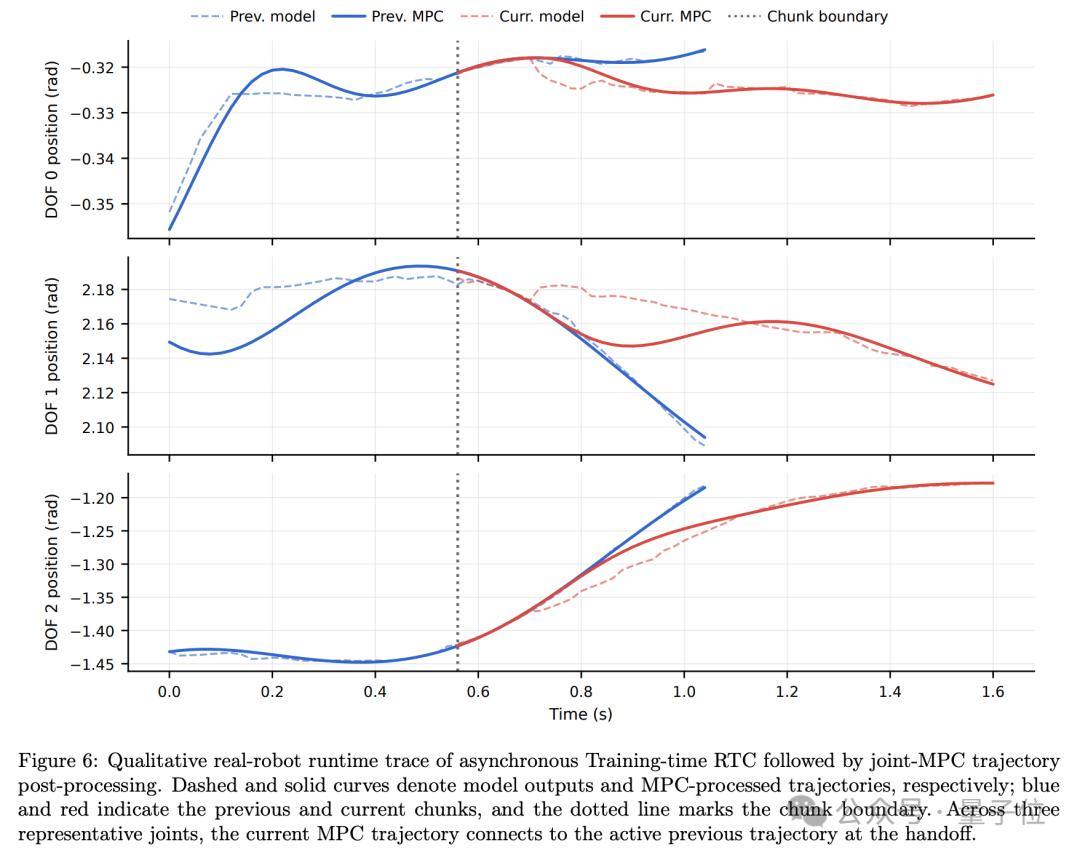
FluxVLA Engine 引入了实时动作分块协调(RTC)机制。其核心逻辑在于:利用上一段尚未执行完毕的动作末端状态,动态约束下一段最新预测轨迹的起始段,如同拉链一般平顺咬合不同推理周期的动作片段,消除突变引起的硬件冲击。
随后,轨迹后处理模块将执行运动学过滤与平滑约束,确保下发至伺服电机的每一个指令均处于物理极限边界内且输出平顺。
推理加速解决了动作的生成时延问题,RTC 与后处理模块则化解了预测与执行的时空失配。两者协同,不仅大幅降低了算法适配硬件的工程门槛、保护了昂贵的机械本体,也让机器人的物理动作具备了拟人化的平滑度与协调性。
第三招:“万用插座”跨本体迁移,打通实战数据闭环
在真机部署环节,FluxVLA Engine 采用了清晰的双层解耦架构:负责上层策略调度的 Runner 与负责底层驱动对接的 Operator。
具体而言,Runner 专注于模型推理管理、动作调度队列以及全流程状态机的运维;Operator 则专注底层传感数据采集、工业总线通信协议解析及底层控制指令的分发下发。两者各司其职、解耦协作,为后续策略在多形态本体间的迁移及实战数据回流奠定了标准化的工程通路。