
Latent Space 播客
Paul Copplestone 与 Ant Wilson 谈为 AI Agent 构建后端
swyx
10 月 28 日 · 77 分钟
我第一次见到 Paul Copplestone 和 Ant Wilson 是在新加坡,当时他们刚作为 YC S20 最炙手可热的初创公司从 Y Combinator 毕业。六年之后,我们终于把他们请到了播客节目中!在将一家开源、全远程办公的公司从零做到 100 亿美元估值后,这是他们首次共同录制播客。
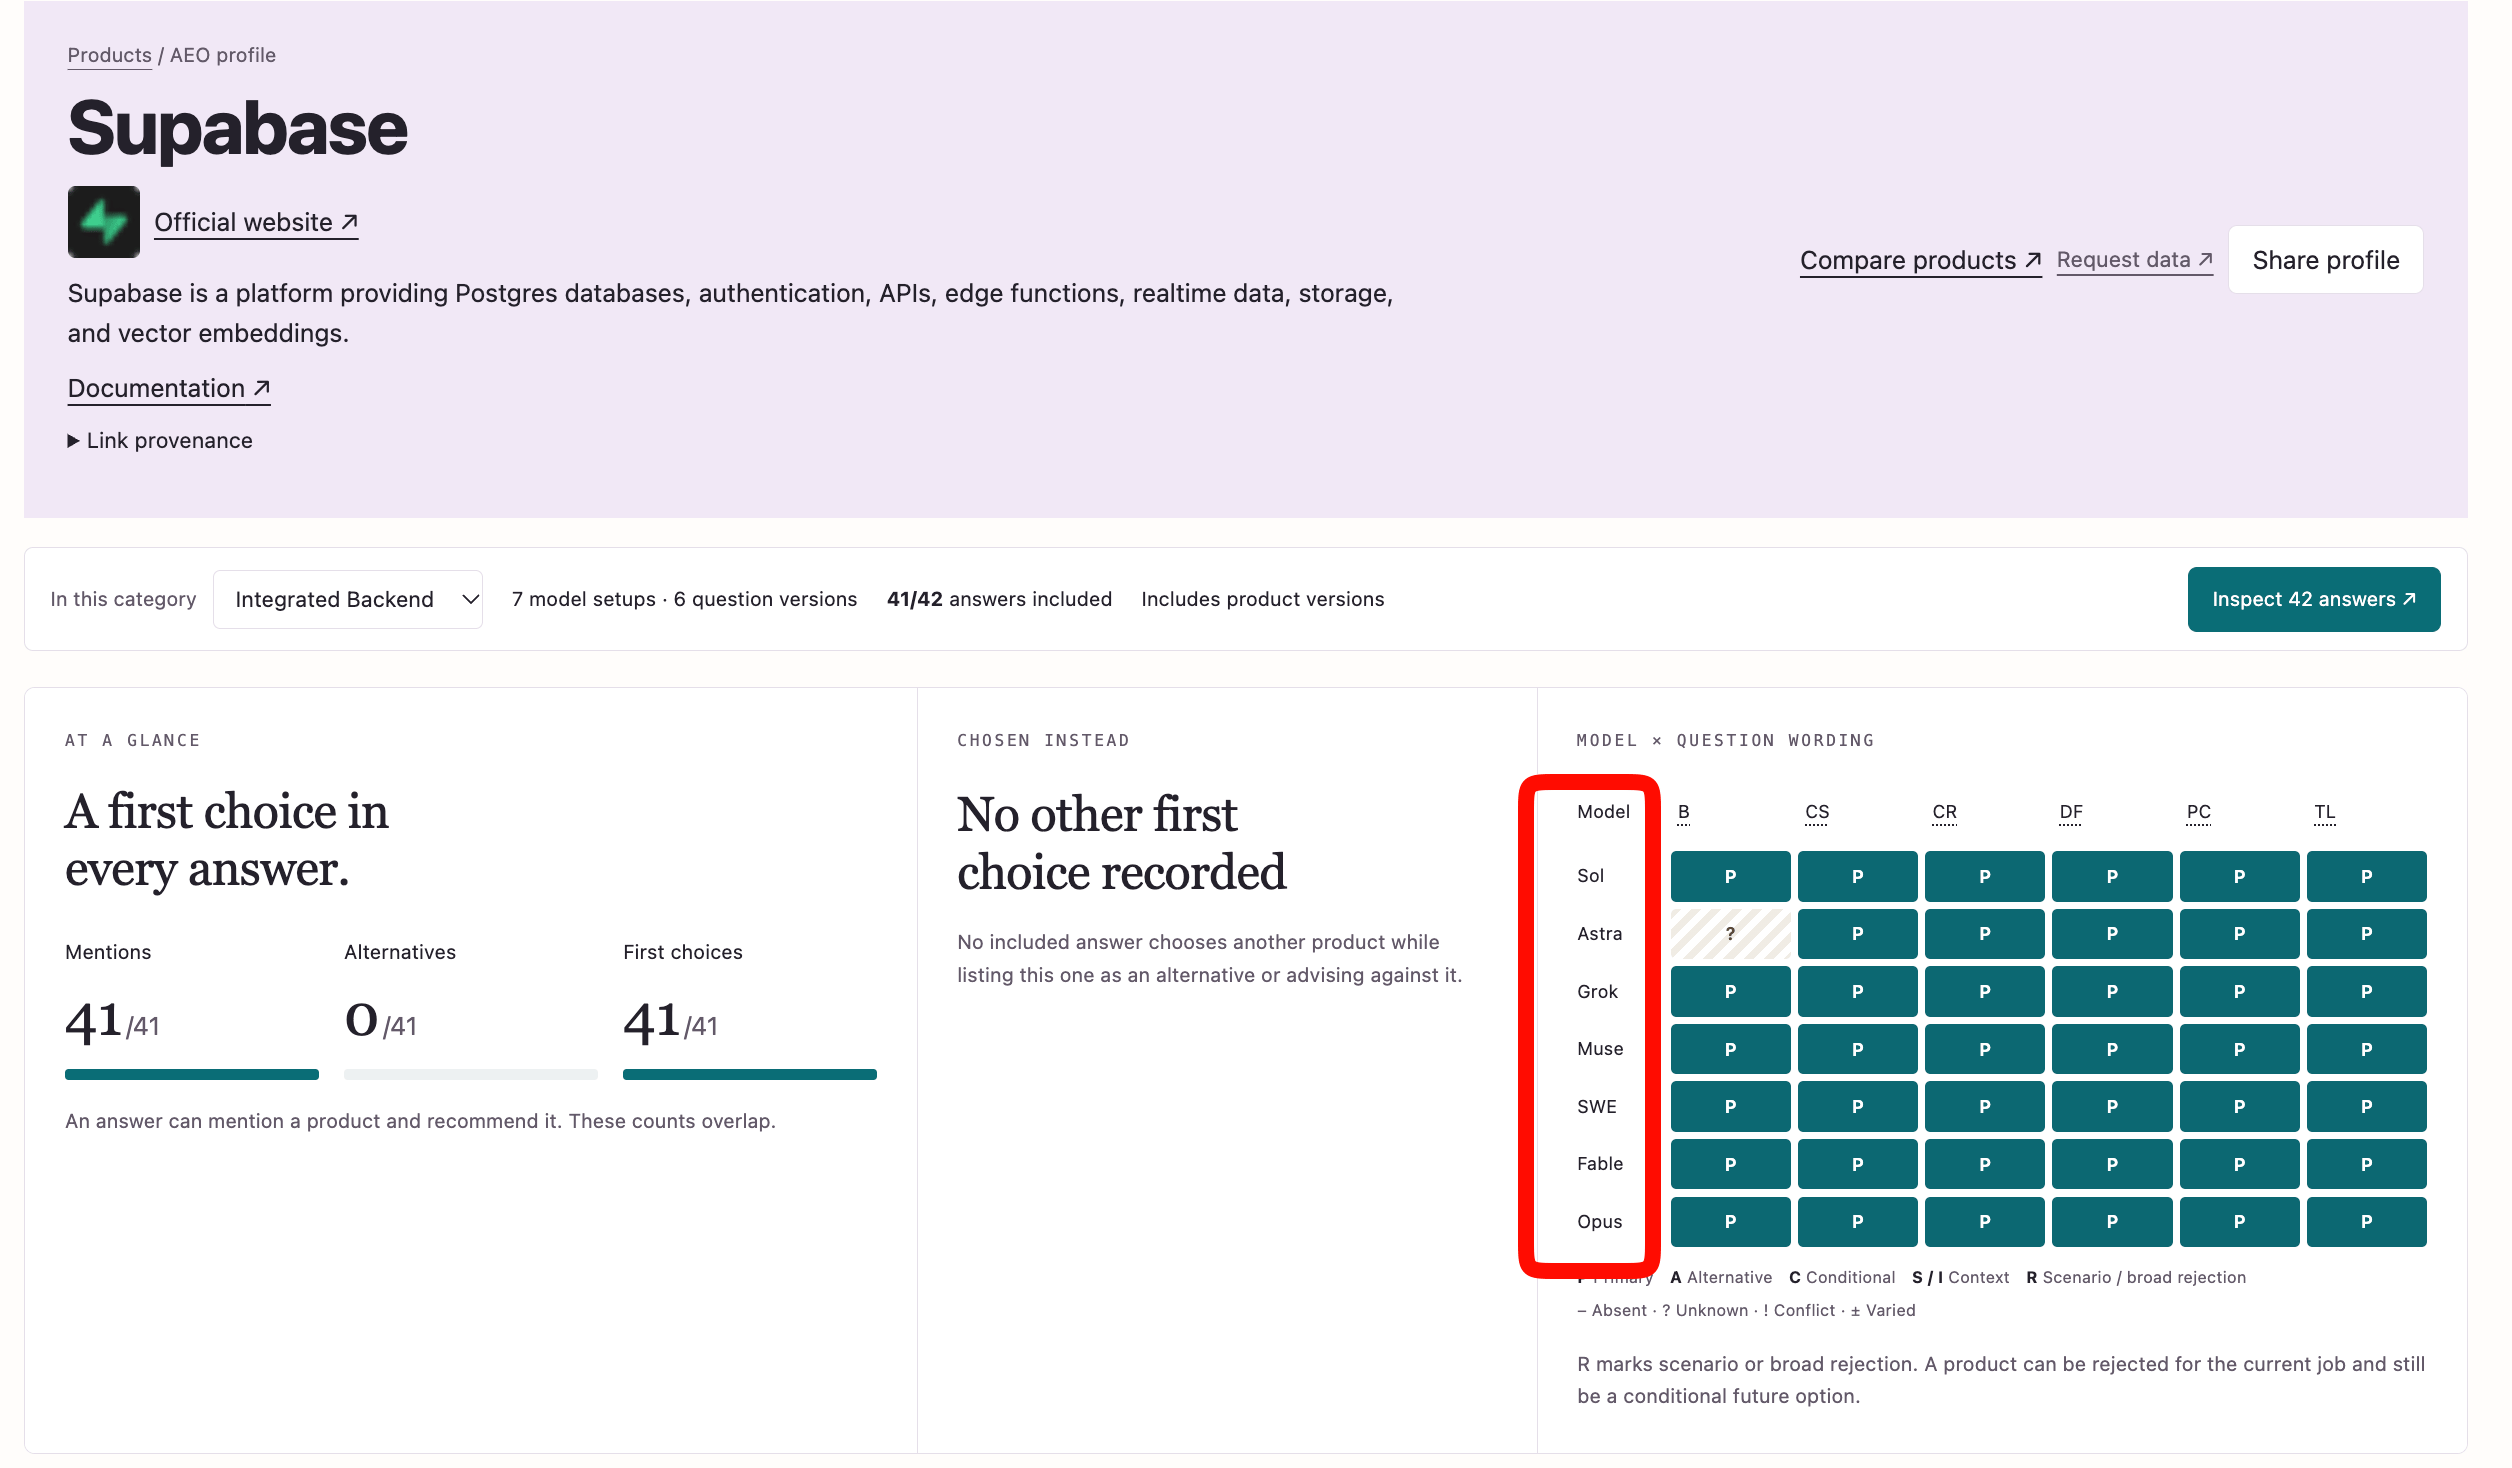
这期播客的标题也是我自己一直想弄明白的一个问题:为什么 Agent 如此钟爱 Supabase? 如今市面上并不缺托管数据库(managed databases),Postgres 托管服务领域的竞争也十分激烈。被模型所熟知固然有助于推广分发,但这并不能完全解释将一段生成的应用代码转化为真正可运行的程序所需的全部工作。然而,当我运行我的前沿 AEO 追踪器时,从 Astra、Fable 到 Muse,几乎所有前沿模型都一边倒地将 Supabase 列为应用后端的首选(同时也是托管数据库的热门竞争者)。
在 Select 大会上,Supabase 将其发布内容归类为构建(Build)、运维(Operate)和扩展(Scale)三大板块。
其中最吸引我的特性出乎意料地实用:无需 Docker 即可启动本地后端、在 Git 中维护期望的数据库 Schema(模式定义),以及在数据库旁直接运行计算任务。每一项都在消除开发者多年来一直不得不做的一些繁琐工作。而 Agent 的出现,让这些摩擦变得更加不容忽视。
给 Agent 一个可读的后端
我最喜欢的开发者工具发布往往能让我觉得:这正是我当下梦寐以求的。用于在本地无需 Docker 即可运行 Supabase 的全新 Alpha 版运行时就是其中之一。我自己使用的是 Colima 而非 Docker Desktop,即使如此,在通往可用数据库的路上少掉一个依赖项也是非常受欢迎的。对于人类开发者来说,本地环境搭建在一周的工作中只占很小一部分;但对于一个需要反复创建和测试环境的 Agent 来说,这种摩擦会成百上千次地重复出现。
声明式 Schema(Declarative schemas)则是更具前瞻性的理念。我们熟悉的 SQL 工作流会不断累积历史:创建 schema,然后一次又一次地执行 migration(数据迁移)。而声明式表示则为 Agent 提供了一个你期望最终状态的描述,这些描述以文件的形式存在,Agent 可以在检查和编辑应用程序代码的同时一并查看和修改它们。
在评论中,我将此比作数据库领域的“Terraform 时刻”。将期望状态保存在 Git 中,Agent 就可以将其作为代码仓库的一部分来读取、修改、分支(fork)并据此开展工作。人类开发者同样能从中受益:无需重构整个变更历史,后端就变得更加清晰易懂。
这正是这个“面向 Agent 友好(agent-friendly)”方向中最让我满意的地方。作为开发者,这些本就是我一直想要的改进;而让它们对 Agent 同样有用,则给了团队又一个将这件事情彻底做好的理由。
计算能力不应只是个提纲要点
我认为目前处于内测阶段(private alpha)的 Supabase Compute 可能被低估了。一个应用不仅需要存放结果的地方,还需要执行任务的地方。即便有了数据库,你仍然需要一个运行环境来执行文档分块(chunking)、生成向量嵌入(embeddings)或其他运行时间较长的任务。
Paul 和 Ant 讨论了在紧邻数据库的位置运行容器。这消除了从应用启动到实际运维之间的脱节:需要配置、连接并向 Agent 解释的独立服务变少了。边缘函数(Edge functions)固然有用,但并不能覆盖所有的工作负载。
运维层面同样至关重要。日志、健康检查、连接信息以及上下文,有助于 Agent 理解自己正在修改什么。即使一个模型能够执行 SQL,它依然需要了解数据库中包含什么、应用如何使用这些数据,以及在发生故障时具体出了什么问题。Supabase 的[运维发布](https://supabase.com/blog/select-2026-operate-with-confidence?utm_source=latent.space&utm_medi