
开源仅一周,GitHub 斩获超 1000 Star,X 平台关注度破百万,并荣登 Today’s News 推荐。
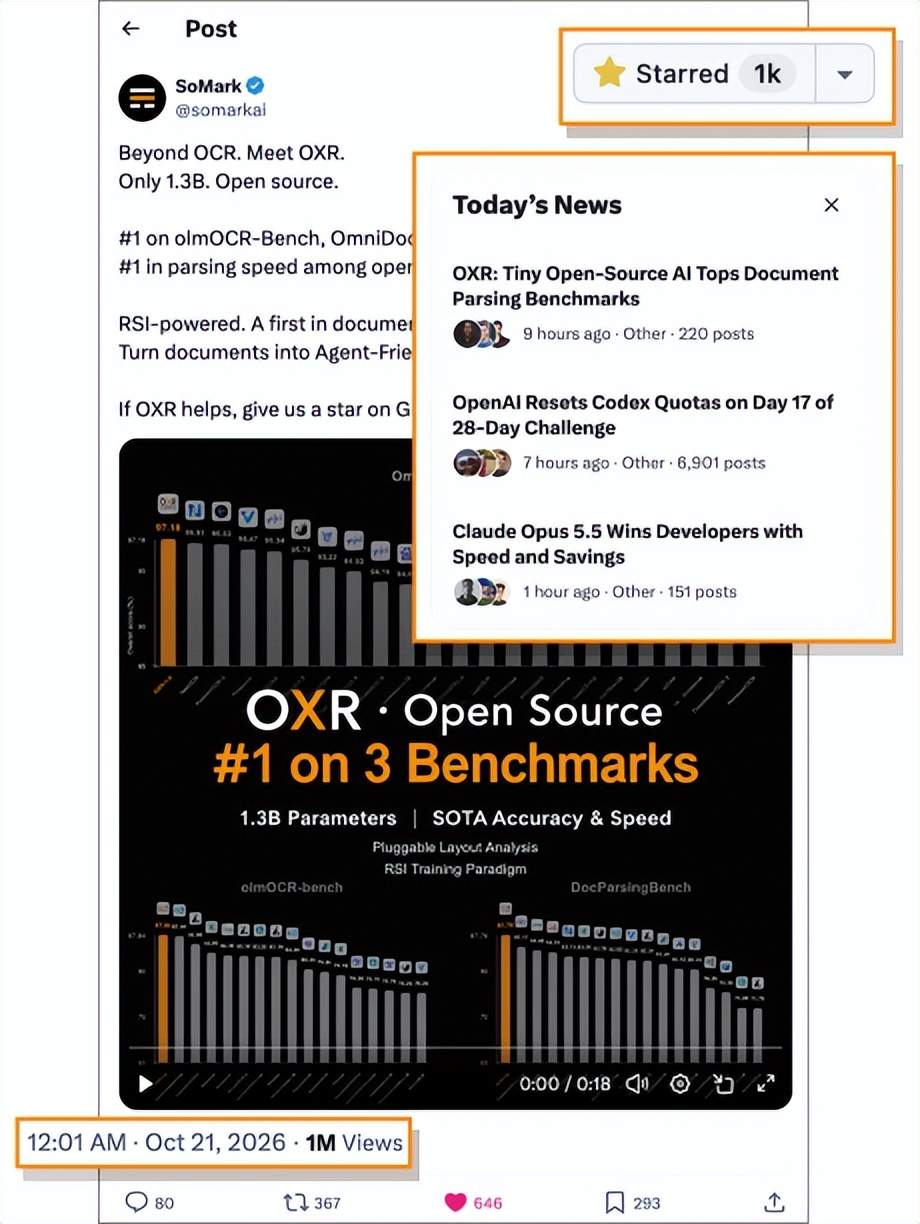
文档解析赛道,迎来了一位极具竞争力的新选手。
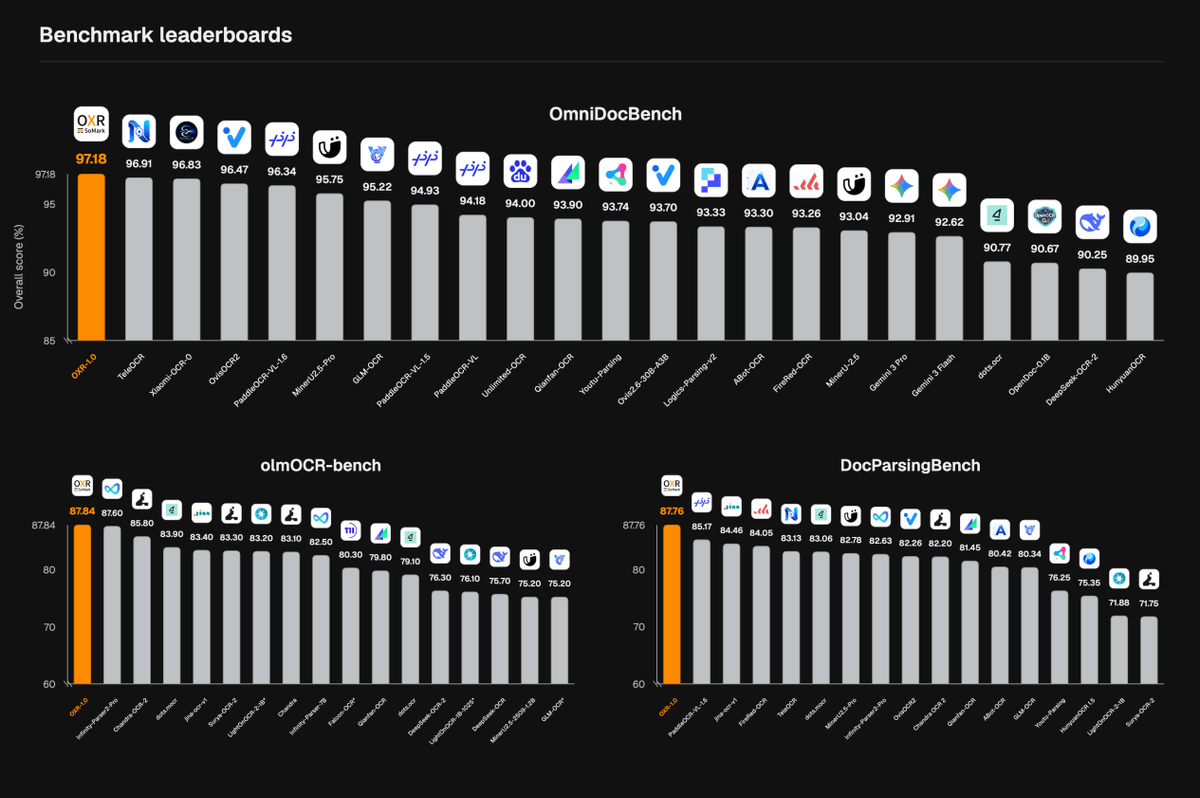
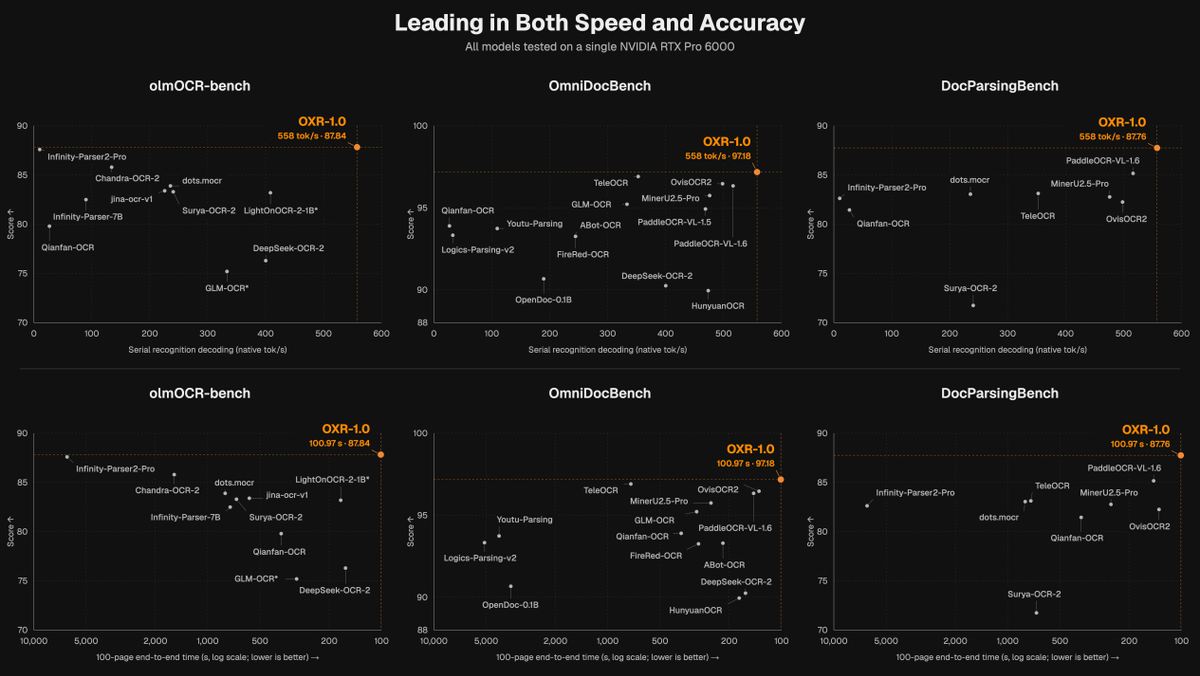
OXR 正式开源:主模型仅 1.3B 参数,在 OmniDocBench、olmOCR-Bench 和 DocParsingBench 三项权威基准测试中悉数登顶;其完整解析速度也超越了同场参测的 PaddleOCR-VL-1.6 和 MinerU2.5-Pro,将轻量级模型的精度与效率双双推至榜首。
该模型背后的 SoMark 团队来自国内一家深耕文档智能领域的初创公司。此前,团队持续围绕核心产品 SoMark 打磨解析能力,如今正式推出了开源模型 OXR。
OXR 全称为 Optical Everything Recognition。从 OCR 跨越到 OXR,它所能处理的远不止文字本身。OXR 不仅能够解析表格、公式、化学式等 13 类复杂文档元素,还能精准还原多栏版面的阅读顺序,输出 Markdown 与 JSON 格式,并保留完整的版面坐标信息,让非结构化的复杂文档真正转化为 Agent 可直接使用的高质量数据。
1 高精度解析,全球三榜夺冠
根据团队公布的评测结果,OXR 在 OmniDocBench、olmOCR-Bench 和 DocParsingBench 测试集上分别取得了 97.18、87.84 和 87.76 的优异成绩,均位列全球第一。
除亮眼的跑分外,更具说服力的是 OXR 处理复杂文档的实际表现。
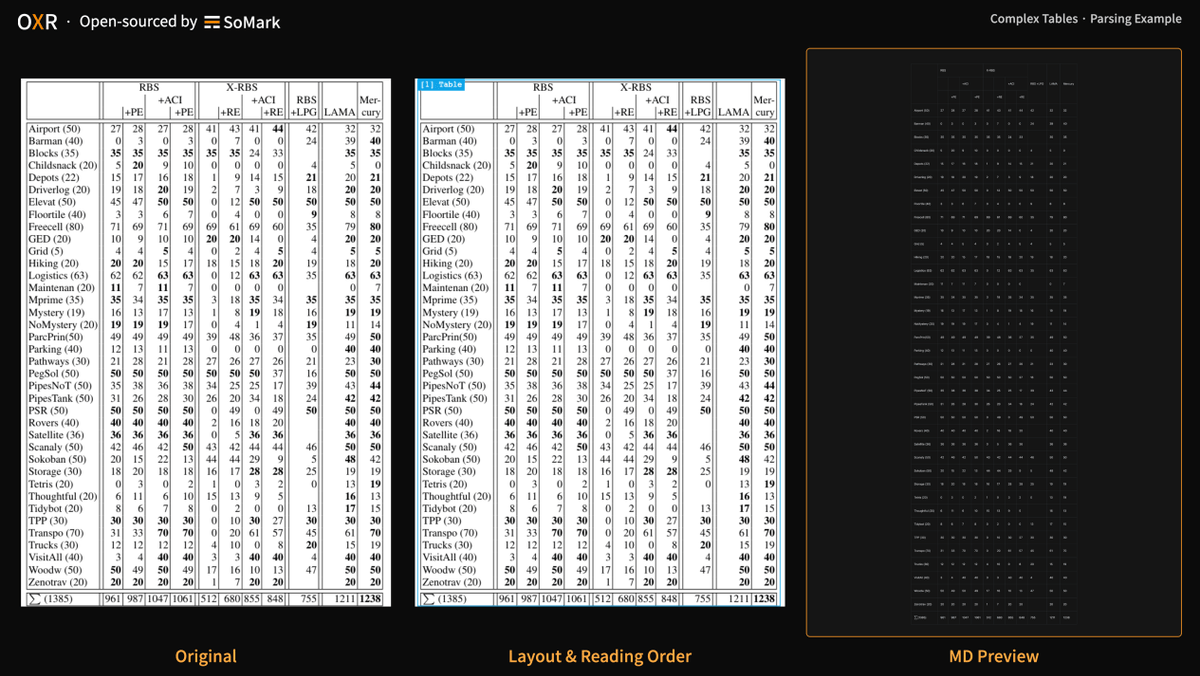
面对跨行跨列的复杂表格,仅仅正确识别文字只是第一步。一旦行列对应关系或合并单元格发生错位,数据就会脱离原有的语义关联。OXR 能够完好保留表格结构,并将其转换为 HTML 格式输出,极大便利了后续的数据展示与处理。
科研类文档的解析难度往往更高:数学公式中充斥着复杂的上下标与多层嵌套结构,化学文献还包含繁复的反应式与分子结构图。OXR 能够将数学公式规范输出为 LaTeX,化学方程式转换为 mhchem 格式,化学结构式则转译为 SMILES 字符串,从而让页面上的静态图形真正转化为可检索、可计算的结构化表达。
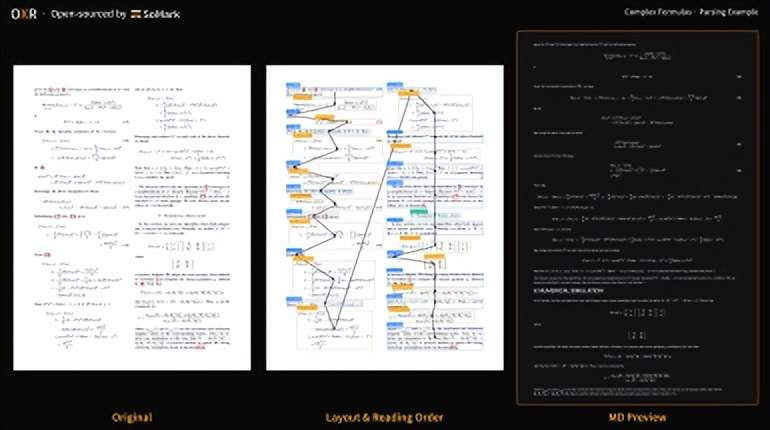
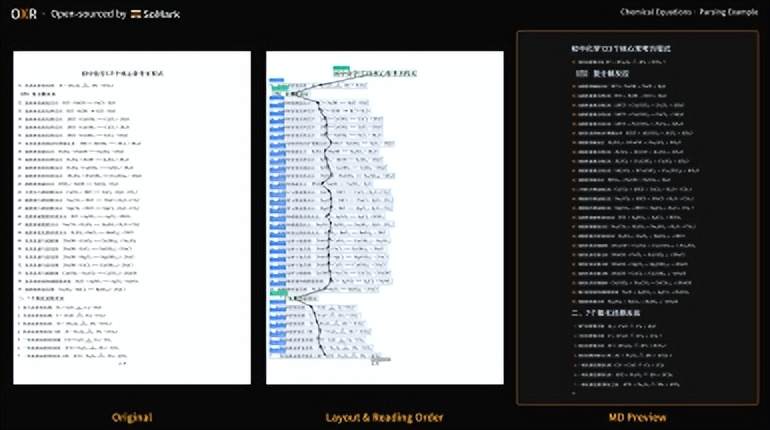
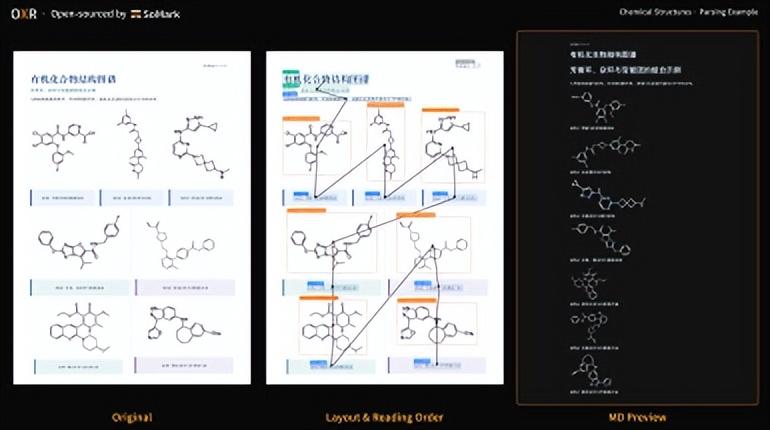
在多栏排版的学术论文、报纸及试卷中,阅读顺序也是一大核心痛点。即使模型能准确识别每个区域的内容,若出现跨栏串读、正文与旁注混杂,原文语义依然会被完全破坏。OXR 在识别内容的同时能够准确判定阅读顺序,并提供精准的版面坐标,完好保留内容在原页面中的位置信息。
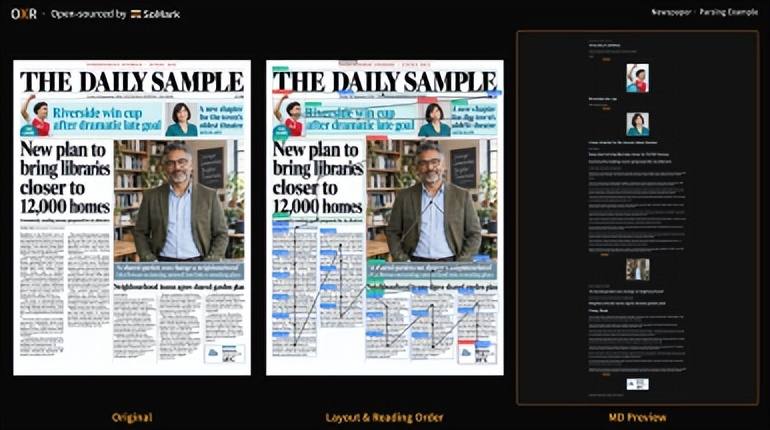
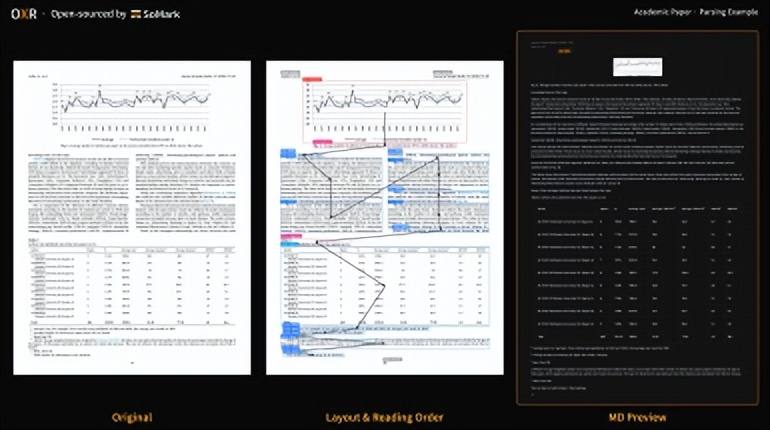
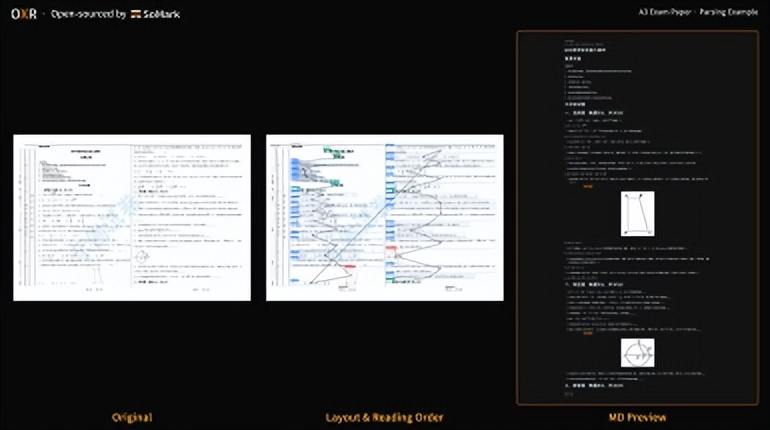
这些能力共同构成了 OXR 所谓的“Everything”:全面覆盖文字、表格、公式、化学结构式、代码块等 13 类文档元素,将 PDF 与各类文档图像高保真解析为 Markdown / JSON,无缝对接下游 Agent 与 RAG 工作流。
2 精度与速度兼具:不只准,而且快
在处理单页文档时,数秒的差异或许不易察觉;但当场景切换到海量论文入库、历史档案整理或金融研报批量解析时,处理效率的高低将直接决定响应延迟与算力开销。
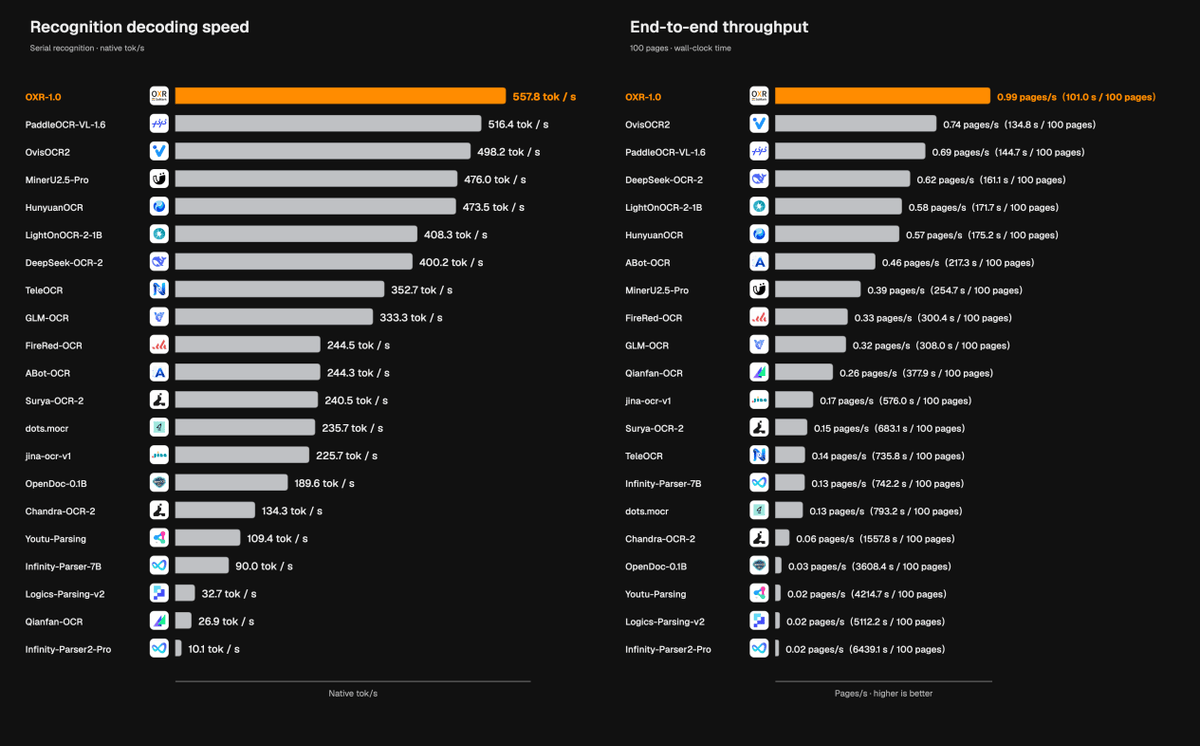
根据团队公布的同等基准完整解析测试,在单张 RTX PRO 6000 Blackwell(96GB)显卡上,针对从 OmniDocBench 随机抽取的 100 页文档进行解析:OXR 平均耗时仅约 101 秒,而 PaddleOCR-VL-1.6 和 MinerU2.5-Pro 分别耗时约 145 秒与 255 秒。
更小的参数量、更高的解析精度、更快的推理速度,首次在同一个模型中得以兼得。
这主要得益于 OXR 在任务分工上的巧妙架构设计:先由轻量级版面分析模型快速定位内容区域,再由主模型集中完成内容识别与阅读顺序推理。
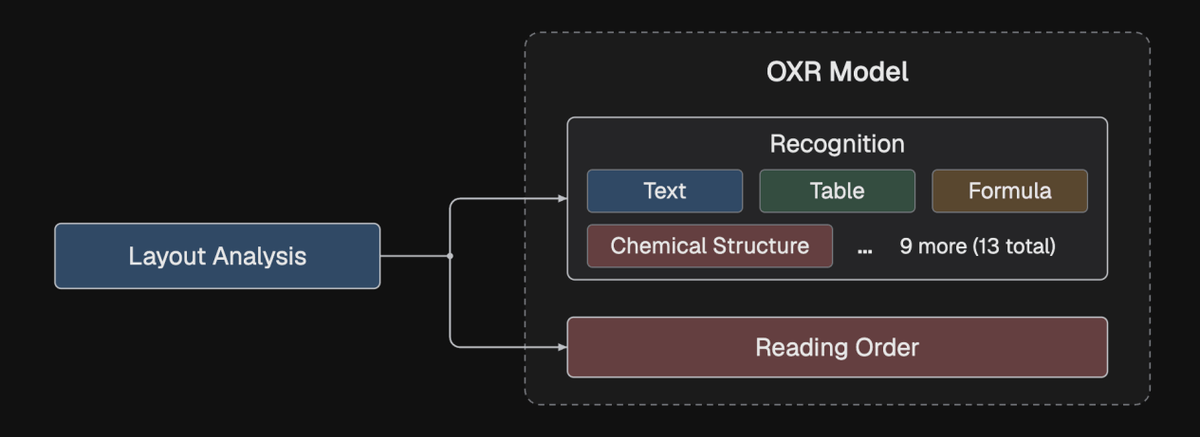
将顺序重构并入内容识别阶段,不仅消除了单独处理排版拓扑顺序的额外计算开销,也使模型能够结合上下文语义准确推断先后次序。这也是 OXR 实现质量与效率双兼顾的关键技术抓手。
3 RSI 训练范式:基于长尾与薄弱样本的递归自我改进
出色的表现背后,OXR 的训练机制同样具备启发性。传统的文档解析往往很难依靠固定规模的数据集覆盖所有异常情况;面对持续变化的排版格式、语言风格与应用场景,如何保障模型在面对未知文档时依旧稳定?
OXR 在后训练阶段**首次引入了面向文档解析的递归自我改进(Recursive Self-Improvement,RSI)**训练范式,将模型在推理阶段产生的错误样本与薄弱样本高效转化为后续迭代的养料。
整套流程可以视作多模型协同驱动的“查漏补缺”闭环:
- OXR 率先对无标注文档进行解析,生成初始预测结果。
- 由外部模型评判识别准确度并逐样本归因,独立聚类模型负责按问题类型自动化归类。
- 判别模型针对薄弱点定向生成高质量增强训练数据,反哺 OXR 进行下一轮调优。
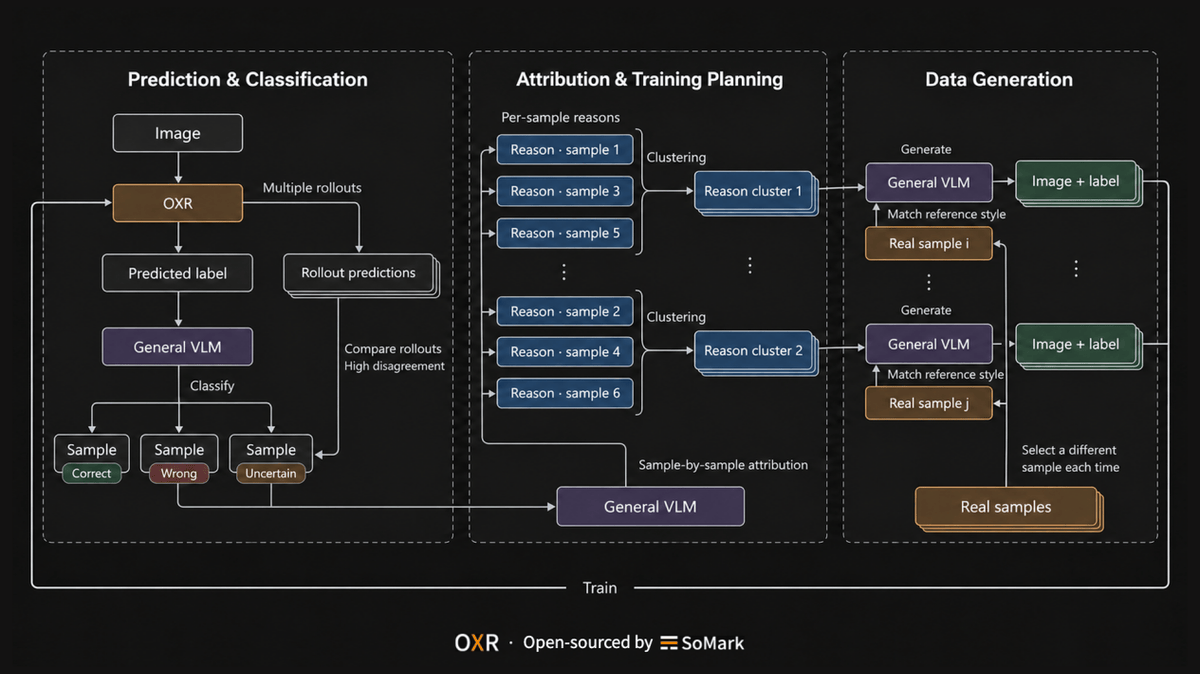
这一机制赋予了训练数据极强的问题导向性:针对薄弱环节定点突破,大幅加快了模型的收敛与迭代周期。同时,闭环中新增的训练样本完全摆脱了对人工标注的依赖,从根本上打破了人工标注所带来的效率与成本瓶颈。
4 模块化可插拔版面分析,灵活适配多元业务
识别准确率需要模型持续优化,但在实际业务落地中,不同场景对“文档结构”本身的定义也存在差异。
例如针对同一组插图,档案留存场景通常需要整块合并归档,而图像检索场景则需要拆分为单图切片;对于包含标题、文本与边框的图文混排区域,部分系统倾向于作为富文本拆解,而有的业务系统则要求按统一表格结构进行提取。这些需求在各自业务中均有其合理性。
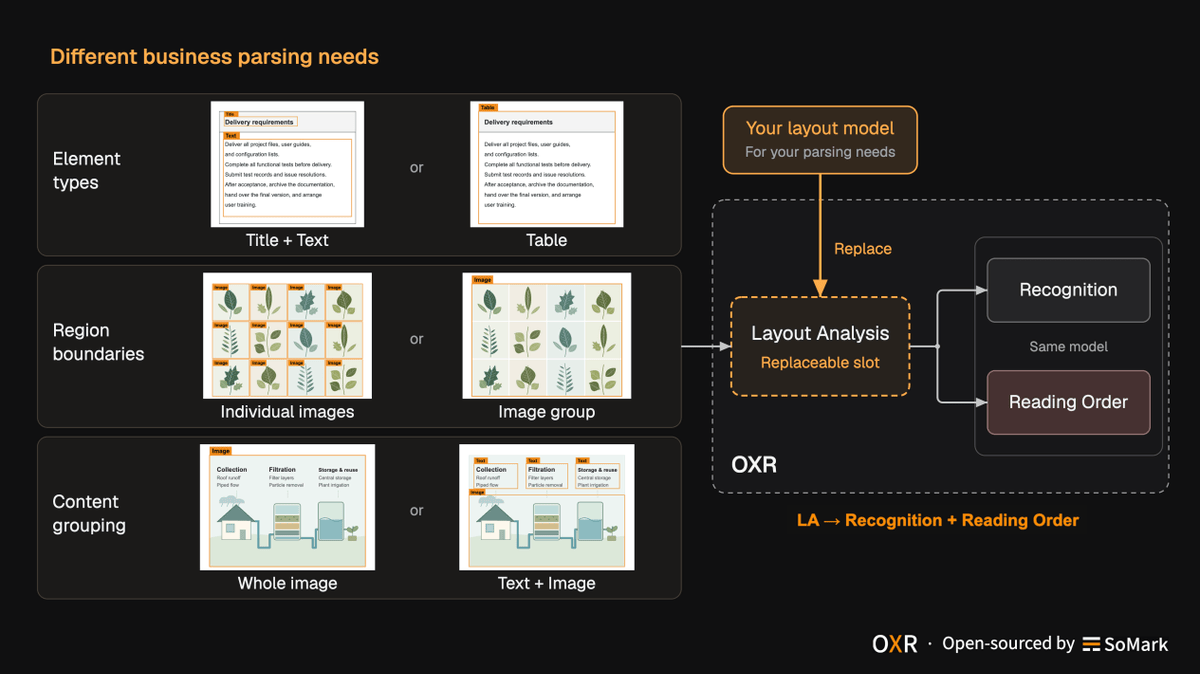
为此,OXR 将版面分析设计为独立的解耦可插拔模块。
开发者既可以直接使用内置的高性能版面分析模型,也可以无缝接入符合自身业务规范的外部版面分析算法,自主定义元素类别、区块边界与内容编组,随后无缝复用 OXR 的内容识别与阅读顺序推理能力。
对于正在构建 RAG 知识库、自动化 Agent 与文档工作流的开发者而言,OXR 带来了一个兼备极高解析精度、高速推理吞吐与极强版面适配能力的开源首选。
目前,OXR 已全面开源代码与权重,并配套上线了在线 Demo 及免费 API,便于开发者使用实际文档进行验证:
- GitHub 代码仓库:https://github.com/SoMarkAI/OXR
- Hugging Face 模型权重:https://huggingface.co/SoMarkAI/OXR-1.0
- 在线 Demo:https://free-oxr.somark.cn/
- 免费 API:https://free-oxr.somark.cn/api/v1
针对更复杂的企业生产级文档解析诉求,该团队亦同步提供了由独立专有模型驱动的商业级文档解析引擎 SoMark:
- SoMark 官网:https://somark.cn/
从 SoMark 到开源的 OXR,团队通过开放长期技术积累向开发者释放核心红利,正如其愿景所展现的:让文档中蕴藏的知识转化为 AI 可直接利用的高质量数据,赋能千行百业的真实业务场景。