
OCR 3.0时代,来了
百度的 OCR 技术再次迎来重大升级:文心 Unlimited OCR 2 正式发布并开源!
这一次,它直接挑战一口气读完整套大部头小说。
从《魔法石》到《死亡圣器》,全套 7 部《哈利·波特》连续识别与转写,3600 多页内容一路顺畅读到最后。
换成 1200 多页、数十万字的《三体》全集,同样能够一气呵成,全程毫无停顿与断层。
然而,要连续读取如此庞大的页数,模型首先必须跨过一道严苛的门槛:显存。
文档越长,推理时需要保留的中间信息(KV 缓存)就越多——这好比模型边读边记的“小抄”,页数越多,小抄越厚。小抄不仅占用巨大的显存空间,翻阅检索起来也极其耗时。
在官方技术报告的百页级单序列测试中,文心 Unlimited OCR 2 给出了一组令人瞩目的数据:
相较于将所有页面视觉缓存同时保留在显存中的标准解码方式,其峰值 KV 缓存占用从 47GB 骤降至 1.77GB,降幅高达约 96%。
47GB 是什么概念?它甚至超过了不少主流笔记本电脑的整机内存容量。更重要的是,这还仅仅是 KV 缓存的开销,尚未计入模型权重等其他显存占用。
事实上,上一代 Unlimited OCR 凭借出色的多页文档连续解析能力,就已在开源社区积累了极高的人气:累计下载量突破 1000 万次,GitHub 标星超 2.86 万颗。从社区自制在线 Demo 到支持 SGLang 高性能推理,围绕它的生态适配一直在持续演进。
而到了第二代,研发重点则转向:在连续处理更长文档的同时,大幅减轻计算与显存的承载负担。
为此,文心 Unlimited OCR 2 提出了稀疏参考滑动窗口注意力机制(SR-SWA),使模型能够按需精准选取相关页面与局部视觉信息,避免冗余重复计算。
配合持续解码机制,该模型能够流畅处理超长文档,且单步解码开销不会随文档长度的增加而水涨船高。
目前,文心 Unlimited OCR 2 已在 Hugging Face 与 GitHub 正式开源。
开源地址:
- GitHub:https://github.com/baidu/Unlimited-OCR
- Hugging Face:https://huggingface.co/baidu/Unlimited-OCR-2
拆解核心技术:SR-SWA 怎么少算,分块解码怎么少存
能够一口气读完数百万字、3600 多页的《哈利·波特》全集,文心 Unlimited OCR 2 究竟是如何做到的?
它借鉴的核心逻辑,其实来源于人类抄书的思维模式。
人类手抄书籍时的流程通常是:看一段、抄一段,视线主要聚焦在当前正在书写的那一页;只有遇到上下文需要前后对照时,才会回翻相关联的特定书页。
在抄书这件事上,人类的直觉非常明确:绝不会有人一边抄录《论语》,一边在脑海中把《论语》的全书页面同时铺开对照。
然而,上一代 Unlimited OCR 并非如此运作:尽管它通过 R-SWA 显著削减了推理阶段的 KV 缓存,但在回看过程中,所有输入页面的视觉特征仍需参与注意力计算。
这就导致文档越长,参与计算的冗余信息越多,其中相当一部分与当前正在识别的文字毫无关联,沦为了典型的算力“陪跑”。
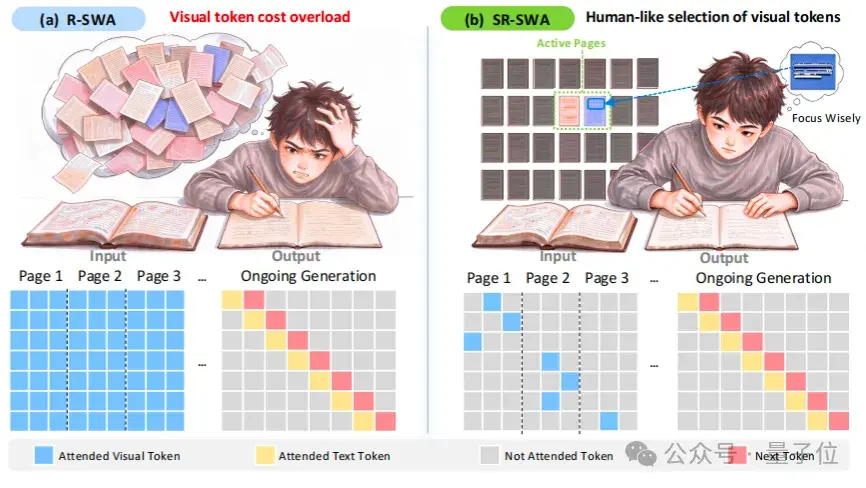 △ SR-SWA 借鉴人类抄书时的局部聚焦方式
顺应这一思路,文心 Unlimited OCR 2 引入了稀疏参考滑动窗口注意力机制(SR-SWA)。
它的核心机制在于“两层过滤”:先筛选出需要参考的书页,再从筛选出的书页中提取真正相关的局部信息,将所有无关计算阻挡在外。
从整体架构来看,文心 Unlimited OCR 2 沿用了上一代的基础设计框架。
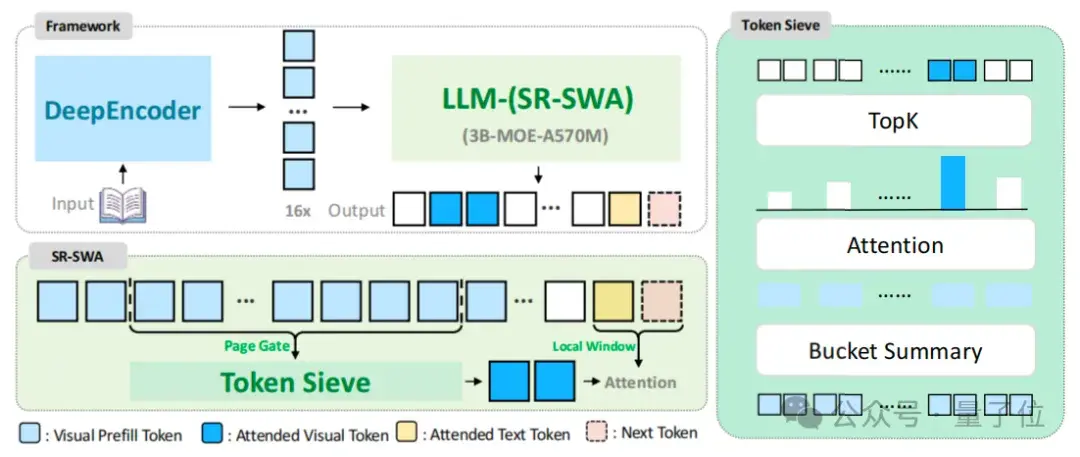 △ 文心 Unlimited OCR 2 整体架构
输入书页图像首先进入 DeepEncoder,被编码转换为模型可处理的视觉 Token——相当于生成了一组记录图文内容与版面特征的数据卡片。随后,语言模型依托这些卡片,逐项生成文本识别结果。
关键的创新突破正发生在语言模型内部:原有的**参考滑动窗口注意力机制(R-SWA)**全面演进为 SR-SWA。
架构图左下方展示了 SR-SWA 的两层筛选逻辑:
-
第一层:Page Gate,负责管控“该看哪几页”
它根据模型当前解析的具体进度,将候选视觉特征限定在强相关页面范围内,剔除无关页面的干扰。映射到抄书场景,就如同翻到某一页时,仅调出与其关联的几页,而非盲目通篇检索整本书。 -
第二层:Token Sieve,负责甄别“页内该看哪几行”
仅圈定页面还不够。即使在相关页面内,也没必要让全部视觉 Token 均参与计算。Token Sieve 会执行二次精筛,挑出与当前内容最吻合的视觉信息块,精准捕获长距离视觉依赖关系。
架构图右侧展示了该过程的具体细节:模型先根据各信息块的紧凑表征计算关联权重,再通过 Top-K 策略挑选出固定数量的高分信息块。入选之后,模型会深入解析其中的精细视觉细节,而非仅停留在粗略摘要层面。
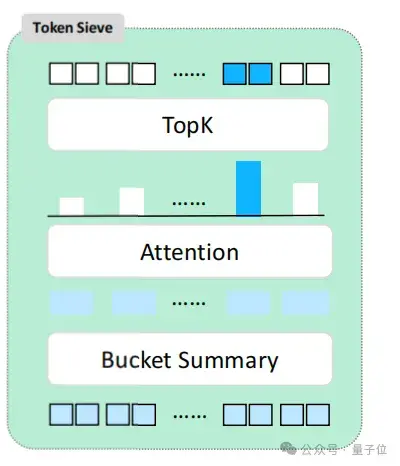 △ Token Sieve 细节
这两层筛选机制相互协同,既能迅速在海量长文档中锁定关键页面,又大幅精简了每一步需要处理的视觉信息量,显著拉升了长文档解析效率。
精选出的视觉信息,还会与架构图中的 Local Window(局部滑动窗口) 协同参与生成。该窗口大小固定,始终维护最新的上下文信息,并随生成过程持续平移,保证输出文本平滑衔接。
由于信息块数量与局部窗口大小均受严格约束,模型单步推理所需参考的信息负载被牢牢限定在一个平稳区间内。这就从根本上避免了“文档越厚、逐字生成越费劲”的算力瓶颈。
如果说 SR-SWA 负责的是在每一步中“少算”,那么显存里到底应该“存多少”,则是另一个核心痛点。
每页文档经编码后均会转化为一组视觉 Token。模型在生成解析结果时必须参考这些特征,因此会将它们存入 KV 缓存中供后续复用。
若一次性载入整份文档,并将全量页面的视觉缓存常驻显存,显存占用必然随页数线性暴增。更为棘手的是,哪怕某些早期页面后续不再参与计算,只要显存未被主动释放,便会持续占位——正如抄书时将写过的废稿全堆在案头,桌面再大也终将不堪重负。
因此,计算层面的“少算”必须辅以存储层面的“少存”。
文心 Unlimited OCR 2 为此设计了无限解码机制(Unlimited-Horizon Decoding Paradigm),通过分块流式处理实现缓存占用的精准可控。
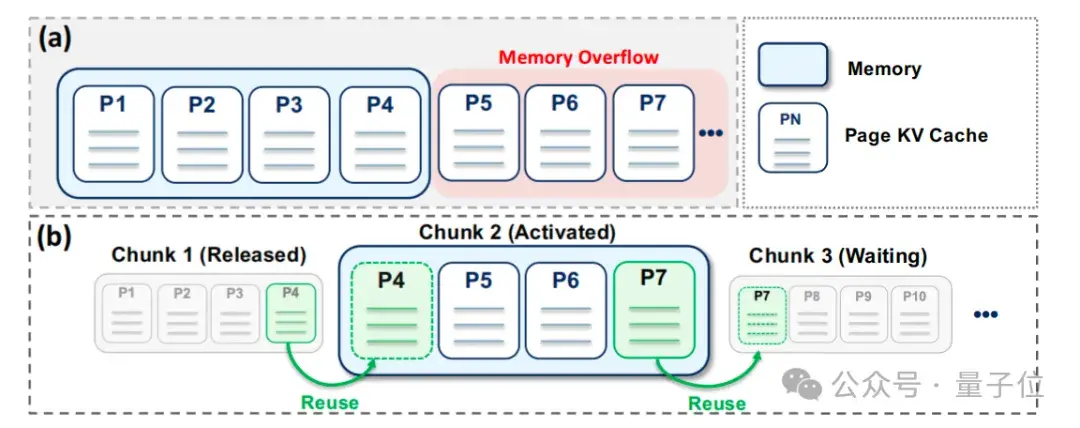 △ 分块解码示意图
该机制将长文档划分为尺寸可控的页面分块并依次解析。相邻两个分块之间保留 1 页重叠区——前一块的最后一页恰好作为后一块的起始页,起到天然的“书签”纽带作用。
切换至下一个分块时,模型直接复用该重叠页的视觉 KV 缓存,并保留前一段输出末尾的文本缓存,以确保上下文逻辑无缝过渡。而历史分块中无需再用的其余视觉缓存则被即刻释放,高效腾退显存。
如此一来,显存中驻留的视觉缓存规模始终被钳制在当前单个分块内。处理完当前分块,仅沉淀必要的衔接信息便流转至下一块,彻底摆脱了全书缓存贯穿始终的沉重负担。
SR-SWA 负责大幅削减单步算力消耗,无限解码机制负责把控显存峰值边界,两者珠联璧合,才让模型得以驾驭海量长文档的持续解析任务。
884页《指环王》42分钟读完,缓存降到1.77GB
聊了这么多底层架构,实测表现究竟如何?直接向文心 Unlimited OCR 2 投喂一份厚达 884 页的英文原版《指环王》。
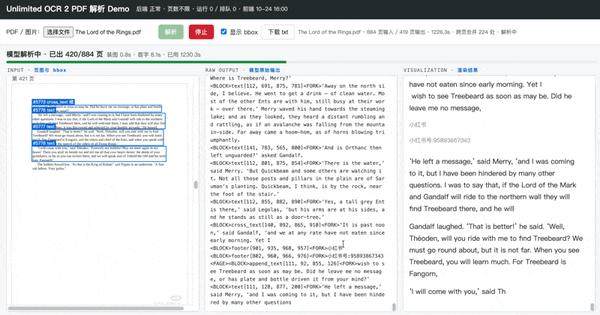
耗时约 42 分 56 秒,整部巨著解析完毕。884 页输入精确产出 884 页输出,单页平均耗时仅约 2.9 秒——差不多喝一杯咖啡或看完一集电视剧的时间,“中土世界”的壮阔篇章就已全数转化为数字化文本。
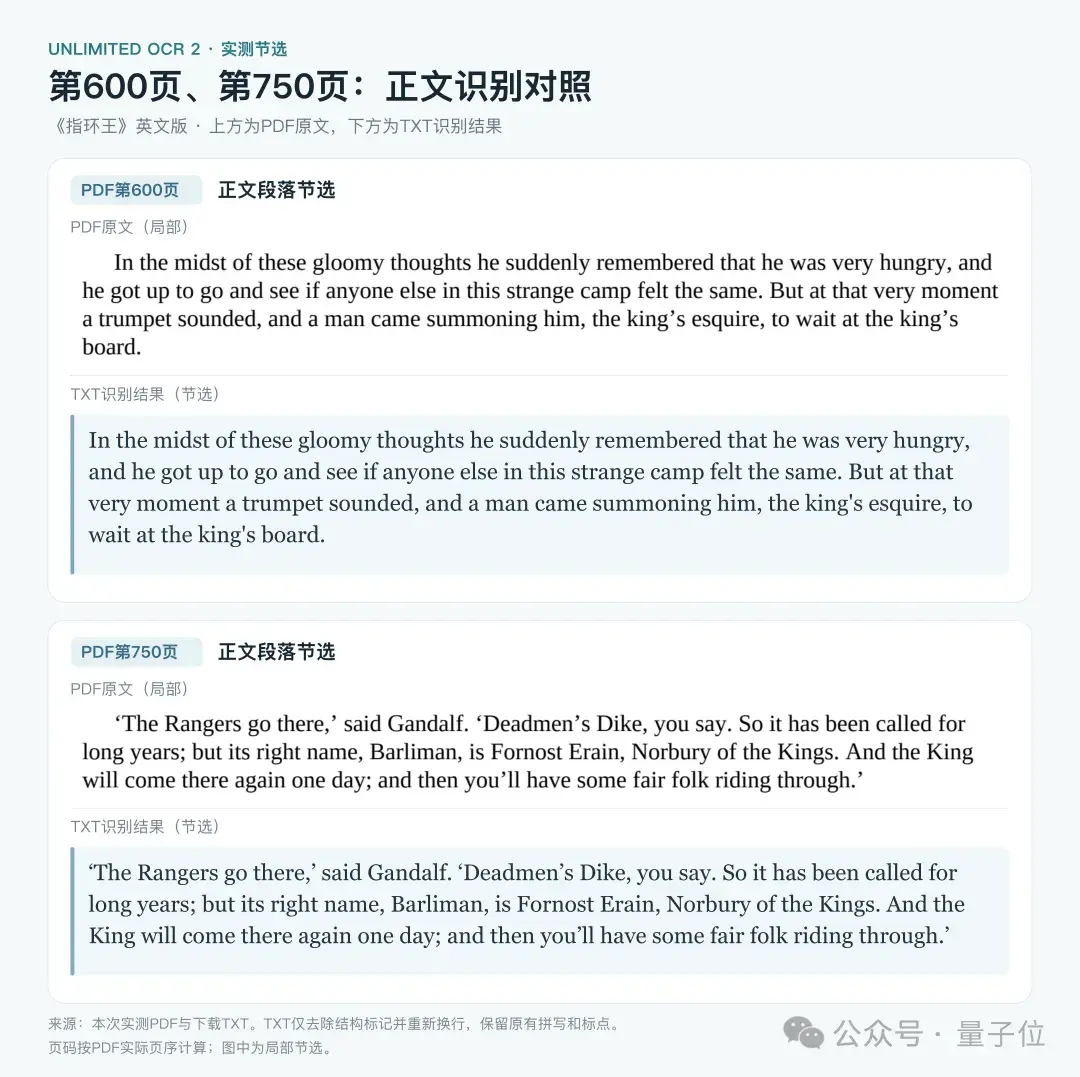
对于如此大体量的文本,推演至中后程时识别精度是否会出现衰退?
技术团队抽样核验了第 600 页与第 750 页的正文内容:输出结果与原始图文毫无偏差。即便行进至第 750 页依然能做到一字不差,证明模型在超长推理链条下依然稳定受控,没有出现幻觉或漂移。
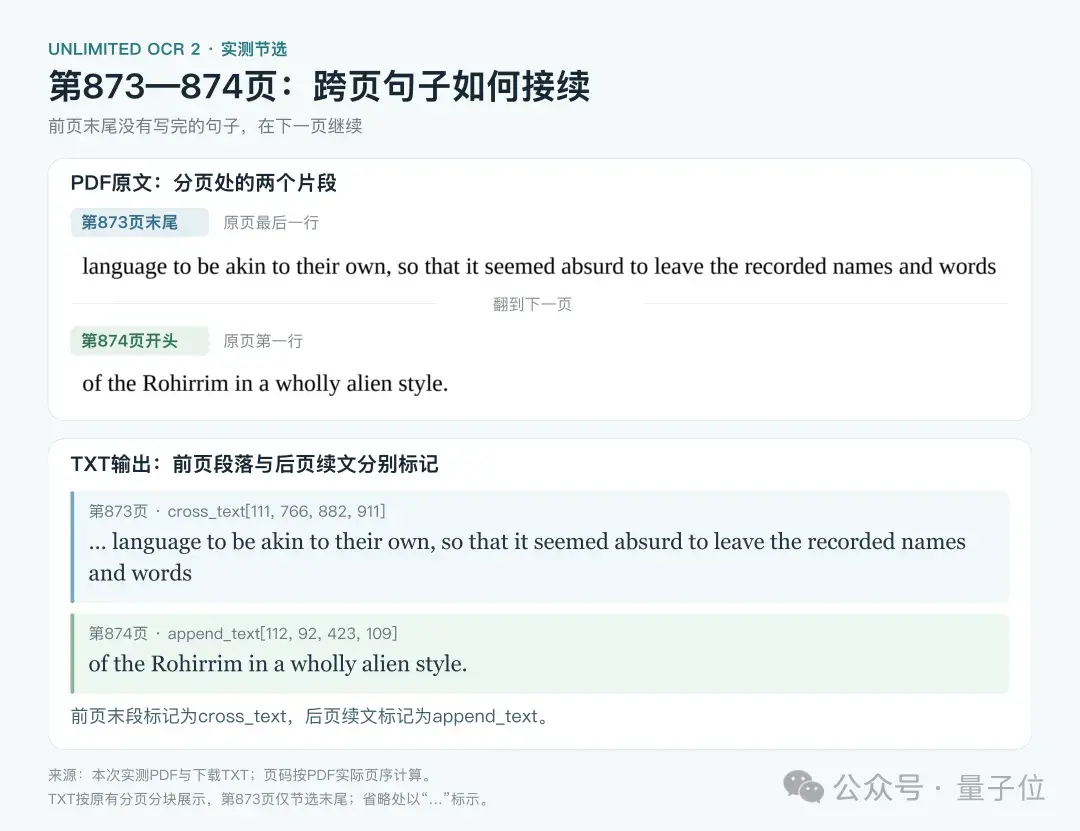
在整个测试任务中,系统还精准识别并标定了 466 处跨页合并。例如全书结尾处的第 873 页与第 874 页之间,原本因物理排版被强行分段截断的长句,在最终生成的输出文本中被严丝合缝地拼接还原。
实测印证了全书连续解析的工程落地能力,而技术报告则进一步量化了解析效率、缓存控制与识别精度的关键指标。
在百页级评测基准 MarathonDocBench 上,团队对比了标准全量解码与 Unlimited-Horizon Decoding 的实际表现。单序列推理测试中,在引入分块处理与边界缓存复用后,峰值 KV 缓存占用从 47GB 锐降至 1.77GB,降幅高达约 96%(注:1.77GB 仅统计 KV 缓存,模型权重等固有显存另计)。
除单流优化外,多任务并发表现同样亮眼。在 16 路并发测试中,采用新架构后系统的端到端吞吐量从 360 Token/s 跃升至 1315 Token/s,达到标准解码模式的 3.65 倍。
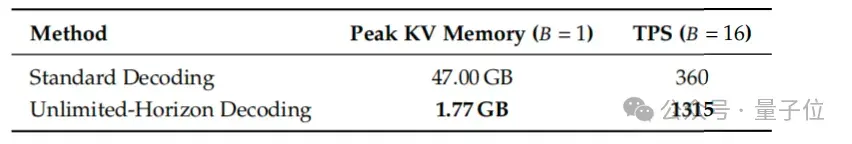 △ 解码方式对比:单序列峰值 KV 缓存与 16 路并发吞吐量
这对于需要批量处理金融财报、工程技术手册的工业级应用而言意义非凡:显存门槛的降低意味着同等算力硬件可承载更多的并发吞吐,单位时间产出呈倍数增长。
对最终用户而言,交互体验也得以极大简化:直接上传数百页的完整文档即可,分块编排与断点缝合均由模型底层自主调度完成,告别了繁琐的手工切片与后期拼装。
在追求极致性能与存储优化的同时,识别质量同样过硬。
在衡量多页复杂文档解析能力的 MPDocBench 评测中,文心 Unlimited OCR 2 斩获了 84.59 的综合评分。
针对百页级超长图文,研发团队还设立了全新的压力基准 MarathonDocBench。该测试集汇集了 100 份篇幅介于 103 至 300 页的长文档,其中包含大量横跨多页的复杂段落与跨页表格,极其考验模型对长跨度语境的衔接一致性。
在这项极具挑战性的基准测试中,文心 Unlimited OCR 2 取得了 77.06 的综合得分。在两项权威基准中,其表现均位列报告参测模型的首位。
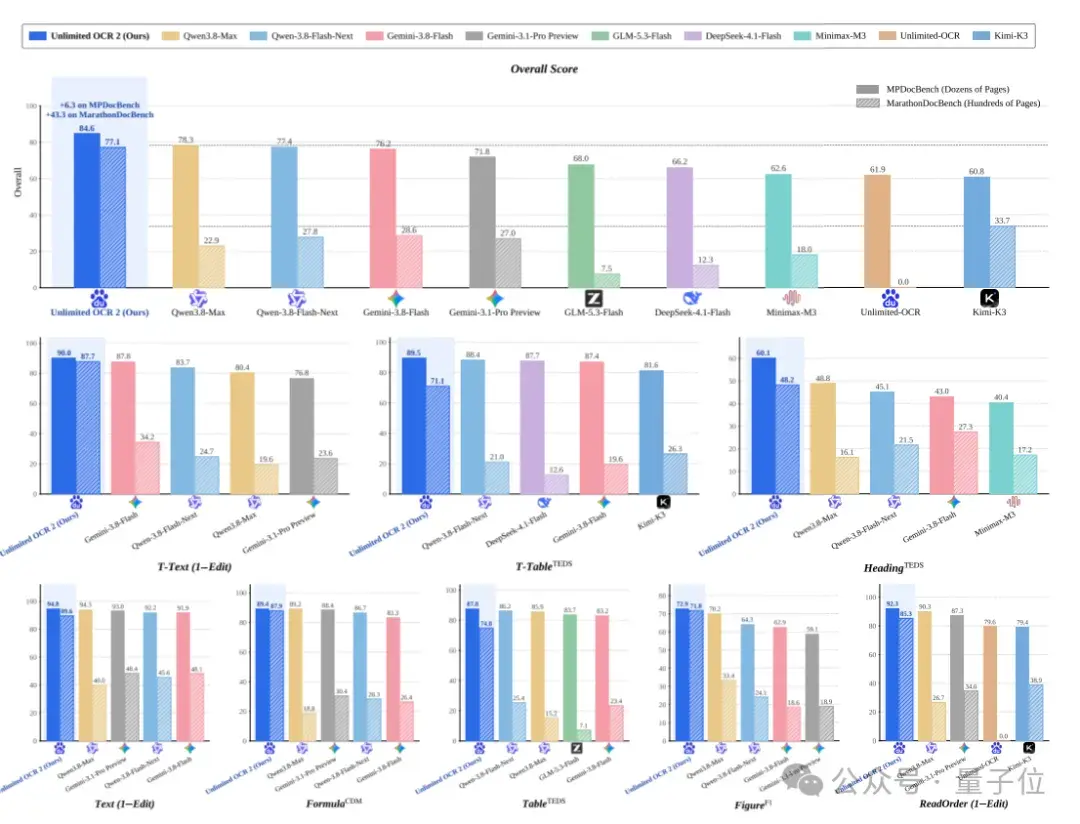 △ 技术报告所示:多页文档解析评测结果
在解码速率维度,SR-SWA 的单步解码速度分别达到全注意力机制(Full Attention)的 7.0 倍,以及前代 R-SWA 的 5.6 倍。
从性能曲线可以清晰看出:传统方案的单步解码延迟会随文档长度加剧而显著走高,而 SR-SWA 的耗时曲线几乎保持为一条平稳的水平线。
这意味着,无论书本多厚,模型每输出一个 Token 所耗费的时间几乎恒定不变——真正实现了“厚积而不迟缓”。
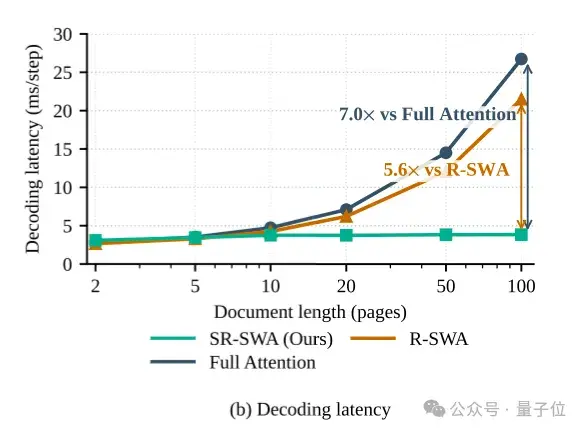 △ 不同文档长度下的单步解码延迟
相比上一代产品,文心 Unlimited OCR 2 在常规单页解析表现上保持稳定高位,而真正的降维打击,则显现于文档规模拉长之后:可连续处理页数呈量级跃升,跨页逻辑辨析更加精准,同时长文档推理解码的综合成本被成倍压缩。
无论是数百页的企业年度审计报告、晦涩厚重的工业规范图册,还是大篇幅扫描档案,用户都可以直接交付模型解析,免去复杂的拆单与对齐清洗流程。
OCR 3.0时代,来了
从最初的单张纸质票据识别,演进到整本图书的连贯通读,文档解析的技术范式正在经历根本性重构。
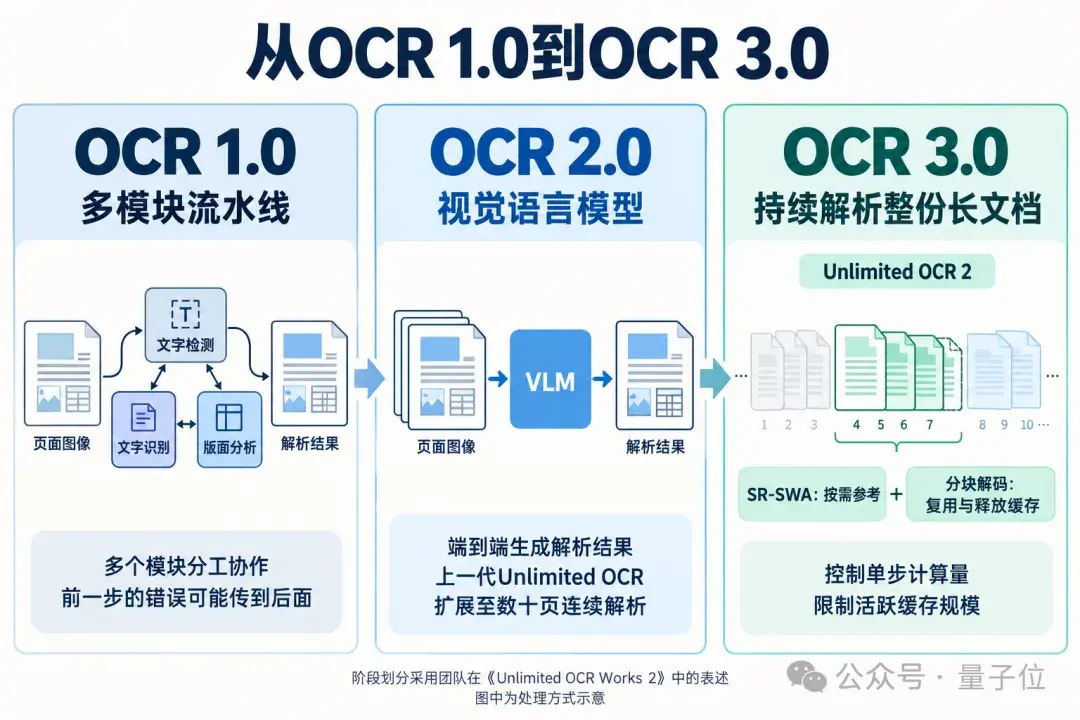
在技术报告中,团队将 OCR 的演进历程划分为 OCR 1.0、2.0 与 3.0 三个核心时代:
- OCR 1.0 时代:采用模块化流水线架构,按部就班执行文字定位、内容识别、版面分析与拼接排版。该模式高度解耦,但也极易造成误差沿链路逐级放大。
- OCR 2.0 时代:视觉语言多模态大模型登上舞台,直接通过端到端架构解析输入图像,消除传统模块间的信息损耗。初代 Unlimited OCR 正是这一阶段的代表作,成功将解析规模拓宽至数十页。
 △ AI生成
- OCR 3.0 时代:当场景迈向数百乃至数千页的大型文档解析时,系统不仅要保持跨页文意高度连贯,更需攻克算力随长度发散与显存爆炸的技术瓶颈。
文心 Unlimited OCR 2 依靠“按需局部注意力(SR-SWA)”与“无限视界分块解码”,做到了算力不随页数膨胀、显存不因篇幅淤积。
团队将此正式定义为 OCR 3.0:以不分页、无上限、整本持续解析为全新技术标杆。
有趣的是,这一技术命题在命名上也蕴含着一份二次元情怀。
“Unlimited OCR Works”的命名灵感,正是致敬了经典作品《Fate/stay night》中的“无限剑制”(Unlimited Blade Works)。
 △ 《Fate/stay night》动画官网首页
在原作设定中,“无限剑制”是一门展开无尽心象风景的固有结界。上一代模型发布后,Hugging Face 社区开发者 Snarcy 便以此为灵感,创作了一段极具极客浪漫色彩的 OCR 版经典咏唱词。
而在文心 Unlimited OCR 2 的技术报告中,研发团队正式将这段社区致敬词收录进了引言,并给予署名致谢。
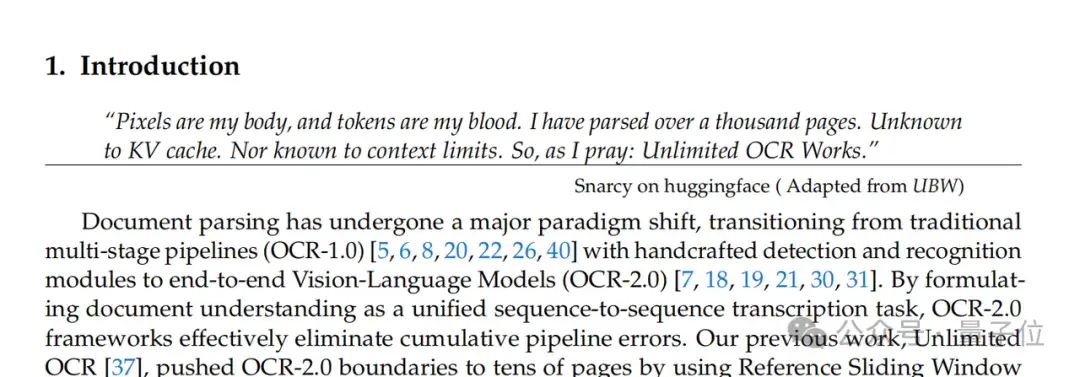
于是,在这篇探讨前沿注意力机制与显存开销的技术报告扉页,读者得以看到这样一段庄重又极具浪漫的宣告:
Pixels are my body, and tokens are my blood.
(身化像素,血铸符元。)