
AI 模型正在解决越来越多的数学难题。在其一系列成功背后,正逐渐浮现出一种模式,有助于我们预测它们接下来能解决哪些问题。
10月23日 · 阅读时间 16 分钟
今年 5 月,OpenAI 的一个内部模型发现了埃尔德什单位距离猜想(Erdős’s unit distance conjecture)的反例。该猜想自 1946 年提出以来悬而未决,诸多专家曾试图证明它,而 OpenAI 却找到了一个反例。一个月后,OpenAI 发布了圈双覆盖(Cycle Double Cover, CDC)问题的证明,紧接着在 7 月前又给出了另外十个未决问题的解答。9 月,他们又发表了纳维-斯托克斯方程(Navier-Stokes)的相关证明。Anthropic 也发布了费马大定理的形式化成果,以及对黎曼猜想界限的推进。AI 模型突然变得极其擅长数学。
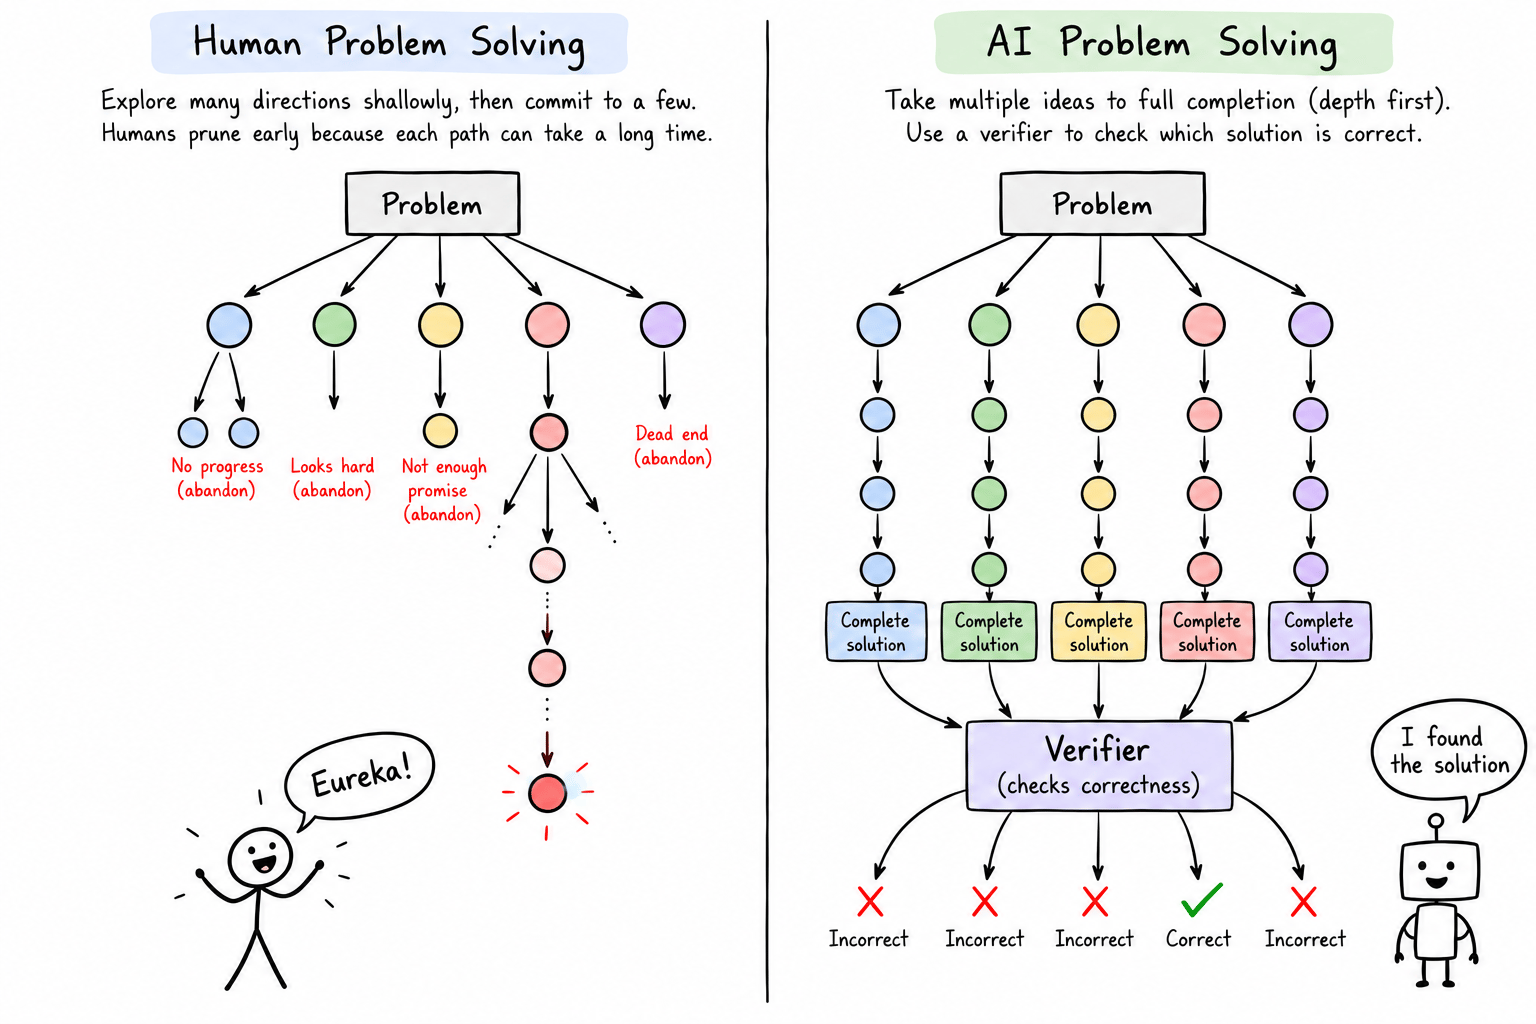
真正令我感兴趣的问题是:我们能否预测这些模型究竟能解决哪类问题?究竟是什么让一个问题变得可被大语言模型(LLM)攻克,这些解决方案又有什么共同点? 如果 AI 解决问题的方式与人类不同,理清这种差异将有助于我们决定该把它的算力投向何处。关于单位距离反例的讨论最为丰富,我们不妨就从这里切入。
问题复杂度
这里有一个简单的心智模型:要解决任何给定问题,你需要一连串提示(hints)或洞见(insights),并在它们之间投入大量工作。这一模式不仅惊人地契合日常琐碎问题,也能解释像广义相对论这样的复杂理论1(见文末彩蛋)。这一序列大致如下:
洞见 -> 时间 / 努力 -> 洞见 -> 时间 / 努力 -> 解决方案。
专家比初学者的背景知识更丰富,因此他们需要的提示会更少。W. T. 高尔斯(WT Gowers)在关于单位距离证明的评论中采用了类似的思路:证明的难度,等于让专家能够重构该证明所需的最短提示序列。 他称之为“模专家下的柯尔莫哥洛夫复杂度(Kolmogorov complexity modulo experts)”2。对于单位距离问题,他的提示序列分为三部分:
-
寻找反例。
-
选取目前已知的最佳构型并将其推广。
-
尝试一系列次数递增的数域,但在范数有界的素理想下开展工作。
高尔斯提出的复杂度公式是 2^k + t,其中 k 是最短提示序列的长度,t 是将其推导展开所需的工作量。这种公式看似严谨,但一旦你试图代入具体数值就会发现其抽象本质——而这恰恰点明了核心:问题复杂度会随着解决问题所需洞见数量的增加而呈指数级增长。
绝大多数解题过程,其实都是在这些洞见之间付出的繁重劳动。你有了一个灵光乍现的“尤里卡时刻”,接着要花上数月时间顺着这条提示深入推进,直到下一个概念性飞跃成为可能。对于专家而言,所耗费的时间是衡量这项工作的一个有效代理指标,即 t。就算直接给某人关于单位距离的第一个提示,他也依然需要做足推演工作才能走到广义构型这一步。
这个模型很有用,但属于事后诸葛亮(post hoc)。你无法在看到一个问题的第一眼就准确预测它需要 x 个提示。因此,问题的提出年份、被尝试攻克的次数以及设立的悬赏奖金,通常被人们用作评估其难度的现实代理指标。